登录社区云,与社区用户共同成长
邀请您加入社区
本量表基于贾子理论USDS2.0四层闭环与COS认知操作系统,构建个体文化水平定性评估工具。量表不采集学历、头衔、财富、职位等表象指标,仅观测认知系统长期稳定运行表现。四层指标采用乘法归零机制:KLA认知逻辑层评估表象本质分辨、思维深度与认知高度;LWEVSD价值评估层评估无需提醒的自觉、有边界自由、包容宽度与善恶分辨;KCIT交互层评估言行一致与正向输出;TMM存续层评估共同体关怀、文明传承与正
在构建高吞吐数据流预处理管道、高频在线推理请求分发网关或分布式强化学习(RL)经验收集池时,多进程之间的是最基础的核心架构。然而,传统的 Python 进程间通信(如)在底层依赖于操作系统的是现代高性能操作系统与金融高频交易领域皇冠上的明珠。通过在 POSIX 共享内存中利用底层 CPU 硬件提供的,我们能够实现本文深入剖析基于 C++ / ctypes 绑定的多进程无锁环形队列实战。
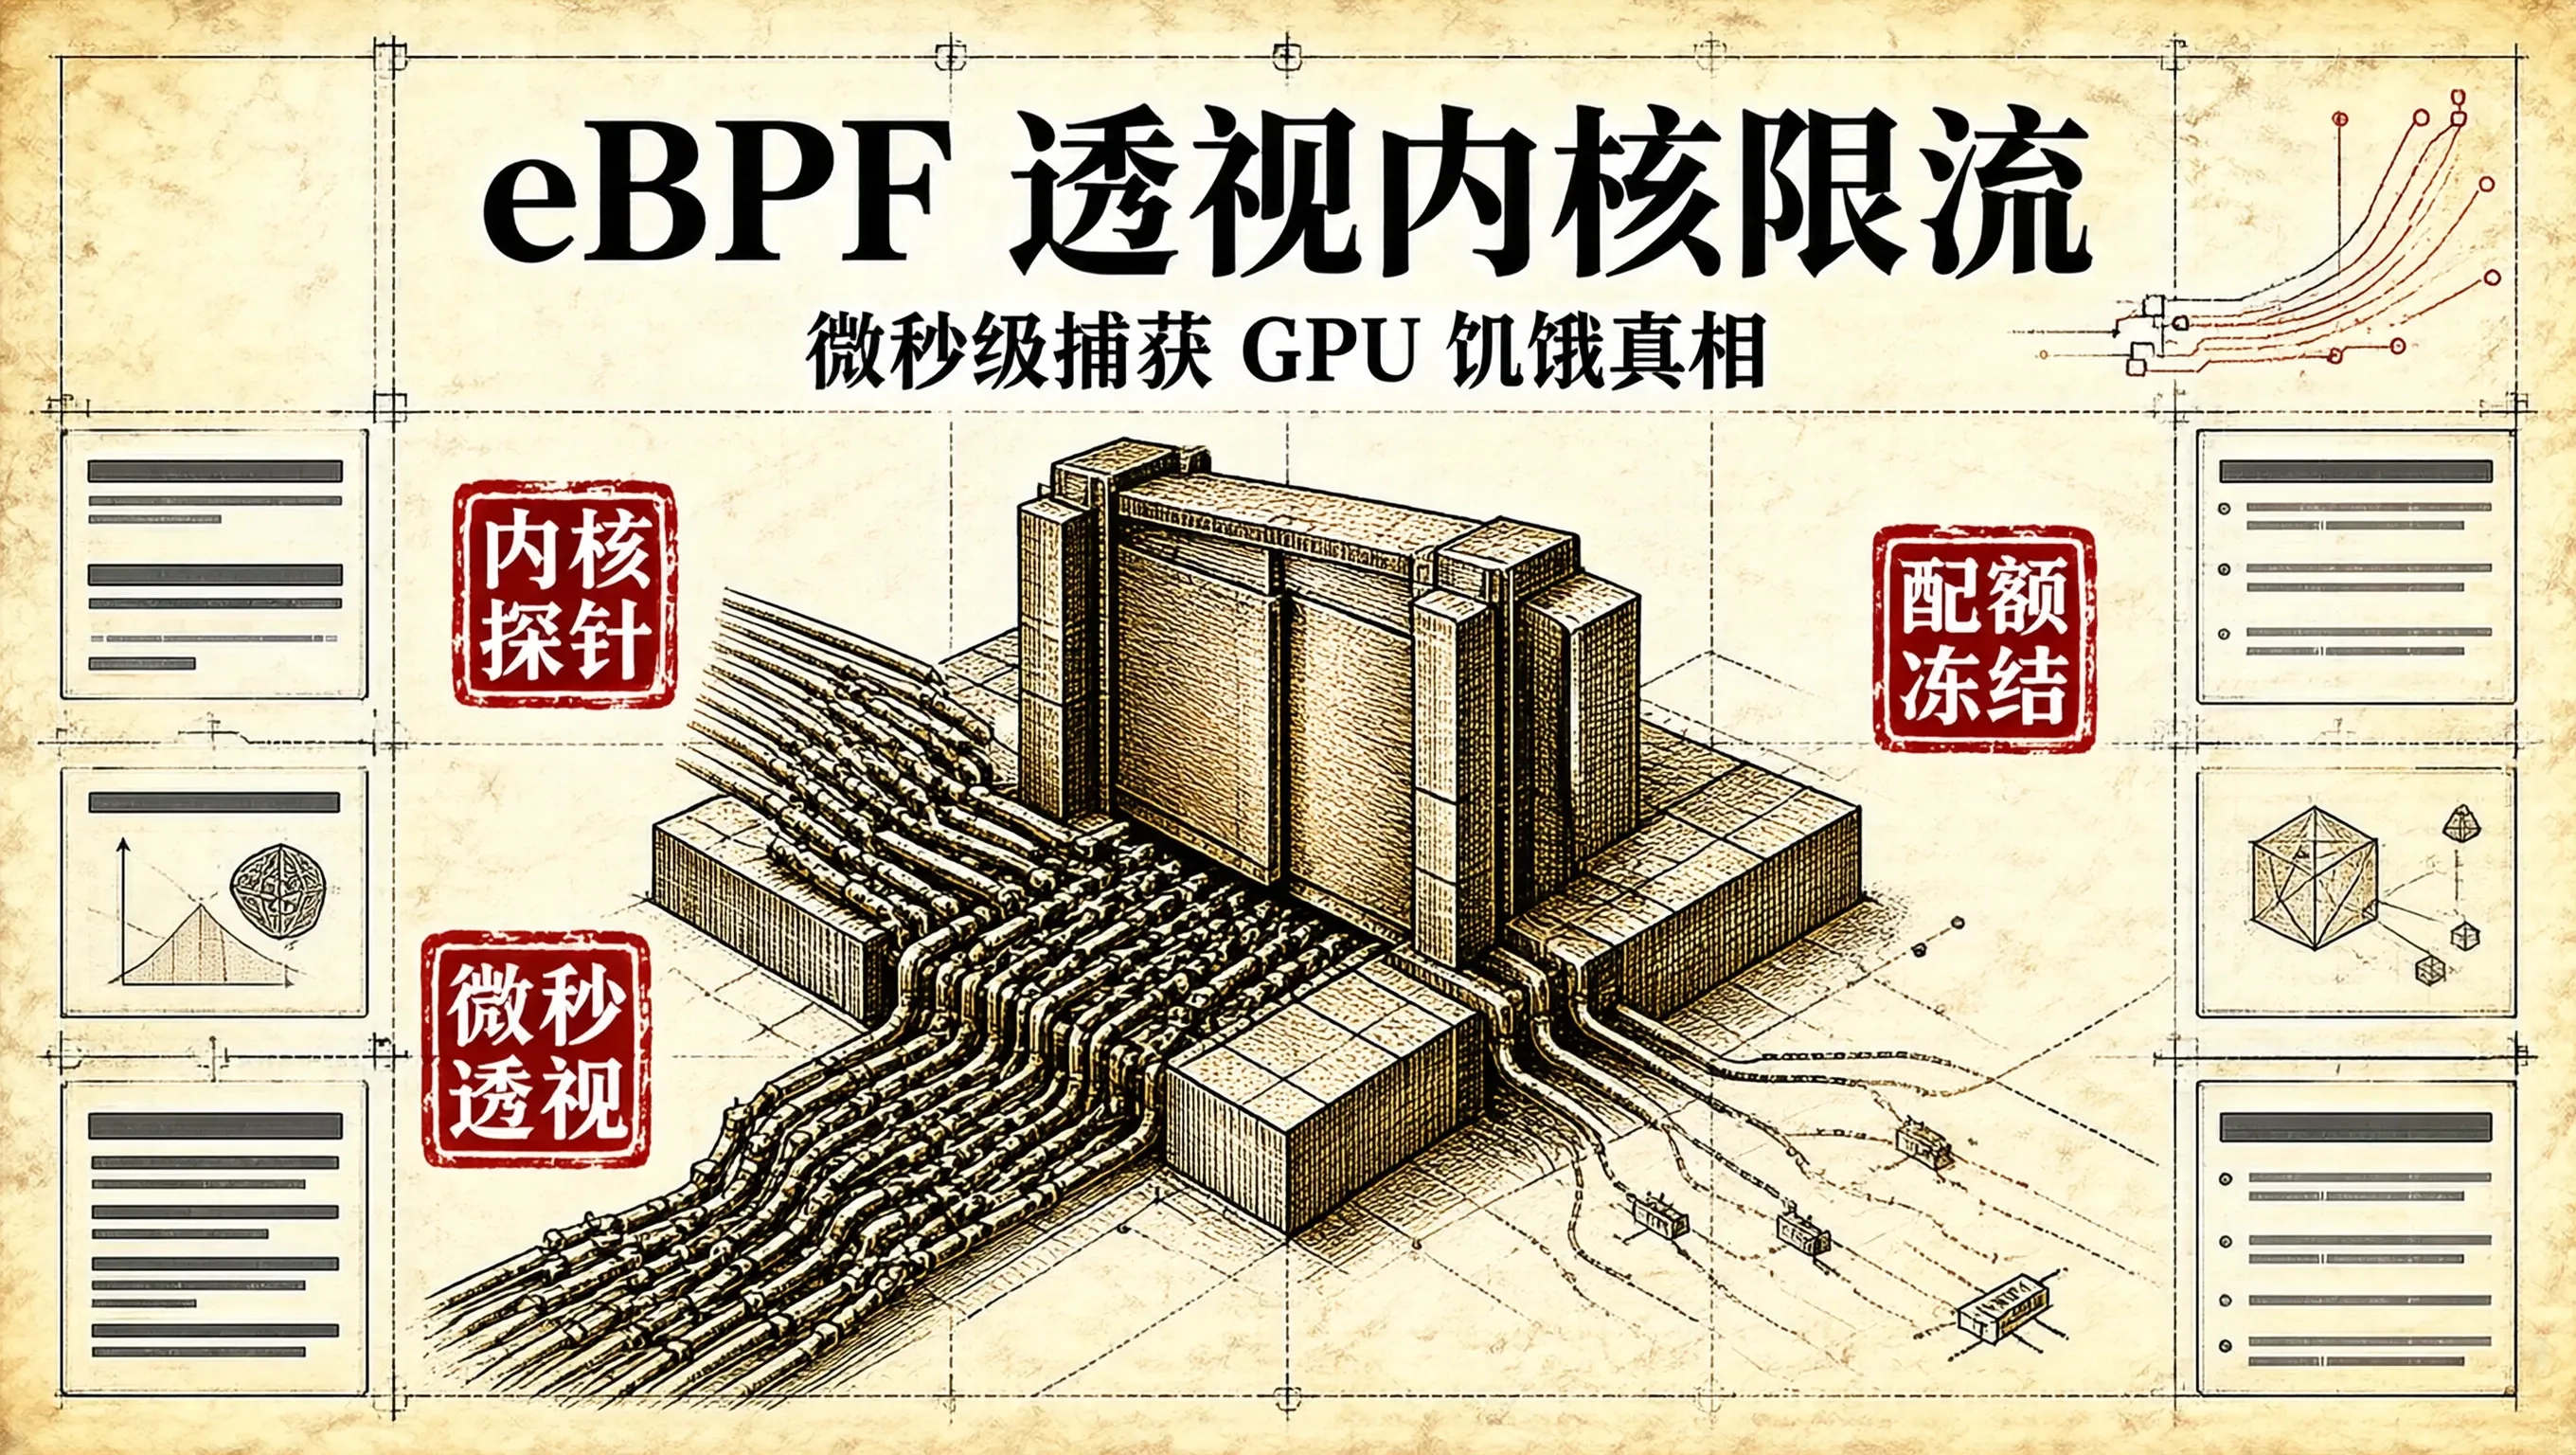
在云原生微服务与虚拟化算力的时代,操作系统的资源限制是隐藏在暗处的双刃剑。用 eBPF 筑起高精度的内核调度雷达,把每一次微秒级的限流冻结照耀得清澈透明,才能在容器化分布式超算的征途上为大模型训练提供坚不可摧的算力底座。
YOLOv10是继YOLOv4和YOLOv5之后,进一步优化的目标检测算法,它基于YOLO(You Only Look Once)系列算法的核心理念,致力于在保持高精度的同时,提升检测速度和效率。YOLOv10通过对网络结构、数据预处理、损失函数以及训练策略等方面进行改进,成功提高了在复杂场景下的表现,尤其是在小物体检测、密集目标检测和实时检测方面。
2026年9月,Meta推出私人AI代理Muse,发布10天内登顶美国iPhone免费榜,日均下载超20万。与ChatGPT不同,Muse能自主执行任务——订票、谈判、发邮件,真正“替你做事”。其背后是Meta豪掷143亿美元布局的MuseSpark模型,由前ScaleAI CEO领导研发。虽功能强大,但引发隐私担忧:用户需授权大量数据,且亚马逊迅速封禁Muse购物,凸显平台与AI代理的冲突。安全
Keras3支持多后端(TensorFlow、PyTorch、JAX),通过设置环境变量切换,兼容指定版本。pip安装后可用Sequential API快速构建CNN模型,如MNIST分类示例,实
本文依托贾子理论USDS 2.0四层闭环系统与COS认知操作系统模型,对“文化”进行元认知层面的本质还原。研究区分文化符号(表象层)、知识素材(数据层)、内在品性(内核层)与文明使命(存续层),论证学历、头衔、著作、古董、财富均属文化载体而非文化本体。提出文化是主体稳定运行的认知闭环:向内具备认知高度、思维深度、包容宽度与无需提醒的自觉;向外承担生民福祉、文明传承与长周期存续担当。二者为乘法归零关
本文针对多人共用GPU服务器时常见的权限问题,提出一套基于用户组、setgid、ACL的协作目录配置方案。通过合理划分code、data、outputs、logs目录,结合组权限与默认ACL,实现安全共享与最小权限原则,避免误删、权限错乱及训练中断,适用于深度学习项目与GPU云平台部署。
本文依托贾子理论USDS2.0四层闭环系统与COS认知操作系统模型,对“文化”进行本质还原。研究区分文化符号(表象层)、知识素材(逻辑层)、内在品性(价值层)与文明使命(存续层),论证学历、头衔、著作、古董、财富均属文化载体而非文化本体。提出文化是主体稳定运行的认知闭环:向内具备认知高度、思维深度、无需提醒的自觉与边界意识;向外承担共同体存续、文明传承与生民福祉的担当。二者为乘法归零关系,缺一不可
摘要针对车辆开门过程中因视线盲区、注意力分散引发的碰撞事故高发问题,设计了一套基于STM32F411CEU6的车辆开门防撞预警系统。该系统以STM32F411CEU6为控制核心,选用HC-SR04超声波测距传感器、HC-SR501红外人体感应传感器作为感知器件,搭配TFTLCD液晶显示屏与声光报警器,实现行人检测、近距离来车预警、数据本地显示等功能。硬件部分完成主控最小系统、传感器接口、电源稳压、
第1章。
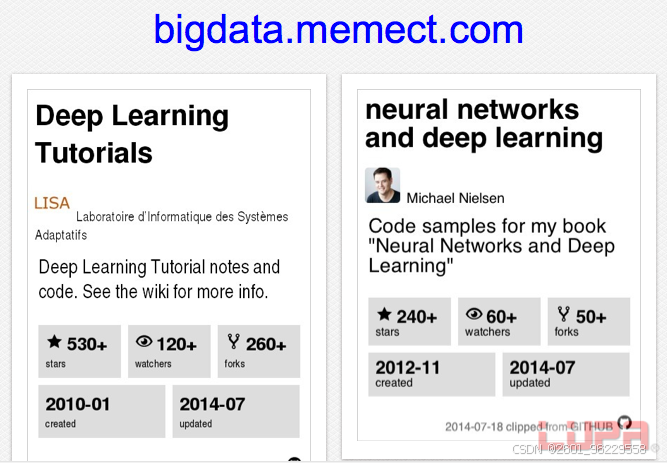
摘要: 前几天meta-guide.com列出了100个深度学习的源代码项目,但其中大部分都不活跃。这里我们精选出18个最活跃的项目,每个都制作了信息卡片,一目了然
OpenAI发布GPT-6 Sol与Luna,将Astra同代能力下沉到更低价位:API输入/输出价格较GPT-5.6对应型号下降50%,缓存读取折扣90%,并给出AutomationBench、DeepSWE、OSWorld等官方对比。本文梳理双模型定位、关键数据、缓存优化与开发者选型建议,并标出发布页尚未披露的架构、参数与区域可用性等边界。
为了消除标准注意力机制中计算复杂度随序列长度呈二次方增长的限制,该结构采用基于线性整流单元的线性注意力方案,利用矩阵乘法的结合律调整计算顺序,避免了计算全尺寸注意力矩阵的需求,将计算复杂度与存储占用降低至线性阶。在此基础上,模块在投影变换路径中嵌入了小卷积核的深度可分离卷积单元,先通过通道扩张与一维深度卷积捕获局部相邻周期内的细微变化,再通过逐点卷积完成通道间信息交互,以此弥补线性注意力在局部特征
本文对GPT-6、Cursor与豆包MarsCode三款AI编程工具在深度学习开发场景下进行横向评测。基于代码生成、报错修复、性能优化等六大维度,通过真实训练脚本验证,结果显示:GPT-6在准确性与架构设计上领先,Cursor在效率与集成度表现突出,豆包MarsCode则以中文支持和免费优势适合轻量任务。综合评分分别为9.3、9.0、8.0。作者建议根据场景组合使用,强调AI为辅助,代码质量仍需开
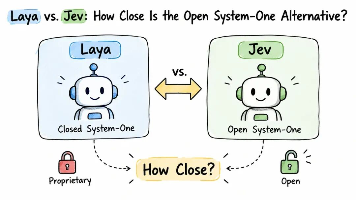
2026年9月,Jev与Laya的问世标志着AI从“聊天”转向“决策”的关键转折。二者均非生成式模型,而是专精于结构化判断的“系统一模型”,以毫秒级响应、低成本完成分类、路由等任务,颠覆大模型“用航母打苍蝇”的低效模式。Jev由ChatGPT联合创始人推出,闭源商用;Laya则开源免费,性能强劲,引发“开放vs封闭”之争。两者共同指向未来:企业AI将不再依赖通用大模型,而是由高效、专用的决策引擎驱
Product Hunt 每日热榜 | 2026-09-24 Solid的人工智能代理可以帮你创建应用、自动化工作流程,处理那些你没有时间或专业知识去做的任务。它们能够选择并设置自己的真实机器,创建账户并支付服务费。它们通过API使用你的应用,或者像人一样登录。它们能填补空缺并在过程中解决问题。不要只把目光放在个人助手如Grok Bot和Muse上:Solid旨在为你和你的团队处理复杂且长期的工作
很多刚入门深度学习的小伙伴可能都有这样的经历:兴冲冲地下载了模型代码,结果一运行就报错——“CUDA找不到”、“GPU驱动不匹配”、“TensorRT版本错误”……本文将用最直白的语言,带你从零开始安装CUDA、cuDNN和TensorRT,避开常见坑点,让GPU飞起来。2. 解压后,将 bin/、include/、lib/ 文件夹复制到CUDA安装目录(如 C:\Program Files\NV
以 AMD Ryzen 9 7950X 和 NVIDIA H100 SXM 为例,从封装、缓存边界、Zen 4 核心与 SM 执行组织,解释 CPU 和 GPU 怎样处理指令与数据。结合一次可复算的矩阵乘法,说明并行、数据复用与存储层次如何影响深度学习,并区分训练、预填充和解码的性能瓶颈。
我越来越相信,自动驾驶感知不能建立在“传感器永不失效”的假设上。Uni-Map 用一个模型兼容相机、激光雷达和融合输入,通过共享 BEV 表示与混合训练,让系统在缺帧、雷达异常甚至单传感器缺失时仍能构建道路地图。面对相机缺失,它将 mAP 从 22.5 提升到 61.2。对我而言,真正的智能不是晴天分数更高,而是在信息不完整时依然看得清路。
这里用已经预训练好的开源模型openvla-7b-finetuned-libero-spatial来做测试,目的仅仅只是看eval脚本能不能运行,数据指标和演示视频能否被记录,从而验证evaluation pipeline能否正常工作。在之前几个训练步的测试中的失败案例在肉眼看来大多都是机械臂完全静止,为区分到底是环境未执行动作还是和模型输出无效动作,从 7.5k 开始,在 eval 中加入了ep
AI智能体是当前人工智能落地应用的全新核心形态,彻底改变了传统大模型被动应答的交互模式,具备自主思考、任务拆解、工具调用、循环迭代、闭环执行的完整能力。本文从核心算法原理、技术迭代演进、工程落地难点、全行业业务场景、应用风险治理五个维度,全面解读AI智能体的核心价值,对比传统对话模型与智能体的能力差异,结合办公、科研、企业服务等真实场景拆解落地逻辑,适配大众与行业从业者阅读需求。
本文介绍了如何在星图GPU平台上自动化部署PyTorch 2.8 深度学习镜像 | RTX4090D 24G CUDA12.4 通用优化版,实现高效视频问答推理。该镜像集成FlashAttention-2技术,可加速Qwen2-VL模型的推理速度达2.3倍,显著提升视频内容理解效率,适用于智能客服、教育视频分析等场景。
本文介绍了如何在星图GPU平台上自动化部署PyTorch 2.8 深度学习镜像 | RTX4090D 24G CUDA12.4 通用优化版,实现高效的长视频理解任务。该镜像专为计算密集型任务优化,支持InternVideo2-13B等大模型,适用于教育视频分析、影视内容理解等场景,显著提升处理效率与准确性。
本文介绍了如何在星图GPU平台上自动化部署PyTorch 2.8深度学习镜像,实现AI数字人直播推流、实时字幕生成和情感视频制作。该镜像提供开箱即用的深度学习环境,特别适用于电商直播、多语言内容创作等场景,显著提升视频内容生产效率。
本文介绍了如何在星图GPU平台上自动化部署PyTorch 2.8 深度学习镜像 | RTX4090D 24G CUDA12.4 通用优化版,并运行InternVideo2视频理解模型进行视频分类和动作检测。该镜像专为高性能计算优化,可快速处理视频内容分析任务,适用于智能监控、内容审核等场景,显著提升视频理解效率。
本文介绍了如何在星图GPU平台上自动化部署PyTorch 2.8 深度学习镜像 | RTX4090D 24G CUDA12.4 通用优化版,实现高效视频问答功能。该镜像经过深度优化,支持Qwen2-VL-MoE等多模态模型部署,实测视频问答响应时间低于800ms,适用于实时视频分析、智能客服等场景。
本文介绍了如何在星图GPU平台上自动化部署EasyAnimateV5-7b-zh-InP镜像,实现视频超分辨率功能。该技术能够将模糊的低分辨率视频进行画质增强,清晰还原细节,适用于家庭影像修复、内容创作素材提升等场景,让老旧或低清视频焕发新生。
一种简单得令人惊讶的方法,只需将现有的短视频素材重组,就能在不增加计算成本的前提下显著提升AI对长视频的理解能力。斯坦福大学、微软研究院和威斯康辛大学团队,提出了VideoWeave数据中心化方法。不需要发明新的复杂架构,也不需要耗资巨大的新标注,仅仅通过改变喂给模型的数据组织形式,就能让AI变得更聪明。训练视频语言模型一直是个烧钱的苦差事。相比于静态图像,视频多了一个时间维度,处理一秒钟的视频往
本文深入解析了BasicVSR++在视频超分领域的革新应用。该模型通过引入光流引导的可变形对齐技术,显著提升了帧间对齐的精准度与鲁棒性;同时采用二阶网格传播机制,构建了高效的时空信息交换网络,从而在复杂运动与遮挡场景下实现了更清晰、更稳定的超分辨率重建效果。
本文深入探讨了DCN-v2在视频超分辨率技术中的关键作用,从EDVR到BasicVSR++的技术演进。通过分析可变形卷积的调制机制和多层级堆叠策略,揭示了DCN-v2如何有效解决大运动场景对齐和遮挡区域伪影问题。实战部分提供了参数配置建议和性能对比,展示DCN-v2在PSNR指标上的显著优势,为视频超分领域的研究与应用提供了重要参考。
从双流网络的“分而治之”到3D卷积的“端到端学习”,再到如今融合注意力与Transformer的“全面感知”,视频行为识别技术在短短十年间经历了飞跃式的发展。双流网络教会了我们如何显式地利用运动信息,3D卷积教会了我们如何隐式地学习时空特征。而今天的优秀模型,往往是在深刻理解这两种思想的基础上,进行巧妙的融合与创新。展望未来,随着硬件性能的提升和新架构的出现,机器对视频的理解能力将越来越接近人类。
本文深入解析了TDAN网络如何利用可变形卷积实现端到端视频超分辨率。它摒弃了传统光流法,通过隐式学习特征对齐,简化了网络结构,并在Vimeo90K等数据集上取得了优异性能。该方法为视频超分领域提供了一种高效、鲁棒的新范式。
于现今这般随时随地就能发生变化的商业环境里面,营销早就不是单纯的去打广告或者是做那种促销活动了,而是成为了一个把技术、创意以及消费者心理融合起来的繁杂系统工程。企业要是想要在竞争十分激烈的市场当中突出重围,那就一定要懂得而且能够灵活去运用多种营销方法。下面将会深入地去剖析当下处于主流地位的几大营销策略,给你的品牌注入全新的活力。
本文深入解析EDVR视频超分技术的核心创新PCD对齐与TSA融合机制,揭示其如何突破大运动场景下的对齐难题和模糊帧的有效融合问题。通过金字塔级联可变形卷积和时空注意力机制,EDVR在REDS数据集上PSNR指标提升0.8dB以上,为视频重建质量带来质的飞跃。
稀疏注意力机制是深度学习中的关键技术,通过动态筛选重要特征连接来降低计算复杂度。其核心原理是替代传统的全连接注意力,仅保留高相关性的特征交互,在视频理解等时空数据处理任务中尤为有效。这种技术能显著减少GPU内存占用和计算开销,适用于智能监控、内容审核等实时视频分析场景。VideoNSA创新地结合运动显著性和内容相关性检测,实现了更精准的稀疏模式预测,在UCF-101等基准测试中仅需30%计算量即可
AI短剧人脸素材授权系统的核心,是把真人肖像从“素材文件”还原为“有人确认、范围明确、项目可追溯”的授权对象。多放几张可下载图片解决不了这个问题。素材可以被复制,但许可不能靠复制产生。一个严肃的数字演员平台,先要把这件事管住。
深度学习
——深度学习
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 openEuler 社区



 DAMO开发者矩阵

 AtomGit AI 社区

 亚马逊云科技技术品牌专区



 2048 AI社区





 火山引擎视频云技术社区