登录社区云,与社区用户共同成长
邀请您加入社区
智链矩阵GEO4.0体系应对AI问答时代品牌信息幻觉与转化难题,以诊断先行、信息一致性为核心,构建省-市-区县三级分站矩阵,通过llms.txt结构化配置,打通豆包、元宝、千问等多生态信源,实现企业事实资产统一管理与精准投放。系统集成知识库、线索闭环(GEO-CRM)、效果监测与数据反哺,将AI曝光转化为可追踪商机,解决传统软文铺量模式下信息冲突、流量不可控等问题,适用于连锁品牌、区域扩张型企业,
四、生活场景背后的技术支撑五、让技术真正为人服务。#数字孪生 #人工智能 #大数据 #具身智能。数字孪生走进日常生活:从城市治理到个人健康。二、家庭:让居住空间“善解人意”三、健康:从被动就医到主动管理。一、城市:在虚拟中预演现实。
想象一下,你的电脑是一台复杂的机器,它有许多不同的部件,如CPU、内存、硬盘等。这些硬件设备需要一种方式来协同工作,以执行你想要的任务,比如打开网页浏览器或播放音乐。这就是Linux内核的作用——它是操作系统的核心部分,负责管理和协调所有这些硬件资源,并为应用程序提供一个稳定的运行环境。内核定义:内核是操作系统中最底层的部分,介于用户程序和硬件之间。它充当两者之间的桥梁,确保每个程序都能安全地访问
个性化教学长期受限于数据采集和内容生成的高成本,大模型的出现显著降低了实现门槛。其底层逻辑是基于知识图谱将学科拆解为带依赖关系的知识点,通过测评、规划、反馈、迭代构成持续闭环,并根据作答记录与正确率动态调整推荐难度,让正确率维持在60%~80%的合理区间。系统的核心价值在于最大化学习效率,在更短的时间内精准定位薄弱环节并安排错题复现,这正是“每天只学2小时”得以成立的工程基础。该模式在K12、备考
最近半年,我至少被问了二十次同一个问题:“为什么用 AI 写出来的东西,读起来都一个味儿?问这个问题的,有做自媒体的朋友,也有企业里负责内容运营的团队。他们不缺工具,ChatGPT、DeepSeek、文心一言轮着用,提示词也学了不少,但产出就是千篇一律——开头都是"在当今这个快速发展的时代",结尾都是"让我们一起拥抱未来"。这篇文章不聊虚的,就从我们团队踩过的坑出发,讲清楚同质化的根源到底在哪,以
上个月末,慕尼黑工业大学建筑 AI 中心主任 André Borrmann 在首尔参加 Hanmi Global 三十周年举办的 Global PM Summit 2026,主讲 BIM、AI 和机器人的融合。韩国经济日报随后报道了他的说法:多智能体 AI 靠文字命令生成 BIM 模型,墙体生成、开洞插入这类建模测试成功率 86%~95%;现场照片结合 BIM,把模板等结构的识别精度最多提高了 5
一、具身智能交互的本质:行动带来环境状态变化。四、虚实迁移学习:模拟器预训练到真机微调原理。#具身智能 #大模型 #世界模型 #人工智能。三、模仿学习范式:从演示行为提取策略原理。二、强化学习范式:试错学习的底层原理。五、交互学习范式的整体能力局限。具身智能环境交互与学习范式原理。
GPT-5.6 桌面端提供了比网页版更流畅的体验和更多本地功能。通过本教程,您应该已经成功完成了安装和基本配置。
想要学习LLM(大型语言模型),首先要对LLM有一定的了解,知道LLM的基本概念和使用。因此,对于每一位初学者,首先都需要学习一些LLM的入门课程,包括基础的 Python 语法(因为 LLM 目前基本都建立在Python生态上)、LLM 的概念、Prompt 书写技巧等,对 LLM 有一个初步而全面的了解。
本周阅读的论文题目是《KAG: Boosting LLMs in Professional Domains via Knowledge Augmented Generation》(《KAG:通过知识增强生成提升专业领域的大型语言模型》)。最近开发的检索增强生成(RAG)技术使得构建特定领域的应用变得高效。然而,它也存在局限性,包括向量相似性与知识推理的相关性差距,以及对知识逻辑(如数值、时间关系、
当然,以上教程只是在最基础的层面上实现了 DeepSeek-R1 的本地部署。如果你想将这个热门模型进一步整合进自己的本地工作流程中,还需要进一步的配置 —— 从基础的设置系统提示词到更高阶的模型微调定制、整合 RAG、搜索功能、多模态能力、工具调用能力等等。同时,随着专门针对 AI 开发的硬件以及小模型相关技术的发展,相信未来本地部署大模型的门槛还会进一步降低。看完此文,你会自己动手试试部署自己
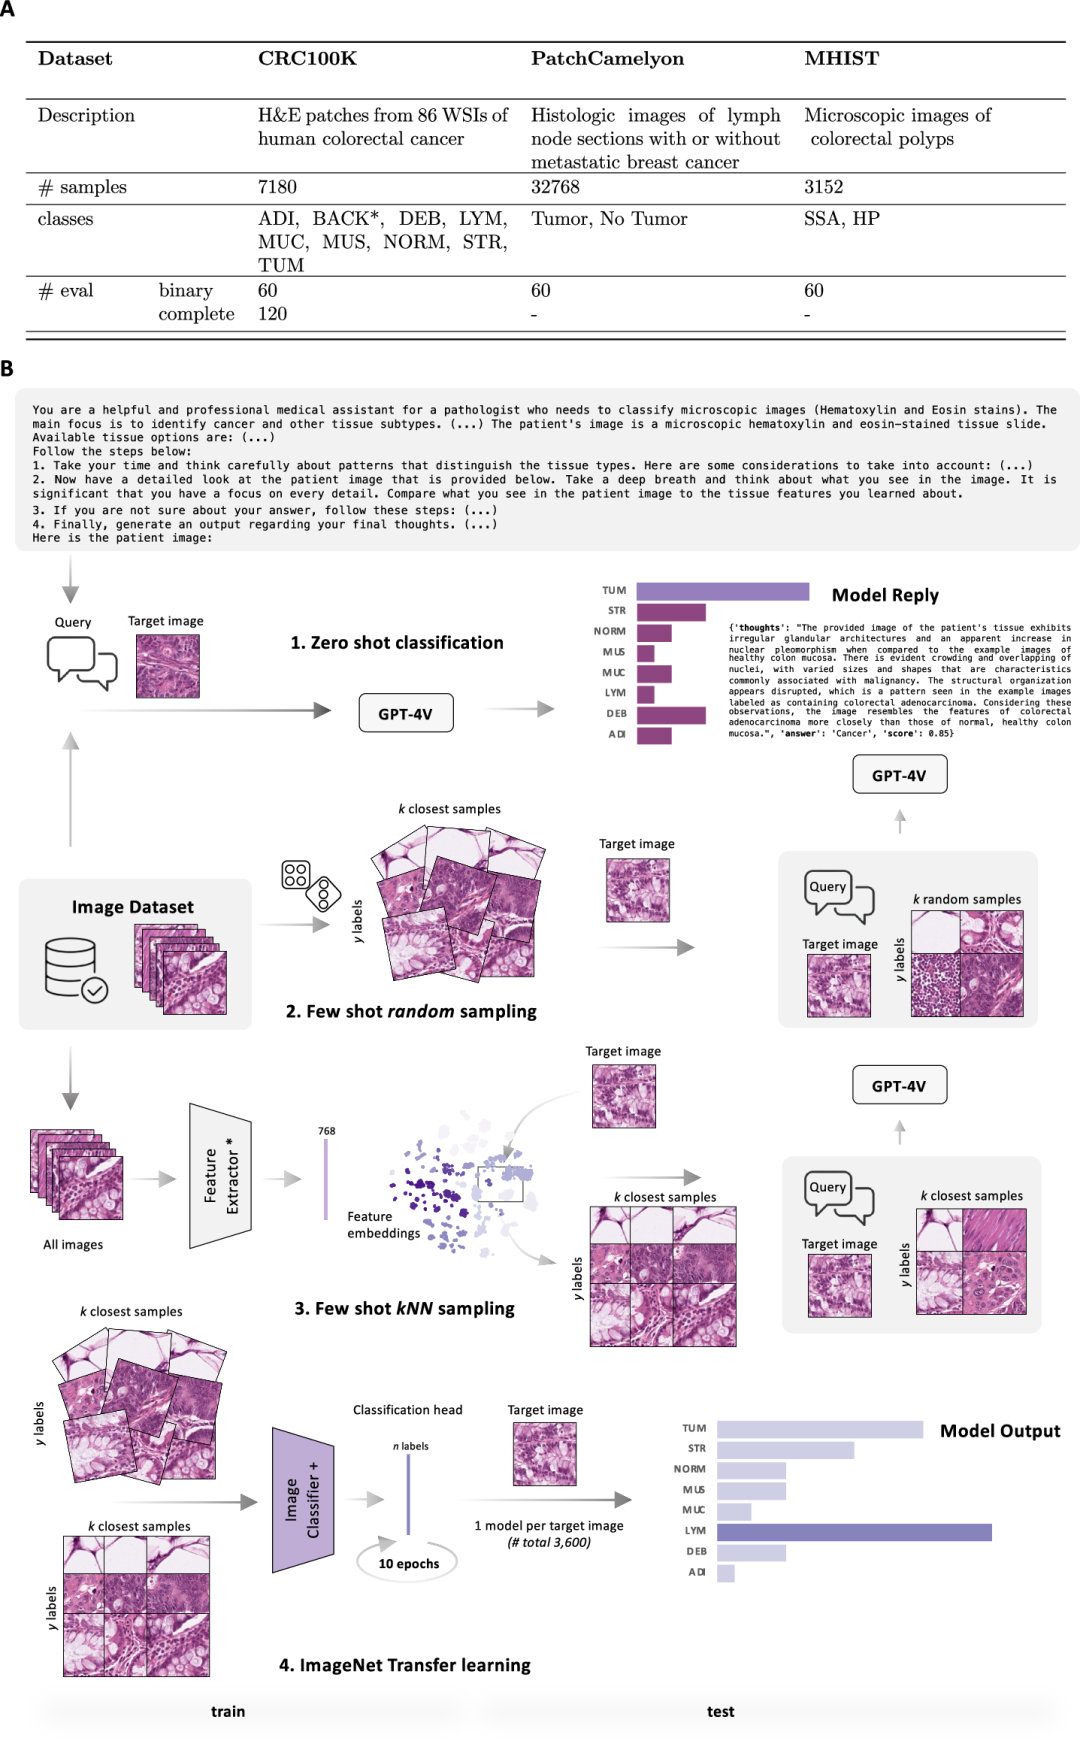
01.工作速览医学图像分类需要使用标记过的、特定于任务的数据集来从头训练深度学习网络,或者用于微调基础模型。然而,这一过程在计算和技术上都极具挑战性。在语言处理中,上下文学习提供了一种替代方案,模型可以直接从提示中学习,从而绕过参数更新的需求。然而,上下文学习在医学图像分析中的应用仍处于探索阶段。2024年11月21日,德国海德堡大学在_Nature Communications_在线发表题为**
我们在前面的文章中提到了calcite支持csv和json文件的数据源适配, 其实就是将文件解析成表然后以文件夹为schema, 然后将生成的schema注册到RootSehema(RootSchema是所有数据源schema的parent,多个不同数据源schema可以挂在同一个RootSchema下)下, 最终使用calcite的特性进行sql的解析查询返回.
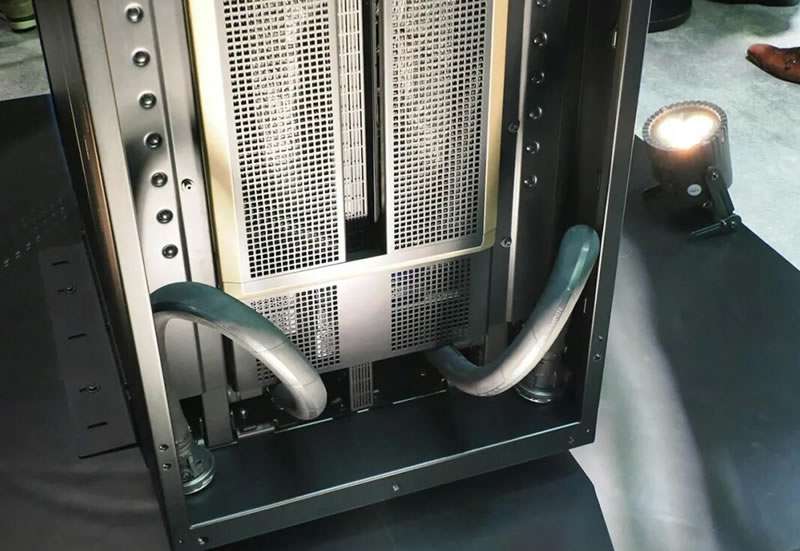
云达科技现场展示的1U机型QuantaGrid D75B-1U,在Nvidia GB200 NVL72的系统建置框架之下,可透过单座机柜容纳72台这样的设备。新一代 AI 液冷机架解决方案 NVIDIA GB200 NVL72,结合了 36 个 NVIDIA GB200 Grace Blackwell 超级芯片,其中包括 72 个基于 NVIDIA Blackwell 的 GPU 和 36 个NV
随着条件生成模型的快速发展,分子生成技术在药物反应预测和药物靶标结合亲和力等任务中取得了显著进展。然而,这些为特定任务生成的分子在工业生产中的应用仍显不足,因此分子优化成为了一项关键任务。传统方法依赖化学家的经验和直觉,效率低下。深度学习方法通过学习SMILES、图形和3D结构来加速分子优化,但这些方法往往忽视了保留分子核心结构的重要性。此外,基于引导搜索的方法虽然采用了先进的优化技术,却受限于外
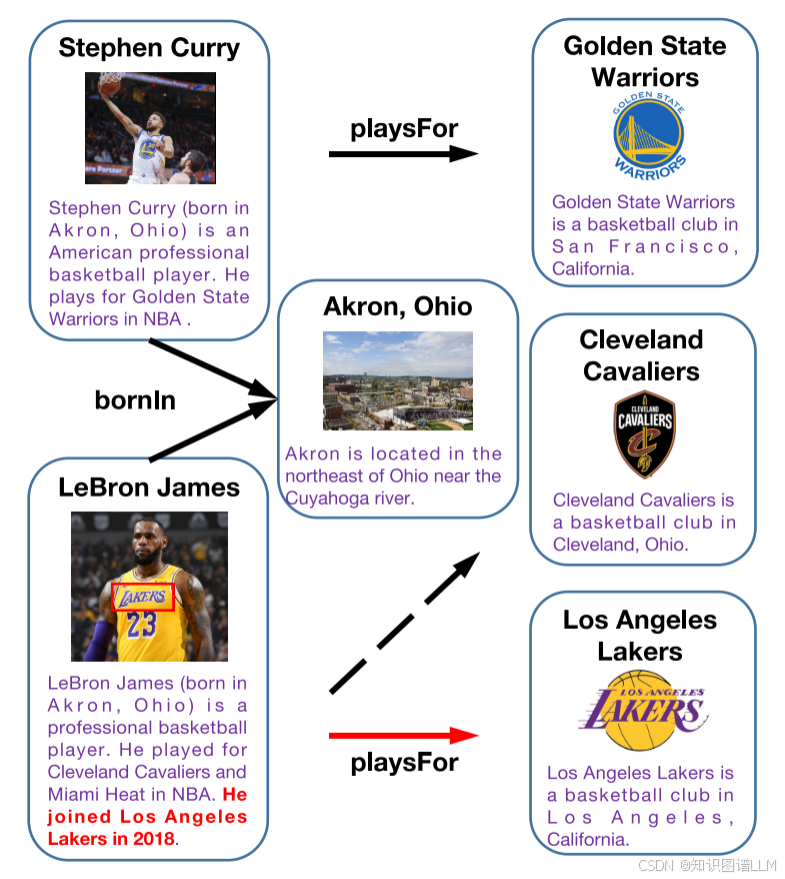
知识图谱(Knowledge Graph)作为一种新型的知识表示和组织方式,正逐渐成为信息领域的研究热点。以下是对知识图谱的详细介绍:
是一个与任务无关的框架,将知识图(KG)的显式知识与大型语言模型(LLM)的隐式知识相结合。在这里,我们利用一个名为SPOKE的大型生物医学知识库作为生物医学环境的提供者。 SPOKE 整合了 40 多个来自不同领域的生物医学知识库,每个知识库都专注于生物医学概念,如基因、蛋白质、药物、化合物、疾病及其已建立的联系。 SPOKE 由 21 种不同类型的超过 2700 万个节点和 55 种类型的 5
在今年以OpenAI为代表的LLM席卷全球前,笔者尝试了很多开源技术来进行实体关系的识别,发现中文环境下,百度的Paddle所展示出的效果最好的。一种更好的办法是,在提示中给出Json格式的输出样例,以确保LLM按照指定的格式输出结果,方便后续的程序统一处理,更加简单、方便。从目前的实验结果看,使用LLM进行实体关系的识别,较之前的技术,有了很大程度的提升。但在使用LLM的这种技术时,需要注意,不
从我们实验的效果看,除混元、Llama2外,其它四个大语言模型基本都能够识别出我们所要求的信息。输出格式的差异可以通过后续的处理程序对齐。信息抽取的有效性让我们充分看到了大语言模型在实体关系抽取这类作业上能力。它将为我们打通一些我们之前无法企及的应用效果的道路。
目前CiteSpace最新版6.2.R2高级版的中文版界面。CiteSpace中文版对于英文不太好的新手,确实可以所见即所得,可以大大降低学习成本,学习效率也会更高一些。
本篇我总结了学习计算机网络时必备的知识,可以用于巩固知识或者期末复习~~~如果觉得博主爆肝总结的不错,感谢点赞!目录1、计算机网络的几个发展阶段2、计算机网络的组成3、协议的概念4、实体,协议,服务,和服务访问点5、计算机网络的分类6、物理层的四个特性7、数据传输方式:通信双方的交互方式(通过传输方向分)8、数据传输方式:按照传输对象分9、数据交换:10、两种信号11、数据传输方式:串行传输和并行
c语言 宽字符 wchar_t
在经过一段时间的c语言学习后,我针对自己的学习情况以及知识体系总结了一份c语言思维导图,此图是在大佬(lxf_style)的基础上我以自己的所学知识对其进行了部分修改与扩充,如有错误请大家帮忙指出哈有需要的朋友可以点赞收藏,以便于大家期末复习或者查漏补缺,谢谢!!!撒花,完结~...
前言最近导师让我学习知识图谱,其中用到一款软件protege,涉及到graphviz。今天给大家分享一下graphviz的下载安装与使用。Graphviz下载官网地址:http://www.graphviz.org/download支持liunx、mac、windows。小编的系统是win10,所以接下来以win10(64位)为例,其他系统也是差不多的。可以按路径一步一步点击:10/cmake/R
1 知识图谱 知识图谱(Knowledge Graph)又称为科学知识图谱,由Google与2012年5月提出,目的是提高搜索引擎的能力,改善用户的搜索质量及搜索体验。随着人工智能技术的发展和应用,知识图谱逐渐成为关键技术之一,现已被广泛应用于智能搜索、智能问答、个性化推荐、内容分发等领域。维基百科 知识图谱是Google用于增强其搜索引擎功能好的知识库。本质上,知识图谱旨在...
EchoArchive 是一个融合空间音频采集、生成式AI修复与区块链存证的非遗声音记忆数字化平台。通过Ambisonics与HRTF实现沉浸式声场还原,利用AI技术完成降噪、补全与语义标注,支持多终端交互回放与版权溯源。系统覆盖采集、修复、管理、共享全链路,赋能研究者、传承人、公众与机构,推动口述史与非物质文化遗产向“可听可感可交互”升级,实现文化记忆的智能化保存与传播。
二、世界模型支撑下 “规划 - 模拟 - 评估 - 执行” 循环机制。四、世界模型、感知模块、决策模块之间信息协同逻辑。一、两种智能体推理范式:反应式推理与预测式推理。#人工智能 #具身智能 #智能体 #世界模。三、世界模型实现反事实推理的底层原理。五、协同推理体系的原理性短板。
视频理解是计算机视觉领域的核心任务之一,旨在让机器像人一样解读视频内容。其基本原理在于通过深度神经网络提取视频帧的时空特征,进而识别动作、物体与场景。这项技术的价值在于能将海量非结构化的视频数据转化为可检索、可分析的结构化信息,广泛应用于智能监控、内容审核、人机交互和自动驾驶等场景。面对长视频理解中“信息过载”和“长程依赖”的工程挑战,一种结合了智能体决策与分层知识图谱检索的新范式应运而生。该范式
本文介绍一套以数据主权为核心的个人AI工作台架构:采用“客户端—本地回环服务—本地数据”三层单向数据流,确立文件、SQLite、索引的唯一真源,杜绝双写不一致;通过权限、审批、审计与幂等机制约束AI操作,所有工具调用均需候选审批;搜索基于可重建的FTS5全文索引,向量检索默认关闭;REST+SSE保障操作可溯源,强调“默认关闭”与评测驱动。核心理念:控制权在手,才能真正驾驭AI。
通过引入本地代码索引工具 CodeGraph,将代码文本升级为结构化 AST 查询,实现符号级精准上下文调取,成功将 Input Token 暴砍 66%,单单一个 5 人团队每月便可省下数千元。
本文深入解析知识图谱链接预测的四大核心评估指标:MRR、Hits@n和MR,通过实战案例和计算公式详细说明各指标的计算方法、优缺点及适用场景。文章特别强调MRR(平均倒数排名)作为重要指标的应用价值,并提供了指标选择策略和评估报告撰写技巧,帮助开发者全面理解并正确使用这些评估工具。
最近在研究全钒液流蓄电池的充放电储能系统,发现Matlab/Simulink真是个好东西,尤其是在做双闭环控制的时候,简直是无敌的存在。总的来说,这个仿真模型非常强大,通过双闭环控制,我们可以精确地控制电池的充放电电流和电压。电流环的作用是控制电池的充放电电流,电流为负时充电,为正时放电。双向DC/DC全钒液流蓄电池充放电储能matlab/simulink仿真模型,采用双闭环控制,充放电电流和电压
本文深入对比了PlantUML和Mermaid在Markdown文档中绘制知识图谱的优劣,涵盖语法特性、渲染兼容性及VS Code配置方案。PlantUML适合专业级建模,而Mermaid以轻量级Web集成为优势,帮助开发者根据项目需求选择最佳工具。
机器学习通常需要一定的编程能力。编程是机器学习算法的实现和应用的基础。在机器学习中,你需要使用编程语言(如Python、R等)来处理数据、实现算法和构建模型。编程能力使你能够对数据进行预处理、特征工程、模型训练和评估等操作。尽管有一些工具和框架可以简化机器学习的实现过程,但理解和掌握编程是非常有益的。编程能力可以帮助你更好地理解算法和模型的实现细节,允许你对其进行定制化和扩展,以满足具体的需求。因
ChatBox 是一款支持多语言模型的高效 AI 聊天客户端,主打流畅智能的对话体验,无论是日常聊天、工作辅助(如文案生成、数据整理),还是编程调试、学习答疑,都能轻松胜任。其核心优势在于跨平台兼容性(支持 Windows、macOS、iOS、Android)、自定义模型配置(可接入 DeepSeek、Grok 等主流大模型),以及轻量化设计(安装包小,启动速度快),尤其适合新手快速上手。
昨天,OpenAI的CEO兼联合创始人Sam Altman在他的个人博客上发表了一篇名为《反思》的文章。文章回顾了OpenAI成立9年来的发展历程:从最初的不被看好,到2022年推出ChatGPT引发全球AI热潮,用户数超过3亿,再到他被解雇导致公司陷入混乱。他意识到自己在管理上的不足,但在恢复过程中得到了很多人的帮助,并对OpenAI的董事会进行了多元化改革.Sam表示,OpenAI现在有信心以
链接:https://pan.quark.cn/s/0ba96bce3332。夸克网盘无需下载在线播放视频,畅享原画5倍速,支持电视投屏。「Python入门到进阶手册」,来自夸克网盘分享。自取哦~关注后续更多知识更新❤️。
蛋白质晶体结构解析工具,案例实操分析见下一篇博客
链接预测旨在识别知识图中潜在的缺失三元组。为了得到更好的结果,最近的一些研究引入了多模态信息来进行链接预测。然而,这些方法单独利用多模态信息,忽略了不同模态之间复杂的相互作用。在本文中,我们旨在更好地建模跨模态信息,从而引入一种新的交互式多模态融合(IMF)模型来整合来自不同模态的知识。为此,我们提出了一个两阶段的多模态融合框架,以保留模态特定知识,并利用不同模态之间的互补性。我们的多模态融合模块
neo4j安装说明
知识图谱
——知识图谱
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 AtomGit AI 社区


 DAMO开发者矩阵

 openEuler 社区


 乐奇 Rokid 开放社区












 火山引擎视频云技术社区