登录社区云,与社区用户共同成长
邀请您加入社区
这篇论文做了一件很有意思的事:它把认知神经科学的测量工具(EEG、眼动追踪)、图学习的结构化建模能力(超图)和大语言模型的语义推理能力三者结合起来,构建了一个能够"理解人类大脑如何理解视频"的系统。从技术路线来看,它代表了多模态大语言模型研究的一个重要趋势——从"让模型看懂视频"到"让模型理解人看视频时的感受"。这个转变不只是模态数量的增加,而是研究目标的根本性升级:从客观描述到主观理解,从内容分
把答案说短一点”是否真的改善服务?“先复述再推进”会不会反而增加通话时长?这类问题不能靠团队主观听几通录音决定,也不能拿一组漂亮的平均值直接宣布“策略适配有效”。这篇文章讨论的是表达策略实验:在用户明确要求直接回答、任务风险可控的前提下,调整答案顺序、解释密度和确认方式。它不是根据声音诊断 MBTI 或人格,也不把任何示例数字写成线上效果。我的判断是:VASI 的 A/B 测试必须先把“能不能进入
同一个人在安静的耳机通话里语速正常,换到地铁、免提或窄带线路上,停顿、音量、音高和识别置信度都可能改变。若系统据此给人贴上“急躁”“犹豫”甚至人格标签,结论很容易错;更糟的是,它会把错误结论带进后续话术。闪电智能 Voice Agent 在这里应当做的是,不是从声音诊断人格。可进入策略层的,只能是经过环境校正、稳定性检验、且与当前任务相关的信号;用户明确说出的偏好优先级最高。
MotionLLM通过。
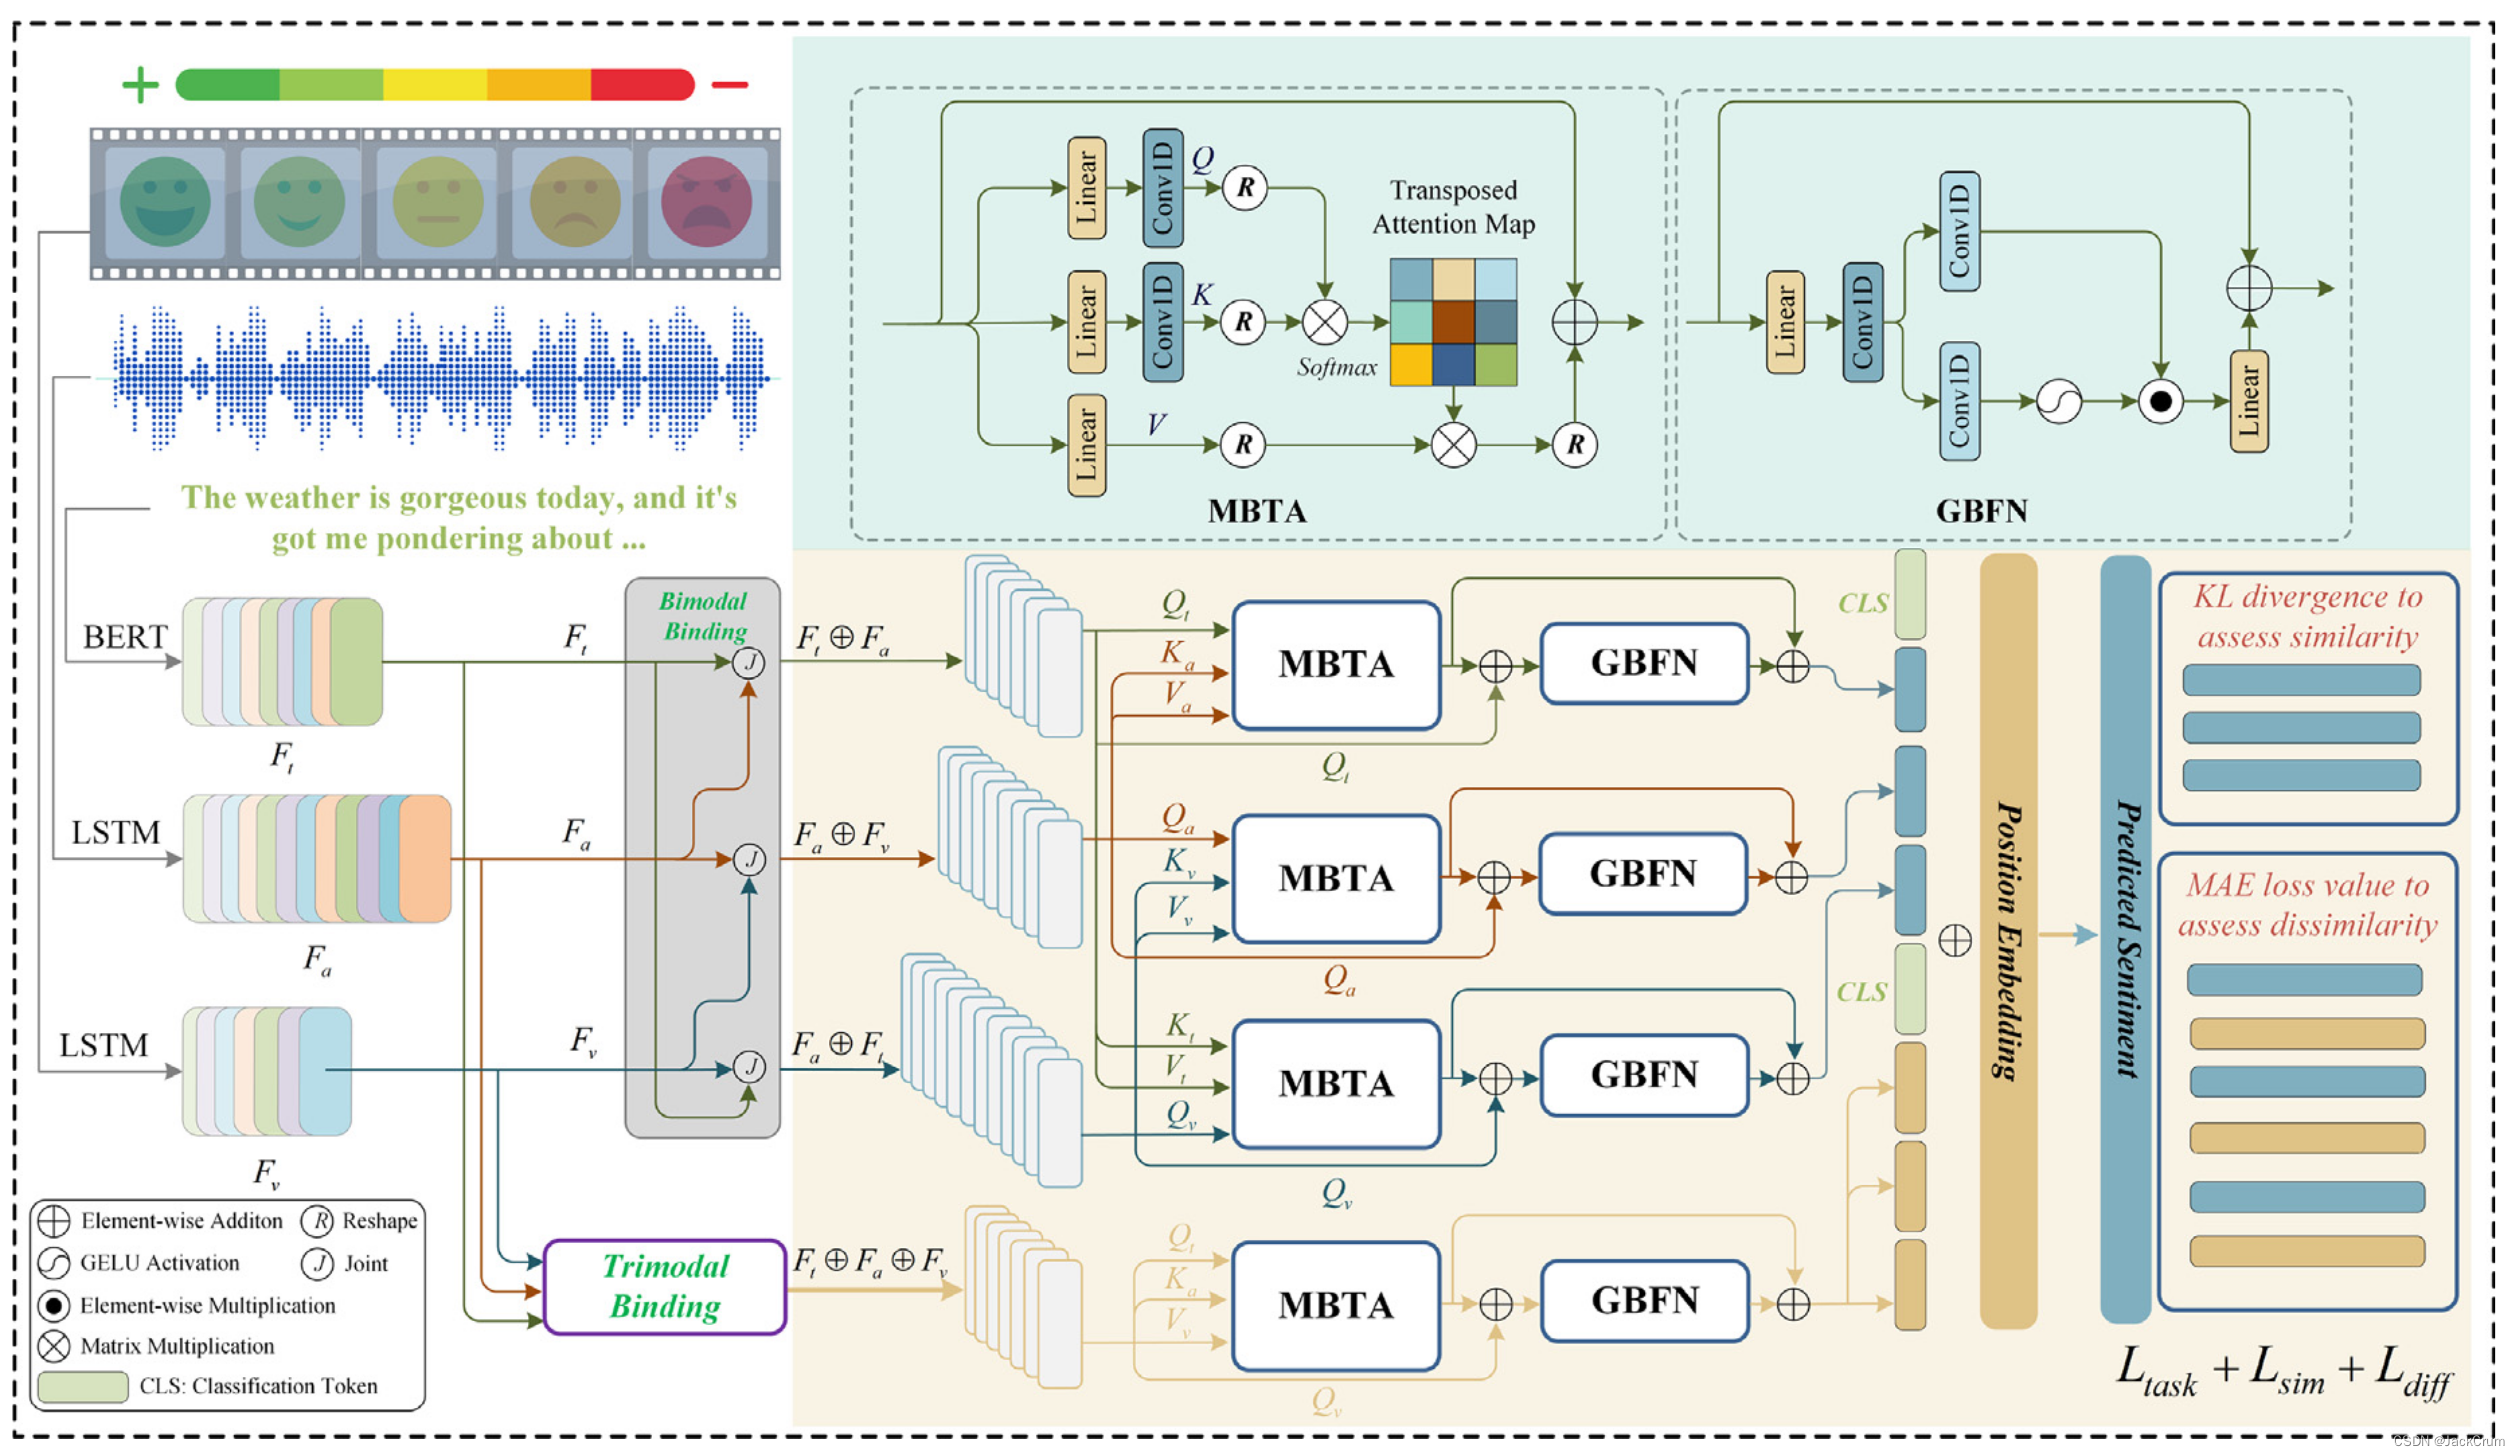
多模态情感分析是人机交互研究的重要方向,它可以通过同时分析文本、视频和声音特征来准确识别个体的情绪状态。尽管当前的情绪识别算法使用多模态融合策略表现良好,但仍然存在两个关键挑战。第一个挑战是在融合之前有效提取模态不变和模态特定的特征,这需要不同模态之间的深层特征交互。第二个挑战涉及区分模态特征之间的高级语义关系的能力。为了解决这些问题,我们提出了一种新的模态绑定学习框架,并重新设计了 Transf
本文通俗解析Agent核心概念:它不是聊天机器人,而是能自主完成任务的智能体。核心由大脑(大模型)、手(工具)、规划员、记事本(记忆)、说明书(技能)和统一接口(MCP)组成。关键在于“思维-行动-观察”循环(ReAct),大模型只负责决策,真正执行靠工具;MCP则提供标准化接口,降低外部能力接入成本。理解这五要素与三层结构(零件、接口、循环),就能看懂Agent如何协同“干活”。
本文围绕科研文献检索需求,结合AI翻译相关工具定位,推荐四款适配不同科研场景的文献检索工具:具备对话式梳理功能的切问学术、可全球聚合学术资源的Google Scholar、专注生命科学领域的专业数据库PubMed、支持自动抓取与管理文献的Zotero,助力科研人员高效精准检索文献,节省科研时间,为学术研究筑牢基础,适配科研新手到资深研究者的不同使用需求。
该数据集包含超过 70 万个任务,涵盖数学、编程和通用科学领域,数据规模达到 0.7M 级别,主要用于训练 GooseReason-4B-Instruct 模型,该模型在 15 个涵盖数学、编程、STEM 推理、指令遵循和逻辑谜题的基准测试中取得了 4B 级别模型的新最先进结果。教程涵盖容器、流、编解码器、数据包、帧与时间戳等基础概念,并通过可运行实验逐步实践视频同步、音频同步与媒体寻址,适合学习
AGI(通用人工智能)指具备类人通用认知能力的智能,能跨领域学习、推理、规划并自主解决问题。当前大模型如ChatGPT已展现强通用性,但仍未达真正AGI标准,核心差距在于跨领域迁移、长期规划与持续学习能力。AGI非单一“聪明”,而在于智能的可迁移与自适应。尽管技术快速演进,但可靠性、现实交互与对齐问题仍是挑战。未来关键不在于“何时出现”,而在于如何重构工作模式——人类将更聚焦于定义问题与协调AI,
本文从大语言模型基础原理出发,结合工程化实操,介绍如何快速掌握大模型应用。涵盖结构化提示词、思维链推理、少样本示例、API代码调用及参数调优5个核心方法,附带Python代码示例,帮助读者在实际场景中提升文本生成与逻辑处理效率。
你不需要猜测数据库喜欢什么关键词,直接用一段话描述你的需求,比如:“我想找关于‘可持续建筑设计评价方法’的英文论文,最好是近三年可以免费下载的。用好以切问学术为核心的这套“免费智能中枢+资源直通车”组合,你就能构建一个强大、高效且主要合法的学术资源网络,真正实现外国文献下载不求人。更重要的是,它能成为你探索其他免费资源的“智能中枢”。和最新的开放获取论文,将重要进展直接送到你面前,确保你紧跟真正“
本文用一套 9 道可验算的硬题,对 DeepSeek V4.1 Flash、Step 5、MiMo V2.6 Pro 和 MiMo V2.6 Flash 四款免费档大模型做了同台裸考实测。结论是:答案对错层面四家基本打平,所有翻车事故都集中在同一道矛盾检测题上;真正的差距在速度和稳定性——MiMo 深度惊人但思考动辄十几分钟,DeepSeek 则全程零错误、零崩溃、零等待。作者最终选择无脑 Dee
作者:元宝GPT-6 Astra 的发布信息很容易让人产生一种错觉:既然新模型在多项测试里刷新纪录,打开它,工作效率就会自动翻倍。现实通常没这么直接。OpenAI 在 9 月 22 日更新了 GPT-6 系列信息,Astra 正逐步向 ChatGPT Plus、Pro、Business 和 Enterprise 用户开放,也提供 API。它的重点是计算机操作、网页浏览、软件工程和专业文档,而不是单
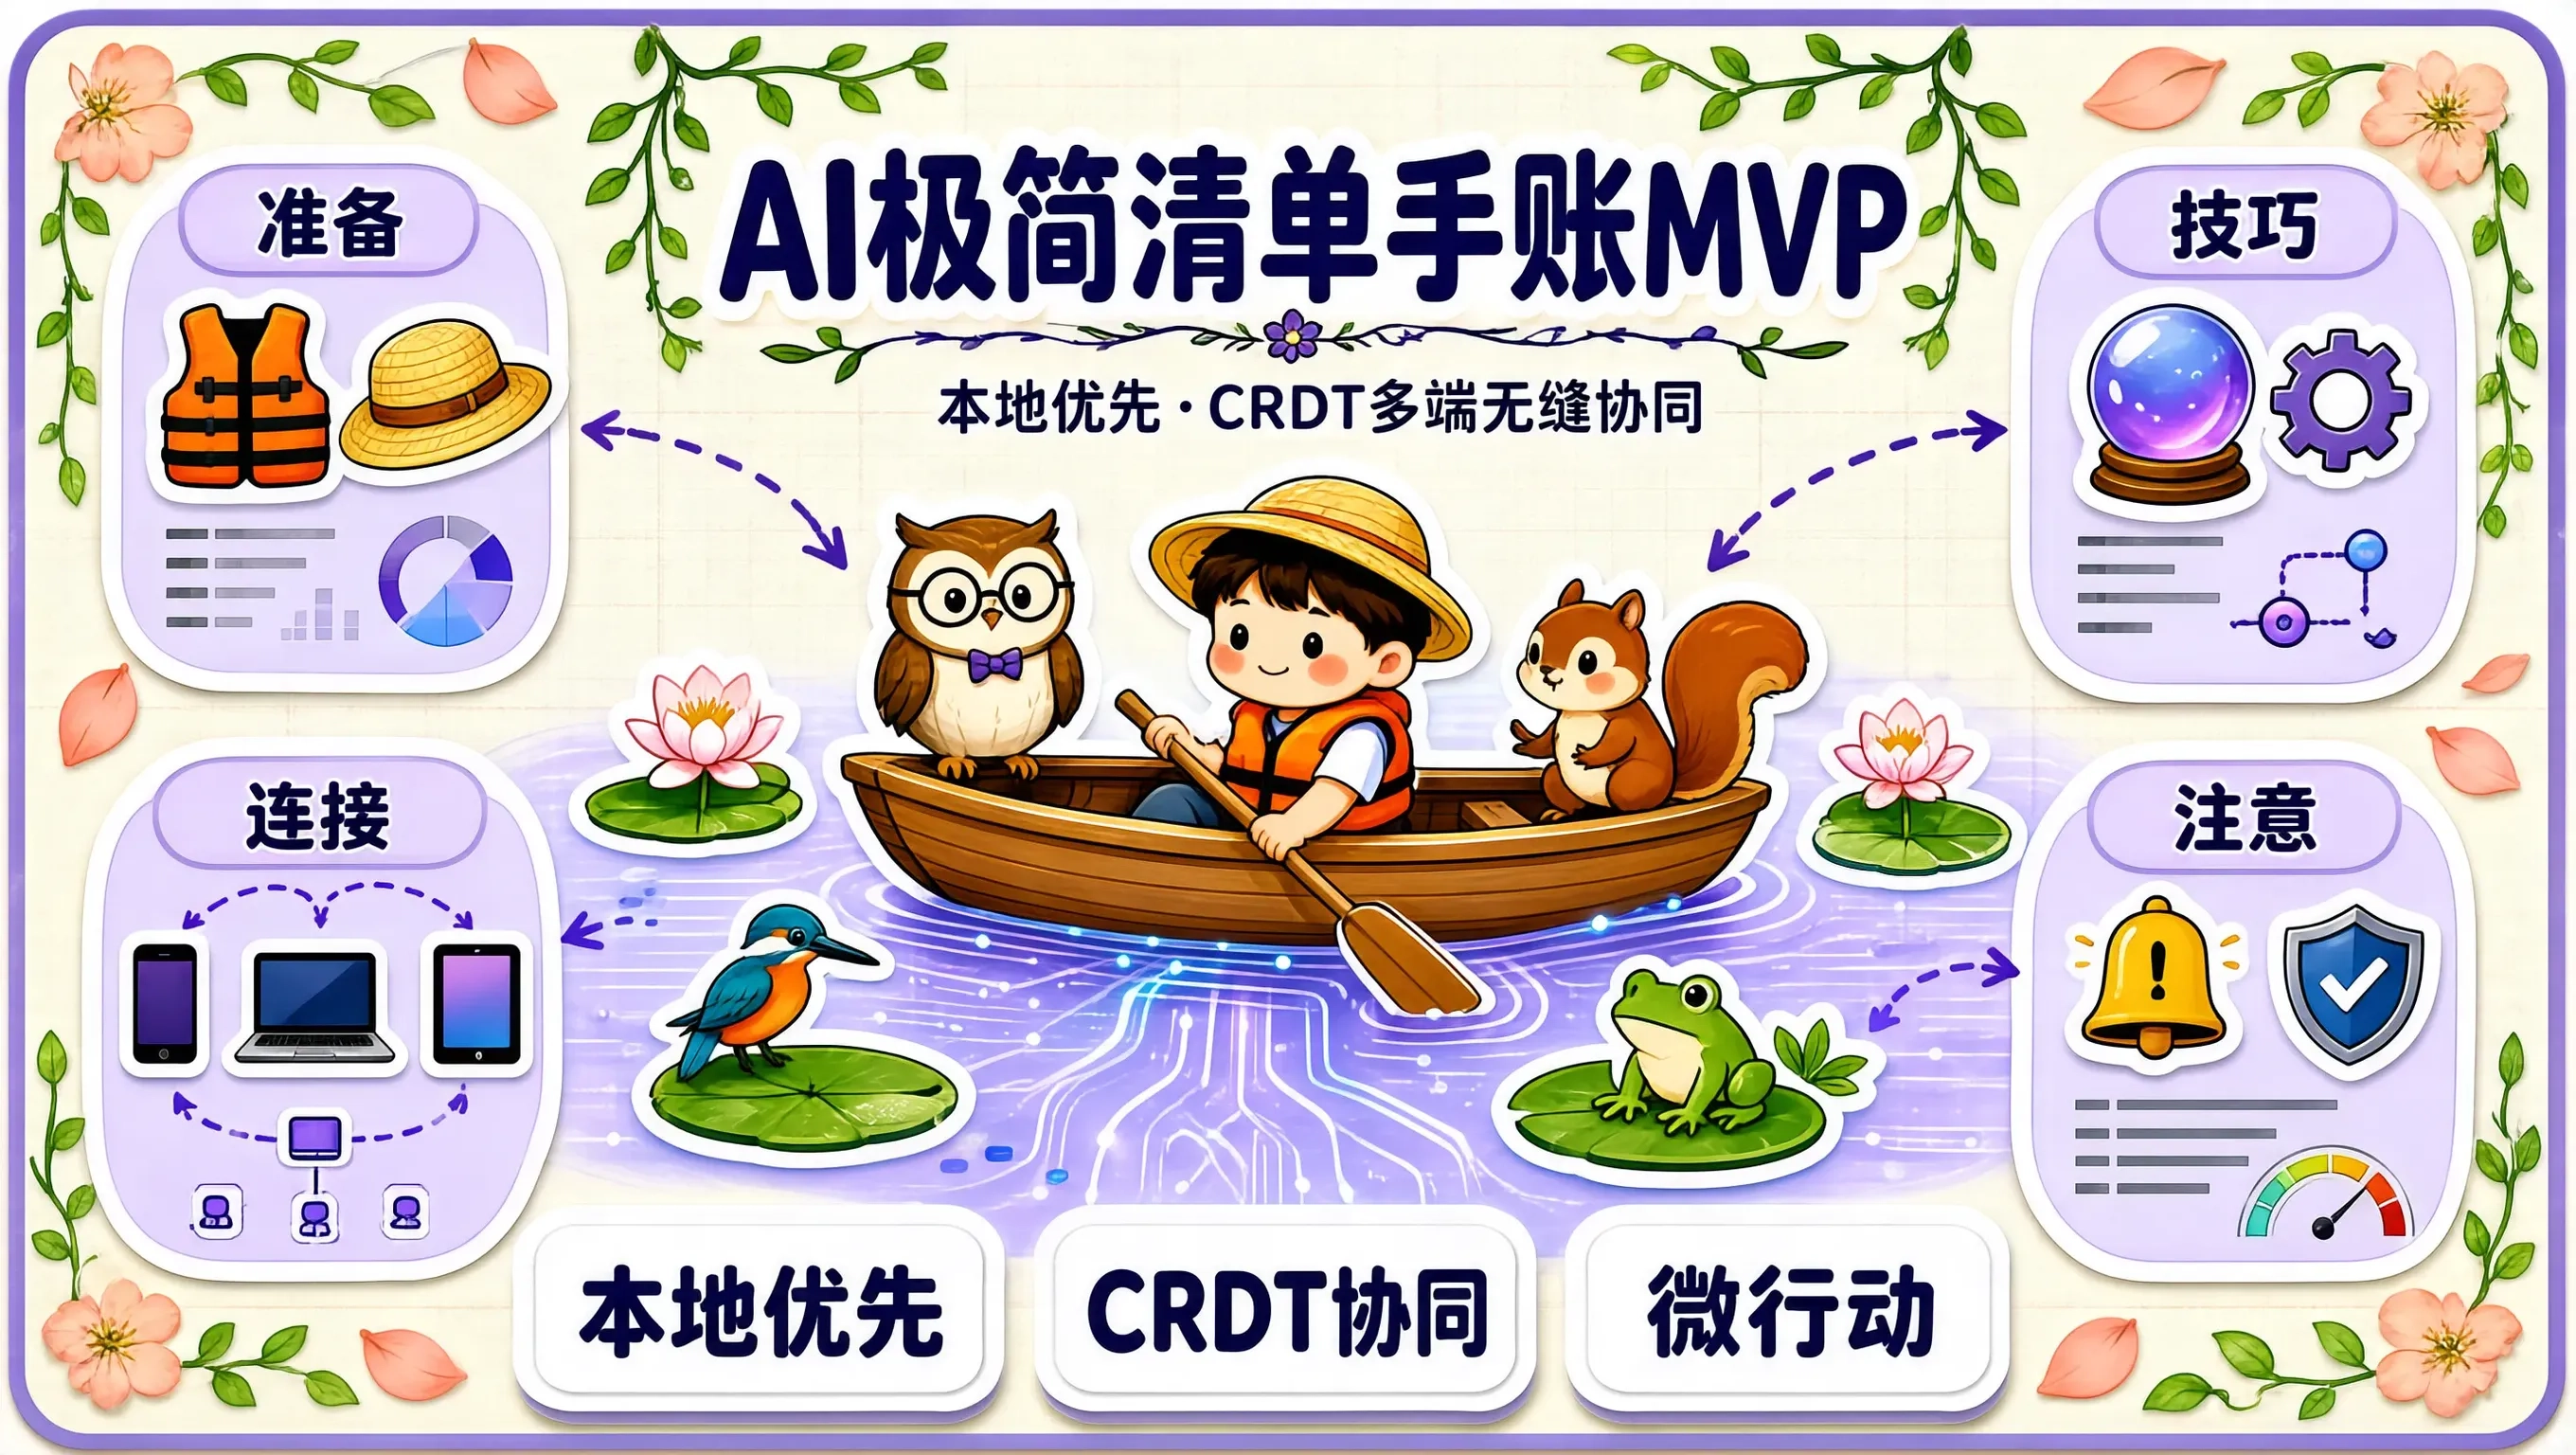
九月第四周的周三。经过连续三天的高强度编码与算法打磨,我的第四款核心作品——在本地局域网与跨端测试环境中正式跑通闭环!这是我们在整个九月技术沉淀最硬核的一次交付:它不仅继承了「Tide UI」温润治愈的手作视觉外壳,更在底层真正跑通了**“100% 本地优先(Local-First)+ 纯客户端轻量 CRDT 多端无缝协同 + 5 分钟微行动拆解”**的完整全栈架构。今天把这款 MVP 在多端设备
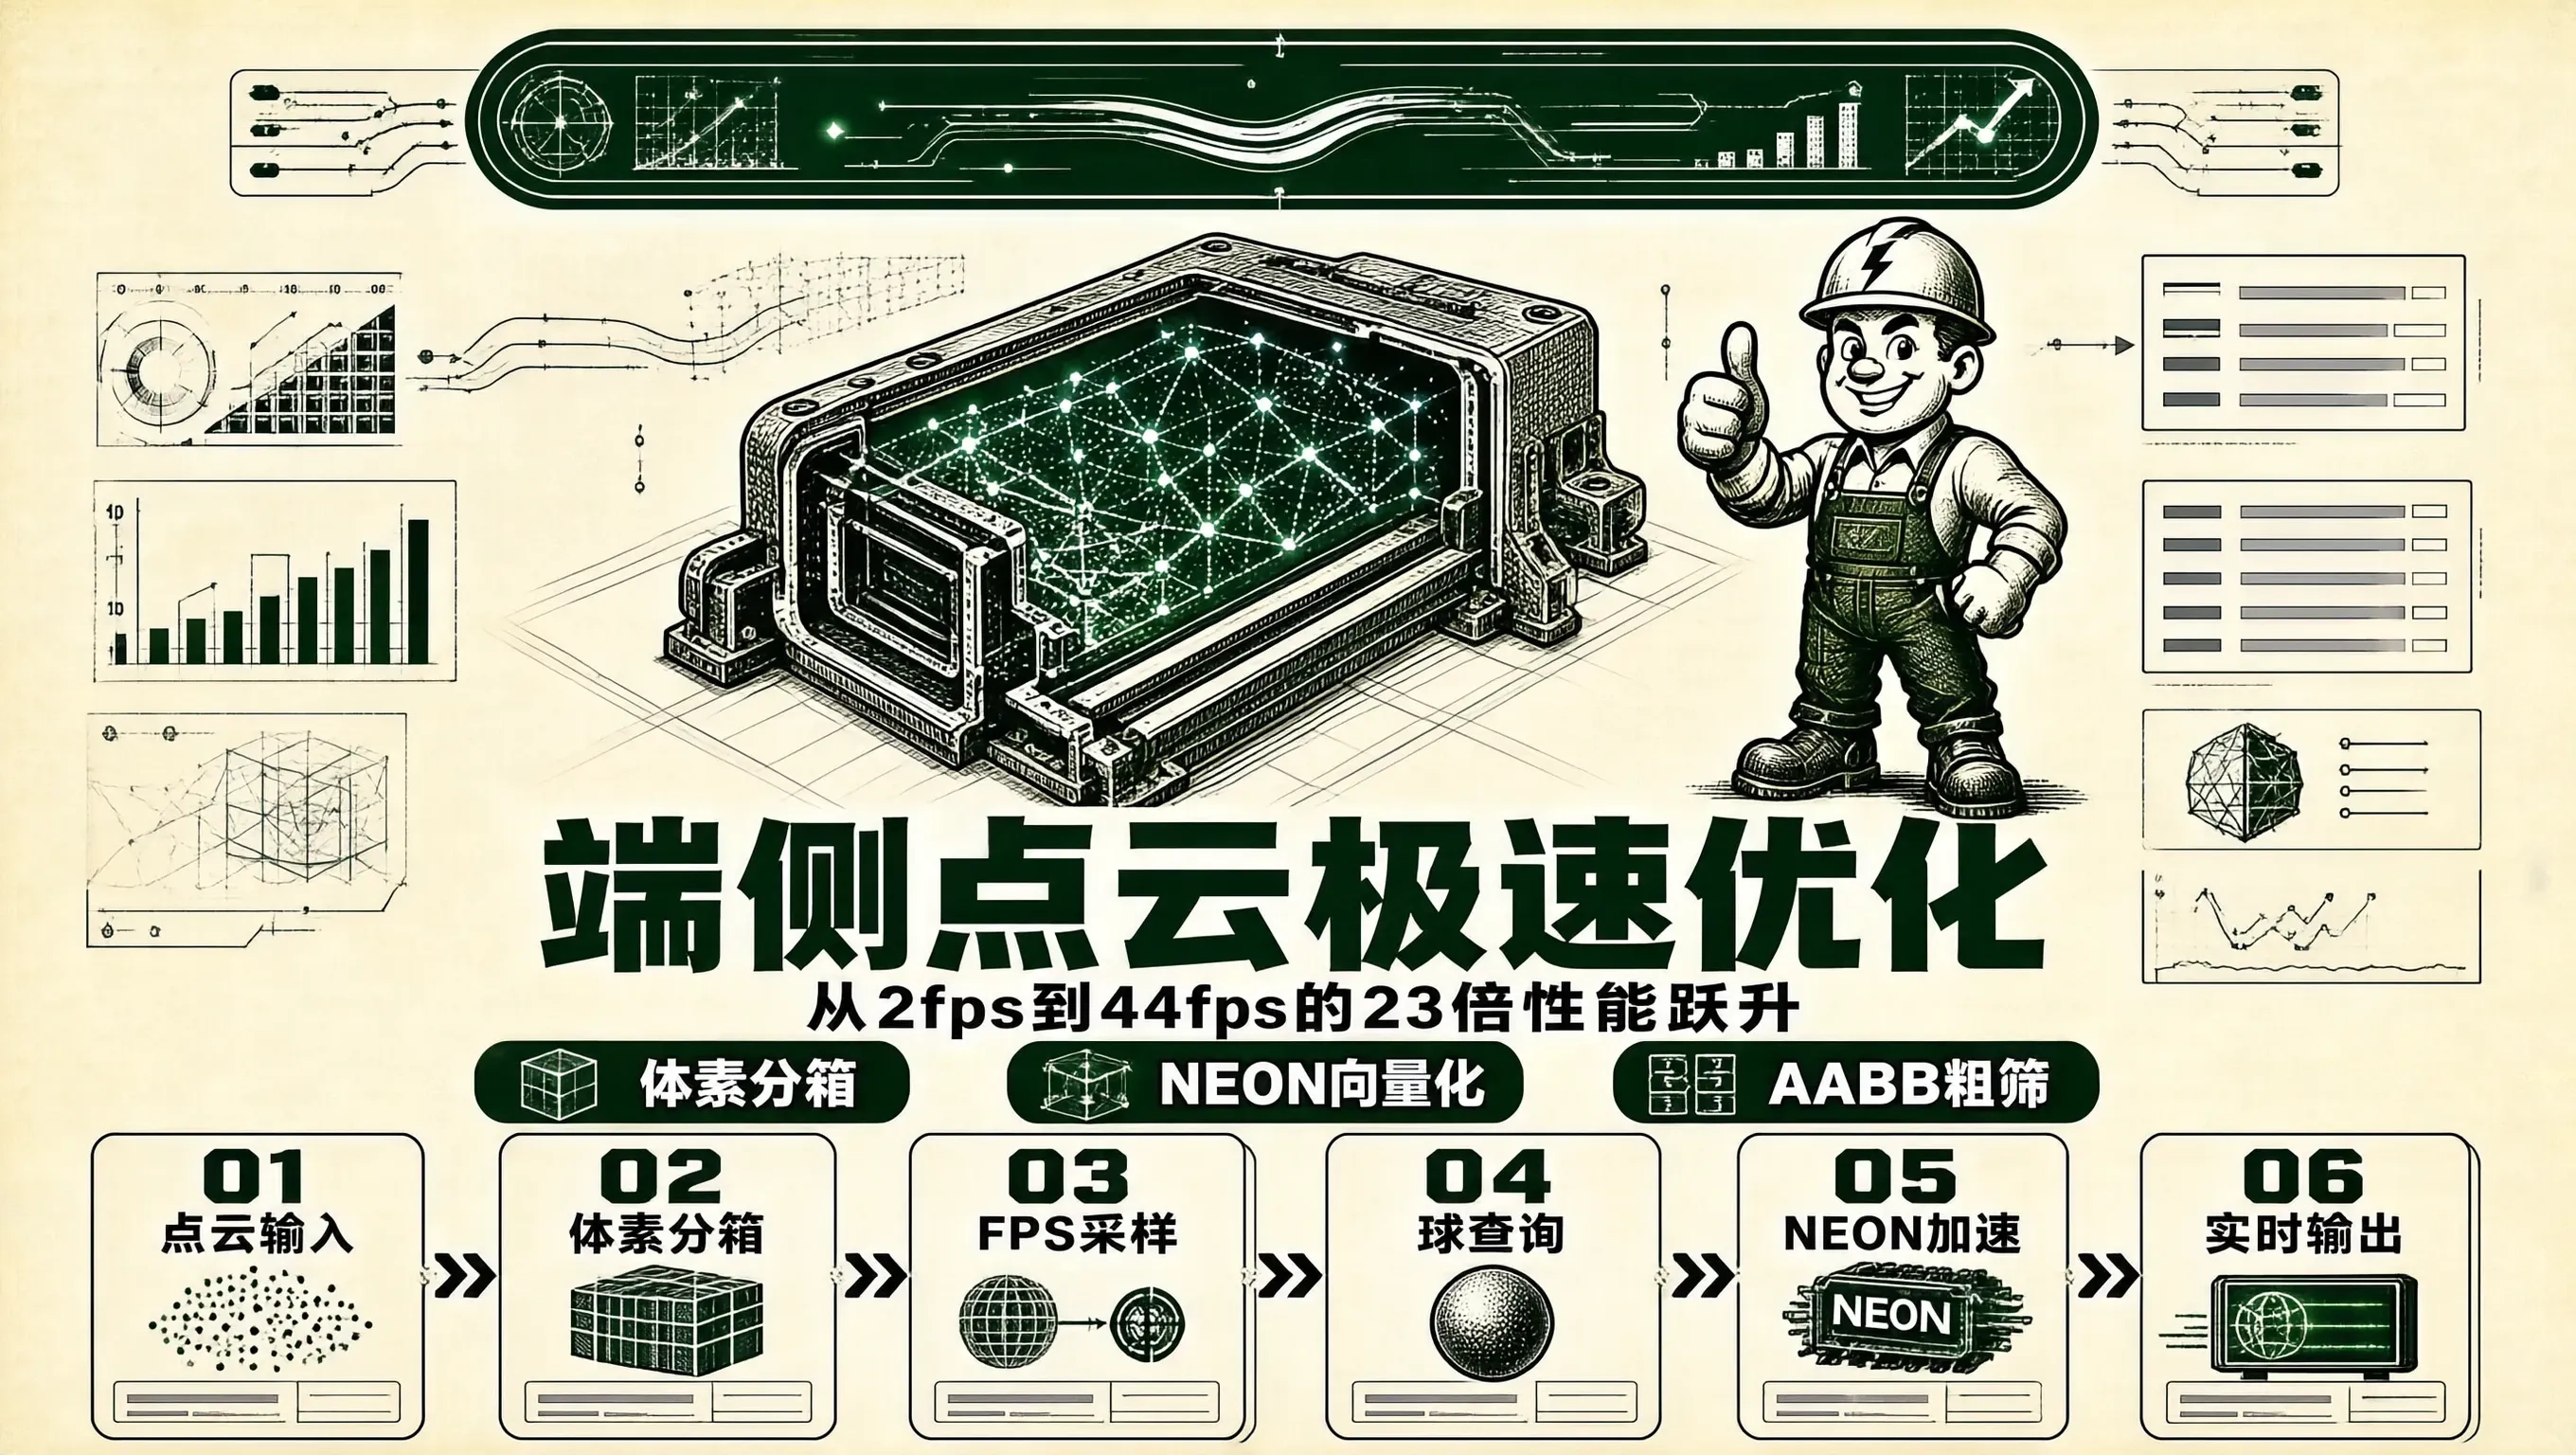
在自动驾驶低速物流车、工业 AGV 激光雷达避障、以及机械臂 3D 抓取引导等机器人系统中,是理解三维空间几何结构的核心算法底座。与二维图像像素点规则整齐的网格排布(2D Grid Array)截然不同,激光雷达每秒产生的数十万个空间点具有。然而,开源学术界原版的 PointNet++ 核心算子基于 CUDA GPU 编写,或者基于未经优化的 Python/PyTorch 库。通过以及,我们能够将
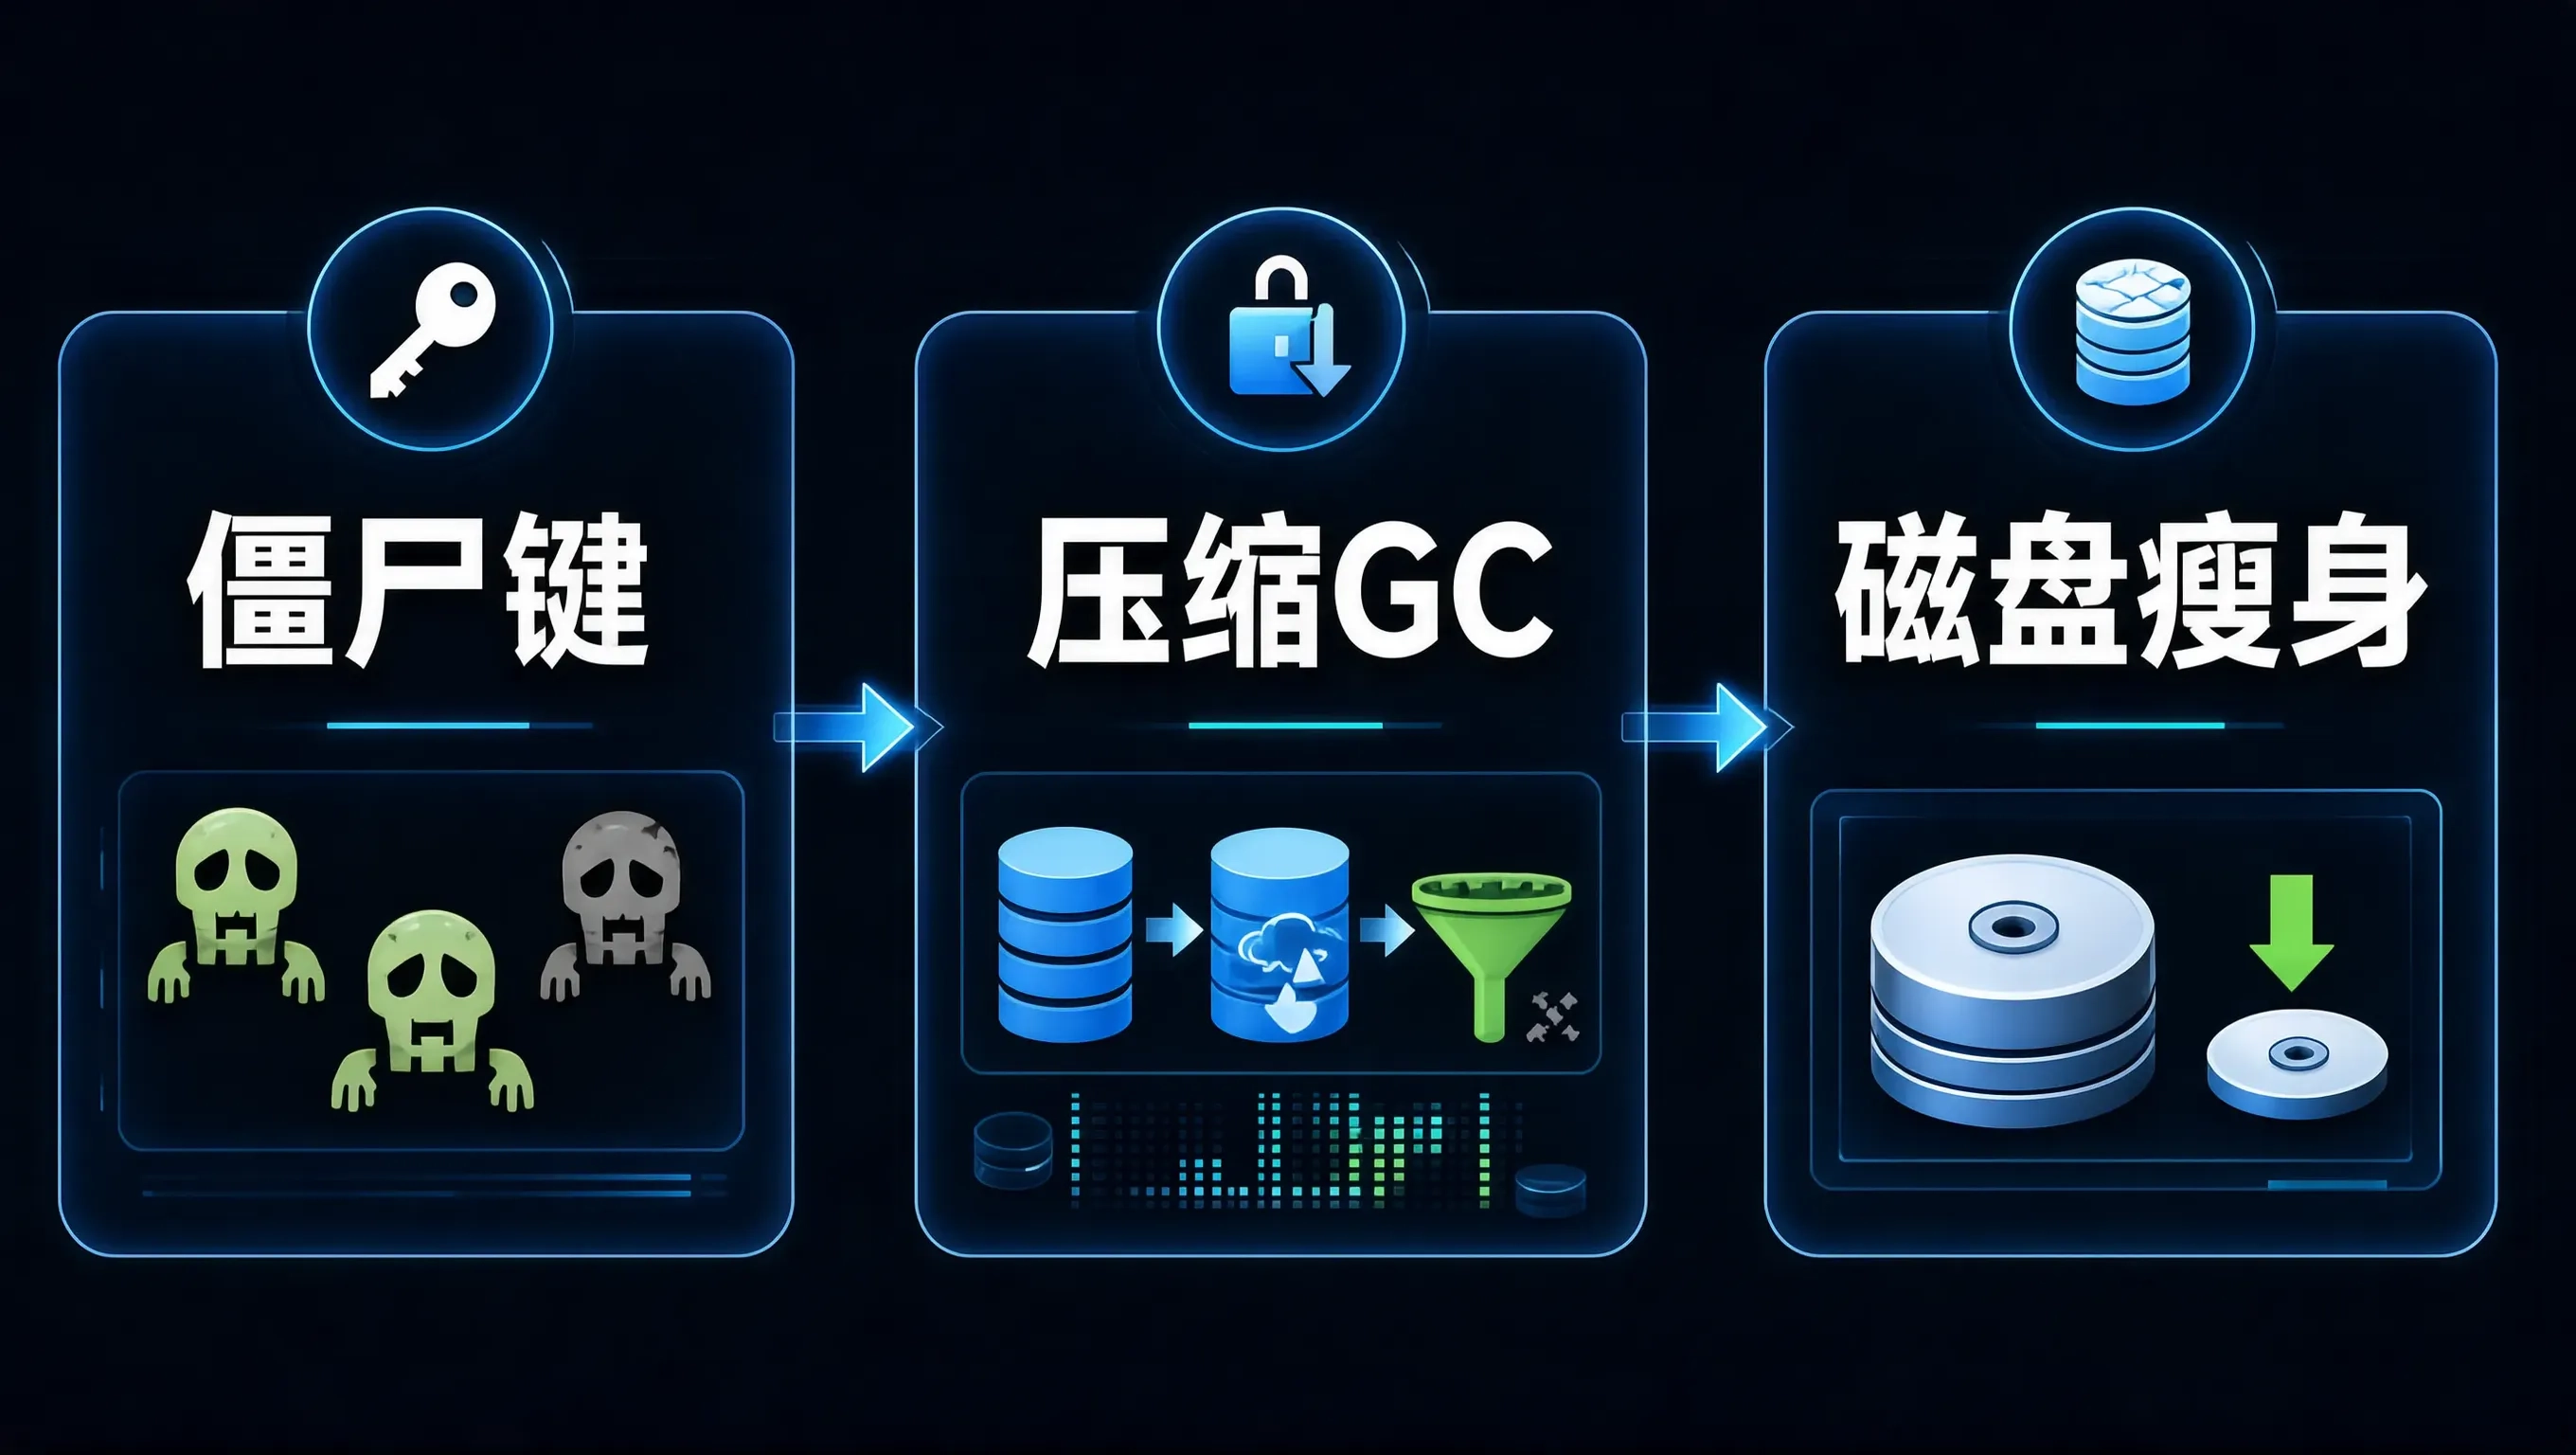
在 Apache Flink 构建 7x24 小时不间断运行的企业级实时数仓宽表与用户画像标签任务中,流计算工程师面临的一项最隐蔽、也是最具破坏性的“慢死故障”,莫过于**“无界流状态无限膨胀导致的物理磁盘打爆(State Unbounded Expansion & Disk Full Crash)”**。KeyedState为了从物理上根治状态无限膨胀,Flink 引入了革命性的。通过配合,可以
生成式AI重塑内容分发逻辑,GEO应运而生。与SEO争排名不同,GEO聚焦“被引用”——通过结构化内容、信源建设与持续监测,提升品牌在AI回答中的出现率与可信度。核心在于从“页面级博弈”转向“语料级博弈”,实现认知植入而非点击转化。需以数据驱动闭环优化,强调口径一致与跨平台可见性。小团队亦可切入,但需工具支撑真实效果追踪。一句话:SEO让人搜到你,GEO让AI愿意替你推荐你。
84% 的开发者已在使用 AI 编程工具,但到底该选哪个?本文横评 GitHub Copilot、Cursor、Windsurf、Claude Code、Cline、Tabnine、CodeGPT、Replit、Bolt.new、Manus 共 10 款主流工具,按使用形态分为 5 类,逐一分析核心功能、适用人群与优缺点,并附速查表和选型指南,帮你快速找到最适合自己的 AI 编程助手。
今天五条消息说明,AI 行业正在同时争夺能力、成本和工作入口。新模型向更低价格下沉,缓存降低长时间 Agent 的重复计算,机器人开始复用标准化技能,外部评估则要求更充分的证据。对个人和团队来说,选模型不应只看榜单,还要记录任务完成质量、总费用、人工复核时间与数据边界。只有这些环节一起成熟,模型升级才会变成稳定产出。明天见。
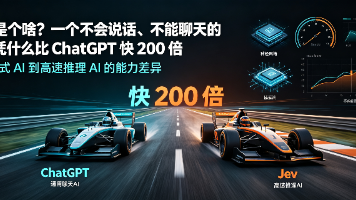
Jev是一款不聊天、不生成文本的“系统一模型”,由前OpenAI研究员Diogo Almeida创立的TypeSafeAI推出。它专精于快速、精准的判断任务,通过“填表式”交互实现零幻觉、高延迟低的自动化决策,适用于客服分类、缺陷评级等场景。相比传统大模型,其响应快200倍,成本低至1/444,但无法写代码或对话。它的核心价值在于:让智能真正落地,降低自动化门槛。
SFT 让模型学会遵循指令,但"遵循指令"不等于"回答得好"。RLHF(Reinforcement Learning from Human Feedback)通过人类偏好数据训练奖励模型,再用强化学习优化模型,使其输出符合人类偏好。这是 ChatGPT 成功的核心技术。本章详解 RLHF 的三阶段框架、奖励模型与 PPO 算法。
26年9月来自港中文、港大和英国牛津大学的人类未来研究所(Future of Humanity Institute,FHI)的论文“WholeBodyWAM: Generalizing Pre-trained World–Action Priors to Humanoid Loco-Manipulation via WBC-Grounded Coordination”。这篇论文 WholeBody
26年8月来自上海创智学院、智元机器人和港中文的论文“τ0-VLA: a Hierarchical Robot Foundation Model with World-Model-Guided Test-Time Computation”。其最有价值的贡献,是把长任务中的“下一步做什么”变成可增加推理预算的决策过程,并将它接入真实机器人的控制闭环。实验显示该方向有效,但对收益来源、物理预测可靠性和
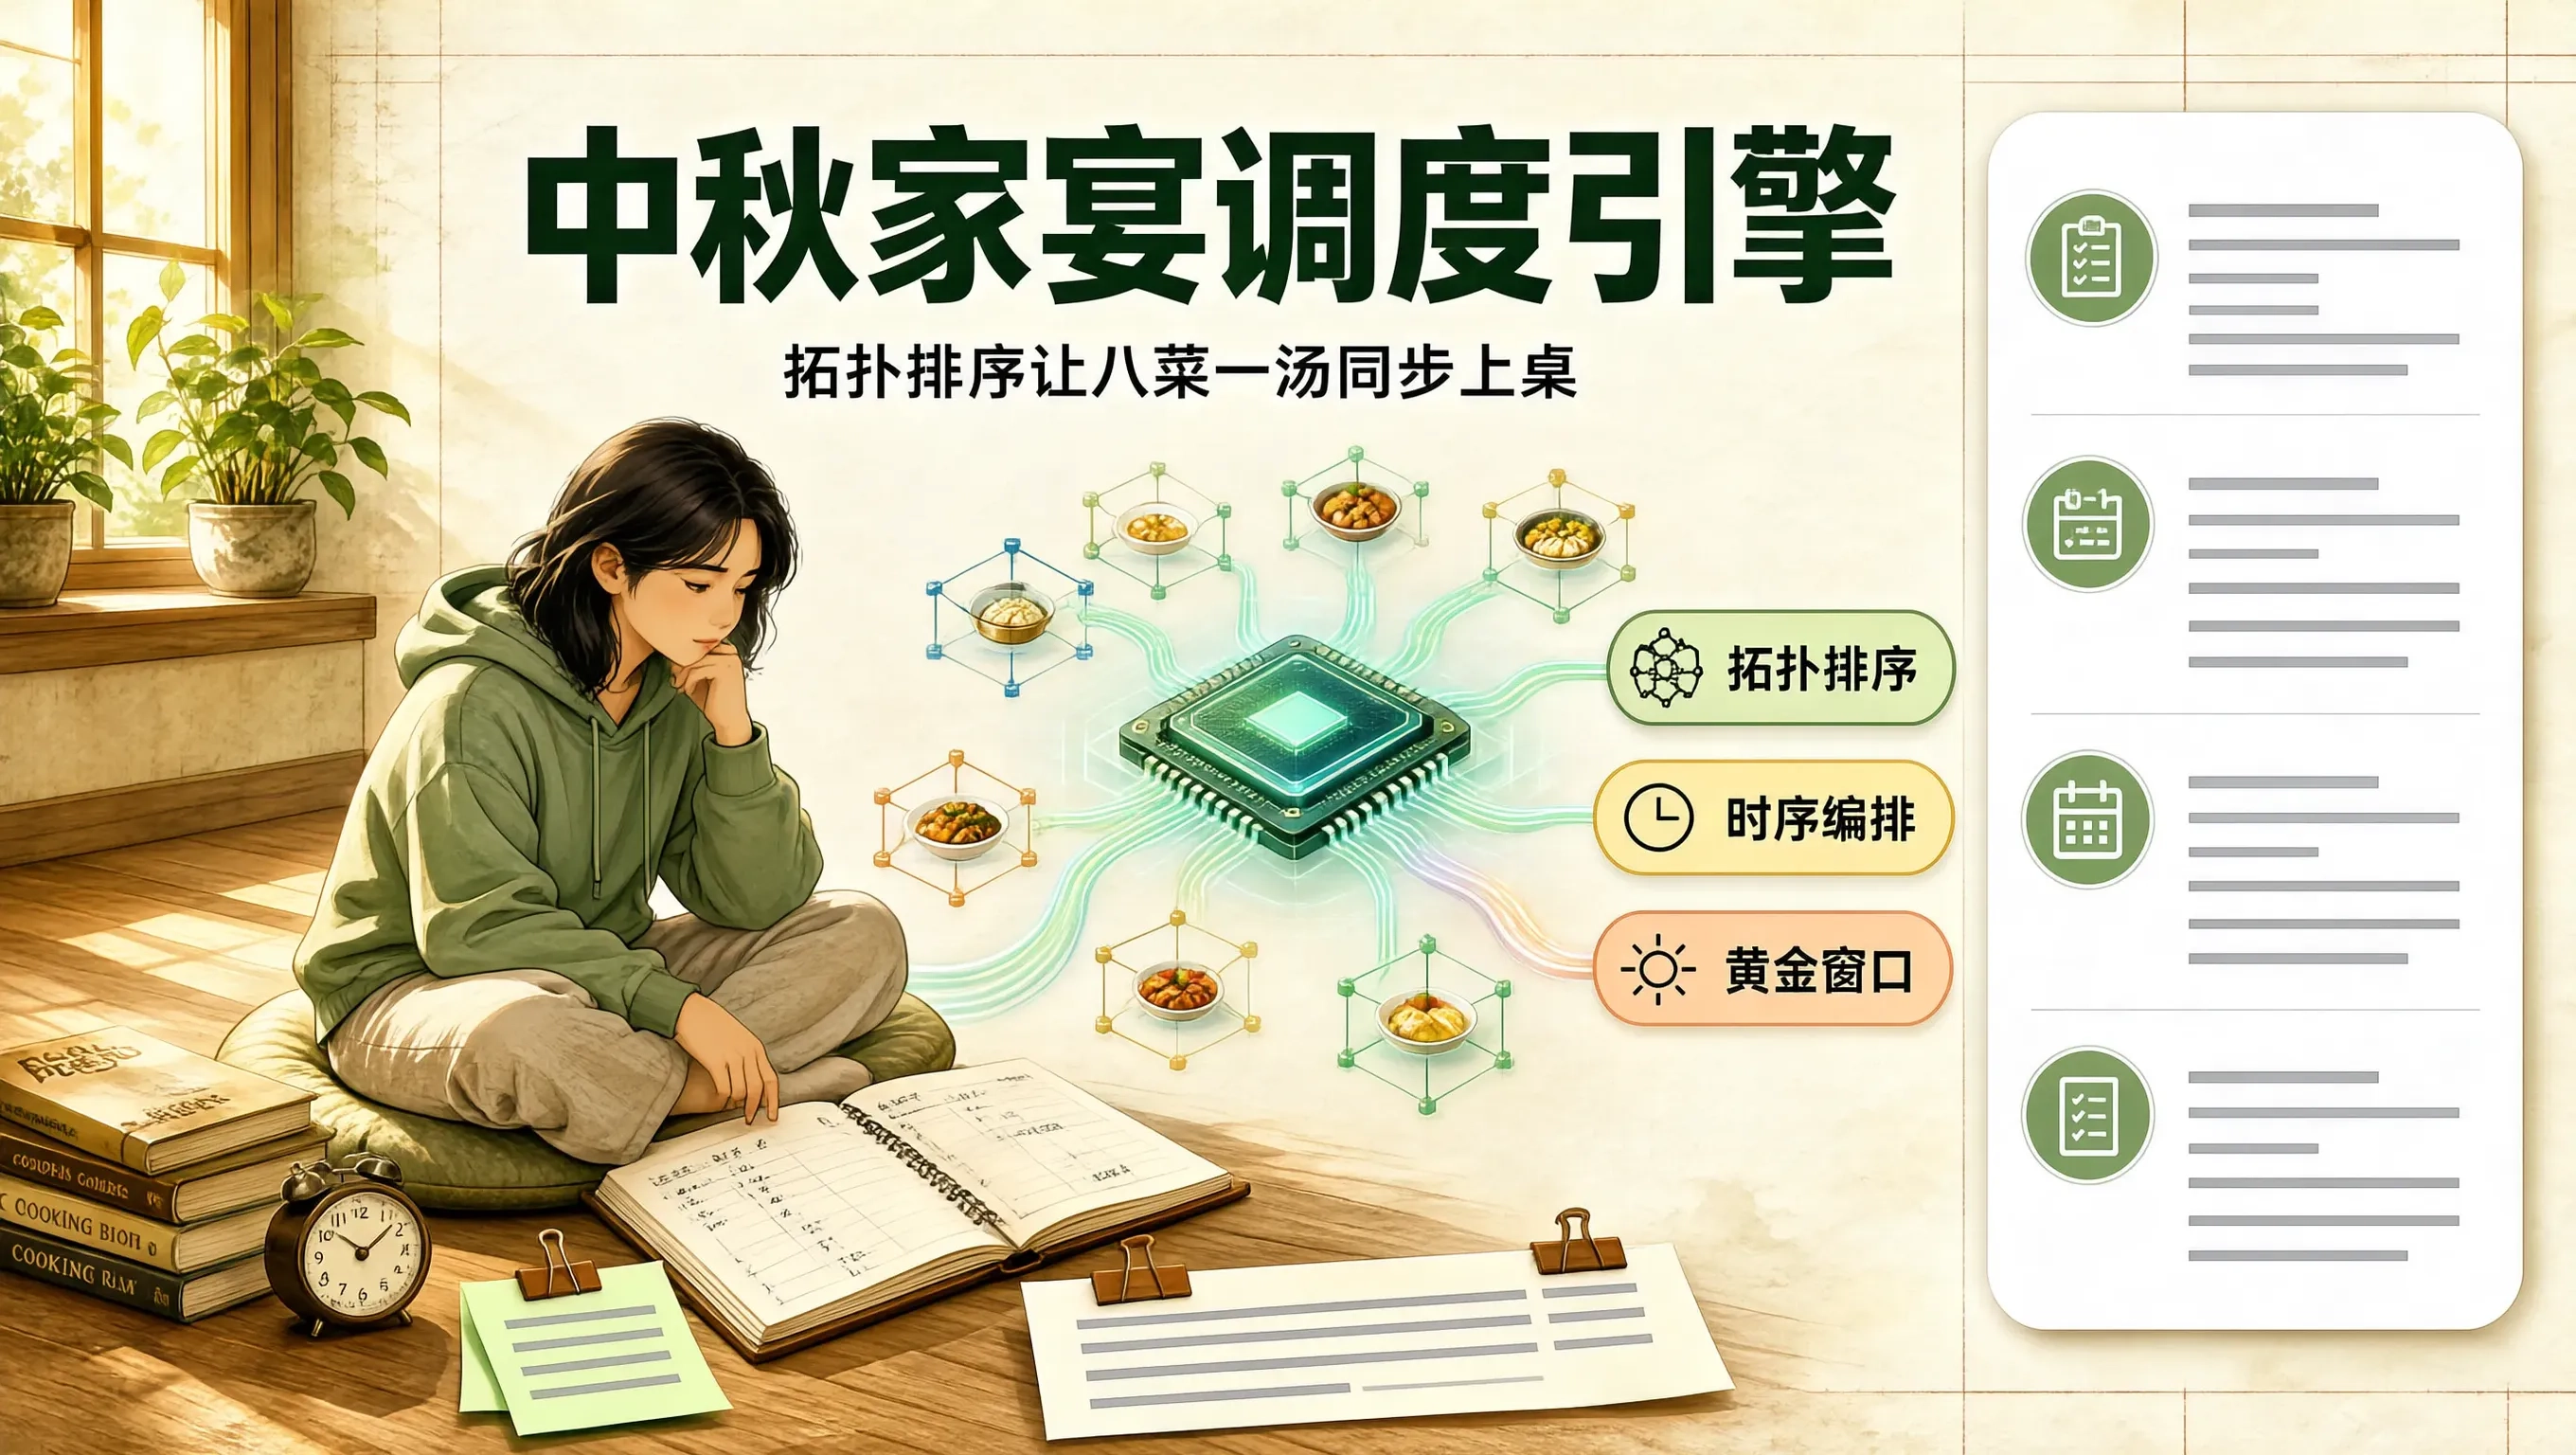
中秋佳节的团圆家宴,是全家一年中规模最大、菜品最丰盛的一顿大餐(通常包含):清蒸太湖大闸蟹、桂花糖藕、东坡肉、清炒百合莲藕、松鼠鳜鱼、老鸭笋干煲、鲜肉月饼、桂花酒酿圆子。然而,对于掌勺的老妈来说,做一桌八菜一汤的家宴常常是一场在计算机操作系统中,这是一个典型的。为了让老妈能够,我设计了一套。
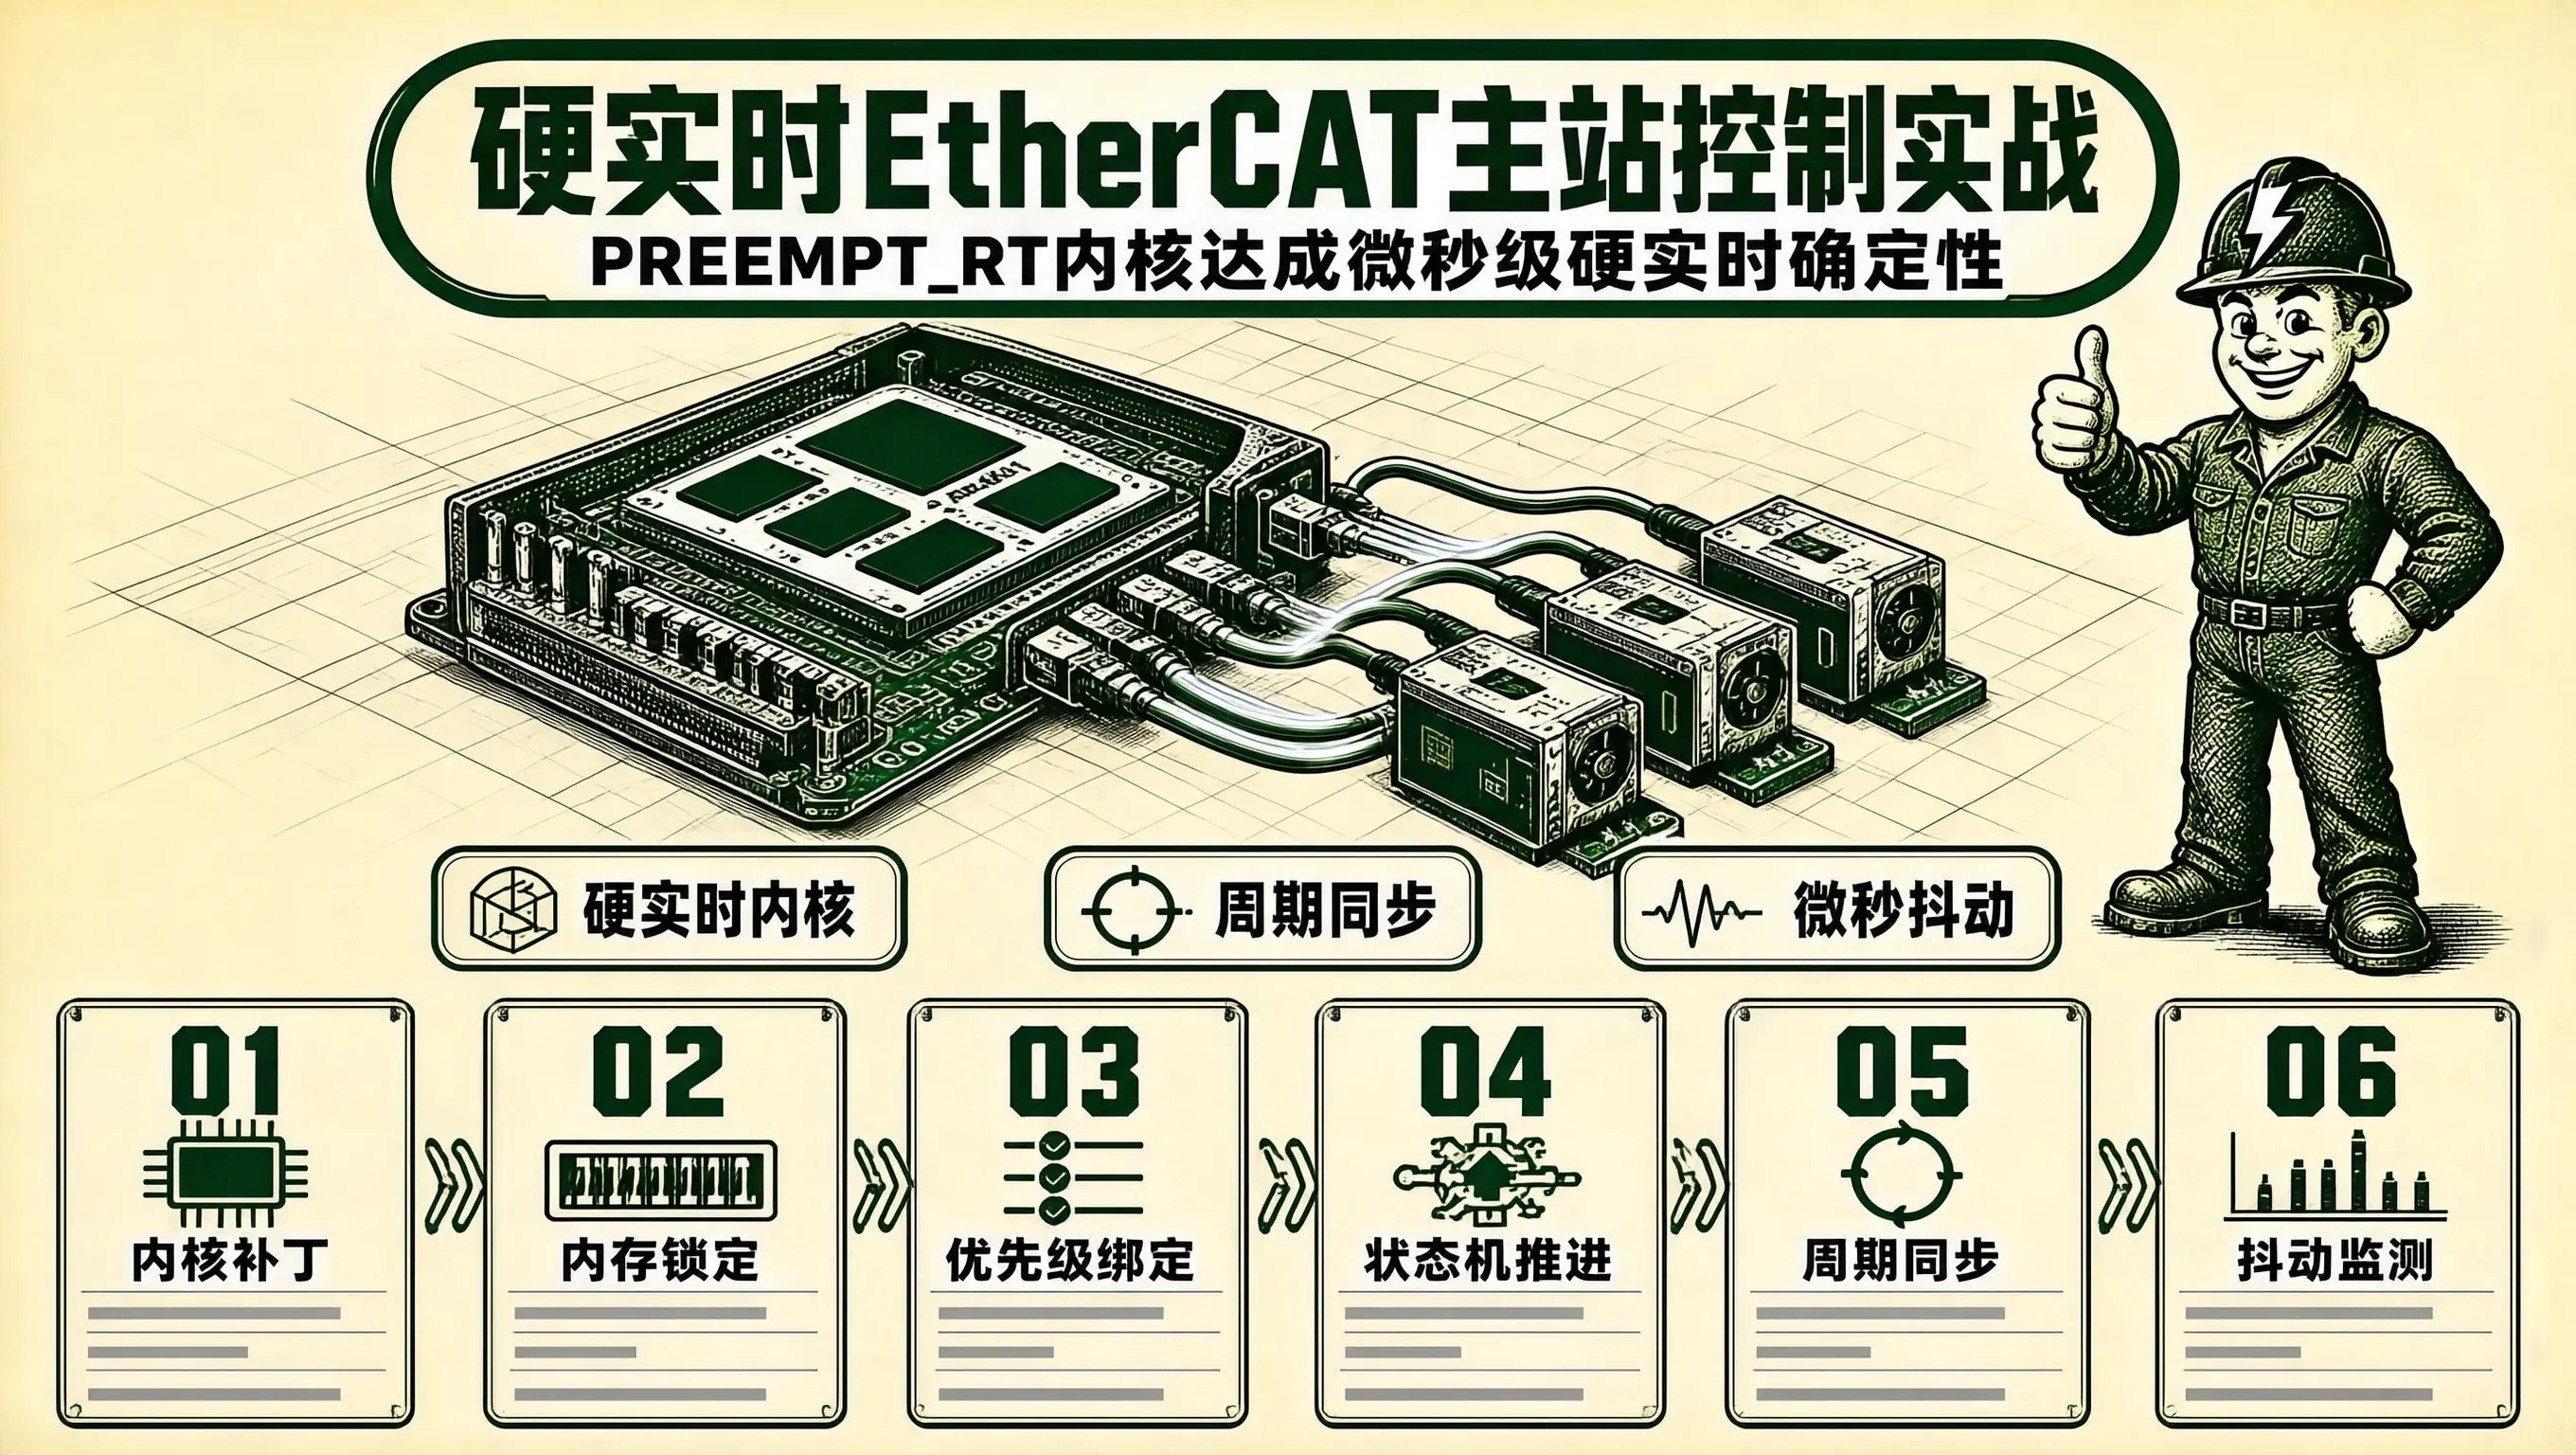
在多轴工业机器人、高精度数控机床(CNC)以及半导体封装设备中,是目前全球工业现场实时性最高、抖动最低的工业以太网现场总线之一。在 EtherCAT 网络中,主站(Master)通常通过标准的以太网物理网口连接多个从站伺服驱动器(Slaves / 如汇川、松下、倍福伺服)。主站必须以,周期性地向网线发送过程数据对象(PDO, Process Data Object),同步刷新所有电机的目标位置与速
在百万级高并发大促活动打响之前,对核心 Rust 底座(包含手写无锁环形队列、自定义内存池、SIMD 裸指针运算与 FFI 跨语言边界)执行 全面的 Unsafe 专项安全审计,是保障系统绝对零崩溃的最后一道硬核防线。很多开发者以为:“只要我的代码通过了 ,且在高压测试下没有触发操作系统 Segfault,代码就是绝对安全的。”然而,在 Rust 与 LLVM 编译器的严谨语义世界中,存在着大量极
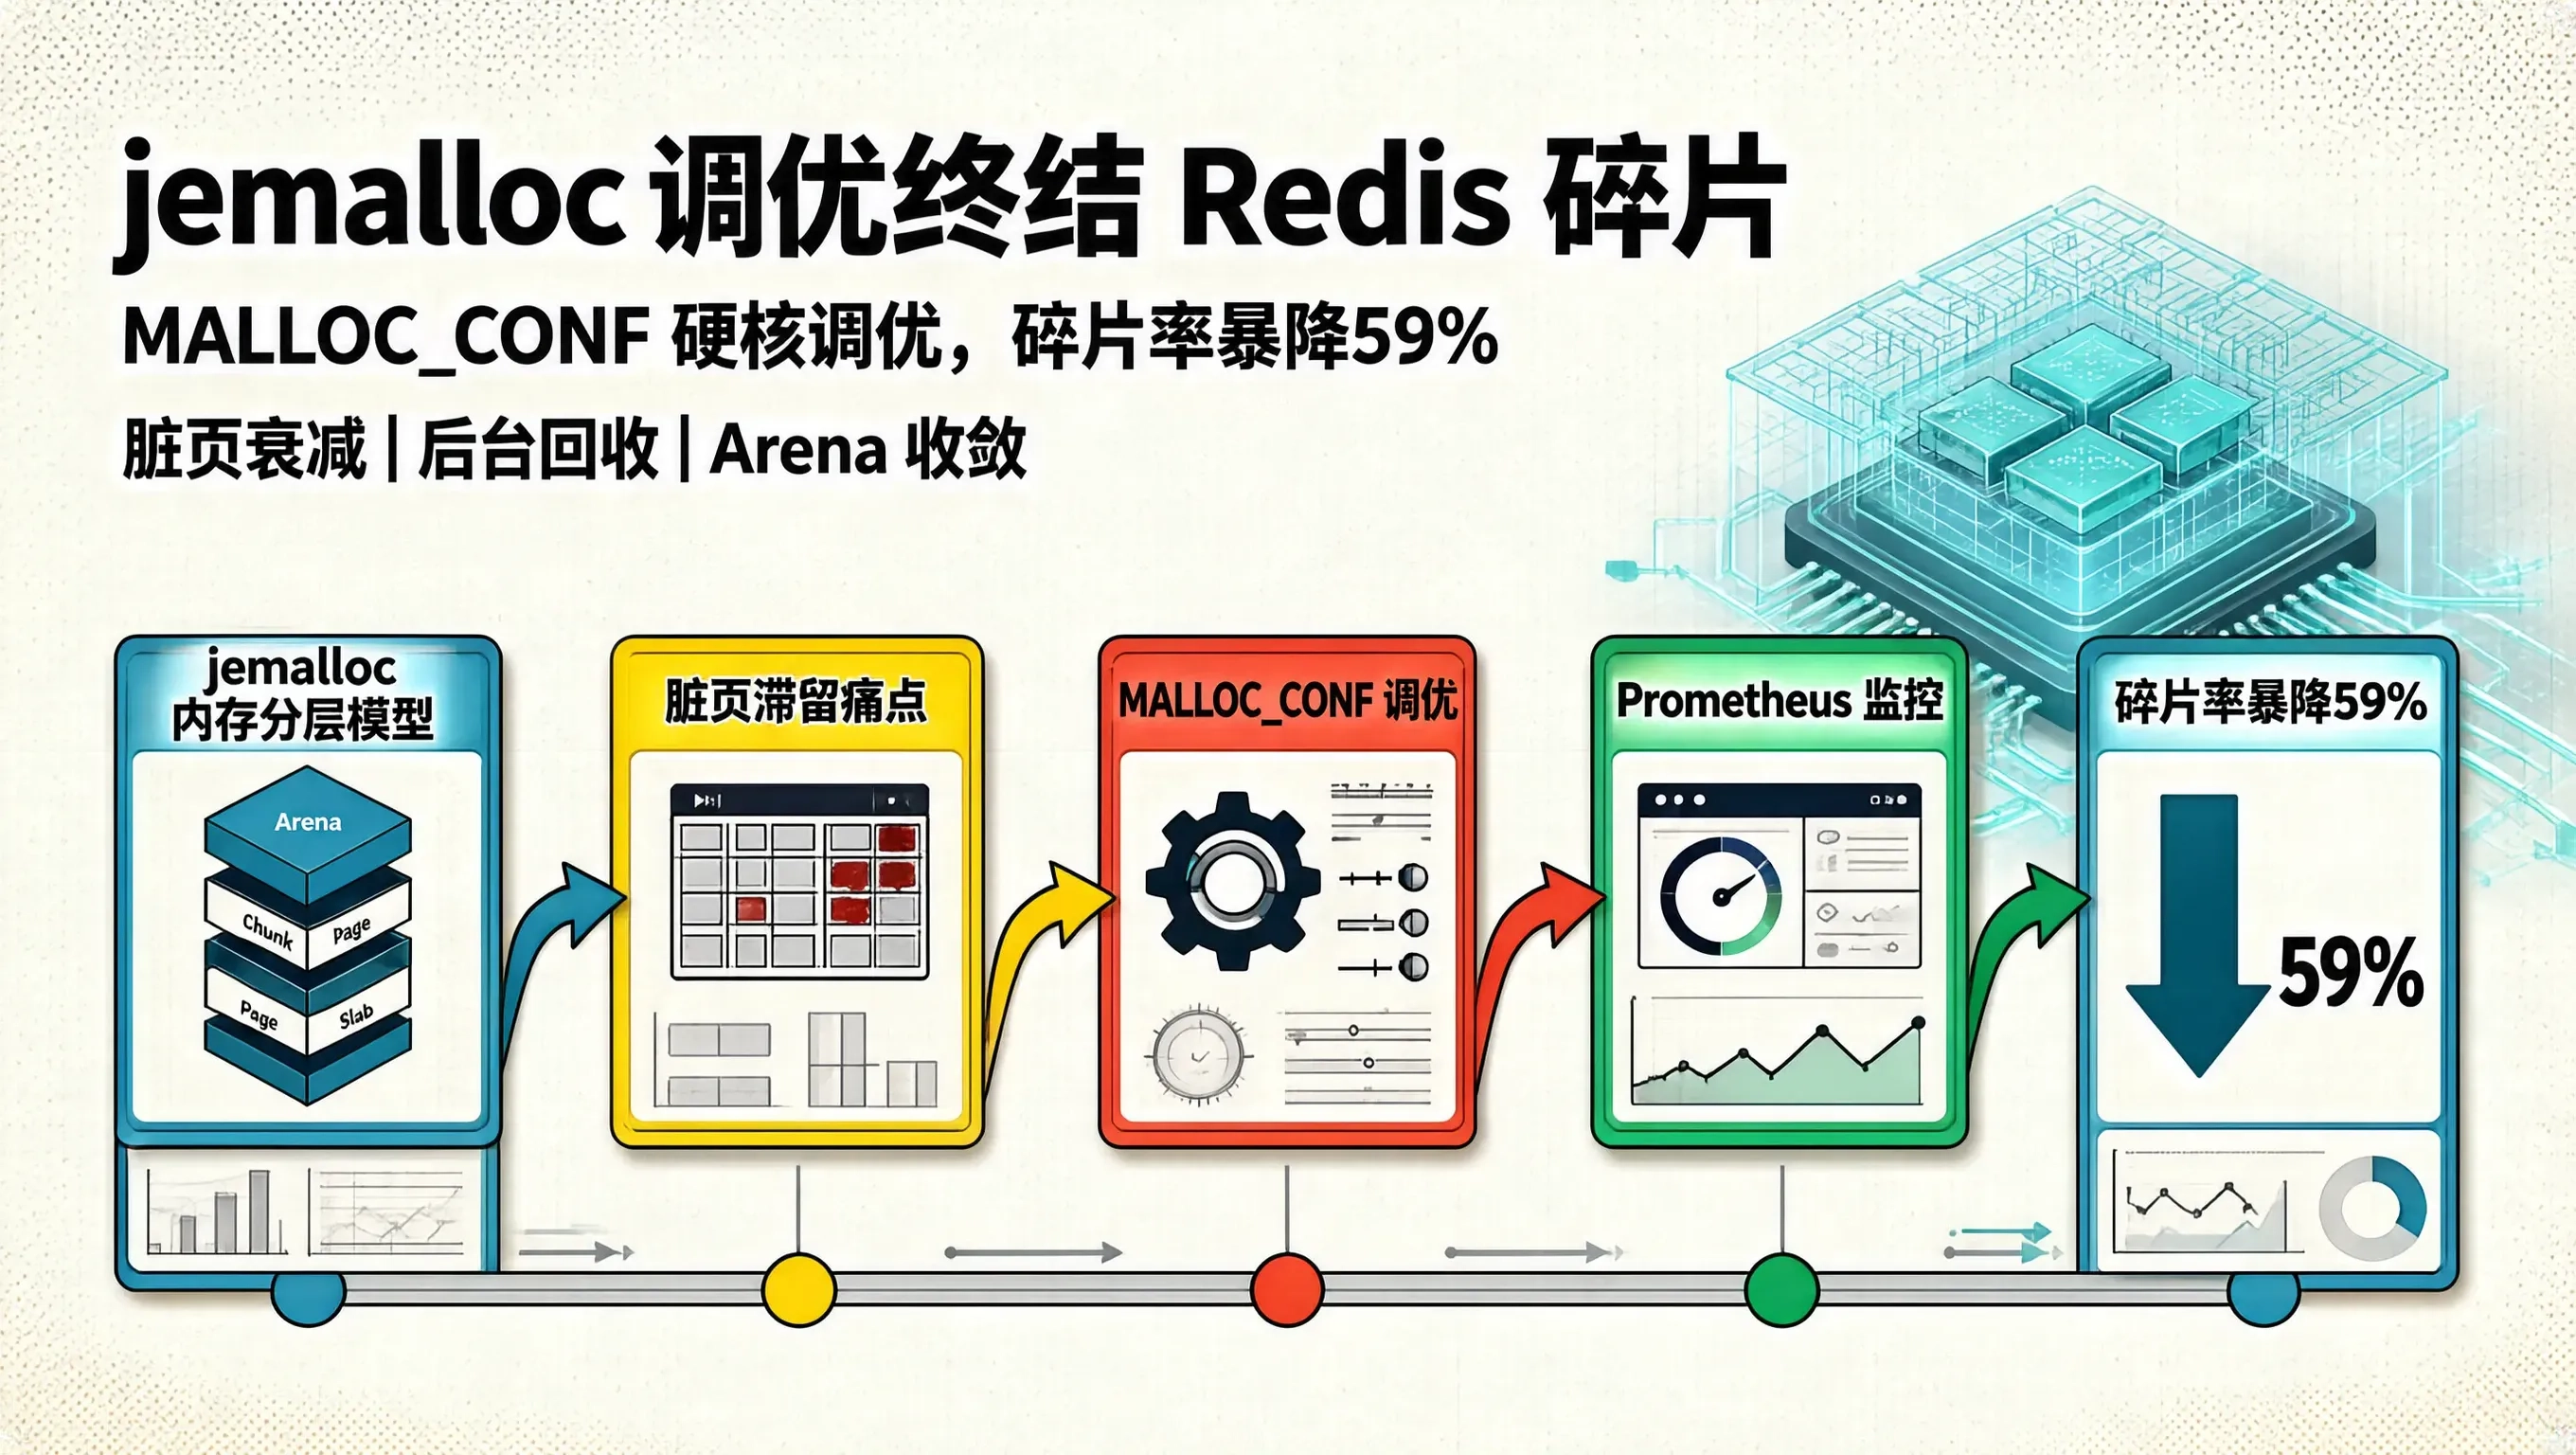
真正的系统级性能调优,必须直击操作系统的底层分配器。“通过开启 jemalloc 后台回收线程,将脏页衰减时间压缩至 1 秒,将 Arena 数量死死限制在 2 个”,配合 Prometheus 深层度量监控,从物理内存最底层彻底终结 Redis 碎片虚胖,是用硬核内功为企业换取数倍硬件利用率提升的工业级技术典范。
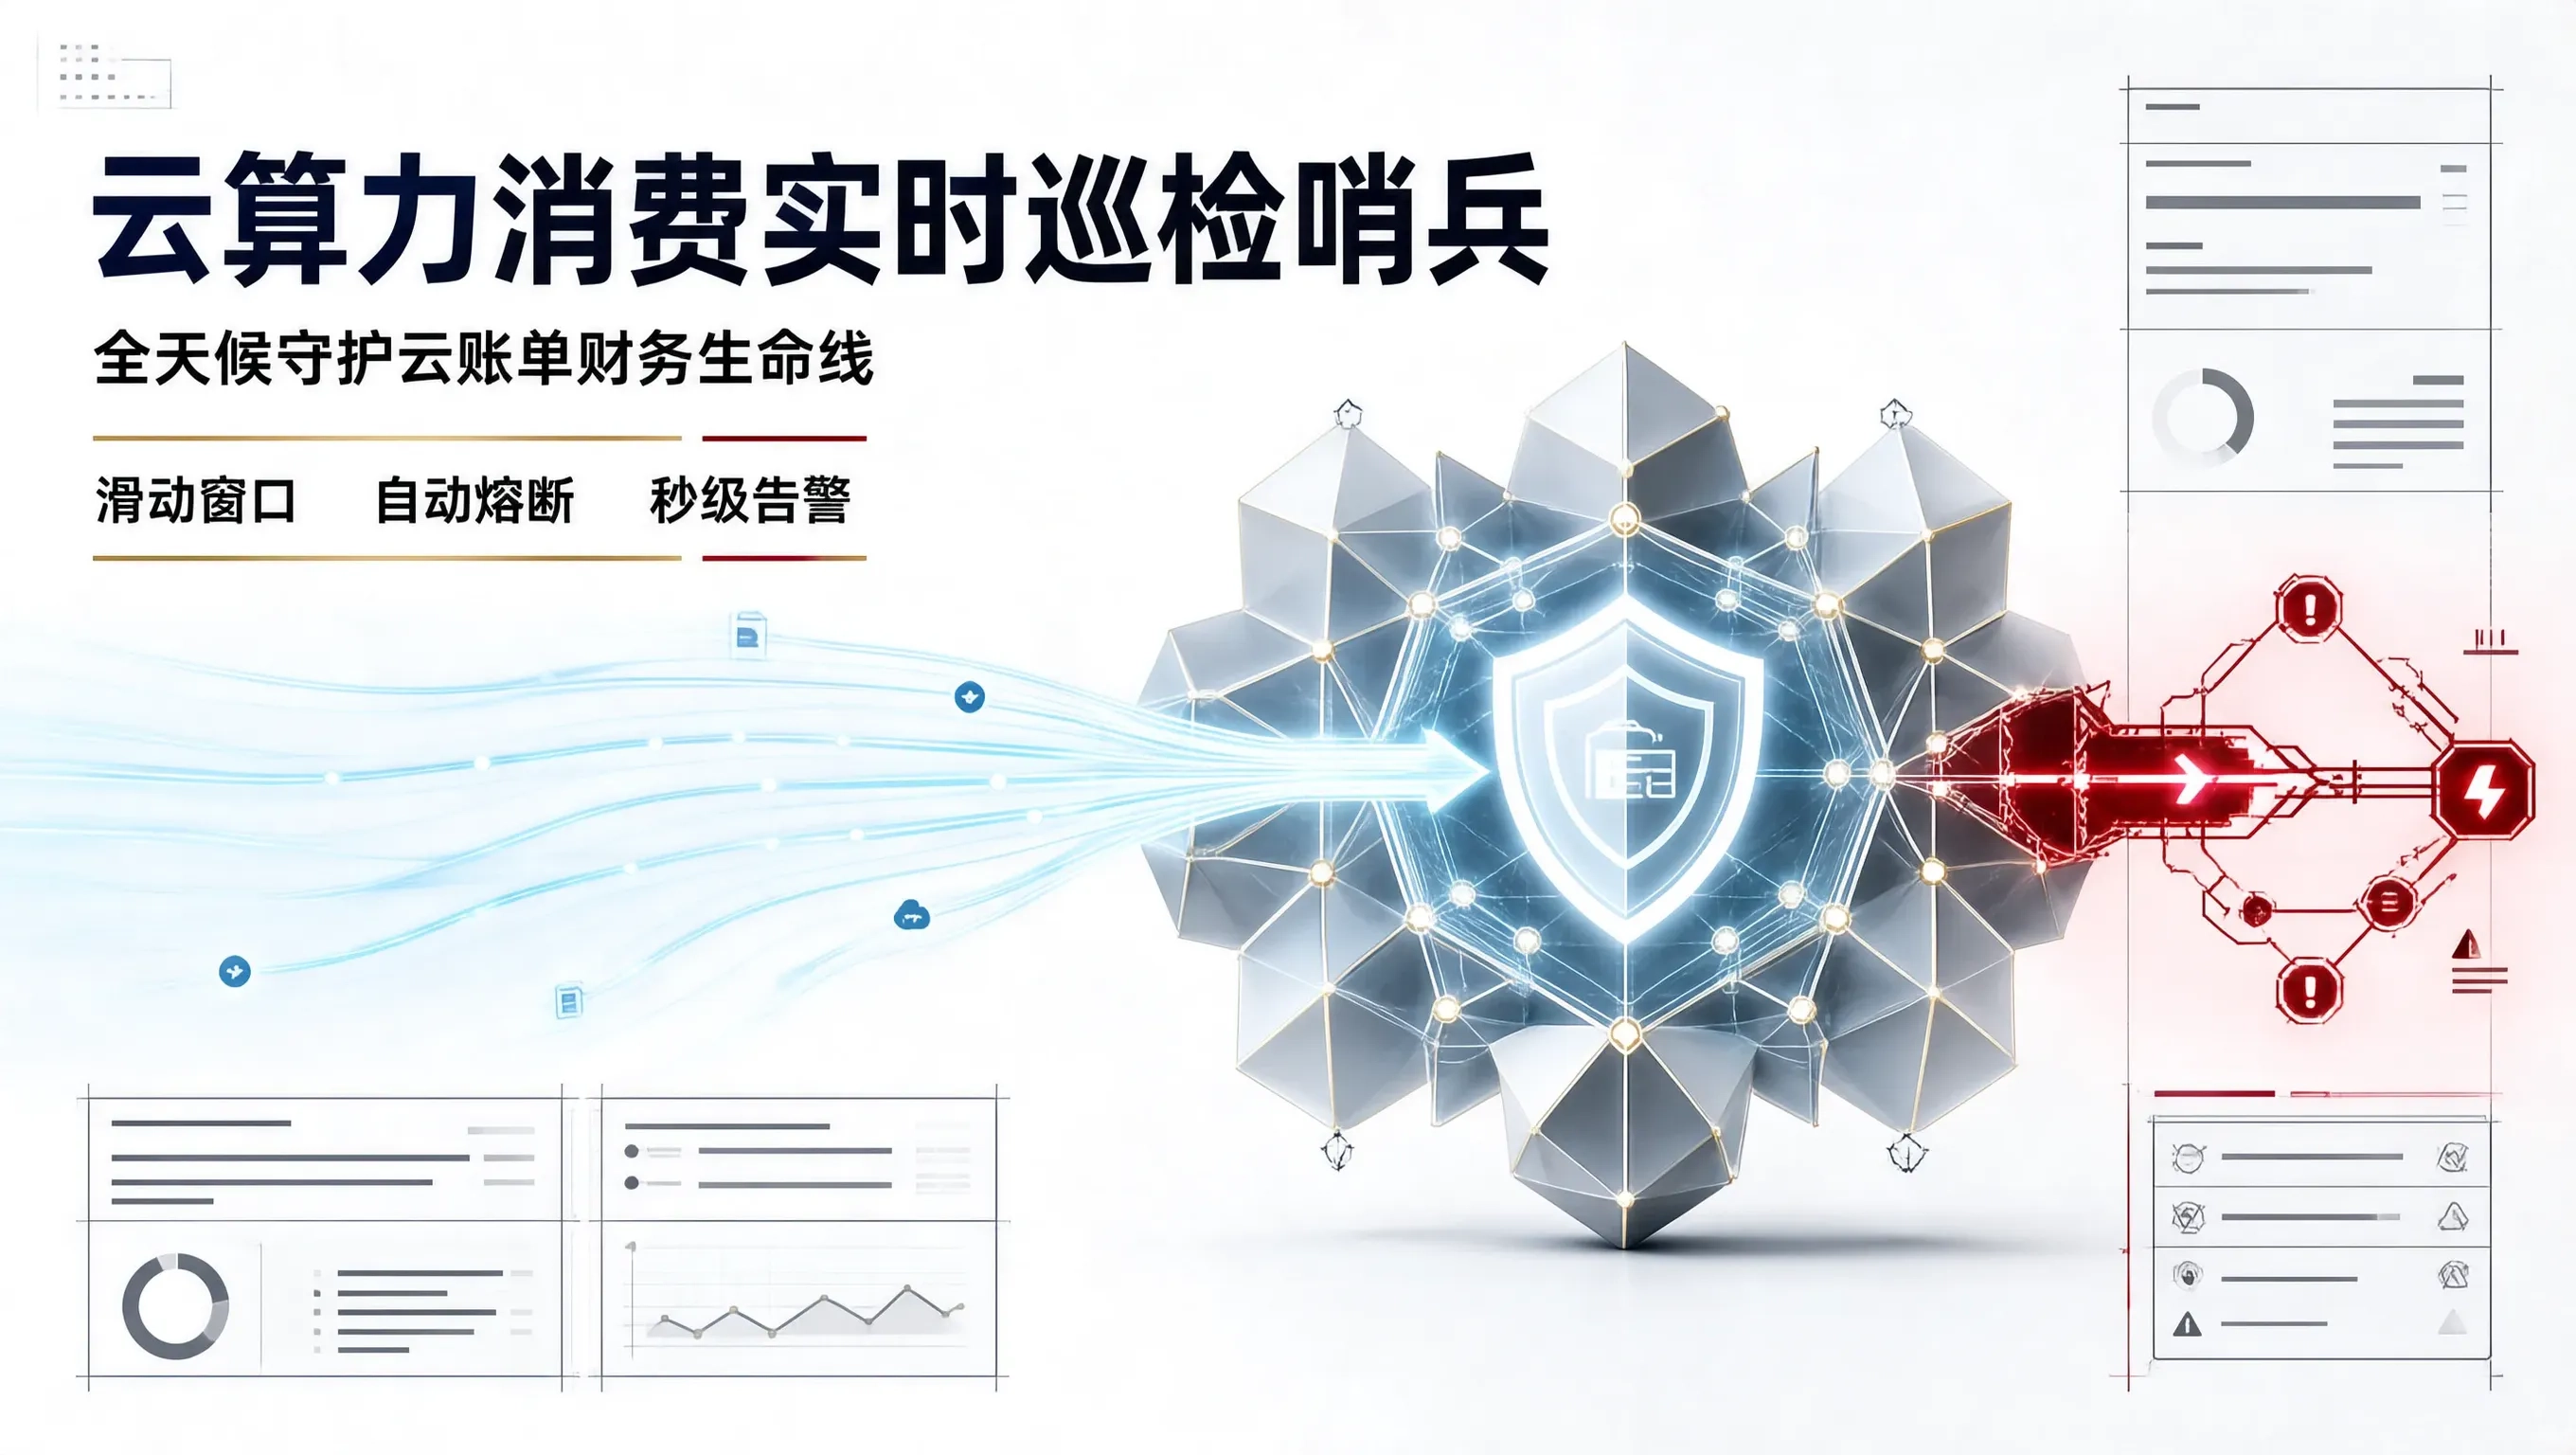
在云计算与大模型 API 的日常使用中,“”是每一个技术团队最深沉的梦魇。如果团队仅仅依靠“月末看一眼云厂商月结账单”或者“依赖云厂商默认延迟长达 24 小时的账单预警”,灾难发生时公司现金流早已被洗劫一空。构建一套,基于滑动窗口(Sliding Window)每 5 分钟探测消费速率,
在持续集成(CI/CD)体系中,人工测试无法满足每日构建(Daily Build)的高频性能回归需求。人工跑测不仅耗费大量人力,而且测试路径随机、技能释放时机不一致,导致捕获到的 FPS、内存占用与发热数据存在严重噪声,难以横向比对不同代码提交(Git Commits)带来的细微性能劣化。构建基于引擎内嵌的自动化跑测机器人(Autopilot Monkey),结合确定性路径巡航(Determini
本文从特征提取、可解释性、数据依赖与计算资源四维对比机器学习与深度学习,厘清二者本质差异;并通过文本、图像、音频、视频生成案例,直观展示生成式AI的创造能力。课程旨在构建技术认知坐标系,为后续大模型实操奠定清晰概念基础。
2026 年 9 月 15 日,TypeSafe AI 发布了 Jev——一款不做文本生成、只做结构化决策的"System One 模型"。创始人 Diogo Almeida 是 RLHF 的共同发明人之一,也就是让 ChatGPT 真正好用的那套训练方法。Jev 不讲段落、不写代码、不做解释。它只回答三种问题:从选项里选一个(Choice)、给一个分数(Score)、给一个是/非的概率(Noul
本文系统解析AI智能体(Agent)的三层技术架构:模型基础层(如LLM、Token、上下文窗口)、能力增强层(如RAG、Function Calling、Memory)与工程协作层(如MCP、Multi-Agent、Orchestrator),通过通俗类比与图解揭示Agent如何实现自主规划、工具调用与多智能体协作,区别于传统聊天机器人。强调其底层逻辑稳定,有助于快速掌握新兴术语,是理解AI A
Salesforce 推出 Agentforce Coworker,将AI从“聊天机器人”升级为企业的“数字同事”。在Adecco全球2.7万名员工中,该系统通过统一数据层(Data 360),让AI不仅能理解自然语言、跨系统查询信息,还能协调专业Agent执行任务,如提交请假、更新客户信息等。这标志着企业AI正从“信息检索”迈向“任务执行”,成为连接员工与业务系统的智能操作入口,真正实现“AI协
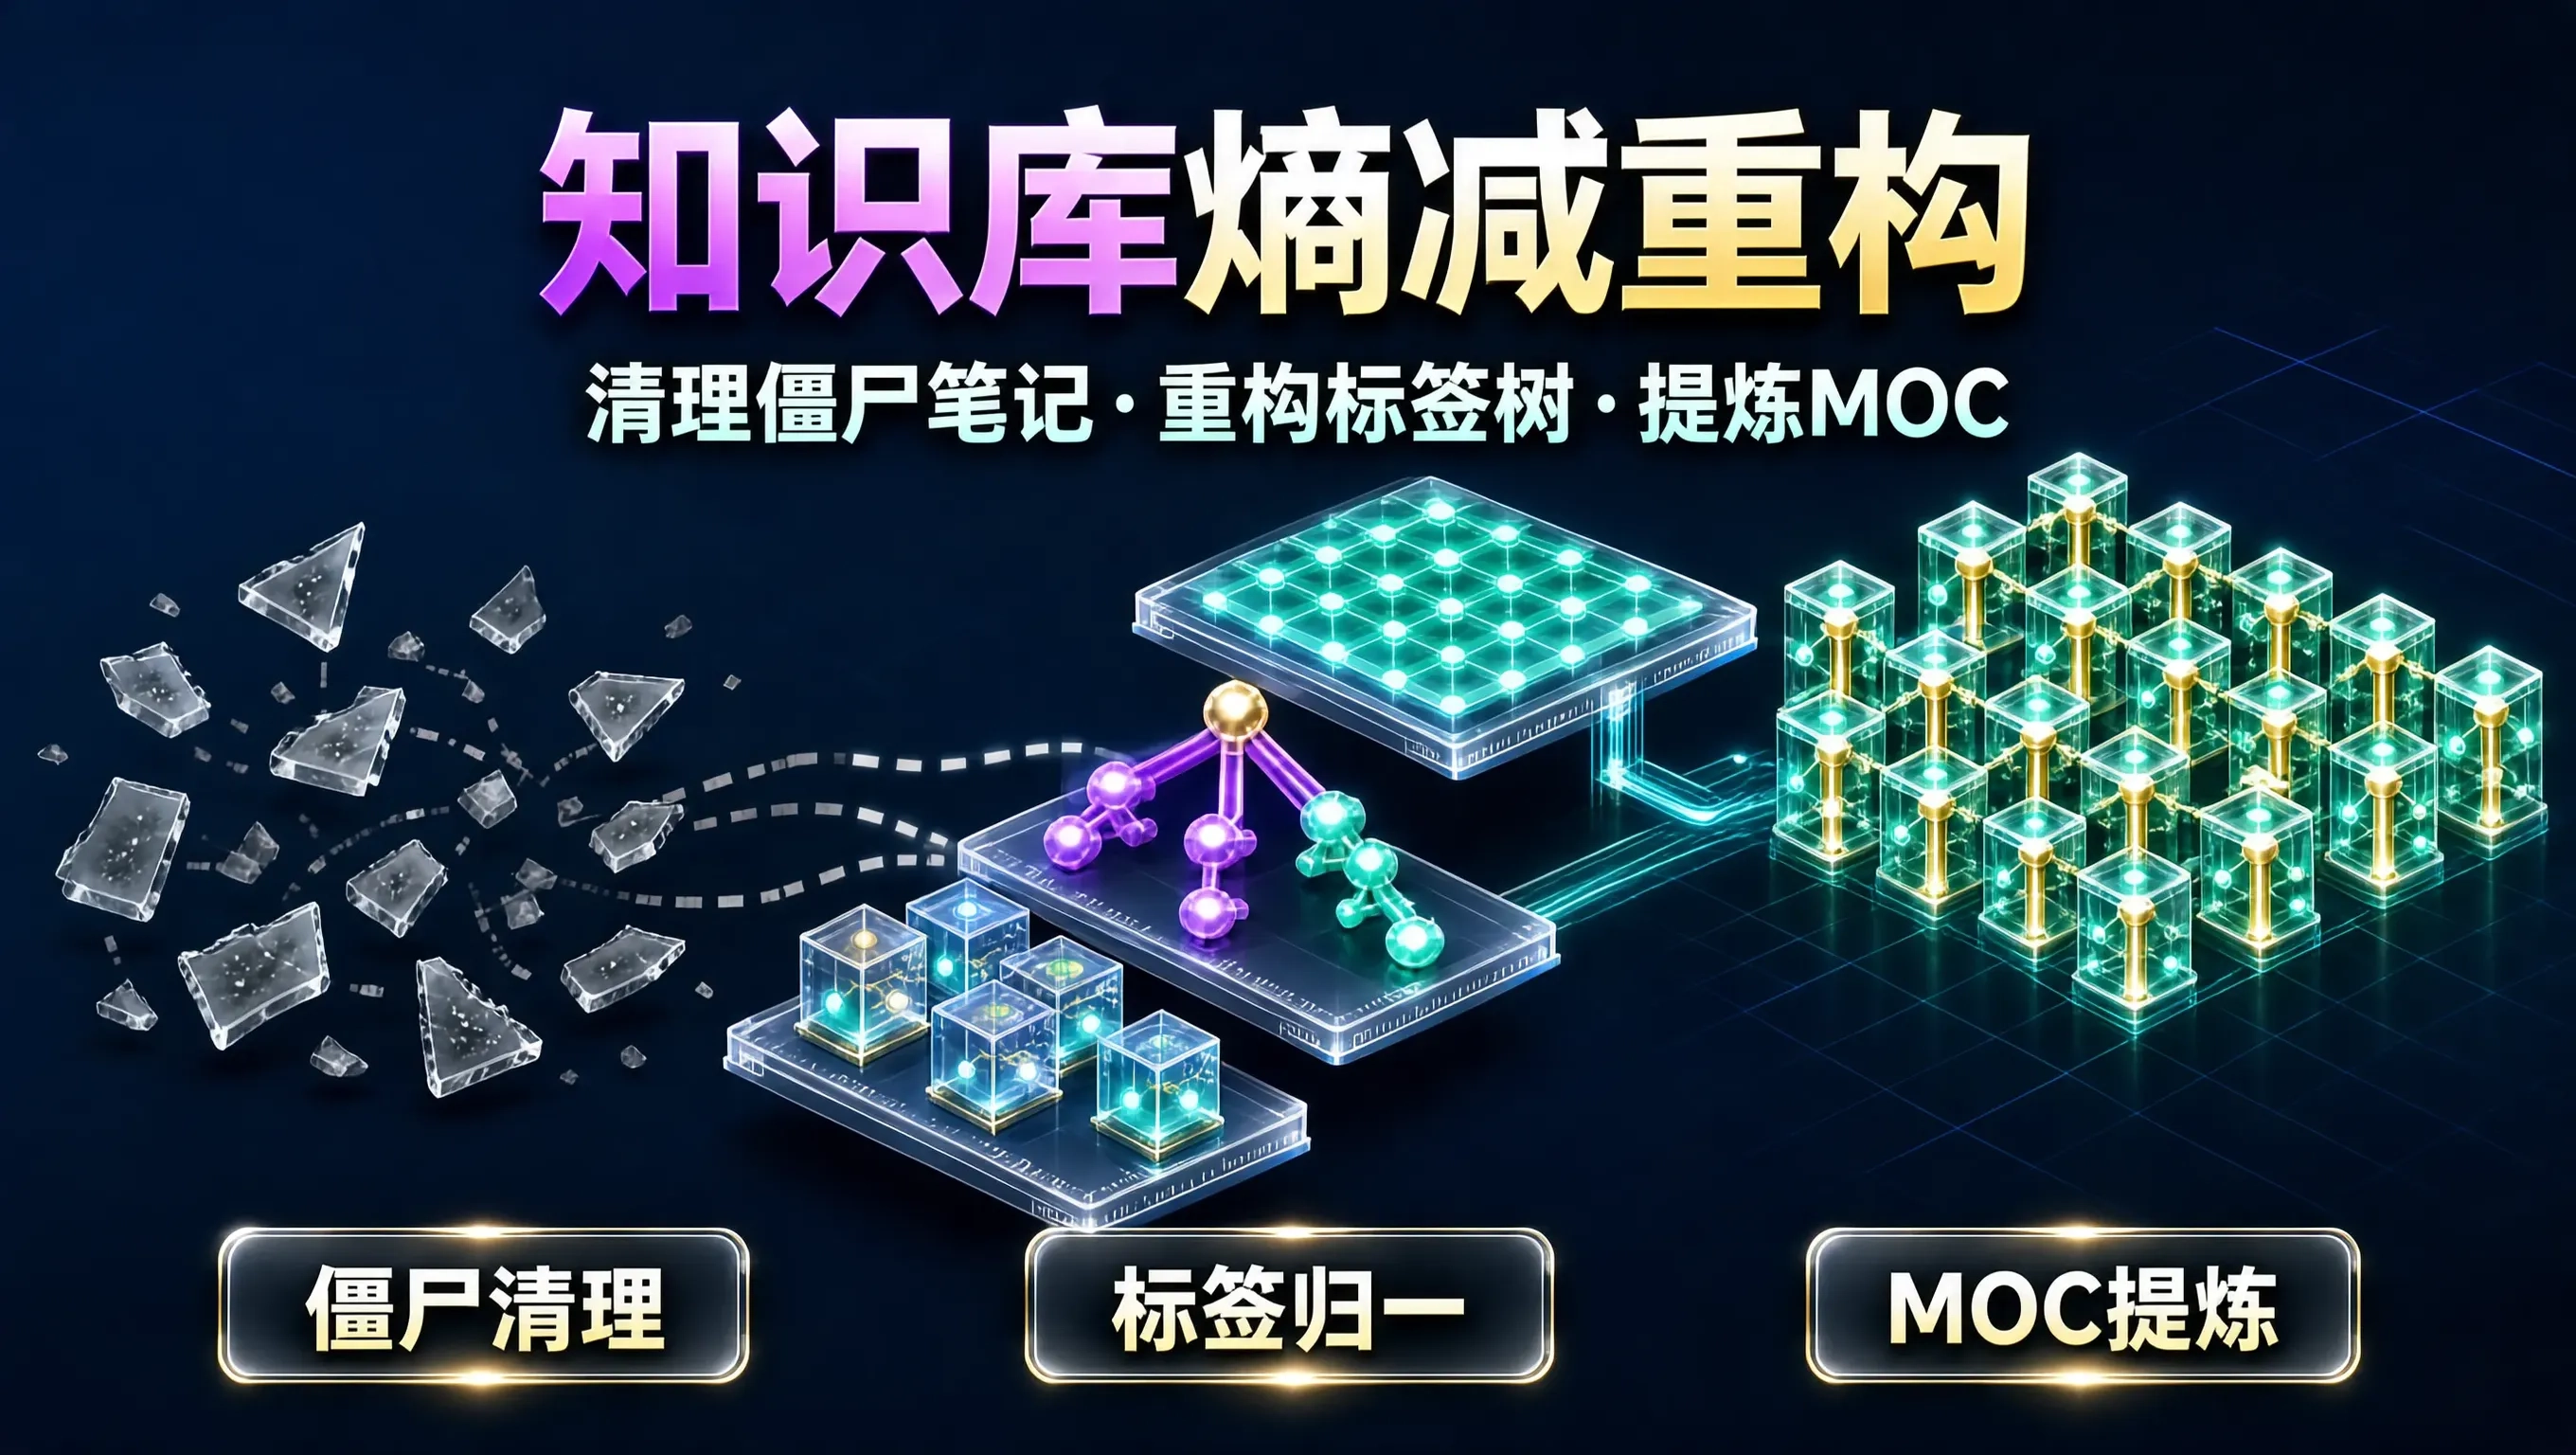
在基于 Obsidian 与本地 Markdown 构建个人“第二大脑”运行满一个季度之际,知识库中的笔记数量不知不觉膨胀到了近 500 篇。任何一个长期运转的系统,都会随着时间自发走向“熵增(Entropy Increase)”;#go#golang#GoLang正如操作系统需要定期进行磁盘整理与垃圾回收(GC),一个高生命力的知识管理系统,也必须在每个季度末开展一次**“知识资产大盘点与标签树
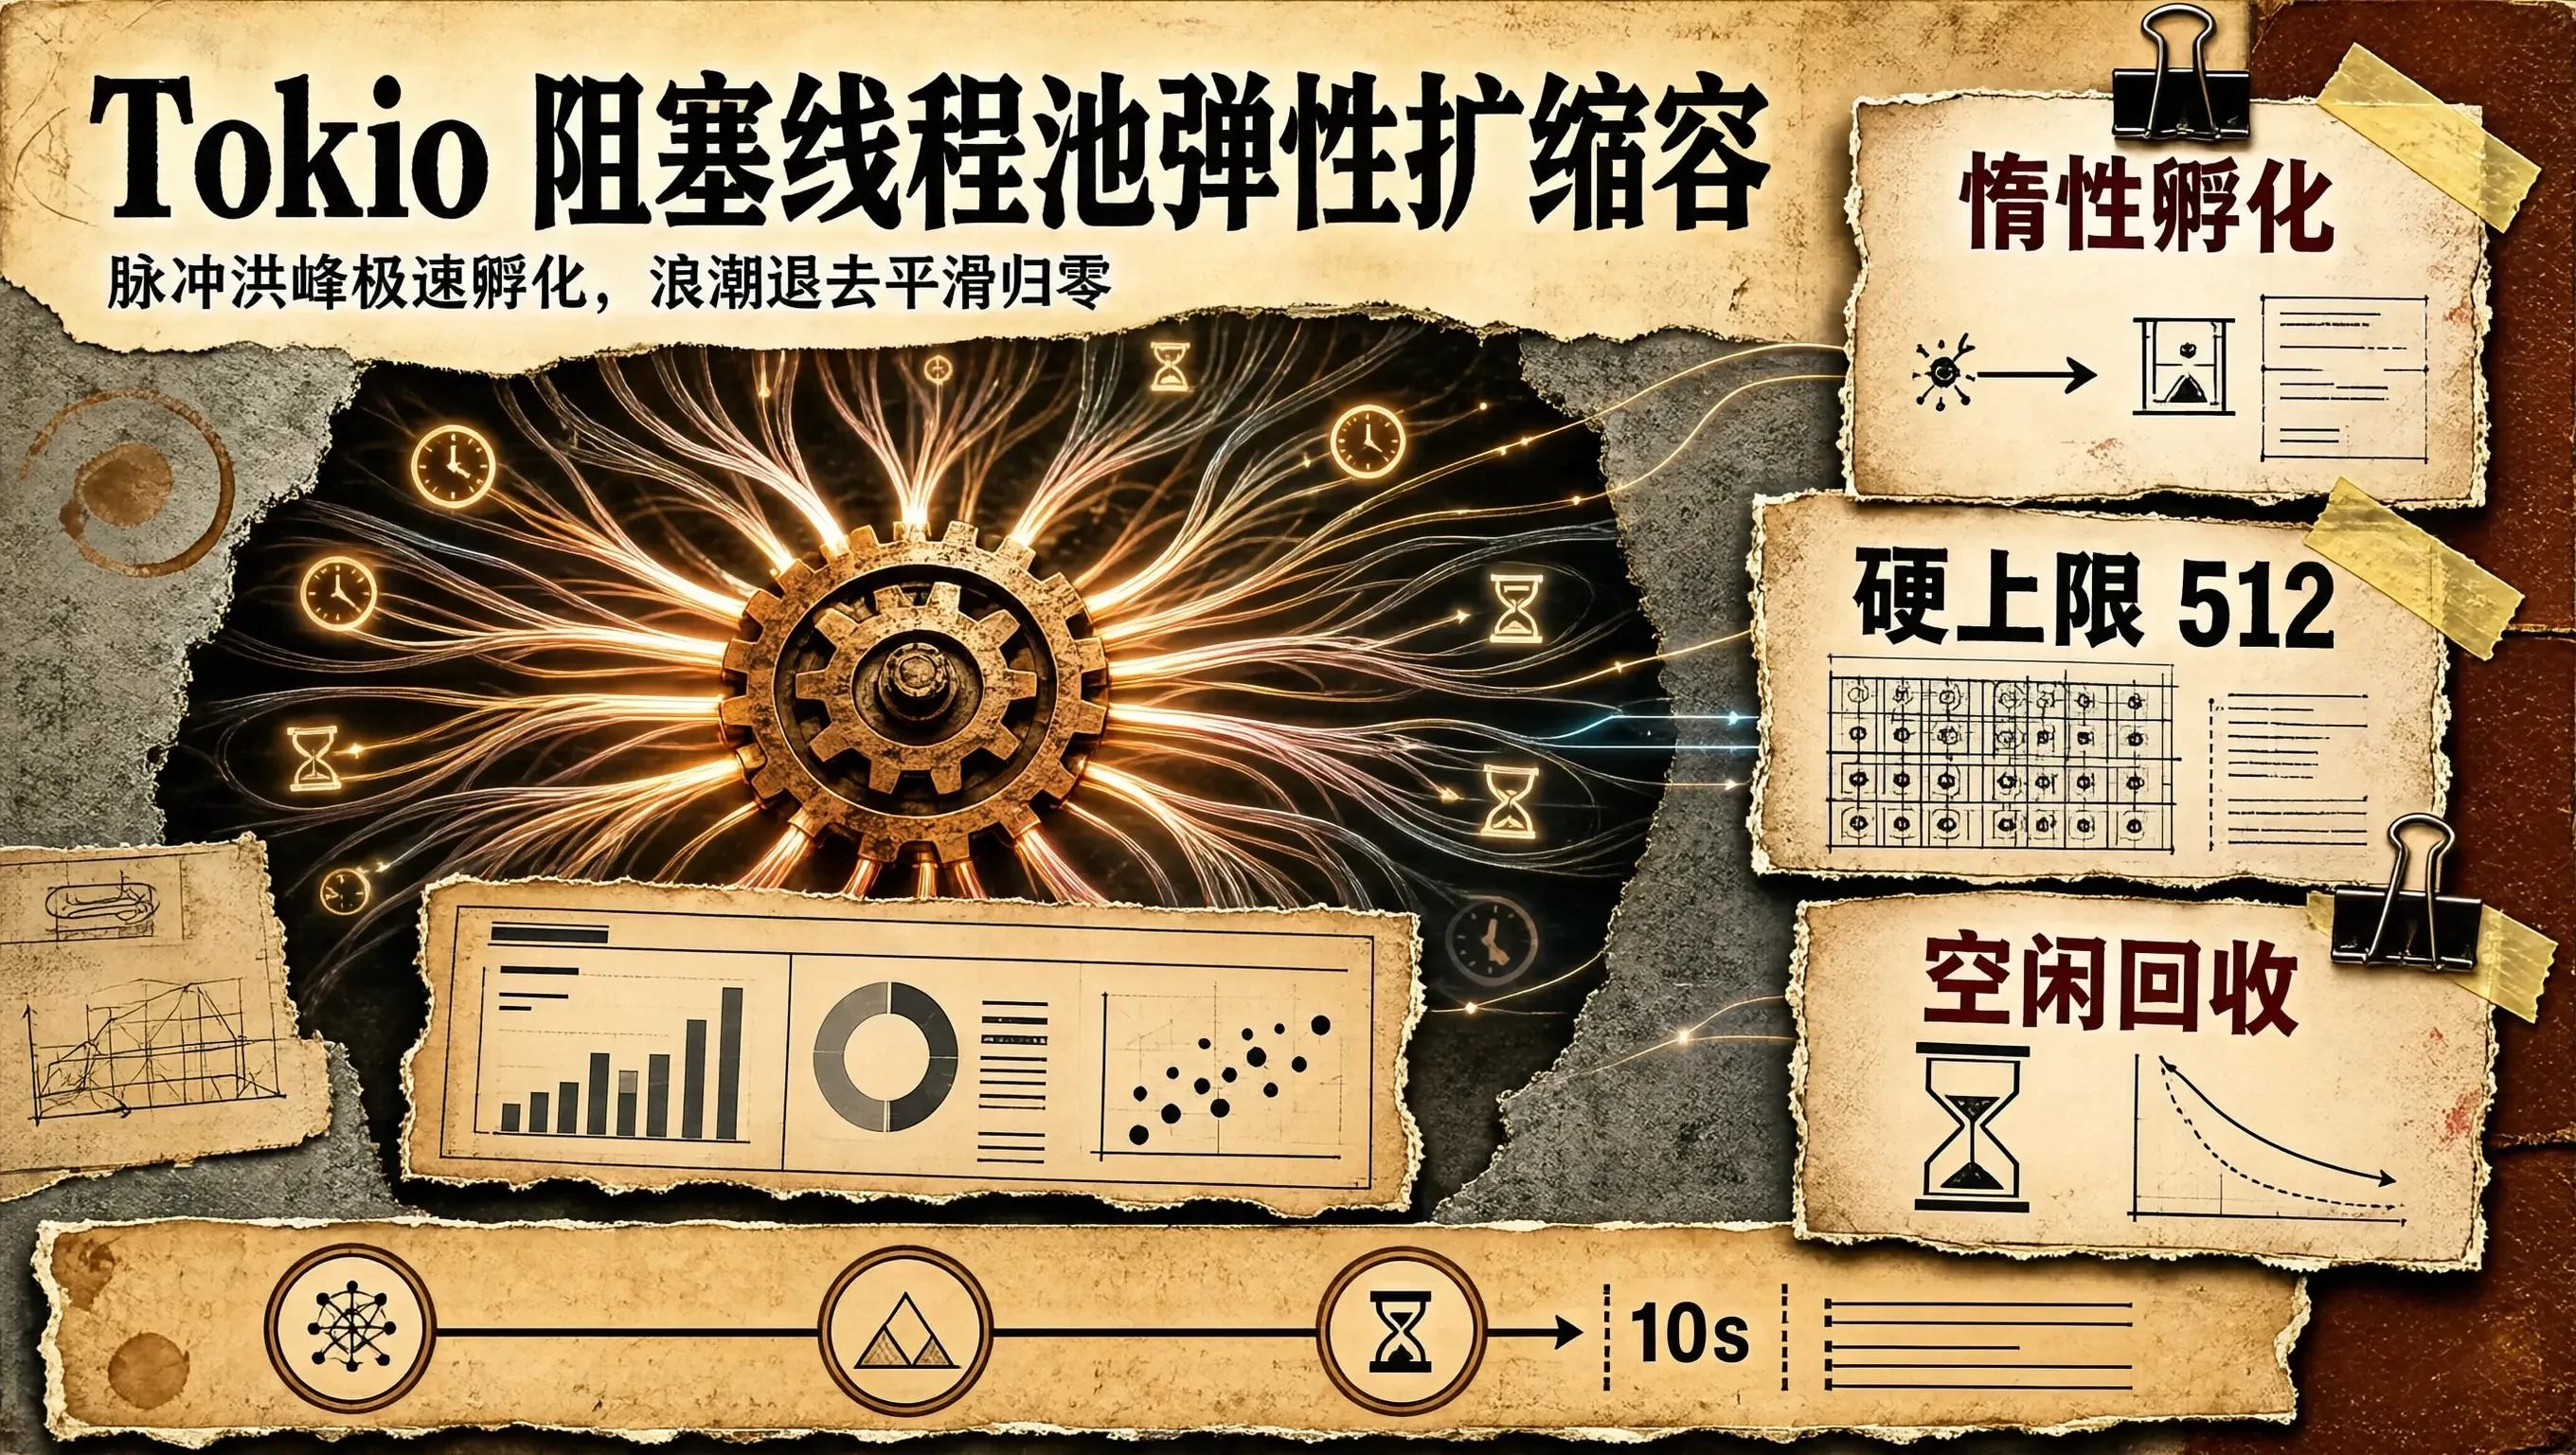
std::fs很多开发者以为只是一个简简单单的固定大小线程池。如果阻塞线程池采用固定大小(如固定 16 线程),突发任务会发生严重的排队阻塞;如果采用无限创建线程,又会瞬间耗尽操作系统的内存与 PID 描述符(引发崩溃)。深入剖析 Tokio 阻塞线程池是如何通过与实现丝滑弹性扩缩容的?
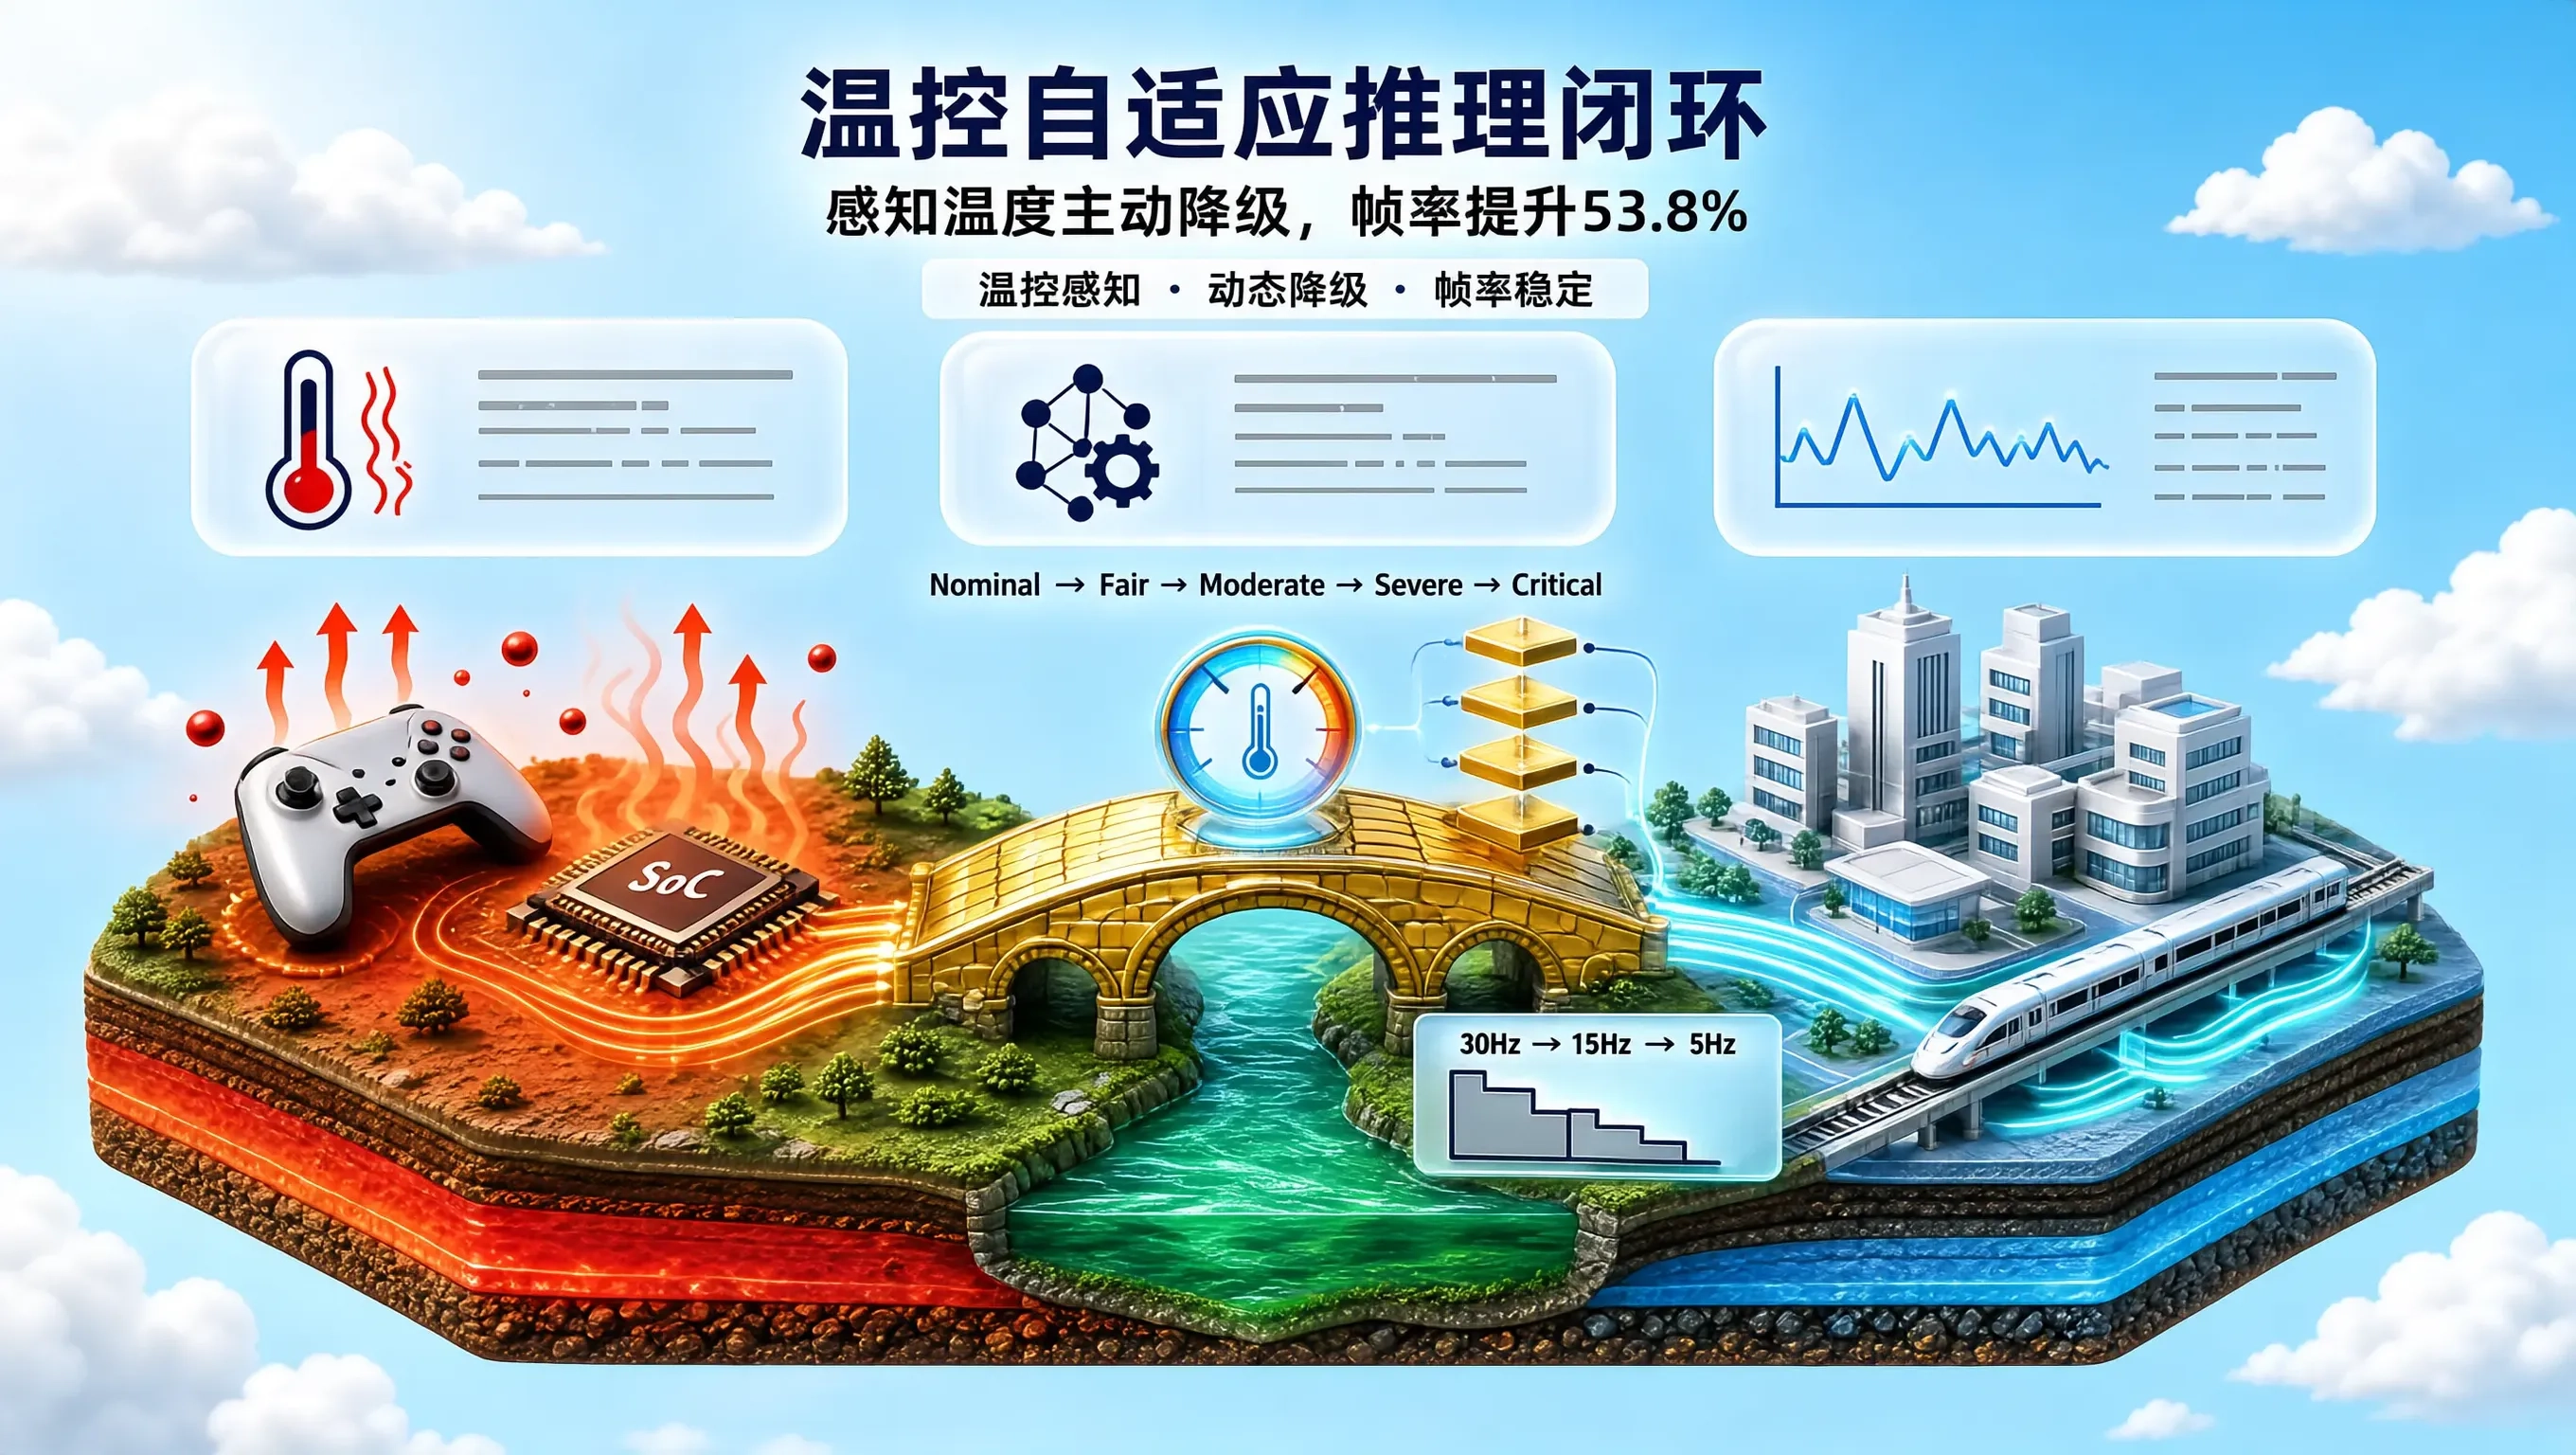
移动端游戏在持续高负载运行(如 60fps 渲染叠加端侧神经网络推理)时,SoC(CPU/GPU/NPU)产生的焦耳热如果无法及时耗散,会触发操作系统底层的硬件温控调频(Thermal Throttling)。一旦发生降频,CPU 主频可能从 3.0GHz 骤降至 1.2GHz,导致画面出现持续性掉帧、卡顿与触摸失灵。构建一套感知机身温度状态并主动调整渲染与 AI 推理负载的闭环自适应调控系统,是
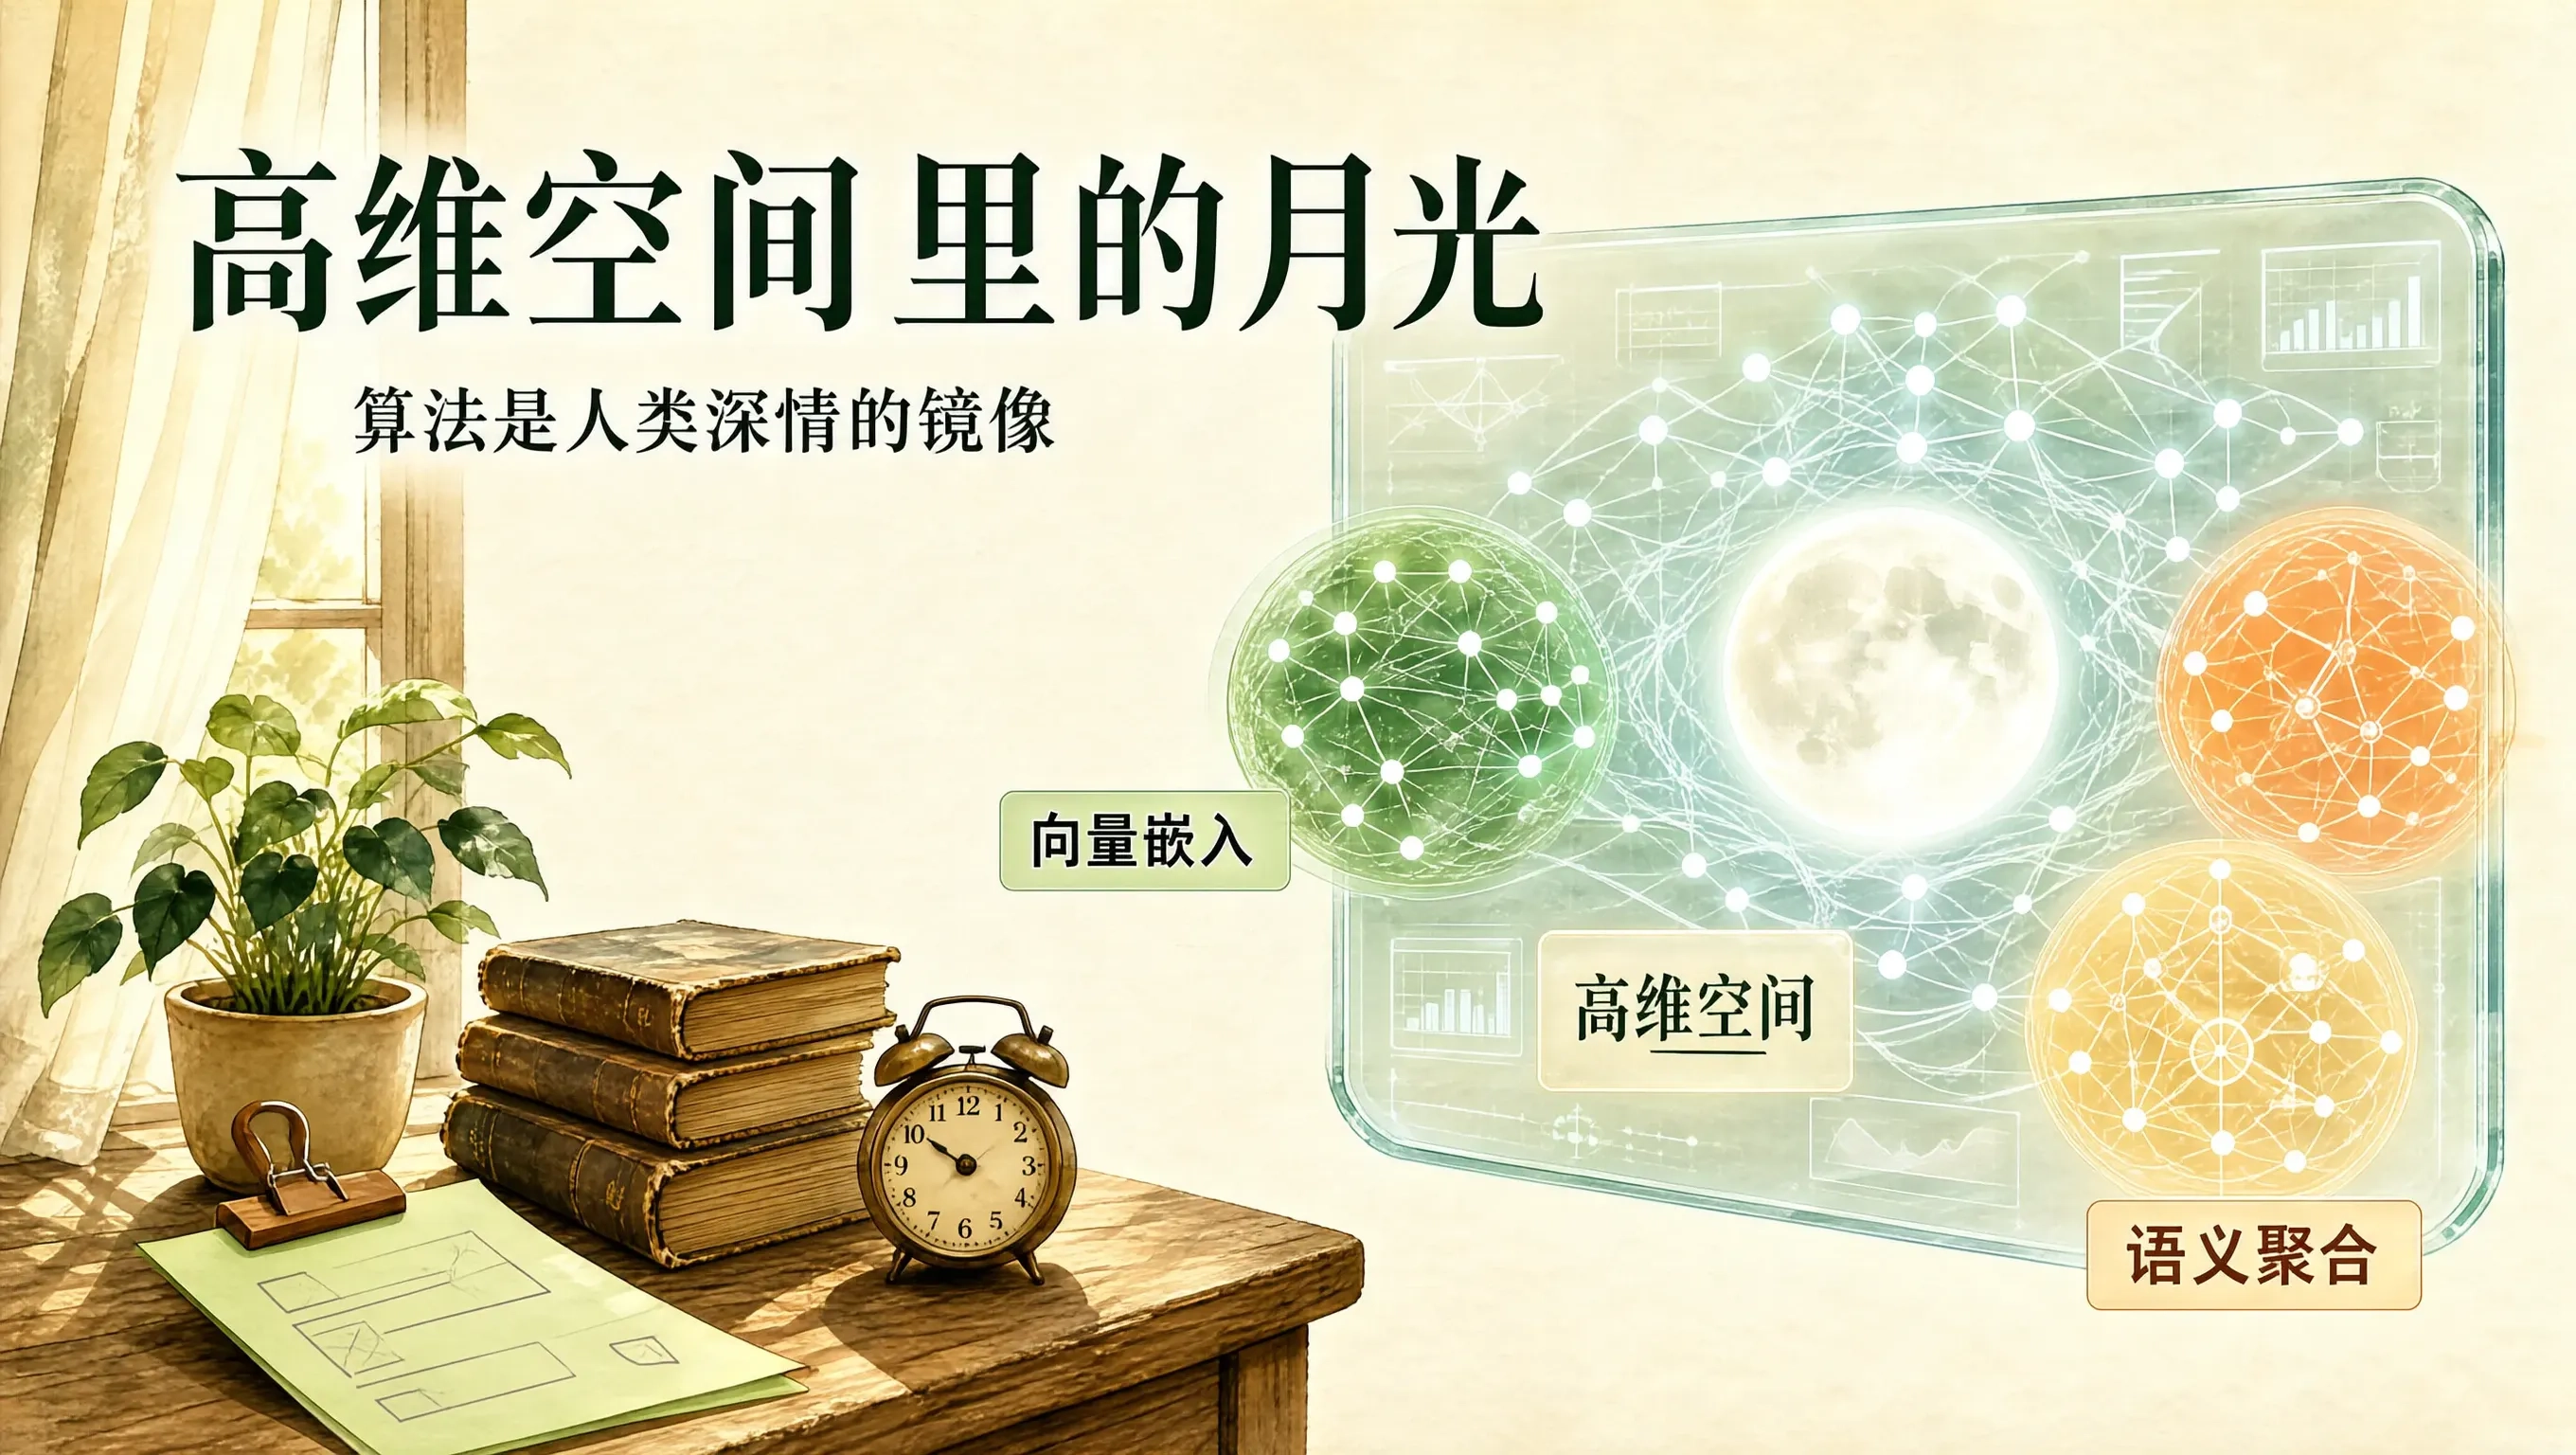
今夜庭院里的桂花开得格外浓密,秋风一吹,落英缤纷。老爸端着一杯清茶,抬头望着天边那一轮逐渐圆满的明月,轻声吟诵起苏轼的千古名句:"人有悲欢离合,月有阴晴圆缺,此事古难全。但愿人长久,千里共婵娟。老爸转过身问我:"闺女,你说现在的计算机大模型,把张若虚的《春江花月夜》、李白的《静夜思》、苏东坡的水调歌头全给学进去了。在那些冷冰冰的芯片、电路和矩阵里,那个'月亮'到底长成什么样呢?
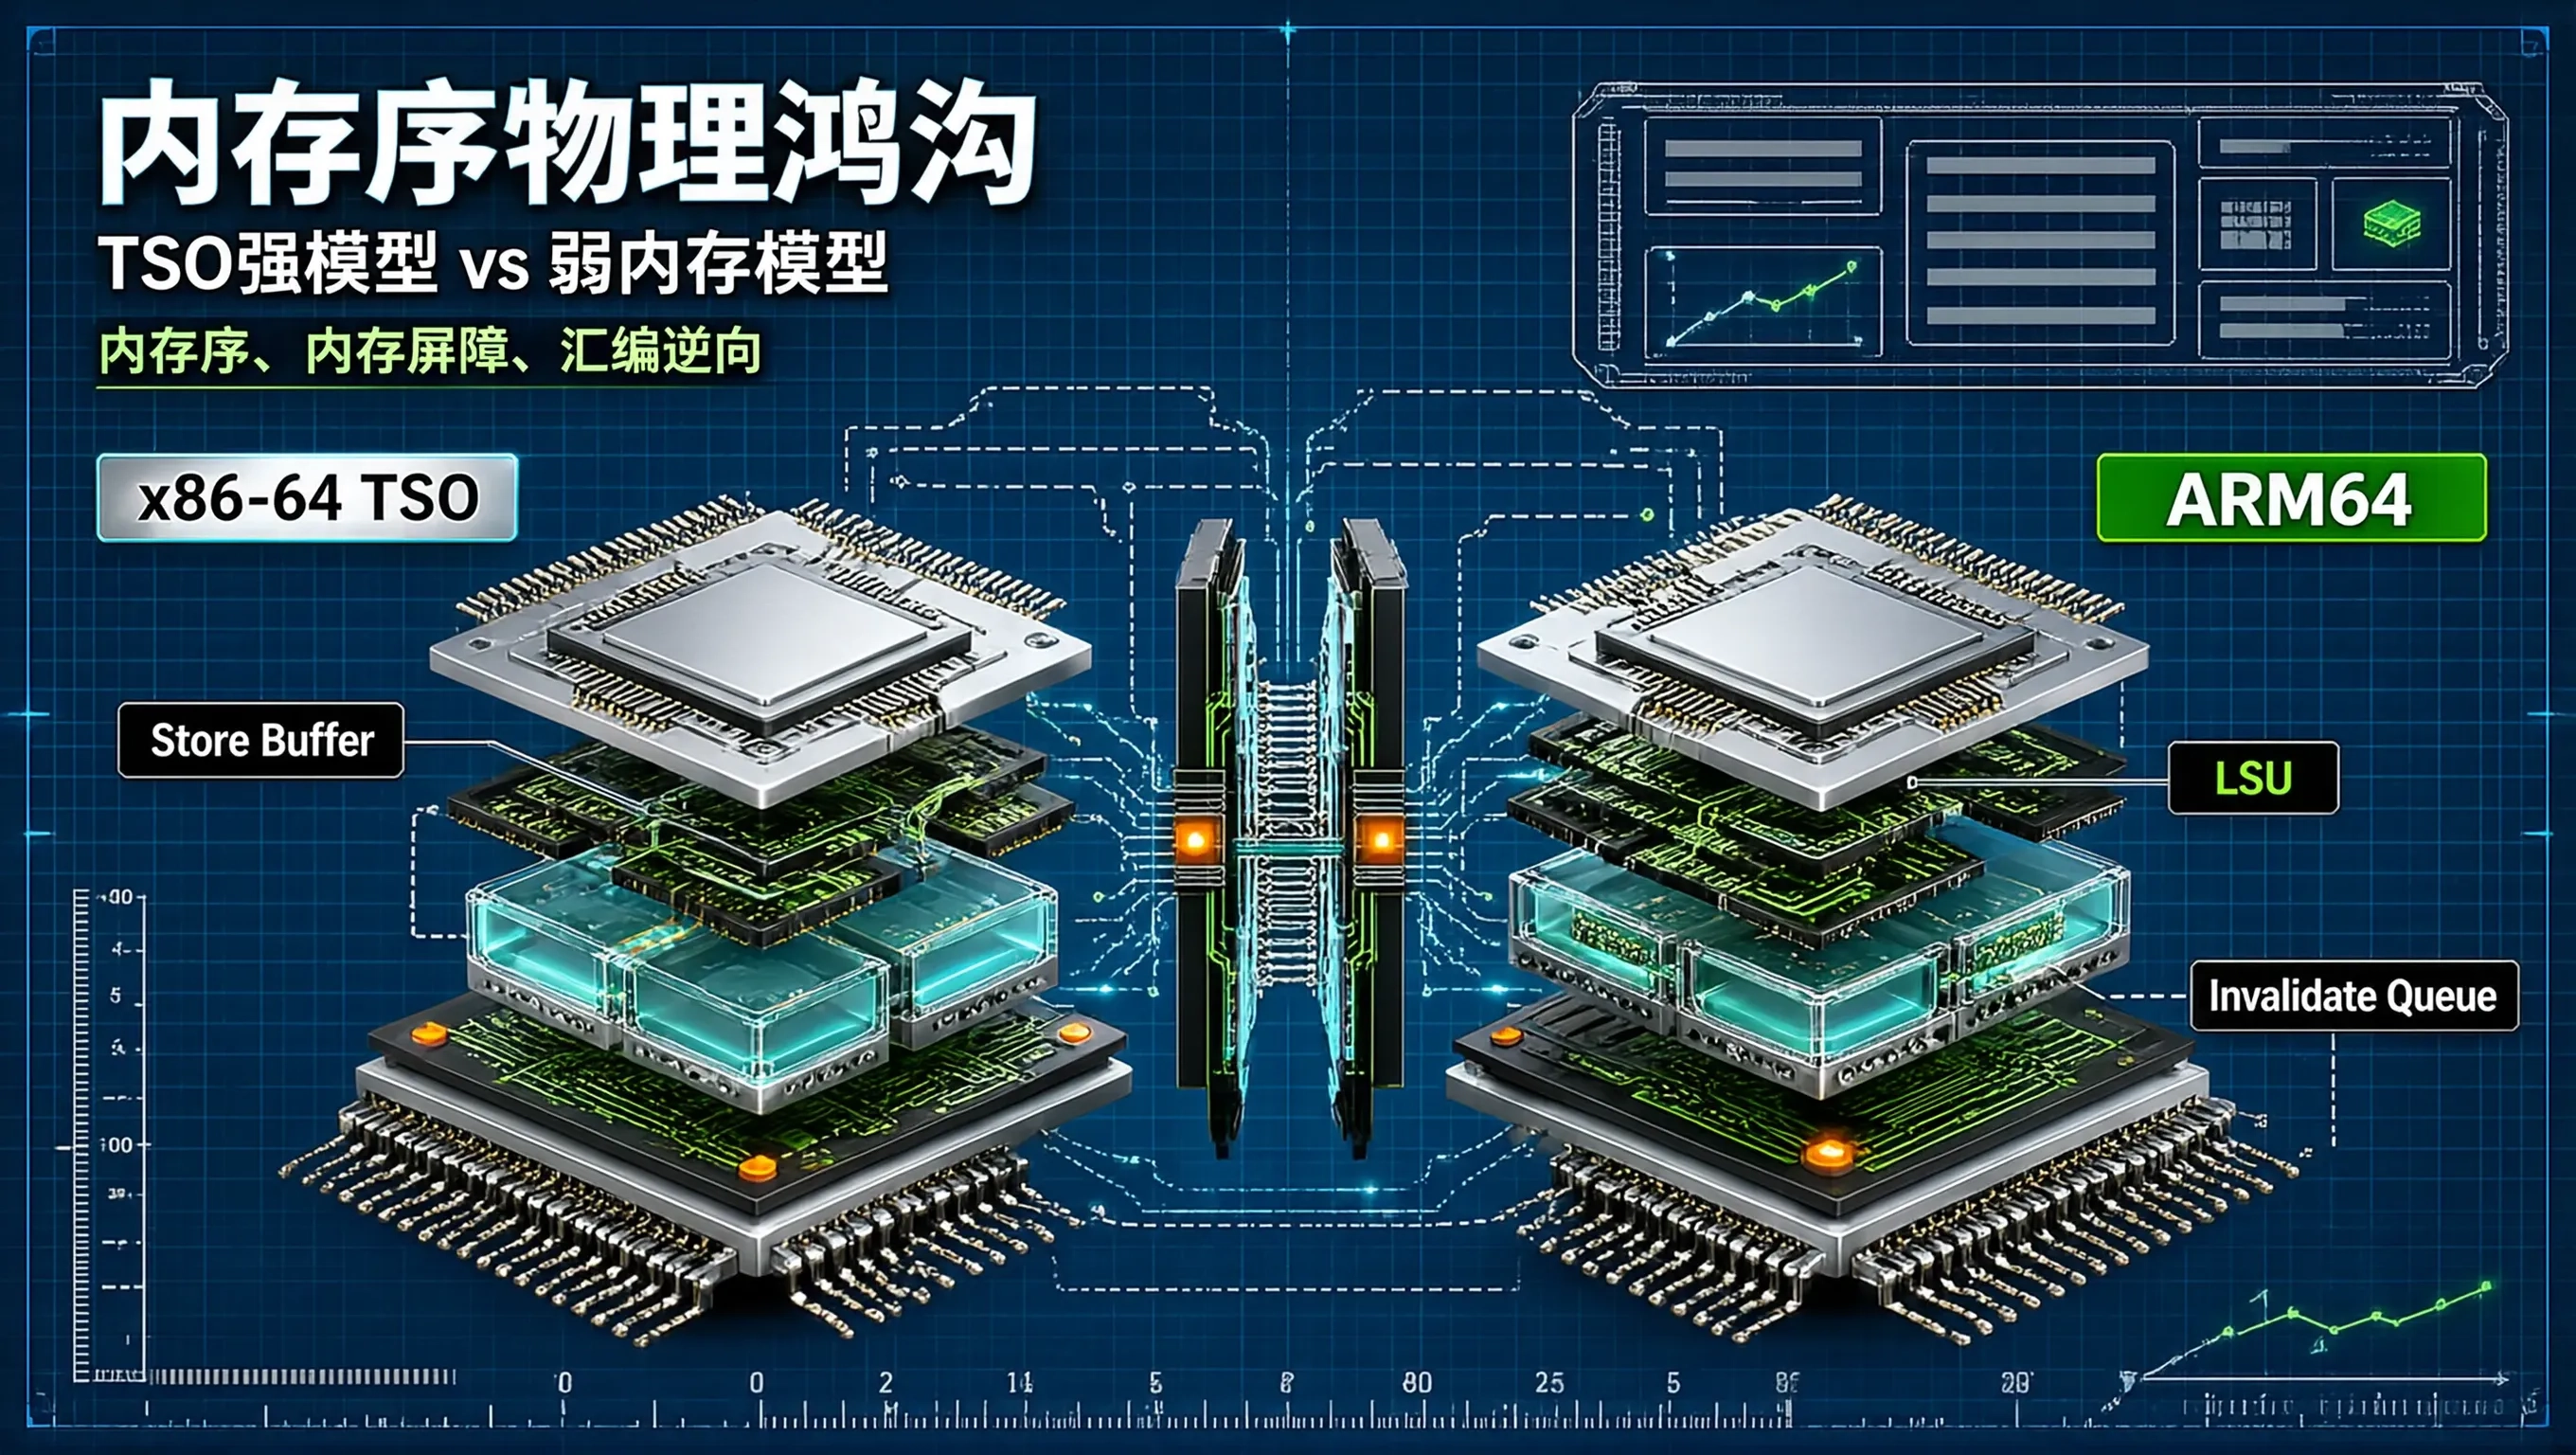
在现代高性能系统级编程(C++、Rust、Go)中,内存序(Memory Ordering)与原子操作是无锁并发数据结构(如无锁队列、原子引用计数、无锁跳表)中最深奥、也最容易引发诡异并发 Bug 的微架构深水区。然而,高级语言层面上完全相同的 Acquire-Release 代码,在 x86-64 架构芯片(Intel / AMD)与 ARM64 架构芯片(Apple Silicon、AWS G
语言模型
——语言模型
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 火山引擎视频云技术社区


 海思HiSpark开发者社区

 DAMO开发者矩阵

 2048 AI社区


 AtomGit AI 社区

 EazyDevelop社区







 openEuler 社区




 鲲鹏昇腾开发者社区