登录社区云,与社区用户共同成长
邀请您加入社区
安装环境:三台已配置完毕的虚拟机(网络、网关、localhost、密钥、防火墙等)spark压缩包(.tgz)官方下载链接放在下面这里用spark-3.0.0(虚拟机)举例。Apache Archive 分发目录。
spark 动态shuffle 合并shuffle
添加SPARK_HOME 和 PYTHONPATH 环境变量。如图可自行选择项目的存放位置;Python解释器默认即可。使用hdfs命令将其上传至hdfs文件系统中。首先创建一个python项目。### 选择 onssh方式。选择ip地址和对应的用户名。一直下一步(next)即可。配置同步项目文件夹位置。统计文本各单词出现频率。
开窗函数语法总结
Spark(SparkStreaming)消费Kafka消息--使用mysql或redis维护消费索引(保证消费的数据不重复不丢失), '多主题,多分区'
大数据处理,Spark删除redis千万级别数据。
DSS与Schedulis的集成安装教程(单机)Schedulis是微众银行大数据平台室开源的工作流调度系统,通过在DSS中安装配置AppConn插件,可以实现DSS开发的工作流发布到Schedulis定时调度执行。1. 安装前准备 1. 首先需要安装DSS,通过一键安装部署脚本或单独安装,可以参考DSS安装文档。 &
1-1访问结果:1-21-31-4通过以上四组测试结果可出结论redisTemplate.boundHashOps(“test”).increment(key, value);第一次使用increment时,键值对对应的value是初始化的值第二次使用increment时,键值对对应的value是自增或者自减的值;**测试得出的结果和总结的结论才是王道,其他都是浮云。若你get到,请点赞+评论..
一、将虚拟Python环境打包创建好环境后,进入到环境所在的文件夹,例如环境是/home/hadoop/anaconda3/envs, cd到envs下,使用打包命令将当前目录下的文件打成zip包:cd /home/hadoop/anaconda3/envszip -r py37.zip py37YARN集群配置Python环境在开始安装YARN及Spark集群的时候,可以将对应Python软件包
文章目录前言装备Core Code1. Mysql数据库建结果表2. DB配置文件3. 搞个文件4. 数据分层5. SparkJob父类6. MetroAnalysisJob(具体业务sparkjob)7. SparkJob工具类8. MySQLjdbcConfig9. Running ResultGithub总结前言hadoop完全分布式集群搭建刚写完。还是先写一下应用。这里写一下spark..
一、在 Spark SQL中有时会因为数据倾斜影响节点间数据处理速度,可在SQL中添加distribute by rand()来防止数据倾斜val dataRDD = sqlContext.sql("select A ,B from table your_table distribute by rand() ")二、在数据量过大时,若在Spark SQL中 使用
NVIDIA RTX Spark 笔记本电脑今天正式上市,首批产品来自华硕、戴尔、联想、微软和微星,后续还将推出更多机型。这些产品将 RTX 加速和 NVIDIA 全栈 AI 平台带到设计纤薄,质感高级的 Windows PC,用于创作、游戏和本地 AI。
本系统基于Spark大数据框架,结合Django与Vue技术栈,实现人口统计特征与肥胖风险的关联分析。系统涵盖性别差异、年龄结构、体质指标、活动关联与风险画像等七大模块。利用Spark SQL进行多维数据聚合,采用K-Means算法划分风险人群画像,孤立森林识别异常体质,FP-Growth挖掘高风险特征共现规则,为健康数据评估提供有效支撑。
本系统采用Python与Django框架构建,前端基于Vue与Echarts呈现,核心依托Hadoop与Spark大数据生态。系统针对宫颈癌变光谱特征数据,实现了数据上传、分布式存储、Spark清洗及特征提取功能,并通过可视化大屏展示分析结果,有效检验了大数据技术在医疗数据处理场景的落地效果,是一套技术完善的毕设方案。
本系统基于Spark与Django框架构建,旨在解决水质多指标数据的关联分析与可视化问题。系统整合Hadoop与Spark计算引擎处理海量数据,利用Pandas和NumPy进行数值运算。功能涵盖指标分布、关联矩阵计算、达标评价、饮用判定及风险洞察。通过K-Means聚类、Isolation Forest异常检测和PCA主成分分析,深度挖掘水质潜在风险模式,为水质监测提供高效的大数据解决方案。
90% 的机器学习团队仍停留在 2019 年的建模方式: Spark+XGBoost大规模训练
这里提示没有对应的SQL驱动,需要下载对应对应的驱动程序并在pyspark启动时将对应的路径传入才可以。这里梳理下本地部署MySQL服务和SQLite服务,并连接对应的驱动程序过程。
ClassNotFoundException: org.codehaus.janino.InternalCompilerException
要先向环境中添加mysql的jar包:数据库端口:3306用户:root密码:root数据库:spark。
File "D:\python工具\python学习工具\第二阶段\test pyspark.py", line 48, in D:\python\python.exe "D:\python工具\python学习工具\第二阶段\test pyspark.py"python版本是3.12。进程已结束,退出代码为 1。
因此,他们可以使用熟悉的工具专注于自己的业务和数据。一个与 HiveServer2 兼容的接口,允许最终用户使用 thrift 客户端(跨语言支持,tcp 和 http)、基于 thrift的 Java 数据库连接(JDBC)接口或基于 JDBC的开放数据库连接(ODBC)接口。Kyuubi 在各种现代计算框架(例如 Apache Spark、 Flink、 Doris、 Hive和Trino等)
将使用来自网络竞赛中的社交圈研究数据,这些数据来自少量的 Facebook 用户,这些用户在他们的朋友圈中分享信息。同时,每个用户被要求分配他们的朋友到一个或者多个社交圈。社交圈是一些用户朋友的分组,对这些用户是有意义的。
2、构建聚类模型可以采用Kmeans及GMM,并训练。4、查看聚类中心或混合成分参数,分析并对比聚类效果。i.即聚类的各类别是否反应其真实所属。【 救救孩子,不会做 π _ π 】3.训练分类模型并预测居民收入。2.进行主成分分析(PCA)
业务那边给了个需求,我们这边完成的话需要两个表进行join操作,小表(4800万条)大表(26亿条)。典型的小表和大表join,首先想到的就是 Broadcast Join对其进行一个最佳处理。
头歌Spark GraphX—寻找社交媒体中的“影响力用户”答案代码
第1关:QueueStreamimport java.text.SimpleDateFormatimport java.util.Dateimport org.apache.spark.{HashPartitioner, SparkConf}import org.apache.spark.rdd.RDDimport org.apache.spark.streaming.{Seconds, Stre
第1关:SparkSQL初识package com.educoder.bigData.sparksql;import org.apache.spark.sql.AnalysisException;import org.apache.spark.sql.Dataset;import org.apache.spark.sql.Row;import org.apache.spark.sql.SparkS
Exception in thread "main" java.lang.NoSuchFieldError: JAVA_9at org.apache.spark.storage.StorageUtils$.<init>(StorageUtils.scala:207)at org.apache.spark.storage.StorageUtils$.<clinit>(Stor
使用PySpark搭建机器学习模型文章目录使用PySpark搭建机器学习模型前言搭建回归模型1.加载数据集2.拆分数据集3.创建模型4&5 模型训练与预测6.模型评估绘制折线图参考文章前言因为现阶段的实验需要用到 PySpark ,所以安装了 PySpark 来搭建机器学习模型来进行训练。还没有配置好 PySpark 环境的,请参考这篇博客进行配置 Windows下搭建PySpark环境实
Kafka-Spark Streaming 异常: dead for group td_topic_advert_impress_blacklist很有可能是防火墙问题或者是C:\Windows\System32\drivers\etc\hosts文件的问题!!!18/10/31 17:42:58 INFO AbstractCoordinator: Discovered co...
在mysql中创建hive数据库,并允许hive接入mysql> create database hive;#这个hive数据库与hive-site.xml中localhost:3306/hive的hive对应,用来保存hive元数据mysql> grant all on *.* to hive@localhost identified by 'hive';#将所...
问题描述:在SparkStreaming长时间写入HBase的时候,会下面的异常问题:2017-12-24 23:20:34[ SparkListenerBus:540107357 ] - [ ERROR ]Listener EventLoggingListener threw an exceptionjava.io.IOException: Failed to replace
将CDH gateway 安装到docker里面。
本文以真实生产场景的实测链路为贯穿实例:基于 EMR Serverless Spark 上的 Ray 运行 EMR Embodied AI 数据生产管线。
系统基于Hadoop与Spark大数据框架,结合Django后端与Vue前端技术,专注于跨平台消费者评论的情感强度分析。系统通过预处理机制生成实体标签与情感强度,利用Spark SQL及Pandas完成热度榜、时段活跃度等宏观统计,并融合K-Means聚类、孤立森林异常检测与FP-Growth关联规则算法,计算实体活跃画像与异常热度点,最终通过Echarts实现数据可视化展示。
Nemotron 3.5 Bolt、NVIDIA PAIR 和 NVIDIA Broadcast 2.3 将加入数千款应用、游戏和模型行列,一同迎接 10 月 16 日 RTX Spark 上市。Gerardo Delgado2026年10月13日NVIDIA RTX Spark 为 PC 开启新序章,将游戏 PC、创意工作室和个人 AI 超级计算机的能力集于一颗超级芯片,重塑 PC 体验。
想象一下:你的工厂里每台设备的温度、转速、振动频率都被实时映射到虚拟空间里。当虚拟世界中的某台设备出现异常趋势时,系统提前4小时发出预警,同时自动生成维修工单,调度备件库存,通知接班工程师。这一切发生在真实故障出现之前。这不是科幻电影,这是2026年"企业大脑+数字孪生"融合落地的真实场景。
本文介绍了一个基于Python+Django+MySQL的个性化音乐推荐系统。系统采用MVC架构,整合双协同过滤算法实现核心推荐功能,包含用户端和后台管理端两大模块。用户端支持音乐播放、收藏、评分、评论等操作,系统会根据用户行为推送定制化音乐;后台端可管理用户、音乐、标签等各类数据。测试表明ItemCF-IUF算法表现更优。系统功能完善,包含音乐展示、下载、在线播放、歌单管理等12个功能模块,界面
计算机毕业设计hadoop+spark股票行情预测系统 量化交易分析 股票推荐系统 股票爬虫 大数据毕业设计(源码+文档 +PPT+讲解)
基于 Spark 的在线广告推荐系统,是为广告平台打造的智能化推荐平台,旨在通过分析用户行为与广告特征,实现广告精准投放,提升广告转化率与用户体验。系统以 Spark 为核心计算框架,整合 HDFS 存储分布式存储用户行为日志与广告资源数据,利用 Spark streaming streaming 处理实时点击流数据,sparkmllib 构建推荐模型,kafka 实现高并发数据接入,支撑大规模广
在推荐系统中,协同过滤算法是应用较多的,具体又主要划分为基于用户和基于物品的协同过滤算法,核心点就是基于"一个人"或"一件物品",根据这个人或物品所具有的属性,比如对于人就是性别、年龄、工作、收入、喜好等,找出与这个人或物品相似的人或物,当然实际处理中参考的因子会复杂的多。大家如果在实际业务处理中有相关需求,可以根据实际场景对上述代码进行优化或改造,当然很多算法框架提供的一些算法是对这些相似度算法
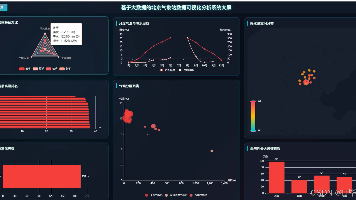
基于大数据的北京气象站数据可视化分析系统 摘要:本系统采用Hadoop+Spark大数据框架,结合Django/Spring Boot后端与Vue前端,实现了对北京气象数据的多维度分析与可视化展示。系统支持年度气温变化、降水量趋势、极端天气事件等分析,通过Spark分布式计算高效处理海量数据,为气象研究提供决策支持。开发采用Python/Java双语言,集成HDFS、Spark SQL等技术,实现
基于Hadoop+Spark的中国火车站站点地理数据可视化分析系统 毕业设计 Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy如果你觉得内容不错,欢迎一键三连(点赞、收藏、关注)支持一下!欢迎在评论区留下你的想法或提出宝贵意见,期待与大家交流探讨!谢谢!
摘要:本文介绍了PySpark中RDD的map方法实战应用,重点讲解如何通过lambda匿名函数实现数据转换。文章包含环境配置问题解决方案(Python 3.12与PySpark 3.5.5的兼容性问题)、map方法原理、多参数lambda写法,以及普通函数与lambda函数的本质区别(是否修改原参数)。作者分享了对技术学习的思考,强调在理解核心逻辑的基础上,合理规避环境兼容性问题的重要性。最后以
将dwd层的历史拉链表数据和ods层当日新增及更新的数据LEFT JOIN左关联,利用左关联的特性,如果能关联上那么说明历史拉链表中的这条数据当日的维度数据是有变化的,那么我们就需要将其end_date更新为当前时间的前一天(今天处理的是昨天的数据,那么其过期时间也应该为前一天):当维度表中的某个属性(如客户的地址、产品的价格、员工的部门、订单的状态等)发生变化时,不直接覆盖更新原有记录,而是插入
摘要:本实验通过PySpark实现RDD基本操作和数据处理任务。首先使用交互式编程分析大学计算机系成绩数据,统计学生人数(265人)、课程数量(8门)、计算Tom平均分(30.8)及各课程选课情况;其次编写独立程序完成数据去重,合并文件A和B生成去重排序后的文件C;最后实现求平均值应用,处理多学科成绩文件并计算学生平均成绩。实验使用VirtualBox和Linux环境,通过map、reduceBy
本研究设计并实现了一个基于Spark的网易云音乐推荐系统,采用Hadoop、Spark和Django框架开发,通过爬虫采集数据。系统实现了古典歌单管理、音乐信息展示、用户管理等功能,并利用ECharts提供数据可视化分析,包括年龄统计、播放量排行等。系统测试表明其运行稳定、操作简便,能够有效分析用户关注行为和音乐偏好,具有实用价值和应用前景。
在线广告推荐系统摘要: 本文研究了一种基于Java技术和SpringBoot框架开发的在线广告推荐系统,采用MySQL数据库存储数据。系统通过分析用户历史行为数据,运用协同过滤算法实现个性化广告推荐,同时结合Scrapy爬虫技术收集网络数据。系统包含用户和管理员两个角色,主要功能包括用户管理、广告数据管理、在线论坛和系统管理等模块。前端采用Vue.js框架构建交互界面,后端利用Hadoop处理大数
doris单机版本使用spark写入doris表一直报错 127.0.0.1:8041 [/127.0.0.1] failed: Connection refused
Join Key 基数定义特点适用 Join 类型优化策略高基数唯一值数量较多,接近总行数数据分布均匀,Shuffle 数据量大,但不会出现数据倾斜确保分区均匀,使用 Broadcast Join(如果小表较小)。低基数唯一值数量较少,远小于总行数数据分布不均匀,容易出现数据倾斜处理数据倾斜(随机前缀打散、分区优化),使用 Broadcast Join(如果小表较小)。方法是否解决随机前缀一致性问
spark
——spark
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 乐奇 Rokid 开放社区


 科技大视野开发者社区







 DAMO开发者矩阵