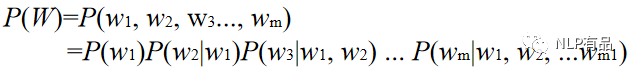登录社区云,与社区用户共同成长
邀请您加入社区
整体思路:1)使用tensorflow2加载预训练bert模型,进行训练,然后将模型部署载tfseving中。2)使用flask部署模型推理,模型推理时会requrest请求 1) 中tfserving部署的模型3) 将2)的flask构建成一个docker镜像,运行镜像即启动了服务4)模型更新:只需将最新模型放入tfserving的对应模型路径下1 模型训练及tfserving部署参考博客htt
pytorch模型部署成Tensorrt记录
本文详细解析了机器学习项目的全流程,包括数据收集、预处理、模型训练、评估、部署和监控等阶段。重点介绍了损失函数的定义及其在回归和分类任务中的应用。回归任务中常用的损失函数包括均方误差(MSE)、平均绝对误差(MAE)和均方对数误差(MSLE);分类任务中则常用交叉熵损失、合页损失和Focal Loss。文章通过Python代码示例展示了如何在回归和分类任务中实现这些损失函数,并强调了根据任务特点选
本文详细介绍了基于RK3588芯片的四足机器狗语音交互系统设计方案。系统通过五大功能模块实现拟人化交互:语音采集模块负责降噪拾音;语音识别模块利用NPU加速实现语义和情感识别;情感决策模块匹配机器狗响应状态;发声模块合成情感化语音;协同控制模块实现动作与语音同步。方案充分利用RK3588的算力优势,在500ms内完成语音识别,300ms内完成情感反馈,支持离线运行和多种交互场景。通过硬件资源优化分
先说结论:这是一门“讲义驱动”的课。老师带着你翻一份 222 页的 Word 讲义,中间穿插代码演示和 Hugging Face 文档,节奏不快,但知识链路很完整——从分词、词向量一路讲到 BERT / GPT / T5 和微调。课程标题里带了“llm、大模型训练”,不过 187 讲实际讲到预训练模型就结束了,没有大模型预训练、RLHF、分布式训练这些内容。冲着“训练大模型”来的话,这门课只能打基
参考公众号:腾讯技术工程以及Datawhale2026 年 9 月,一家名为 TypeSafe AI 的公司发布了一个叫 Jev 的模型。它不写文章、不聊天、不写代码,只做三件事:回答选择题、打分级评分、判断陈述真假——并且直接返回概率,百毫秒级完成。如果你把它当作“又一款更聪明的大模型”,会错过它真正想说的东西。Jev 不是来挑战 GPT 的智商,而是公开质疑了一件被行业默认了十年的事:面向对话
本文系统梳理了语言模型的演进历程:从2003年NNLM首次用神经网络替代统计模型,到2013年Word2Vec通过简化架构实现效率突破(CBOW聚合上下文预测中心词,Skip-gram中心词预测上下文),再到2018年BERT采用深层Transformer实现动态语境建模。模型发展呈现从静态词向量到动态上下文表示、从局部窗口到全局双向理解的趋势。不同模型在计算效率、语义捕捉、一词多义处理等方面各具
任务目标:输入文本(如“这部电影剧情紧凑,演员演技出色!”),输出情感标签(正面/负面)。微调数据:带标签的情感语料,示例:文本标签“这部电影剧情紧凑,演员演技出色!正面“画面模糊,音效刺耳,不推荐观看。负面BERT的训练过程通过“预训练筑基+微调适配”实现知识迁移:预训练用无监督任务从海量文本中学习语言本质,微调则用少量标注数据将通用知识转化为任务能力;而推理则是微调后模型对新数据的高效预测。这
是由Google在2018年提出的预训练语言模型,其核心思想是通过双向Transformer编码器学习通用语言表示,并通过“预训练+微调”模式适配下游自然语言处理(NLP)任务。BERT的出现彻底改变了NLP领域的范式,推动了“预训练模型主导下游任务”的趋势,大幅提升了文本分类、问答、命名实体识别等任务的性能。BERT通过双向Transformer和创新的预训练任务,奠定了现代预训练语言模型的基础
BERT采用双向Transformer编码器结构,通过自注意力机制同时处理上下文信息。其核心创新是Masked Language Modeling预训练任务,随机遮盖部分词并利用左右上下文进行预测,与GPT的单向解码器形成鲜明对比。这种双向性让BERT能更全面理解句子语义,在命名实体识别、问答等任务中表现出色,成为自然语言处理的重要突破。
在 BERT 上做自回归语言模型必须添加下三角 mask,否则模型会因 “偷看未来信息” 而失去真正的预测能力,最终生成任务完全失效。这也是为什么你的代码中特别强调 “训练时构建下三角 mask 矩阵,让上下文之间没有交互”—— 这是用 BERT 做生成任务的核心改造点,不可或缺。
摘要:本文详细介绍了基于BERT的中文掩码语言模型(MLM)实现过程。主要包括:1) 使用Hugging Face的BertTokenizer和BertModel加载预训练模型;2) 自定义数据预处理函数collate_fn2,构建包含[MASK]的输入序列和对应标签;3) 设计包含线性输出层的MyModel模型架构;4) 采用AdamW优化器和交叉熵损失进行模型训练;5) 实现模型评估流程。关键
BERT(Bidirectional Encoder Representations from Transformers)是自然语言处理领域的里程碑模型,通过大规模无监督预训练获取深度双向语言表示。其核心架构基于Transformer编码器,采用多头自注意力和前馈网络,并通过残差连接和层归一化增强模型性能。BERT通过掩码机制实现双向上下文建模,突破传统语言模型的单向限制。预训练任务包括掩码语言建
为了比较系统的学习大模型的训练与应用有了该样例,仅供由此爱好的初学者参考和给自己留存。本文将以去哪网酒店预订评论数据作为训练材料进行模型训练,力求达到输入中文描述,模型自动匹配该描述是好评还是差评。
Transformer模型是一种用于自然语言处理的机器学习模型,它在2017年由Google的研究者提出,并在论文《Attention is All You Need》中详细描述。Transformer模型的核心创新在于其采用了自注意力(self-attention)机制,这使其在处理序列数据(如文本)时比传统的循环神经网络(RNN)和长短期记忆网络(LSTM)更加高效。
transformers bert-base-uncased情感分析
【预训练语言模型】 使用Transformers库进行BERT预训练
这个是二月份学习的,最近整理资料所以上传到博客备份一下数据在这里:https://www.kaggle.com/competitions/nlp-getting-started/data使用BERT(transformers库)对推特灾难文本二分类xxx着火了(灾难)火烧云像是燃烧的火焰(非灾难)
词词性语法块实体标签SOCCERNNB-NPOOOJAPANNNPB-NPB-LOCGETVBB-VPO在Ner任务中,我们只需要关注词和实体标签,即第一列和最后一列,不需要用到词性和语法块。
这一周终于开始看论文了,昨晚睡觉前突然觉得论文看得越多越糊涂,在gpt帮助下和网路搜索总结一下以上模型。全是自己的理解,轻喷。
出现这个错误时,可能是transformer版本的问题,重新安装transformer即可。
transformer是Google在论文中提出的一种将Attention思想发挥到极致的一种全新的模型,提出解决sequence to sequence问题的transformer模型,用全attention的结构代替了LSTM,抛弃了之前传统的encoder-decoder模型必须结合CNN或者RNN的固有模式,只用attention。
将句子的概率分解为各个单词条件概率的乘积,如果文本较长, 条件概率的估算会非常困难(维数灾难),所以就规定当前词只和它前面的n个词有关,与更前面的词无关,每一个词只基于其前面N个词计算条件概率 —— N-gram语言模型,一般N取1到3之间。词的静态表征,不能解决同义词问题,如水果中的“苹果”和苹果公司的“苹果”,词向量表示是一样的,而实际上这两词的意思完全不一样。,来作为我们每个词的向量表示(词
使用 transformer 结合 BERT 作为关键字提取算法的好处是:可以利用 BERT 的语言理解能力来提取出文本中的关键信息。transformer 模型具有很强的泛化能力,能够很好地适用于不同的语料库。在计算资源允许的情况下,可以使用多层 transformer 来进一步提升模型的表现。BERT 中使用的双向 transformer 可以同时利用当前词语的前后语境信息来进行理解...
基于Bert的中文电商文本分类
猿创征文|信息抽取(2)——pytorch实现Bert-BiLSTM-CRF、Bert-CRF模型进行实体抽取
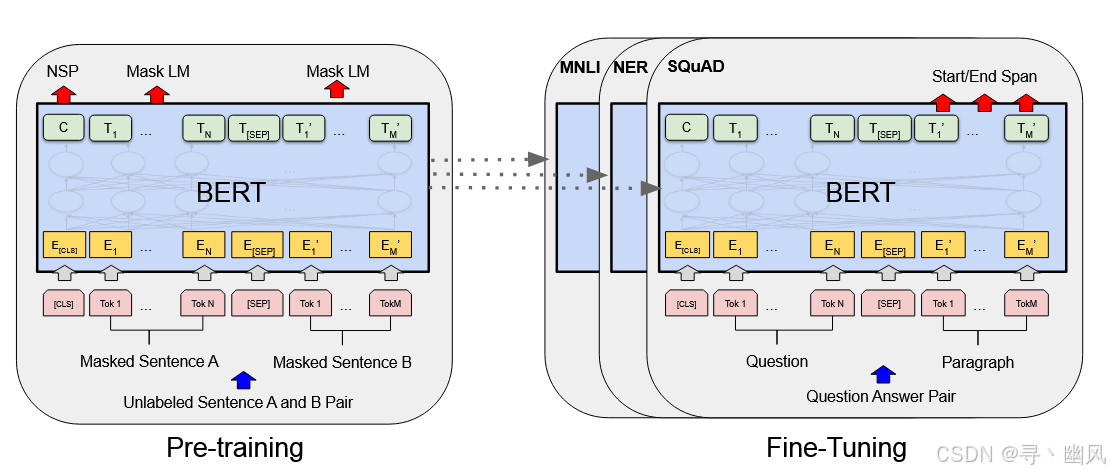
BERT(Bidirection Ecoder Representations from Transformers):左右信息,深的双向Transformer编码(enceder)模型BERT使用自监督的方式在两个任务(MLM和NSP)上进行预训练,使得编码器具备优质的提取特征的能力,迁移至下游任务进一步完成NLP的任务。
利用transformers包加载预训练好的Bert模型得到句子Embedding1. transformers包加载预训练好的Bert模型2. 得到句子Embedding(1)encode()方法:仅返回input_ids(2)encode_plus()方法:返回所有的编码信息3. Eg:以上代码整理,可跑1. transformers包加载预训练好的Bert模型# 1. 导入包import t
原文标题:⼤规模⽆监督预训练语⾔模型与应⽤(中)文章目录1 transformer1.1 encoder部分1.1.1 Attention定义1.1.2 Multi-head Attention1.1.3 position-wise feed-forward networks1.1.4 positional encoding1.1.5 残差链接1.1.6 layer norm1.2 decoder
import torchfrom transformers import BertTokenizer, BertModel#MODELNAME='hfl/chinese-bert-wwm-ext' #ok#MODELNAME ='hfl/chinese-bert-wwm' #ok#MODELNAME='hfl/rbt3'#ok#MODELNAME='hfl/rbtl3'#ok#MODELNAME=
BERT 基于 Transformer Encoder 架构,采用双向上下文建模。通过MLM + NSP的预训练任务,使模型学到深层语义表示。在多个 NLP 下游任务上达到 SOTA(state-of-the-art)表现。BERT 的提出是 NLP 领域的里程碑,为后续的等改进模型奠定了基础。%20b_2M。
BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding 论文阅读笔记
如果由于某些原因您需要更改默认的缓存路径,可以通过设置环境变量来指定新的路径。import os。
语言模型预训练已被证明对改善许多自然语言处理任务是有效的,现有有两种策略可以将预先训练好的语言表示应用到下游任务中:基于特征的策略和微调策略。这两种方法在训练前具有相同的目标函数,它们使用单向语言模型来学习一般语言表示。作者认为,目前的技术限制了预训练表示的能力,特别是对于微调方法。主要的限制是标准语言模型是单向的,这限制了在预训练过程中可以使用的架构的选择。在问题回答中,从两个方向合并上下文是至
链接预测旨在识别知识图中潜在的缺失三元组。为了得到更好的结果,最近的一些研究引入了多模态信息来进行链接预测。然而,这些方法单独利用多模态信息,忽略了不同模态之间复杂的相互作用。在本文中,我们旨在更好地建模跨模态信息,从而引入一种新的交互式多模态融合(IMF)模型来整合来自不同模态的知识。为此,我们提出了一个两阶段的多模态融合框架,以保留模态特定知识,并利用不同模态之间的互补性。我们的多模态融合模块
预训练模型:bert-base-chinese。排名:长期赛:193(本次)/1561。比赛地址:医疗诊疗对话意图识别挑战赛。方案:BERT/BERT+CNN。模型+配置:bert+cnn。
BERT 高频面试题八股文——基础知识篇1. 问:请简述自然语言处理(NLP)的主要研究目标是什么?2. 问:什么是BERT模型,它为什么重要?3. 问:请解释什么是Tokenization以及它在BERT中的作用。
bert
——bert
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 地瓜机器人开发者社区


 北京朝阳AI社区


 乐奇 Rokid 开放社区