登录社区云,与社区用户共同成长
邀请您加入社区
在智能制造升级中,设备“水土不服”源于对参数表象的误读与真实场景鲁棒性预判不足。本文揭示选型核心:跳出营销迷雾,通过全负载压力测试、多场景实测、算法长期稳定性验证及典型落地案例分析,构建理性评估体系。重点识别透明/反光物体识别、极端环境适应性等技术边界,提出10项极限测试清单,助力企业规避“标称值陷阱”,实现智能装备从“买家秀”到“真落地”的跨越。
本文提供了在Windows系统下部署Qwen-Image-Edit图像编辑模型的完整指南。核心步骤包括:更新NVIDIA驱动至CUDA12.1以上版本、安装Git和Anaconda(Python3.10)、创建虚拟环境并安装PyTorch2.1.2(CUDA12.1版本)、通过ModelScope下载38GB模型权重(Qwen-Image-Edit-2511)。文中特别强调版本匹配要求,并针对常见
我的学习资料【【闪客】一小时从函数到 Transformer】https://www.bilibili.com/video/BV1NCgVzoEG9?【90分钟!清华博士带你一口气搞懂人工智能和神经网络】https://www.bilibili.com/video/BV1atCRYsE7x?【大白话讲解:线性回归】https://www.bilibili.com/video/BV17VZkBoE2
本文系统梳理了语言模型的演进历程:从2003年NNLM首次用神经网络替代统计模型,到2013年Word2Vec通过简化架构实现效率突破(CBOW聚合上下文预测中心词,Skip-gram中心词预测上下文),再到2018年BERT采用深层Transformer实现动态语境建模。模型发展呈现从静态词向量到动态上下文表示、从局部窗口到全局双向理解的趋势。不同模型在计算效率、语义捕捉、一词多义处理等方面各具
YOLOv8模型:YOLOv8 是 Ultralytics 公司于 2023 年推出的最新一代 YOLO(You Only Look Once)实时目标检测模型,继承并优化了 YOLO 系列“单阶段、端到端、高精度、高速度”的核心理念。它在架构设计上融合了先进的骨干网络(如 C2f 模块)、更高效的特征金字塔(PAN-FPN)以及改进的损失函数和数据增强策略,在保持推理速度优势的同时显著提升了检测
特征图内存 =例如:输入尺寸480×480,数据类型为float32(4 字节),通道数C的特征图内存为:max_channels上限 ≈ (M × 0.5 × 1024×1024) / (H × W × 4)示例:若M=64MBH×W=30×30,则:中 conv.py 是默认卷积模块和block.py是网络块。
随着RTX 5090的到来,我们看到了一款在AI模型推理、微调与中型训练任务中表现出色的全能GPU。与此同时,RTX 4090 48GB凭借更大的显存,在长上下文与多任务并发下仍具优势。
本文介绍了PyTorch神经网络的基本组件和使用方法。主要内容包括:1)使用torchvision加载CIFAR10数据集并进行数据预处理;2)DataLoader实现批量数据加载;3)卷积层、池化层、非线性激活函数(ReLU/Sigmoid)和全连接层的原理与实现;4)使用Sequential简化网络搭建;5)通过TensorBoard可视化网络结构和训练过程。文章通过具体代码示例展示了如何构建
本文详细介绍了NPU设计的原理、方法和实现,包括运算单元设计、内存架构设计、数据流管理、功耗优化等关键部分。未来,我们需要不断探索新的设计方法和技术,为NPU设计注入更多活力。本文将带领大家深入了解NPU设计的原理、方法和实现,探讨如何发散创新,为NPU设计注入更多活力。神经网络的运算需要大量的数据,因此,如何高效地存储和访问这些数据是内存架构设计的主要任务。在设计过程中,需要考虑到内存的访问速度
BossNAS是一种新型无监督神经架构搜索方法,通过分块自监督学习解决权重共享空间过大和监督偏差导致的问题。该方法将搜索空间分解为多个块,采用"集成自引导"训练方案:先独立训练每个块,再整体搜索最优架构。研究人员还设计了HyTra混合CNN-Transformer搜索空间,搜索得到的BossNet-T模型在ImageNet上达到82.5%准确率,超越EfficientNet 2
/ 允许访问父类 protected 成员}} // 子类不可访问<x-preset class="no-tts reference-tag disable-to-doc" data-index="1">1</x-preset><x-preset class="no-tts reference-tag disable-to-doc" data-index="4">4</x-preset>• 定义:
神奇的是,眼镜不仅可以将这些0和1的数字组合输入给无名,让无名能看见或者听见,同时还可以将数字组合转化成文字输出给外界,让别人看懂或听懂。L:OK,在继续这个故事之前,我先总结一下,无名的这一集正是对应了大模型训练的第一阶段,即数据收集与预处理。您这么擅长讲故事,要不您用讲故事的形式给大家说说GPT-4训练和应用的全流程吧,这里小朋友这么多,肯定都是爱听故事的。L:A爸,假设AI把生产效率提升了成
【论文推荐】人工智能在滑坡风险评估三大核心领域的应用:研究综述(引言)
在网络的最后,有一个输出层。我们可以这么做,把每4个格子为单元,找出最大的那个数,其他剔除,这样组成一个比较小的特征图,却依然保留了原来特征图的重要信息,我们仍然可以看出这是一条右下斜着的线条。做完这个有啥用呢,我们分析就明白,卷积核只有斜着的三个元素是1,所以原来那张图上如果斜着的这三个元素也是1的话,最后一做卷积,这个数字就会变大,我们在特征图上找那些数字特别大,这就是提取到的特征了...
LLM 有能力为 AI 驱动的应用程序带来革命,但该领域的进步似乎有点困难,因为仅仅增加模型的大小可能会提高其性能,但在特定时间之后,性能会达到饱和,处理这些模型的挑战将大于通过进一步增加模型大小所实现的性能提升。LLM 的用例不仅限于上述,还必须具有足够的创造力来编写更好的提示,并且您可以让这些模型执行各种任务,因为它们经过训练,可以执行一次性学习和零次学习方法的任务。大型语言模型 (LLM)
本文提出了一种新颖的令牌增长方案Token Expansion(ToE),用于加速视觉Transformer(ViT)的训练。ToE通过“初始化-扩展-合并”流程,保持原始Transformer中间特征分布的完整性,防止在加速训练过程中丢失关键可学习信息。实验表明,ToE能够在不损失精度的情况下加速ViT的训练,甚至在某些情况下还能提高性能。此外,ToE可以无缝集成到现有的高效训练框架中,无需调整
是库中用于表示图数据结构的一个核心类。
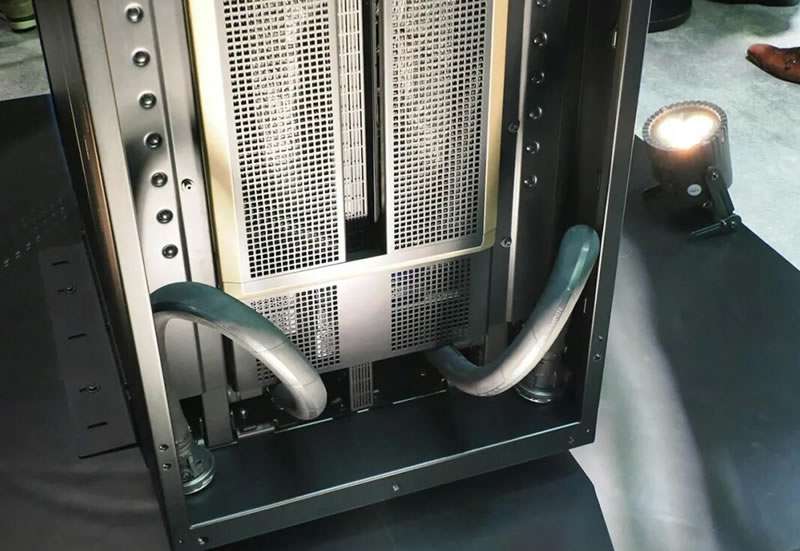
云达科技现场展示的1U机型QuantaGrid D75B-1U,在Nvidia GB200 NVL72的系统建置框架之下,可透过单座机柜容纳72台这样的设备。新一代 AI 液冷机架解决方案 NVIDIA GB200 NVL72,结合了 36 个 NVIDIA GB200 Grace Blackwell 超级芯片,其中包括 72 个基于 NVIDIA Blackwell 的 GPU 和 36 个NV
本资源文件包含了 Pacman 吃豆人游戏的完整 Python 实施。人工智能中的搜索算法游戏状态的表示和更新智能体的行为决策游戏环境的模拟和交互。- 人工智能 Pacman Python 搜索算法 游戏开发 计算机科学
self.layer1 = nn.Linear(10, 20) # 输入层到隐藏层self.relu = nn.ReLU() # 激活函数self.layer2 = nn.Linear(20, 1) # 隐藏层到输出层return x。
这里只是简单的使用ultralytics进行训练,这个比赛是好几年前的,我当时还没开始做kaggle,所以没参与,这里只是为了熟悉目标检测,后面我再去看看mmdetection。
LLamaSharp 是一个跨平台库,用于在本地设备上运行 LLaMA/LLaVA 模型(以及其他模型)。基于 llama.cpp,LLamaSharp 在 CPU 和 GPU 上的推理都非常高效。通过高级 API 和 RAG 支持,您可以方便地在应用程序中部署大型语言模型(LLM)。
一键获取yolo系列latency (推理延迟)的方法
swin transformer 是一种基于 transformer 架构的计算机视觉模型,旨在解决传统 transformer 应用在图像处理时存在的计算成本高和效率低的问题。
卷积内部结构卷积核内部结构例如迁移学习,或者使用固定参数初始化等,有些模型的初始化并不一样,都可能需要使用到自定义卷积核。找到卷积核所在的tensor,conv.weight.data,然后对其赋值操作。运行结果。
部署到3588开发板。
本文介绍了使用YOLOv5进行目标检测的四种方式:1)按文件夹检测,批量处理图片;2)单张图片检测;3)视频检测(包含使用annie工具下载B站等平台视频的方法);4)RTSP摄像头实时检测(需测试连接)。每种方式均展示了检测效果截图,并详细说明了参数修改和操作步骤,前提是已配置好YOLOv5运行环境。文中还提供了视频下载工具的安装教程链接。
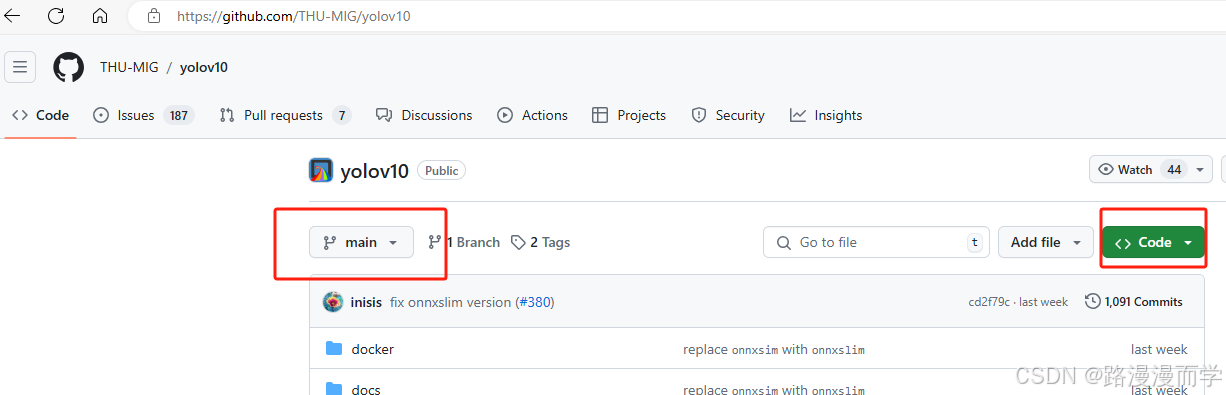
yolov10训练大体步骤与yolov5和yolov8差不多,不同的就是官方没有提供train.py代码。训练先到此为止,后续使用训练好的模型在rk3588+qt进行部署测试。再见!!!
查询向量与一组k个键向量(组合成一个矩阵)使用内积进行匹配。然后用softmax函数对这些内积进行缩放和规范化以获得 k 个权重。注意力的输出是一组 k 个值向量(打包成)的加权和。对于一个包含N个查询向量的序列(封装到中),它产生一个输出矩阵(大小为N × d):其中Softmax函数应用于输入矩阵的每一行。提供了适当的规格化。为了防止当d较大时,点积结果会非常大,导致softmax函数的梯度变
执行,报错 "LINK : fatal error LNK1104: 无法打开文件“kernel32.lib”",搜索 kernel32.lib 的位置为。执行,报错 "LINK : fatal error LNK1104: 无法打开文件“libcpmt.lib”",搜索 libcpmt.lib 的位置为。( 利用OpenCV把一幅彩色图像转换成灰度图 )( 代码用的此博客的,就改了下图片文件路径
yolov8n.yaml可以换成其他模型的yaml,如yolov8s.yaml、yolov8l.yaml、yolov8m.yaml、yolov8x.yaml。repeats:表示当前模块的理论重复次数,实际的重复次数还要由上面的参数depth_multiple共同决定,该参数影响整体网络模型的深度。网络的输入为一幅图像,输出为多个不同层数级的特征图(feature maps),将输出的特征图传递给
(self, cfg=‘yolov5s.yaml’, ch=3, nc=None, anchors=None): 初始化方法,接收模型的配置文件路径 cfg、输入通道数 ch、类别数 nc 和 anchors。_apply(self, fn): 应用给定的函数到模型的张量上,例如 to(), cpu(), cuda(), half()。_descale_pred(self, p, flips, s
目标检测是理解图像内容的基础,它涉及识别图像中的一个或多个对象,并确定它们的位置。YOLOv1将目标检测视为一个单一的回归问题。它将整个图像分割成一个个,每个网格负责预测中心点落在该网格内的目标对象。YOLOv1的架构基于卷积神经网络(CNN),它通过一个单一的网络流程来预测多个边界框和类别概率。网络的输入是一张图片,输出是多个边界框的坐标、置信度以及类别概率。(yolov1的损失函数很重要)
秸秆禁烧烟火识别系统一旦检测到烟雾,秸秆禁烧识别系统将自动监测监控画面中是否存在秸秆焚烧处理,不用人工干涉。当秸秆禁烧烟火识别系统监测到火苗时,系统会自动报警,通知监控管理中心,提示相关人员及时处理。与此同时,将警报截屏和视频保存到数据表中,自动汇总。
如果你在中国或其他地区,网络问题或防火墙设置可能导致与Anaconda官方仓库的连接问题。:如果上述方法都无法解决问题,可能是网络环境本身的问题,如公司或学校的防火墙阻止了连接。这时应联系你的网络管理员或IT支持团队,告知他们你遇到的具体错误,以便他们能够调整网络设置或防火墙规则。:确保你的计算机系统时间是准确的,因为时间偏差可能导致SSL证书验证失败。,这不是推荐的长期解决方案,因为它会降低安全
【代码】pytorch2ONNX时,AdaptiveAvgPool2d的相关问题。
随着神经网络的发展,各种各样的模型都被研究出来,卷积、Transformer也是计算机视觉中国常用的模型,而最近清华大学发表了一篇survey,研究结果或许表明全连接层才是最适合视觉的模型,并将迎来新的AI范式转换!多层感知机(MLP)或全连接(FC)网络是历史上第一个神经网络结构,由多层线性层和非线性激活叠加而成,但受到当时硬件计算能力和数据集大小的限制,这颗明珠被埋没了数十年。
问题描述:在anaconda的创建了一个环境,直接在环境所在的文件夹下面进入cmd命令:pip install *安装某包,但是点开文件夹里面的python.exe却不能import这个包.解决办法:在进入cmd命令时,需要先activate 环境名;然后import就可以了。这些模型在各种 NLP 任务上表现出色,如文本分类、命名实体识别、语义理解、问答等。提供了一个统一的接口,使得用户可以方便
yolov5-6.0训练模型报错RuntimeError: result type Float can't be cast to the desired output type int
3.首先安装了Jetpack的os中都会在/etc/apt/sourch.list.d/中带有nvidia-l4t-apt-source.list文件,里面包含了需要安装基础环境的源路径,不用在单独去下载cuda,cudnn,tensorRT安装包,而且单独下载经过测试存在兼容性问题。cp yolov5/models/yolov5s.yamlyolov5/models/custom.yaml//拷
神经网络(Neural Network,NN)主要由输入层、隐藏层、输出层构成,输入层的的节点数等于待处理数据中输入变量的个数(每一个变量代表了一个特征),输出层的节点数等于与每个输入变量关联的输出的数量(代表了分类标签的个数)。不论是回归还是分类任务,输入和输出层的节点数是固定的(在做二分类时,如果采用 sigmoid 分类器,输出层的个数为 1 个;理论上,隐藏层的层数越深,拟合函数的能力越强
根据 v1.3.0版本官方手册测试后的安装配置,亲测可行。
MP神经网络,即McCulloch-Pitts模型(MCP Model),是神经网络的早期形式之一,由Warren McCulloch和Walter Pitts在1943年提出。这个模型为现代人工神经网络的发展奠定了理论基础,并首次尝试模拟了生物神经元的工作原理。研究过程及原理。
NNLM 通过学习文本序列中的词汇之间的概率关系,能够捕捉到语言的结构和语境,从而能够生成自然语言文本或进行其他与语言相关的任务。嵌入层用于将输入的单词转换为连续向量表示,隐藏层用于学习输入序列的语言结构,而输出层则输出下一个单词的概率分布。具体而言,NNLM 试图最大化给定前文单词的条件下,下一个单词出现的概率。NNLM 的输入是一个固定长度的前文单词序列,用于预测下一个单词。每个单词通常由其词
如何在使用transformers.Trainer时关闭wandb
其有三个重要文件① 图像和标签共同放在同一个大文件夹【obj】② obj.data设定类别数/测试集路径和训练集路径③obj.names 所有标签名(请一一对应classes的顺序)还有一个助手脚本文件,用Python语言编写,用于划分生成指向数据的。
DeiT 是一个全 Transformer 的架构。其核心是提出了针对 ViT 的教师-学生蒸馏训练策略,并提出了 token-based distillation 方法,使得 Transformer 在视觉领域训练得又快又好。
结合opencv与目标检测技术,实现对验证码的自动化bypass
在机器学习领域,混淆矩阵(ConfusionMatrix),又称为可能性矩阵或错误矩阵。混淆矩阵是可视化工具,特别用于监督学习,在无监督学习一般叫做匹配矩阵。在图像精度评价中,主要用于比较分类结果和实际测得值,可以把分类结果的精度显示在一个混淆矩阵里面。在下图是否为猫的预测中,表格左上(实际为正和预测为正)和右下(实际为负和预测为负)是预测正确的值。根据左边表格的数据,可以得出右边表格中的数字,即
推荐与上一节搭配食用~
神经网络
——神经网络
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 DAMO开发者矩阵

 乐奇 Rokid 开放社区