登录社区云,与社区用户共同成长
邀请您加入社区
本篇是我训练营TensorFlow 篇的第 7 次学习(T7),任务是在咖啡豆数据集(Dark / Green / Light / Medium 共 4 类、1200 张)上完成 VGG-16 图像分类。VGG-16 网络结构:13 个卷积层 + 3 个全连接层,全部使用 3×3 卷积核与 2×2 最大池化;VGG-16 的参数量分布特征:全连接层占总量约 89%,是轻量化探索的切入点。K同学啊老
先说清楚概念。本文说的「边缘部署」,指的是把模型推理放到靠近数据产生的地方执行,而不是集中到云端 GPU 集群。端侧设备:手机、平板、车机、智能音箱,推理直接发生在用户设备上。边缘服务器/盒子:工业控制器、边缘网关、视频分析盒子,通常部署在工厂、园区、门店。嵌入式设备:MCU、开发板、机器人、无人机等资源更受限的场景。与云端部署相比,边缘部署的核心差异不是「模型能不能跑」,而是「在受限的算力、内存
摘要:Raspberry Pi OS(Bookworm及以后版本)因PEP668保护机制禁止直接使用pip安装系统级Python包。解决方案是创建虚拟环境:先执行python3 -m venv ~/venv和source ~/venv/bin/activate,再通过虚拟环境的pip安装所需包(如Keras、TensorFlow)。若需开机自动激活,可将激活命令添加至~/.bashrc文件。这一机
当测试初始化时(例如,通过使用MockitoAnnotations.initMocks(this)方法或JUnit 5的@ExtendWith(MockitoExtension.class)),Mockito会扫描测试类中所有使用@Mock注解的字段,并为它们创建模拟对象。这个模拟对象是动态生成的代理对象,它拦截对任何非final方法的调用,并允许测试者通过Mockito的API来配置这些调用的行
检查了几遍都觉得没啥问题,困扰了我很久,而且我另外写的一个手写数字集的识别就没有这个问题。尤其是模型的输入地方,检查了很久,modl.build(input_shape=[None,256,256,3]),觉得有这句话应该不会造成输入的维度不对。而且想了下为什么手写数字集的模型没问题,应该是因为那个模型是一个线性模型,没有用的卷积,只有2个维度,所以没有造成冲突,有些情况下那样写也没出错。第二次运
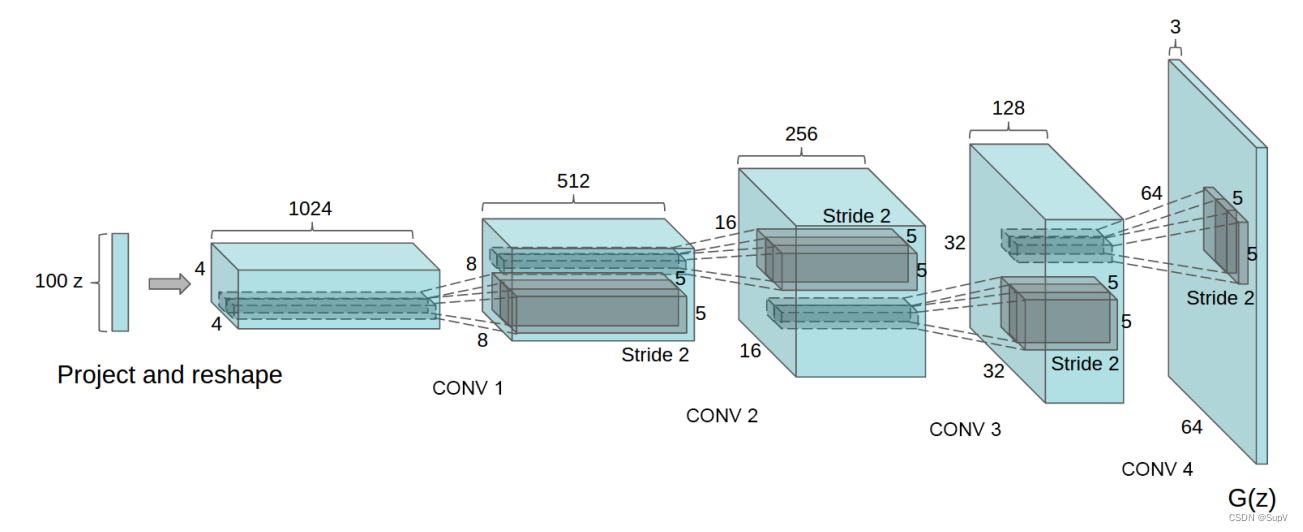
深度卷积神经网络(Deep Convolution Generative Adversarial Nets)的生成网络在DCGAN中,判别网络是一个传统的深度卷积神经网络,但使用了带步长的卷积来实现下采样操作,不用maxpoolingmaxpoolingmaxpooling操作;生成网络使用了一个特殊的深度卷积网络来实现。如上图,使用微步卷积来生成64×6464×6464×64大小的图像。第一层是
安装tensorflow-GPU笔记
对于这个问题,需要做的也很简单,无非就是将模式“P”转化为“RGB”模式,再保存为“jpg”就可以了,所以只用增加两行代码:if img.mode == "P":img = img.convert('RGB')
1.问题描述pip install tensorflow 报错:ERROR: Cannot uninstall 'wrapt'. It is a distutils installed project and thus we cannot accurately determine which files belong to it which would lead to only a partial
GPU kernel died, restarting.或者 InternalError: Failed to create session.ubuntu下安装了两个GPU,spyder突然不能够开多个session了。报错kernel died 或者是 不能创建session。一开始以为是版本问题,重装了anaconda,tensorflow,keras等,问题还在。后来参考该问题:https:
pip install tensorflow -i https://pypi.tuna.tsinghua.edu.cn/simple/
x=tf.constant([2.1301,3.0102,3.3203])for i in range(len(x)):print(round(x[i],2))运行报错如下:TypeErrorTraceback (most recent call last)in1 x=tf.constant([2.1001,3.0012,3.3203])2 for i in range(len(x)):----&
使用scikit-learn跑一个两年前的案例, 报错:cannot import name ‘joblib’ from ‘sklearn.externals’cannot import name 'joblib' from 'sklearn.externals原因: scikit-learn版本太新了, 回退版本即可原来的代码:from sklearn.externals import jobl
在前面我们学习了使用正则表达式的字符集合的表示方法,可以采用枚举的方法,也可以采用连接符的方法,但是还是觉得有些麻烦,比如字符集合,数字集合等等,这些集合可以预先定义好,这不是更加方便了吗?因此在正则表达式里就预先定义下面的这些集合:代码意义\d数字集合\D非数字集合\s分隔符 (tab, space, newline, etc.)\S非分隔符\w字母,数字,下划线\W非(字母,数字
计算机毕业设计Python+Spark+Hadoop考研分数线预测系统 考研院校专业推荐系统 大数据毕业设计 (源码+文档+PPT+讲解)
深入核心,忘掉花哨的引言,咱们这就进入切实可行的技术领域。总结一番,完成这趟奇妙的技术之旅后,乐趣多多,还能享受 tensorflow-rocm 带来的便利和速度。首先,得确保你的Ubuntu系统上,有着一颗闪闪发光的ADM GPU心脏。给予它们力量的名誉——环境变量,这样每当你召唤它们,它们才会应声出现。这不仅仅是输入命令那么简单,这是施展魔法,让系统焕发出全新的力量。就像开启一个古老宝库的钥匙
本人小白一枚,开始用的32位系统在配置TensorFlow是由于很多教程的时效性走了很多弯路,比如一直尝试降降python版本,结果pip莫名其妙用不了,重新链接也不行,弄了两三天能试的都试了,最后试着换成64为系统然后保持py3.9,换国内源,按官网上的pip指令走,终于成功装上了。
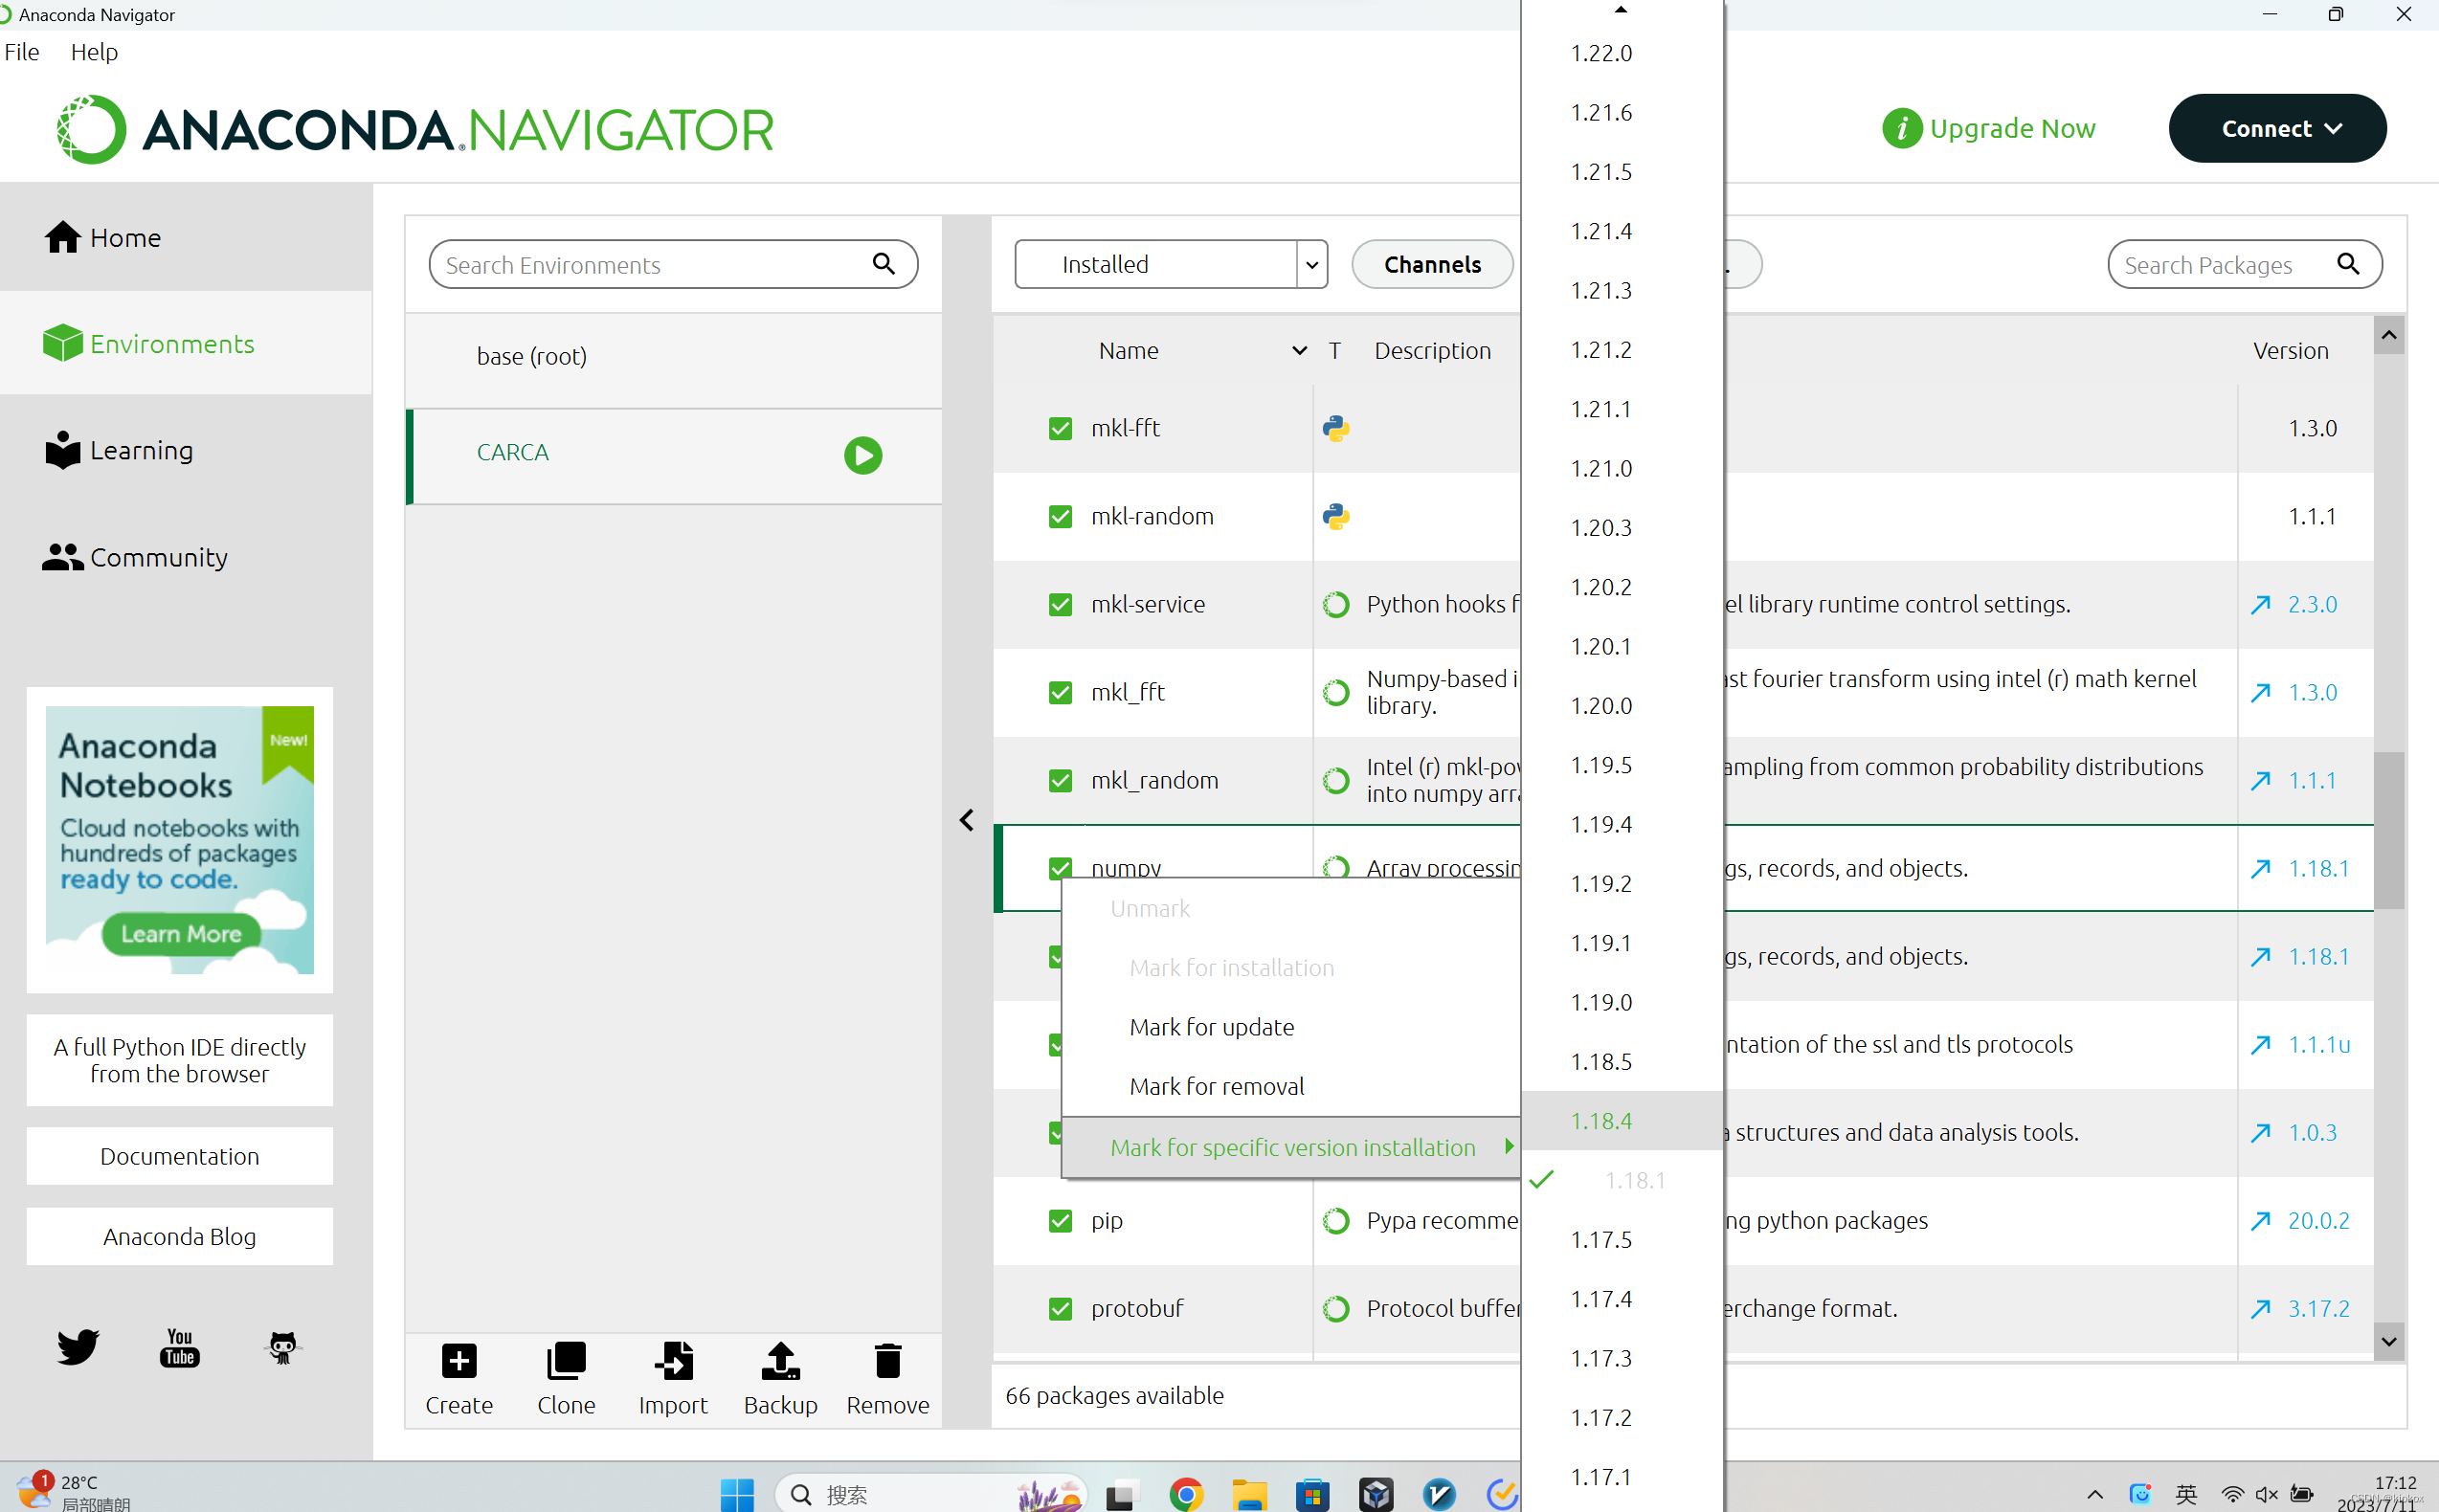
anaconda安装pandas,tensorflow,matplotlib,numpy,six,scitkit-learn的顺序过程,方便指定版本不冲突的安装方法
昇腾计算执行层,负责模型和算子的执行,提供运行时库(Runtim)、图执行器(Graph Executor)、数字视觉预处理(Digital Vision Pre-Processing, DVPP)、人工智能预处理(Artificial Intelligence Pre-Processing, AIPP)等功能单元。昇腾计算服务层,提供了高性能的算子库AOL,以及昇腾调优引擎AOE,是昇腾AI处理
本页将指导您在Raspberry Pi 4 64位操作系统Bullseye 上安装 TensorFlow 2.10.0 或更早版本。
发生错误的原因是安装的tensorflow版本与Keras版本不一致。tensorflow与keras版本对照。卸载已有的keras版本,重新下载。
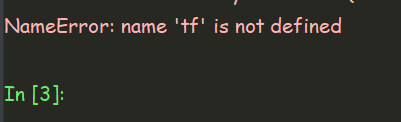
tf.keras.models.load_model(file) 加载模型发生NameError: name 'tf' is not defined
主要分为两部分,一部分是安装hls4ml另一个是安装gpu 版本的tensorflow,比较难安装的是tfhttps://github.com/fastmachinelearning/hls4ml-tutorial不然报错”AttributeError: module ‘tensorflow.keras.layers’ has no attribute ‘MultiHeadAttention’根据
多目标排序MMoE、PLE
事情的起因:因为自己手残,更新了我搭建的tensorflow虚拟环境中numpy的版本(更高),导致import pandas 时出现版本不匹配的问题,于是将pandas一起更新。这时,pandas和numpy可以使用,但是由于tensorflow和keras(版本较低)依赖numpy,因此tensorflow和keras无法使用现在的numpy。遂走上了寻找这几个库相互兼容的道路。解决方案:(经
https://github.com/lhelontra/tensorflow-on-arm/releases
尝试失败的https://github.com/soloIife/yolov5_for_rknnrknn toolkit examples里面自带的均可转为rknn,yolov5s无法转换尝试成功的import yamlfrom rknn.api import RKNNimport cv2_model_load_dict = {'caffe': 'load_caffe','tensorflow':
背景运行一个tensorflow的项目。代码中指定的tensorflow版本是1.4.1。我是在服务器上跑代码的,使用conda创建一个python = 2.7的虚拟环境,并pip安装了tensorflow = 1.4.1。服务器的cuda版本是11.1。问题执行代码时,import tensorflow就报错 libcudnn.so.6: cannot open shared object fi
python3 -m pip install --upgrade https://storage.googleapis.com/tensorflow/mac/cpu/tensorflow-1.12.0-py3-none-any.whl
推荐系统之YoutubeDNN代码详解import pandas as pdfrom deepctr.feature_column import SparseFeat, VarLenSparseFeatfrom sklearn.preprocessing import LabelEncoderfrom tensorflow.python.keras import backend as Kfrom
解决ImportError: cannot import name ‘np_utils’ from ‘tensorflow.keras.utils’在构建语料库词汇表时使用了from tensorflow.keras.utils import np_utils出现下列错误解决方法将导包的语句改成:from tensorflow.python.keras.utils import np_utils错
天池推荐系统学习赛task03打卡:多路召回主办方给的教程挺好的,需要学习多路召回的同学可以看一下零基础入门推荐系统【多路召回】Task3这里需要用到faiss,这个包的安装还挺麻烦的,可以参考下面这篇博客faiss安装测试环境win10anaconda 4.4.10python 3.6.3faiss(CPU)安装成功后面deepmatch部分,由于本机本来没装tensorflow,安装deepm
Neo4j是图数据库,即数据不是保存在表或集合中,而是保存为节点以及节点之间的关系。Neo4j数据主要由节点、边、属性构成。在Neo4j中,节点以及边都能够包含保存值的属性1、安装 py2neo的安装: pip install py2neo2、例子1#coding:utf-8from py2neo import Graph,Node,Relationship ##连接neo4j数据库,输入地址、用
AttributeError: module ‘keras.backend’ has no attribute ‘set_session’出现这个错误主要是因为tensorflow2.0以上的版本已经没有set_session了,所有需改一下:from keras import backend as Ktf_session = tf.compat.v1.Session(graph=tf.compa
解决:selenium.common.exceptions.WebDriverException: Message: ‘chromedriver’ executable needs to be in PATH. Please see https://sites.google.com/a/chromium.org/chromedriver/home以Chrome为例:解决办法:安装与浏览器版本匹配的
问题背景:用tensorflow训练自己的数据的时候,训练一段时间后,出现TypeError: 'numpy.float64' object cannot be interpreted as an integer错误。电脑安装有numpy,版本为1.18.1电脑安装有pycocotools库查阅资料后,发现是numpy版本的问题。两种解决方法:方法一: 将numpy换成低版本,p...
情感化聊天机:结合内外记忆的情感对话生成摘要情感的感知和表达是对话系统或会话代理成功的关键因素。然而,到目前为止,这一问题还没有在大规模对话生成中得到研究。本文中,我们提出的情感聊天机(ECM)不仅在内容上(相关性和语法性),而且在情感方面(情感一致性)也能产生合适的回复。据我们所知,这是第一个考虑到大规模对话生成中涉及情感因素的工作。ECM使用三种新机制来解决这一问题:(1)通过嵌入情感...
对tensorflow-gpu10源码进行编译报错ERROR: Config value cuda is not defined in any .rc file问题原因:bazel版本过高。解决办法:tf1.10的构建版本时需要使用bazel 0.15,换成了bazel 0.15版本构建问题解决。...
在训练神经网络的时候,有时候数据的读取处理所占用的时间比较长,像数据量非常大的情况,或者是3D的数据预处理比较耗内存的情况。此时我们希望并行化,即数据处理与训练同时进行。参考:https://tensorpack.readthedocs.io/tutorial/extend/input-source.html图片上为两种数据处理的方式:并行化和串行化。并行化:在处理数据的时候并进行训...
今天在Raspberry上安装Tensorflow遇到以下错误,这里记录一下:THESE PACKAGES DO NOT MATCH THE HASHES FROM THE REQUIREMENTS FILE. If you have updated the package versions, please update the hashes. Otherwise, examine the p..
TensorFlow中进行单元测试的例子
出现问题可能是在在上面函数中定义了learning_rate,而下面是是顶格。python和C/C++不同的地方是python的缩行代表了变量作用的范围。这也是《TensorFlow实战Google深度学习框架》这本书中的一个小错误。...
1 问题描述在使用pip3 安装完tensorflow时并未发现任何错误,在测试的时候出现如下错误:2 问题分析和解决该问题出现在运行时,可能的原因是编译库的编译器和编译当前程序的编译器版本是不一样的,且当前程序的编译器的版本是比较低的,需要进行升级,即要更换可能由于当前库中的libstdc++.so.6文件。3 解决办法1)查看当前的GLIBC有哪些strings /usr/li...
系统环境:Ubuntu14.04 + GTX1080 目的:配置一下python-tensorflow环境问题复现: 使用设置/软件与更新/附件驱动安装nvidia-375 使用CUDA-8.0*.run安装CUDA 使用cudnn*.tgz安装cudnn5.1 PATH里面加入了/usr/local/cuda-8.0/bin LD_LIBRARY_PATH里面加入了/
windows tensorboard http://0.0.0.0:6006 无法访问 解决方法 - using chrome and localhost as ip
树莓派无屏幕无键盘连接笔记本电脑1 我们需要用到的软件(Windows下)2 树莓派的前期配置(第一次使用)3 查找树莓派的ip地址(无线网络为例)4 连接PuTTY和TightVNC server1 我们需要用到的软件(Windows下)对于很多在树莓派上开发的程序员来说,没有显示屏、键盘和鼠标等配件都是正常的。在Windows下,我们需要下载PuTTY(用来做远程连接使用的)和TightV..
个人总结能实现多GPU跑图的方法:1、使用谷歌框架tf.estimator;session_config = tf.ConfigProto(device_count={'GPU': 0,'GPU':1,'GPU':2,'GPU':3})run_config = tf.estimator.RunConfig().replace(session_config=session_confi...
在电商领域,推荐系统承担着提升用户转化率和平台GMV的核心使命。根据麦肯锡研究,亚马逊35%的销售额来自推荐系统,Netflix用户75%的观看行为由推荐驱动。传统协同过滤算法在数据稀疏性和冷启动问题上存在瓶颈,而深度学习模型通过挖掘用户和商品的深层特征,能够显著提升推荐效果。
检查你当前 Python 环境中安装了哪些包,特别是 TensorFlow。显示2.11 tensorflow,还是不行,显示python3.7版本不对应(不懂?tensorflow1.x 与keras独立,2.x包含keras,不用另外安装keras。版本(对于 macOS 来说,则需要高于 20.3 的 pip 版本)。TensorFlow 2 软件包需要使用高于 19.0 的。查阅tenso
Docker 最初是 dotCloud 公司创始人 Solomon Hykes 在法国期间发起的一个公司内部项目,它是基于 dotCloud 公司多年云服务技术的一次革新,并于 2013 年 3 月以 Apache 2.0 授权协议开源,主要项目代码在 GitHub 上进行维护。Docker 项目后来还加入了 Linux 基金会,并成立推动 开放容器联盟(OCI)。Docker 在容器的基础上,进
tensorflow
——tensorflow
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 AtomGit AI 社区

 DAMO开发者矩阵

 乐奇 Rokid 开放社区













 天工造物局