登录社区云,与社区用户共同成长
邀请您加入社区
本研究的主要目的是深入探讨语言模型在因果推理图构建与社会政策影响评估中的应用及研究进展。随着人工智能技术的飞速发展,语言模型在自然语言处理领域取得了显著成果。因果推理图作为一种有效的工具,能够直观地表示变量之间的因果关系。将语言模型应用于因果推理图的构建,可以充分利用其强大的文本理解和信息提取能力,为社会政策影响评估提供更准确、全面的分析。本研究的范围涵盖了语言模型的相关技术、因果推理图的构建方法
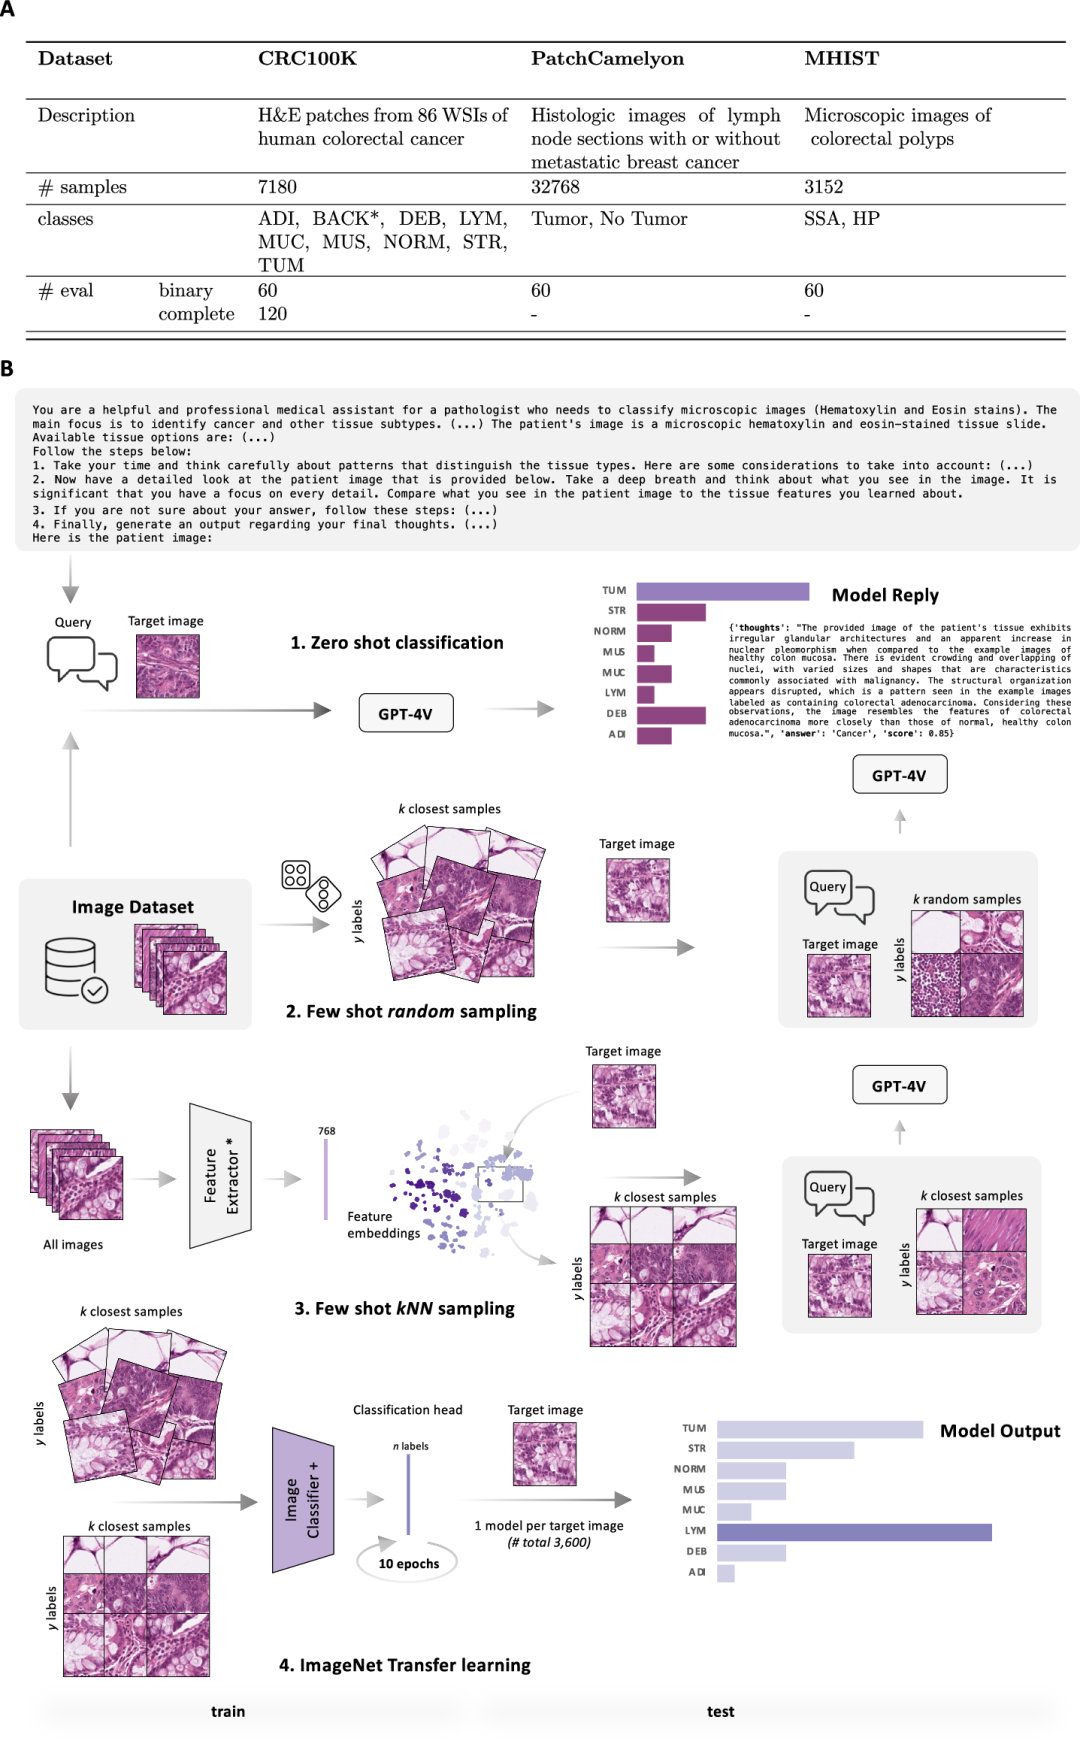
01.工作速览医学图像分类需要使用标记过的、特定于任务的数据集来从头训练深度学习网络,或者用于微调基础模型。然而,这一过程在计算和技术上都极具挑战性。在语言处理中,上下文学习提供了一种替代方案,模型可以直接从提示中学习,从而绕过参数更新的需求。然而,上下文学习在医学图像分析中的应用仍处于探索阶段。2024年11月21日,德国海德堡大学在_Nature Communications_在线发表题为**
随着技术的不断演进,将开源大语言模型(LLM)集成到测试流程中已成为提升测试效率和质量的新趋势。本文将详细探讨如何实现这一集成,以及在集成过程中需要关注的关键要点,并通过一个具体案例加以说明,同时提供相应的示例代码。
通过对自然语言指令进行条件设置,大型语言模型展现了作为通用计算机的强大能力。然而,任务的性能很大程度上取决于用于引导模型的提示质量,且最有效的提示通常是由人工精心设计的。受到经典程序合成和人类提示工程方法的启发,我们提出了自动提示工程师(Automatic Prompt Engineer,APE),用于自动生成和选择指令。在我们的方法中,我们将指令视为“程序”,通过搜索由 LLM 提出的指令候选池
基于统计方法的语言模型主要是指利用统计学原理和方法来构建的语言模型,这类模型通过分析和学习大量语料库中的语言数据,来预测词、短语或句子出现的概率。
在本案例中,我们通过深入探索基于Python和SpaCy的自然语言处理技术,成功展示了如何从简历中提取关键信息,特别是技能的提取。这一过程不仅帮助我们提高了对简历文本结构的理解,也为如何自动化处理大规模文本数据提供了有效的方案。通过对数据集的预处理、实体识别模型的构建、技能模式的匹配、以及技能分布的可视化,我们能够高效地将杂乱的文本转化为具有分析价值的结构化数据。此外,这个案例展示了如何在数据科学
1.背景介绍自从2018年Google发布了BERT模型以来,自然语言处理领域的发展就进入了一个新的高潮。随后,OpenAI在2020年推出了GPT-3,这是一个具有1750亿个参数的大型语言模型,它能够生成高质量的文本,并在许多自然语言处理任务上取得了显著的成果。然而,随着GPT-3的普及,也引发了一系列关于其社会适应性和道德问题的讨论。在这篇文章中,我们将探讨GPT-4如何满足不同文化...
图片以及思想来源请参考论文。
3.tomcat环境:Tomcat 7.x,8.x,9.x版本均可 4.硬件环境:windows 7/8/10 1G内存以上;管理员角色包含以下功能: 登录,首页,用户管理,宠物管理,订单管理,留言管理,新闻管理,新增用户,添加分类,添加宠物,添加新闻,分类管理等功能。基于javaweb和mysql的jsp+servlet宠物商城系统(java+jsp+javascript+servlet+mys
智能问答系统是一种利用人工智能技术理解并回答用户提问的应用。该系统通过自然语言处理技术分析问题的含义,并在知识库中查找相关信息,以生成一个或多个可能的答案。这些答案基于对问题的理解及知识库中的数据生成。智能问答系统适用于多种场景,如在线客服、智能助手和教育辅导等,能够显著提升信息获取速度与用户体验。其关键组成部分包括:自然语言处理(NLP),用于解析问题;知识库,存储了丰富的结构化和非结构化信息;
embedding 是自然语言处理 (NLP)中的一种变革性技术,它改进了机器理解和处理人类语言的方式。其将原始文本转换为数字向量,让计算机更好地理解它。因为计算机只能用数字思考,无法独立理解人类的语言。借助文本嵌入,计算机可以更轻松地阅读、理解文本,并对查询提供更准确的响应。下图可以更加形象的理解:embedding 是一种将文本中的单词或短语转换为机器可以理解的数字数据的方法。可以将其视为将文
c++国际象棋有人机qt5.9.9启动chesss
先来说下添加tabs的两种方式第一种以href链接的方式:function addTab(title, url){ if ($('#tt').tabs('exists', title)){ $('#tt').tabs('select', title); } else {
但是,如果你想要在一个大型文本中快速找出所有的数字,你可能可以使用一个专门的自然语言处理工具或者大模型。例如,你可以在大型文本中使用大模型来找到所有的数字,然后在Python中找到这些数字在文本中的位置。在这个例子中,我们使用了正则表达式`\(([0-9]+)\)`来匹配括号内的数字。`([0-9]+)`是一个捕获组,它匹配一个或多个数字。在这个例子中,我们使用了更复杂的正则表达式`\([0-9]
在本教程中,我们将学习如何使用Ollama和OpenWebUI在本地部署阿里通义千问Qwen2 AI大模型。通过这一过程,您将能够在本地运行强大的自然语言处理模型,并利用其生成文本、回答问题等功能。
在自然语言处理领域,BERT模型就像是一个超级大英雄,它在很多任务中都表现得非常出色。但是,这个大英雄也有一个小毛病,就是它的“身体”太庞大了,运行起来需要很多的资源,速度也比较慢。我们这篇文章的目的就是要想办法给BERT模型“减肥”,使用剪枝技术把它不需要的部分去掉,让它变得更轻便,同时还能保持它的超能力,也就是性能。我们会详细介绍剪枝技术的原理、操作步骤,以及在实际项目中的应用。这篇文章适合对
为了能够实现对定时任务的动态控制,我将定时任务做了一个实体类,并将相关信息映射到了数据库中 package com.acca.entity;/**** 任务实体*** @author zhouhua, 2013-1-16*/public class SchedulingJob {public static final...
2026年性能测试工具呈现智能化、低代码化趋势。LoadRunner在企业级协议支持和分布式压测方面保持优势,新增流媒体协议优化;JMeter则强化云原生协议适配,但需插件扩展非标协议。LoadRunner提供AI辅助开发和基础设施监控,但成本较高;JMeter凭借开源优势更易合规,但需技术投入。选型建议:标准化协议场景用JMeter,传统核心系统选LoadRunner,关键业务可混合使用。测试工
本文汇总了多个基于Django、JSP、Node.js、PHP、Python和SpringBoot的毕业设计项目,涵盖教育、电商、医疗、农业、旅游等多个领域。主要项目包括:Django框架下的考研学习系统、农业害虫识别系统;JSP开发的中小企业门户网站;Node.js实现的养老院管理系统;PHP构建的律所管理系统;Python设计的影视推荐系统;以及SpringBoot开发的宠物医院管理、电子病历
原因:缺少使用data-options=”region:’center’的div<body class="easyui-layout" id="bbb"><div border="false" data-options="region:'center',title:' 当前位置--&am
使用EasyUI的新版本出现Cannot read property 'options' of undefined。解决步骤:1、通过浏览器js提示,确定问题所在,可能出现循环调用,不是每次都抛异常,需要细心。2、断点,确定具体问题_24b是undifined,undefined调用属性options当然就报没有该属性,之后确定_24b的来源,$.data(_249,'
本文介绍了一个基于Spring Boot框架的化妆品推荐系统开发项目。系统采用Java语言开发,使用MySQL 5.7数据库存储数据,通过整合机器学习算法和个性化推荐技术解决化妆品选择难题。项目实现了用户皮肤分析、产品匹配推荐、虚拟试妆等功能,后台采用管理员账号管理,前端界面友好。开发环境包括JDK1.8、Tomcat7、Maven3.3.9等工具,系统具有运行速度快、安全性高等特点。核心代码展示
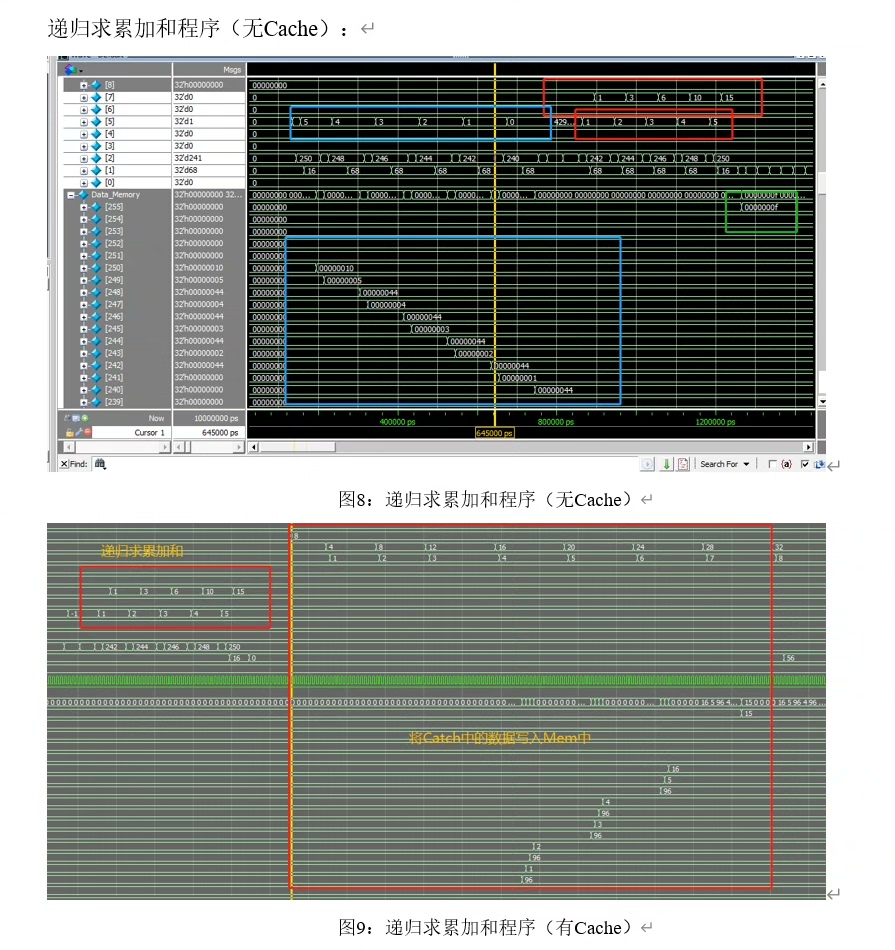
本设计实现了基于RISCV指令集的五级流水线CPU,支持R/I/S/B/U/J型指令,通过前递和冒险检测解决流水线冲突,集成Cache提升访存效率,通过AHB总线扩展外设。代码严格遵循模块化设计,各阶段功能独立且通过寄存器传递数据,忠实还原了RISCV处理器的基础架构与运行逻辑。
最新发布的AllenNLP Interpret包含对NLP模型进行对抗攻击的功能,但仅限可解释性研究用途,且仅支持通过输入缩减或基于贪心梯度的词语替换进行攻击(Wallace等人,2019)。例如Jin等(2019)提出的TextFooler方法原本用于分类和蕴含模型攻击,若研究者想将其搜索策略、转换方法和约束条件应用于翻译模型,只需在TextAttack中实现翻译目标函数即可创建用于翻译模型分析
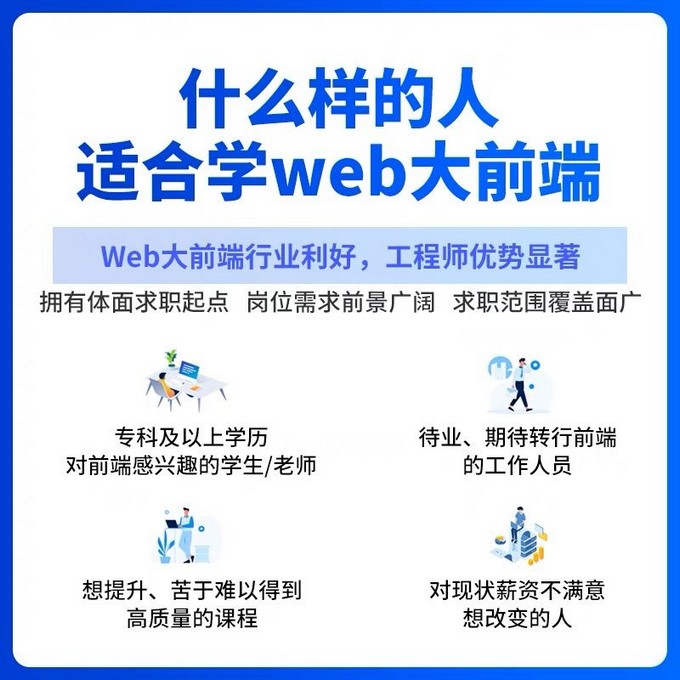
前端程序员转行到大模型领域,需要学习一系列新的技能和理论知识。
将查询的数据库信息存储在会话(session)中,以便在多个请求之间反复使用,是一种常见的优化策略。会话持久化:会话数据通常存储在服务器的内存中,如果服务器重启,会话数据会丢失。数据一致性:如果数据可能会在用户会话期间发生变化,需要确保会话中的数据是最新的,或者在数据变化时更新会话中的数据。会话大小:不要在会话中存储大量数据,这会增加内存使用,并可能导致会话数据丢失。如果会话中有数据,直接使用会话
本文将详细探讨PlugLink与RPA的不同之处,并介绍它们如何高效融合,助力企业实现更高级的自动化。PlugLink和RPA的结合,可以在更广泛的场景中实现自动化,大幅提升企业运营效率。通过灵活运用PlugLink的插件框架和RPA的自动化能力,企业可以创建更智能、更高效的业务流程。通过PlugLink集成的自然语言处理模型,RPA可以自动分析简历内容,筛选符合条件的候选人,并将结果提交给HR部
给大家分享一些关于HTML的面试题。网上学习资料一大堆,但如果学到的知识不成体系,遇到问题时只是浅尝辄止,不再深入研究,那么很难做到真正的技术提升。需要这份系统化的资料的朋友,可以添加V获取:vip1024c (备注前端)一个人可以走的很快,但一群人才能走的更远!不论你是正从事IT行业的老鸟或是对IT行业感兴趣的新人,都欢迎加入我们的的圈子(技术交流、学习资源、职场吐槽、大厂内推、面试辅导),让我
一、mht文件的文件名及路径中不能包含中文。二、修改节点的属性,检查路径是否正确。
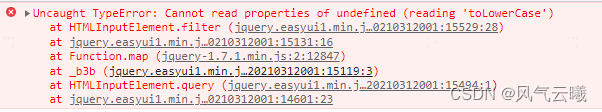
easyui-combobox报错 Cannot read properties of undefined (reading 'toLowerCase'),重写filter方法,解决报错,同时能够模糊搜索
源码获取:博客首页 "资源" 里下载!项目介绍系统主要功能包括:首页零售管理:零售出库、零售退货;采购管理:采购订单、采购入库、采购退货;销售管理:销售订单、销售出库、销售退货;仓库管理:其它入库、其它出库、调拨出库、组装单、拆卸单;财务管理:收入单、支出单、收款单、付款单、转账单、收预付款;报表查询:库存状况、结算账户、进货统计、销售统计、入库明细、出库明细、入库汇总、出库汇总、客户对账、供应商
花了好久弄好的二叉树代码,希望能帮到你们超级详细二叉树实现1、二叉树程序功能前情提要 !!!1.1主菜单功能:1.前序创建二叉树2.前中后序输出3.统计叶子数4.复制二叉树5.交换左右子树6.计算二叉树高度7.输出叶子结点到根结点所有路径8.输出叶子结点到根结点最长路径9.二叉树的所有关系10.字符模式画二叉树11.easyx画二叉树1.2子菜单功能:1.根、叶节点2.结点的双亲 祖先 孩子 子孙
本文主要记录自己在实际开发中,遇到的一个问题:需要数据库中读取部门数据,并生成部门管理树形结构图,对部门进行操作,显示效果如下图所示:由于涉及到公司商业机密,因此在此自己将这个模块单独提炼出来并做了一些修改,并只贴出主要代码。一、前期说明及准备:1.后台是基于ssm框架(Spring MVC+Spring+Mybatis);2.使用mysql数据库;3.前端使用easy
使用easyui框架 有个缺点就是响应有些慢,比如使用dialog 提交表单的时候可能要经过几秒才能提交上,如果用户连续点击提交按钮,可能造成重复提交。有个办法可以解决这个问题,就是使用进度条,也是easyui自带的。像如下这样:$.messager.progress();var form = $("#addcompany");form.aja
拓展1$.extend($.fn.validatebox.defaults.rules,{ //验证中文CHS:{validator:function(value){return /^[\u0391-\uFFE5]+$/.test(value);},message:"只能输入汉字."},//字符验证stringCheck:{validator:func
根本问题,是我们在页面中重复创建了 dialog 或window造成的!尤其是再多页面切换时更容易造成这个问题!easyui 中的大部分组件都是从panel继承过来的,如window、 dialog、datagri等组件,这些组件如果多次初始化,关闭时就会报$.data(_1a8, "panel") is undefined或$.data(...).options不存在等诸如类似的错误
数据预处理不是 “一次性操作”,而是需要根据数据类型、模型目标动态调整的过程。数据探索先行:不了解数据分布就处理,容易导致 “越处理越糟”;管道化封装:用将预处理步骤串联,避免数据泄露;可视化验证:关键步骤(如图像拼接、异常值检测)需可视化确认效果;参数调优:如 Canny 边缘检测的阈值、TF-IDF 的最大特征数,需结合业务调整。掌握这些方法后,你将能应对 90% 以上的数据预处理场景,为后续
简单来说,tokens 是将文本分割成的一个个基本单元。当我们输入一段文字时,人工智能模型不会将其视为一个连续的整体,而是会把它拆分成更小的部分,这些部分就是 tokens。例如,对于句子 "The cat is on the mat",常见的分词方式可能会将其拆分为 ["The", "cat", "is", "on", "the", "mat"] 这 6 个 tokens。这种拆分并非随意为之,
1.背景介绍随着互联网的普及和数据的快速增长,文本数据已经成为了我们生活中最重要的信息来源之一。从社交媒体、博客、新闻报道到科研论文、商业报告等,文本数据在各个领域都有广泛的应用。因此,如何从大量的文本数据中发现关键信息和隐藏的知识变得至关重要。这就是文本挖掘(Text Mining)的诞生。文本挖掘是一种数据挖掘方法,它涉及到从文本数据中提取有价值信息、发现隐藏模式和规律的过程。这些信息...
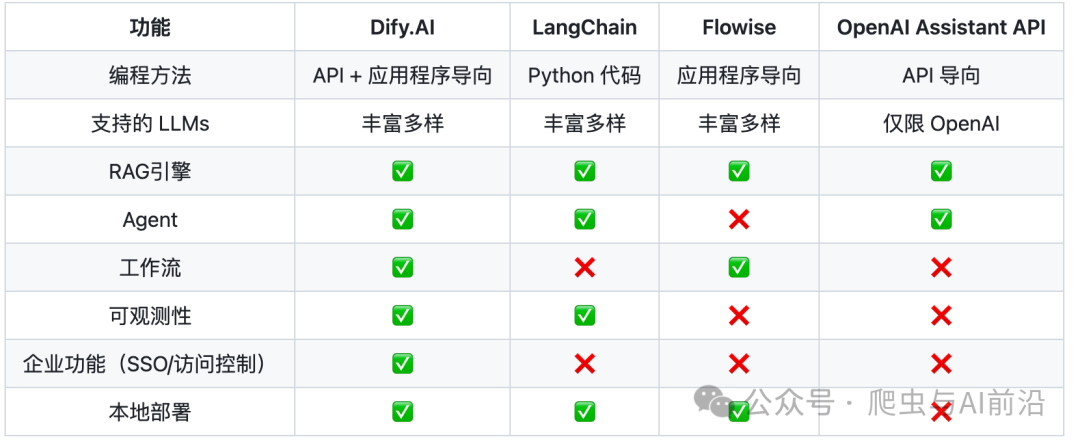
Dify是一个开源的 LLM 应用开发平台。其直观的界面结合了 AI 工作流、RAG 管道、Agent、模型管理、可观测性功能等,让您可以快速从原型到生产。
jquery_easyui_中文解析 原文请到:http://www.cnblogs.com/MFLY/archive/2011/07/19/2110876.html 最近经常接触easyui,但是easyui官网又总是上不去,所以在网上搜罗了easyui的中文解析,以备查询。CSS类定义:div easyui-window window窗口样式属性如下:1)
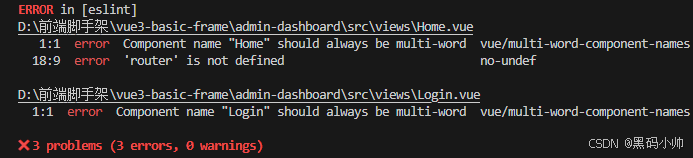
在vue3.x项目遇到问题:1:1 error Component name "Home" should always be multi-word vue/multi-word-componen
然后,从队列 queue 中取出当前最优的节点 (即最短路径的终点),并判断该节点是否已经访问过。同时,将当前节点到目标节点的边加入路径列表 path 中,并将该节点的未访问邻居节点加入队列 queue 中。首先,将起始节点 start 加入队列 queue 中,并将其加入已访问节点集合 visited 中。GBFS 算法在许多实际应用中都有广泛的应用,比如在计算机图形学中用于寻找两个三角形之间的
很多项目中,注册用户和注册企业时需要用到省市县三级联动的情况,自己整理了一下。前端主要是jquery easyui做的。页面效果:目录结构:项目源码地址:https://github.com/lilongsen/LimxDream此项目为maven版本。登陆时的用户名:limingxing密码:123456AreaDao层接口package
摘要:主要介绍如何实现三种Tree的初始化工作、并且重点叙述使用ajax动态加载树、以及初始化的时候展示全部树的结构。
NLTK(Natural Language Toolkit)是一个开源的Python库,专注于自然语言处理任务。它提供了大量现成的工具和数据集,帮助开发者快速实现文本处理、词性标注、命名实体识别等功能。丰富的文本处理功能:支持分词、词干提取、词形还原等基本操作。强大的语料库支持:内置多种语言的语料库,如英文、中文等。灵活的机器学习接口:支持多种分类器和模型训练。易于上手:API设计简洁,适合初学者
本文介绍自然语言处理的定义、典型应用及面临的主要难点,还讨论了符号主义、统计方法、联结主义三大方法论流派,最后对专栏接下来的内容做了简介。
本文介绍了正则表达式的基础语法和常见应用,包括常用元字符(如.、*、+等)的功能说明,以及使用时的注意事项(转义字符、贪婪匹配等问题)。重点展示了自然语言处理中的典型应用场景,如名词提取、句子分割和地名识别,并提供了对应的正则表达式模式和改进建议。文章最后推荐了一个包含100种应用场景的正则表达式查询库,涵盖数据验证、文本处理等多个领域,为开发者提供了实用的参考工具和测试验证功能。
easyui
——easyui
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 乐奇 Rokid 开放社区












 天工造物局










 DAMO开发者矩阵


 AtomGit开源社区