登录社区云,与社区用户共同成长
邀请您加入社区
来源 | 无敌码农责编 | 寇雪芹头图 | 下载于视觉中国在云原生除了K8S、微服务,还有...?中和大家聊了下关于云原生的话题,在云原生的概念中比较明确的一个特点就是云原生是基于云计算的...
1 前言图1-1:边缘计算与SD-WAN;来源:kontron原本说好的是MEC用例协议导读,怎么又给整到SD-WAN去了。别急,这正是协议导读的开篇。几个考量:ETSI GS MEC 0...
边缘计算是分布式计算技术的一种,是在靠近物联设备终端的位置上进行数据处理的方法物联网中边缘计算与区块链的结合是大势所趋,但需要解决安全、计算资源分配不均,及监管诸多问题刘玉书 |文边缘计算...
本文编译自Open Glossary of Edge Computing,仅供学习交流。转载自SDNLAB3G、4G、5G第三代、第四代和第五代蜂窝技术。简单来说,3G 代表智能手机及其移...
本文转载自《智能科学与技术学报》主管:工业和信息化部主办:人民邮电出版社指导:中国自动化学会ISSN 2096-6652CN 10-1604/TP作 者 赵航1,2, 刘胜1, 罗坤1, 陈世超1, 孔令辉3, 贾凡1,41 中国科学院自动化研究所复杂系统管理与控制国家重点实验室,北京 1001902 中国科学院空天信息创新研究院,北京1000943 中...
清华大学最新《面向实时视频流分析的边缘计算技术》综述实时视频流分析在智能监控、智慧城市、自动驾驶等场景中具有重要价值. 然而计算负载高、带宽需求大、延迟要求严等特点使得实时视频流分析难以通过传统的云计算范式进行部署. 近年来兴起的边缘计算范式, 将计算任务从云端下沉到位于网络边缘的终端设备和边缘服务器上, 能够有效解决上述问题. 因此, 许多针对实时视频流分析的边缘...
点击上面“蓝字”关注我们!作者:边缘计算社区来源:知乎1.边缘计算是什么?目前边缘计算概念百花齐放,几百家观点,暂无大家统一的定义。在这里姑且用维基百科上给出的边缘计算的概念来加以介绍。边缘计算是一种分散式运算的架构,将应用程序、数据资料与服务的运算,由网络中心节点移往网络逻辑上的边缘节点来处理。边缘计算将原本完全由中心节点处理大型服务加以分解,切割成更小与更容易管理的部...
导读:如果未来的数字社会属于元宇宙,那么我们需要什么来支撑如此庞大的数字世界?作者:成生辉来源:大数据DT(ID:hzdashuju)元宇宙是指与物理世界分离的平行数字世界,由人创造并以数字形式对其进行操作。每个进入元界的人都会形成一个数据文件,随着社会活动的产生,数据会不断增长,从而形成一个大数据网络。可以肯定的是,元宇宙一旦开发应用,将产生海量数据,给现实世界带来巨大...
用户管理功能的实现是可以对于系统当中所有的用户信息进行管理,同时也可以通过系统来搜索用户信息,并且也可以通过用户管理来修改或者是删除用户信息。管理员可以通过菜品识别菜单来进行检测图片中的菜品信息,通过点击上传要检测的图片,然后点击开始检测,系统会通过所传的图片给出相应的答案信息。当管理者需要检测多种菜品信息时,可以选择使用批量识别检测功能,系统会通过管理者上传的批量信息做出准确的检测。系统功能需求
关键洞察:组织规模化遇到的问题,多 Agent 系统会原样再遇到一遍——沟通成本、信息丢失、职责重叠、单点阻塞。所以 Graph 层的设计方法论更接近组织设计,而非 prompt 工程。评估标准:加一个新 Agent 的边际成本是多少?故障隔离吗?整体产出是否 > 各部分之和?三层之间的关系Graph(组织协同)▲每个 Agent 节点内部是一个合格的 LoopLoop(持续改进)▲每次改进作用的
手上已经有 4 台互通的 CentOS 7 虚拟机,准备把 Hadoop 生态真正搭成一个「完全分布式」集群的同学;以及在伪分布式上跑通了、一切到多节点就各种进程起不来的同学。本篇从「操作系统底座已就绪」开始。:Hadoop 2.6.5 / Hive 1.2.1 / HBase 1.3.6 是 2016~2017 年的教学组合,稳定、坑位资料齐全。生产环境早已切到 Hadoop 3.x / Hiv
本文介绍多机AI Agent协同系统Hive的三项关键设计取舍:跨机留言采用内存+本地文件存储,避免Git版本冲突与延迟;搁置状态主动释放资源并保留历史,通过按钮而非新增列管理,保持看板简洁;任务计划以Tab形式聚合任务,实现项目级进度追踪。核心原则是“能用文件解决就不加数据库,能复用界面就不新增层级”,所有功能均在零依赖前提下实现高可用与易用性。附带一次/api/plans 404排查,揭示了配
本系统基于Hadoop生态,构建生成式AI SaaS用户行为与算力消耗分析平台,整合9800名用户数据,实现从数据采集、清洗到可视化全链路管理。通过K-Means聚类与关联分析,挖掘用户分群、行为模式及异常算力,结合Echarts大屏与多维看板,直观呈现用户结构、算力消耗、付费转化等核心指标,助力精细化运营与风控决策。技术栈涵盖Python、Django、Spark、MySQL、Vue等,支持定制
本系统基于Hadoop生态,构建了社交媒体情绪分析与可视化平台,实现多源数据采集、分布式清洗(Spark)、情绪极性与毒性分析(K-Means等算法),并通过Django+Vue+Echarts实现多维数据可视化。功能涵盖情绪分布、话题分析、用户行为、平台对比、风险洞察及大屏展示,支持实时舆情监控与管理,助力企业精准把握社媒动态。
2026年,Hive以低调务实的姿态深耕Web3社交与内容经济,通过1.28系列九次迭代实现底层质变:投票权重全额计算、密钥职责分离、节点故障隔离,链上区块填充率达99.7%,处理超1.82亿笔交易,零手续费模型经受住持续压力测试。移动节点部署推进中,未来可实现手机运行完整节点;HivePunkz NFT驱动的AIAgent生态已激活200余个“蜜蜂”,燃烧超10亿枚HIVE,打通从身份到激励的闭
本系统基于Hadoop生态,构建强化学习智能体轨迹数据可视化分析平台,集成Django、Spark、MySQL与Vue等技术,实现轨迹数据的采集、清洗、聚合与多维度分析。通过数据大屏与四大分析模块(智能体表现、动作策略、轨迹回顾、深度挖掘),直观对比Q-learning、DQN、PPO与随机游走的表现,揭示决策偏好、回报趋势与路径模式,助力算法优化与行为理解。
本项目基于大数据技术构建电商可视化分析平台,解决传统分析模式效率低、维度单一等问题。采用Hadoop+Spark实现海量数据的高效处理,结合K-Means、FP-Growth等算法进行用户画像与关联规则挖掘,通过Vue.js与ECharts实现多维度动态可视化展示。系统涵盖销售趋势、支付行为、促销效果、订单履约等核心模块,支持下钻联动与实时监控,助力企业实现数据驱动的精细化运营,提升决策效率与市场
很多同学的第一门大数据课用的是 Hadoop 2.6.5 的教材,一上手实机就发现处处对不上:端口变了、配置文件变了、连下载链接都挂了。本文以Hadoop 3.3.6(2026 年 USTC 镜像仍在维护的稳定版)为目标版本,在 Rocky Linux 9 上完成三节点完全分布式部署,并用官方 WordCount 例子做全链路验收。项目值部署主机操作系统Rocky Linux 9(每台 2 核 C
为什么要了解内核的调度策略呢?呵呵,因为它值得我们学习,不算是废话吧。内核调度程序很先进很强大,管理你的LINUX上跑的大量的乱七八糟的进程,同时还保持着对用户操作的高灵敏响应,如果可能,为什么不把这种思想放到自己的应用程序里呢?或者,有没有可能更好的实现自己的应用,使得操作系统能够以自己的意志来分配资源给自己的进程?带着这两个问题来看看KERNEL。首先回顾上我们开发应用程序,基本上...
本文围绕人工智能核心方向,系统梳理了涵盖深度学习、计算机视觉、自然语言处理、智能预测、智能系统开发、机器学习优化及安全伦理等七大领域的200个研究课题。内容聚焦模型优化、算法创新、多模态应用与实际场景落地,涵盖图像识别、语音处理、文本生成、风险预测、智能安防与隐私保护等前沿议题,体现人工智能技术在理论深化与工程实践中的深度融合与广泛应用。
摘要:本文介绍了Sqoop 1.4.7的安装配置过程。特别说明Sqoop 1.4.7原生不支持Hadoop 3.3.4,但通过文章配置可有效解决兼容性问题。
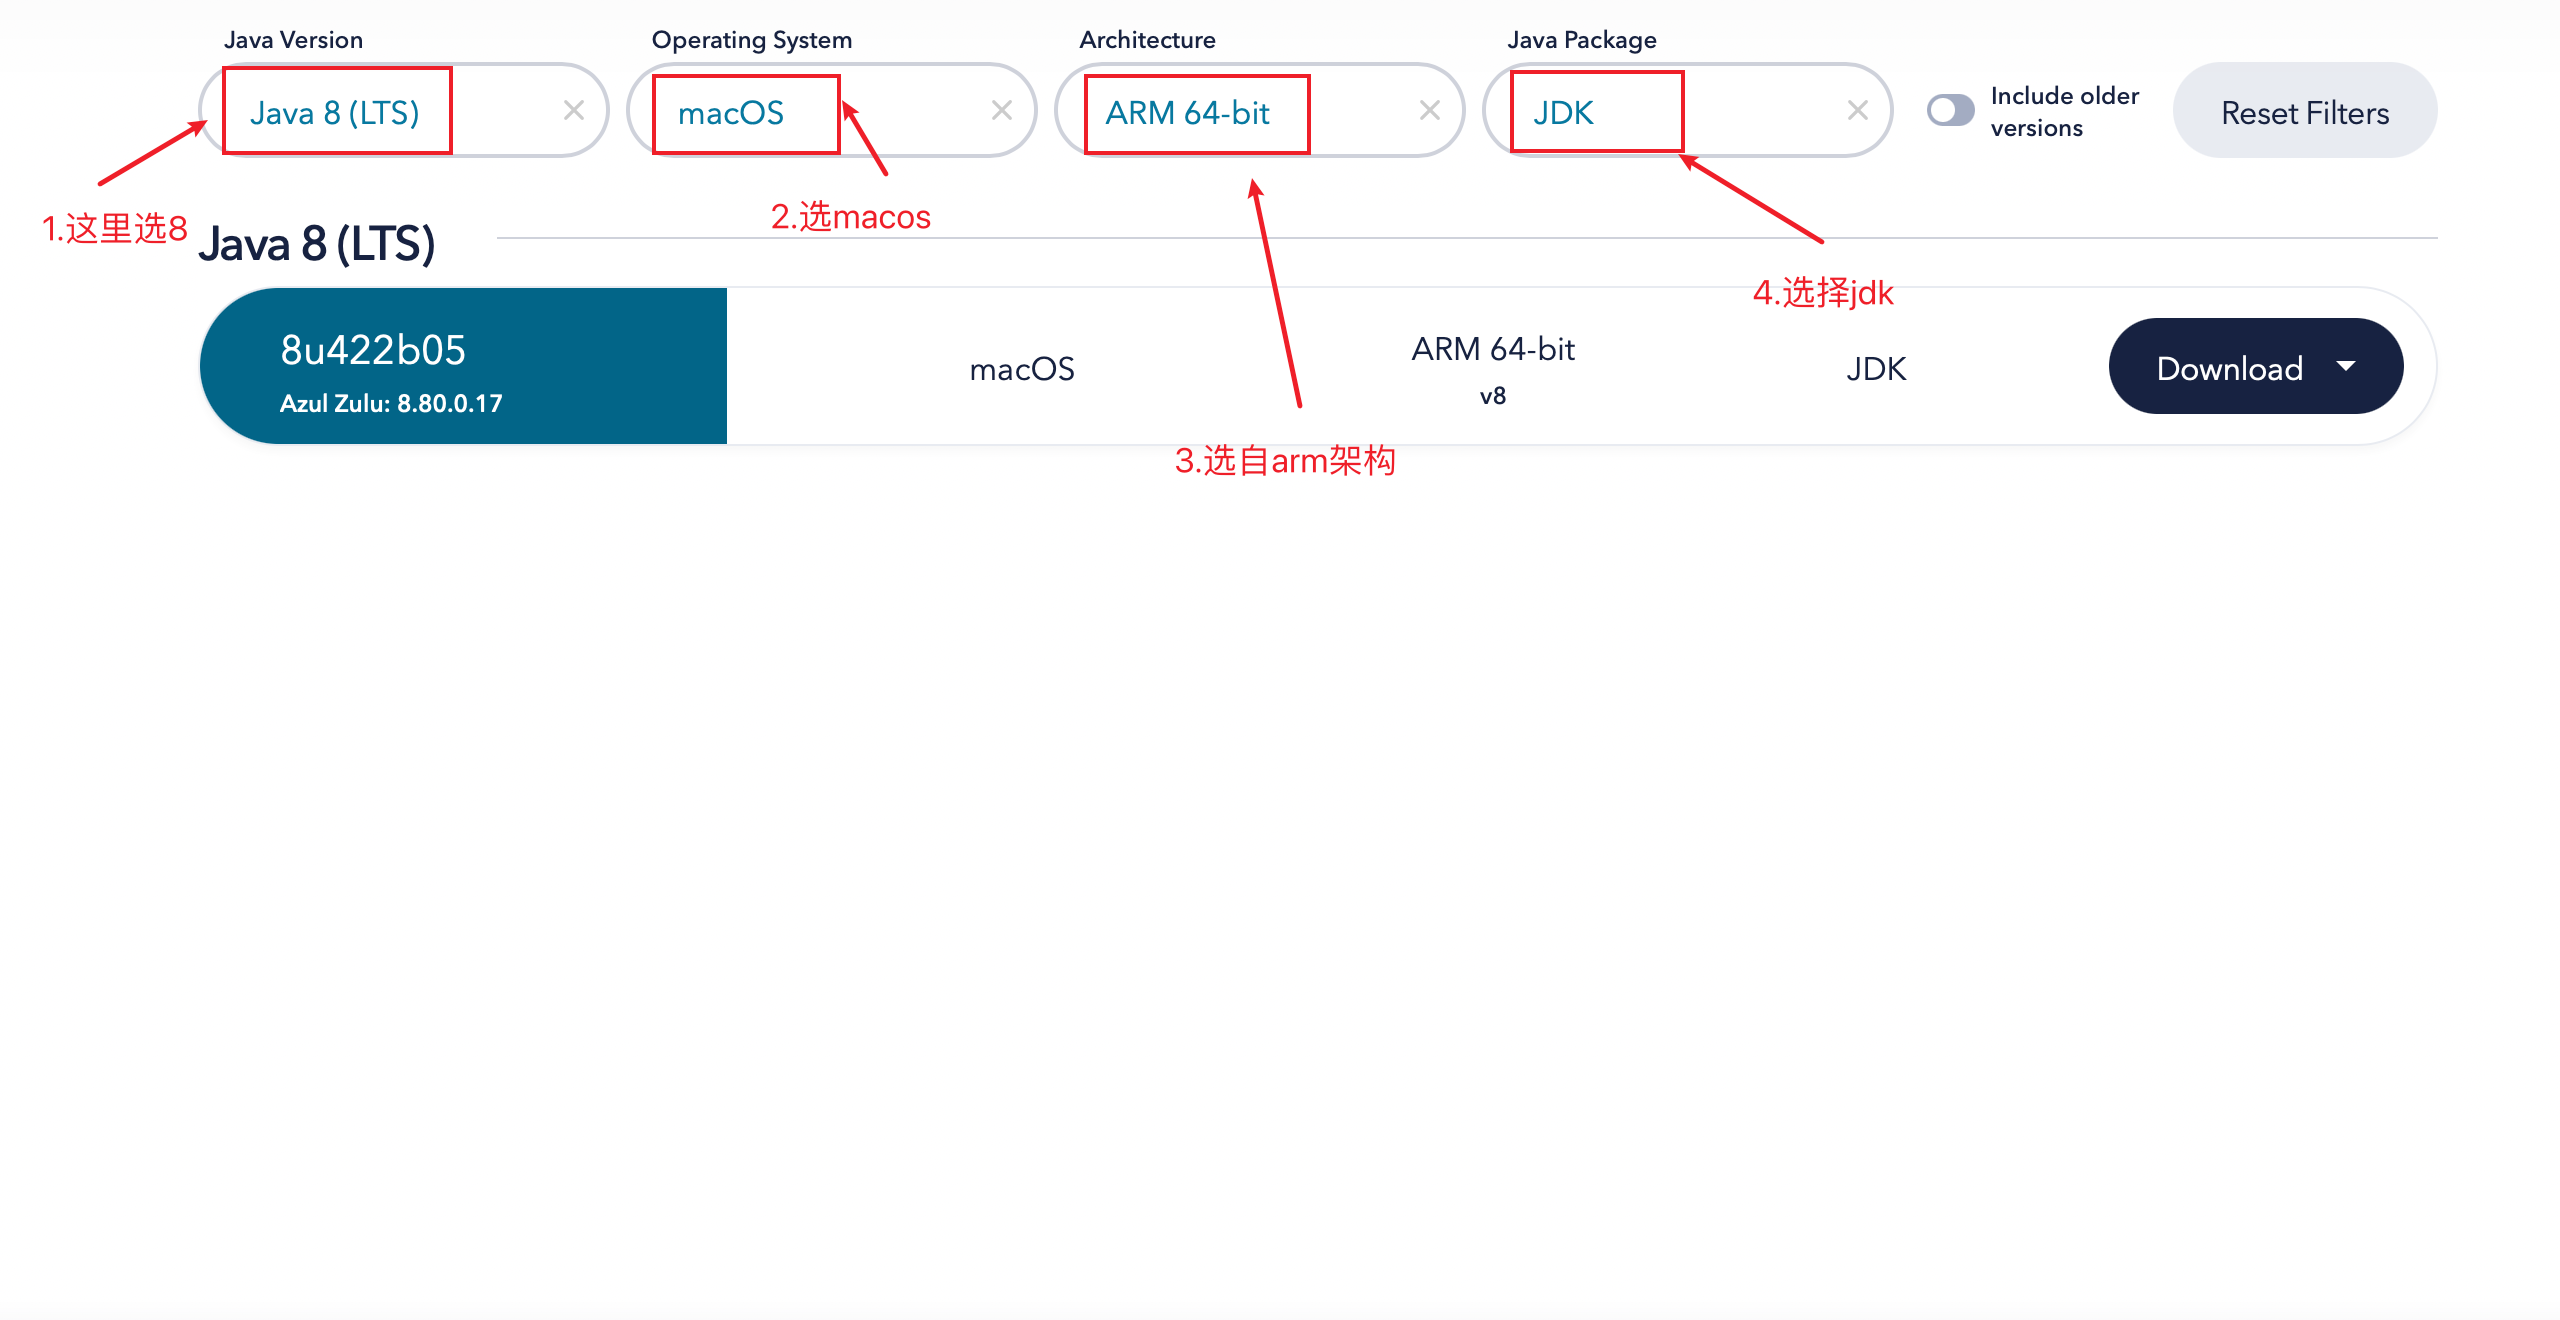
2.下载好后,进行解压,将解压后的文件夹命名为hadoop-3.4.0,并将解压的hadoop文件夹放到资源库(这里你可以根据自己需要放到指定路径下,如果放到其它地方有些配置你需要做对应修改)。注意如果是x86架构的苹果电脑,Architecture选择x86 64-bit或者 x86-32bit。在打印的日志中,没有报错,且有下面提示表示格式化成功!双击标红的部分,然后按照提示,一直默认安装即可
Ubuntu 20.04上安装和卸载MySQL 8.0 - 简书 (jianshu.com)Hive 3.x 安装部署详细教程,每一步清晰明了 - 掘金 (juejin.cn)Hive之MySQL安装与卸载_hive卸载-CSDN博客。启动Hive前要先启动hadoop和mysql。Hive卸载重装_卸载hive-CSDN博客。(listen代表正常启动/工作中)start-all.sh启动进程。
本科大数据专业学习Linux和大数据分析时,可能会用到的Linux组件安装教程网站
这种方法是不可取的,删除之后也无法正常使用,并且会导致原先的集群出现问题,甚至造成数据丢失,切不可盲目使用那种方法,这里推荐的方法是先保存。zookeeper元数据出现错误,进而导致一直卡在客户端连接当中。在网上搜了都说用去zookeeper。这里可能会由于之前修改过备用。集群中的数据表,然后重装。
最近在更换网络环境后,从前通过secureCRT连接本地虚拟机时很慢,有时甚至连接不上。最终发现是密钥交换的问题。key exchange栏中所有的选项都取消,只选中一个diffie-hellman即可。进入session options。
【代码】Hive安装教程。
java基础巩固-宇宙第一AiYWM:为了维持生计,大数据Hadoop之yarn【MapReduce的基本概念、Yarn的架构(中的角色、各角色的工作流程)MapTask与ReduceTask】~整起
SeaTunnel是一个非常好用的超高性能分布式数据集成平台,支持海量数据的实时同步。每天可以稳定高效地同步数百亿数据,已应用于近百家企业的生产中。
dolphinscheduler 海豚调度器 通过shell节点 调用.sql文件
第2关:Mysql导入数据至HDFS上Sqoop数据导入
本文介绍了Hadoop3.1.3安装以及单机/伪分布式配置。
自增id :1 2 3 4 5……uuid :UUID是Universally Unique Identifier的缩写,它是在一定的范围内(从特定的名字空间到全球)唯一的机器生成的标识符。通用唯一标识符的意思,可以以业务实际user id为主键 比如QQ号 手机号等雪花id :相比UUID无序生成的id而言,雪花算法是有序的(有时间参数),而且都是由数字组成。雪花id最大为64位,符合java中
Hadoop安装教程
HBASE比赛用服务器启动(1)在主节点执行命令【cd /usr/local/hadoop/sbin】进入目录,执行命令【./start-dfs.sh】、【./start-yarn.sh】、【./mr-jobhistory-daemon.sh start historyserver】启动集群。(2) 在主节点执行命令【ntp_update】启动时间同步服务(不用,开机自启)(3) 执行命令【ser
hadoop
——hadoop
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 地瓜机器人开发者社区



 北京朝阳AI社区

 openEuler 社区


 AtomGit AI 社区


 快递鸟社区


 乐奇 Rokid 开放社区