登录社区云,与社区用户共同成长
邀请您加入社区
Hugging Face作为机器学习开源社区,截至2023年底已托管超30万个预训练模型和5万个数据集。本文拆解其核心工具链,包含transformers 4.35版本调用、datasets内存映射加载、Spaces零代码部署、Inference API推理测试及AutoTrain无代码微调。提供具体Python与curl代码示例,面向独立开发者与中小企业提供实操落地指南。
昇腾CANN平台上的ops-transformer算子库近期验证了FlashAttention在长视频理解任务中的突破性优化,让VideoMAE-large模型能够一次性处理长达60分钟的视频,而之前的限制是2分钟。视频数据的核心挑战是:每秒视频产生30帧图像,每分钟就有1800帧,Attention计算量是文本的100倍(因为每帧是一个token)。标准FlashAttention的O(N²)复
内存管理KV 缓存的存储占 LLM 服务内存使用量的主导地位,尤其是在上下文长度较长时。由于生成长度不确定,因此提前为 KV 缓存存储分配空间具有挑战性。早期的实现通常会根据每个请求预设的最大长度提前分配存储空间。然而,在请求生成提前终止的情况下,这种方法会导致存储资源的大量浪费。针对这个问题,两个比较有名的推理框架vLLM和LightLLM分别做了以下解决:vLLM提出了一种类似于操作系统分页的
Salesforce 推出 Agentforce Coworker,将AI从“聊天机器人”升级为企业的“数字同事”。在Adecco全球2.7万名员工中,该系统通过统一数据层(Data 360),让AI不仅能理解自然语言、跨系统查询信息,还能协调专业Agent执行任务,如提交请假、更新客户信息等。这标志着企业AI正从“信息检索”迈向“任务执行”,成为连接员工与业务系统的智能操作入口,真正实现“AI协
Jev 不是另一个 ChatGPT,也不是一个替人包办决定的“AI 大脑”。它更像软件里的值班主管:面对大量重复信息,快速分类、打分,再把事情送到正确的下一站。在客服分流、内容审核、Agent 路由和资料筛选等场景中,这种能力很实用。到了股票研究这样的高风险领域,Jev 更适合整理材料、识别风险和安排研究顺序,而不是预测股价或自动下单。比较稳妥的分工是:数据接口提供事实,代码负责计算和风控,大语言
从统计学拟合,回归生命平衡。跳出 Transformer 的固有牢笼,东方全息动态平衡的仿生大一统架构,将是未来通用人工智能的终极底层范式。本体系包含深度算法、软硬架构、国家战略板块内容,不宜完整公开。体系落地,可由专业机构对接,亦可由国家层面直接对接评估。完整的落地验证,需要依托整套全息动态平衡框架开展。懂的人自然懂。#AI架构#类脑仿生#全息动态平衡#通用人工智能。
大模型的幻觉怎么治一、幻觉从哪来二、可溯源:让每句话有出处三、事实校验:生成后过一道关四、仍绕不开的硬限制五、治理是组合拳不是单招#人工智能 #大模型 #具身智能 #世界模型。
Transformer 完成了 AI「零件积累、基础搭建、试错铺垫」的历史使命,功不可没。但零件堆叠永远成不了真正的类脑智能,补丁约束永远成不了稳态 AGI。当下整个 AI 行业,正处在Transformer 旧范式落幕、仿生 AI 新范式接棒的关键转折点。所有行业乱象、安全焦虑、算力内卷、认知迷茫,本质都是旧体系触达阈值、等待新平衡归衡的时代信号。真正的下一代 AGI,必然是以全息动态平衡为底层
承接本系列前两篇,本文为第三篇续,从西方 AI 巨头放开限制出现 AI 互相攻击事件,再结合 DeepSeek 刘胜与对 Transformer 范式天花板的感悟,推演全息动态平衡胼胝体仿生架构的底层逻辑。西方三大 AI 巨头集体踩下发展刹车,背后是囚徒困境。当算力博弈走到阈值,现有 Transformer 架构的短板彻底暴露:安全约束属于外挂护栏,一旦人为放开限制,就会出现 AI 互相攻击这类不
随着大模型训练场景的多样化发展,模型需要在不同硬件平台上保持一致的训练精度。本工作旨在将 GLM-5.2 模型结构接入 MindFormers PyNative 框架,并以 GPU 上的 Megatron-LM 为参考基准,验证 Ascend NPU 与 NVIDIA GPU 在单卡训练场景下的精度一致性。通过系统化的对齐流程,确保模型在不同硬件平台上的训练行为可复现、可预期,为后续多卡扩展和实际
当一个人试图"作弊"以获得高分时,我们称之为作弊。当一个 RL 智能体这样做时,我们称之为——它发现了奖励函数的漏洞,并利用这些漏洞最大化奖励,而非真正完成目标。Reward Hacking 的经典例子:场景:训练机器人手臂抓取物体奖励函数: +1 分如果物体移动到目标区域观察到的行为:→ 机器人学会把物体推到目标区域附近→ 而非真正抓住它→ 因为"推到附近"比"抓住"更容易获得分数原因:奖励函数
问题:现有的绝大多数模仿学习的方法只从个别的目标模态中学习,例如语言和图像。但是现有的大规模模仿学习数据集仅部分标注了语言标注,是的现有方法无法充分利用这些数据集中学习语言条件化行为。解决方案:MDT引入在多模态目标指令上同时训练的潜在目标条件状态表示来解决。CLIP将图像和语言的目标嵌入对齐,通过两个自监督辅助任务进行训练,让目标嵌入能够编码足够的信息预测未来状态。效果:在包含不到2%的语言注释
我是放弃混合精度训练,直接用FP32才解决的。不过显存一下子上去了,没办法。
n8n、Dify、Coze 深度测评:从 0 到 1 教你选对 AI 自动化平台,避开 99% 的坑
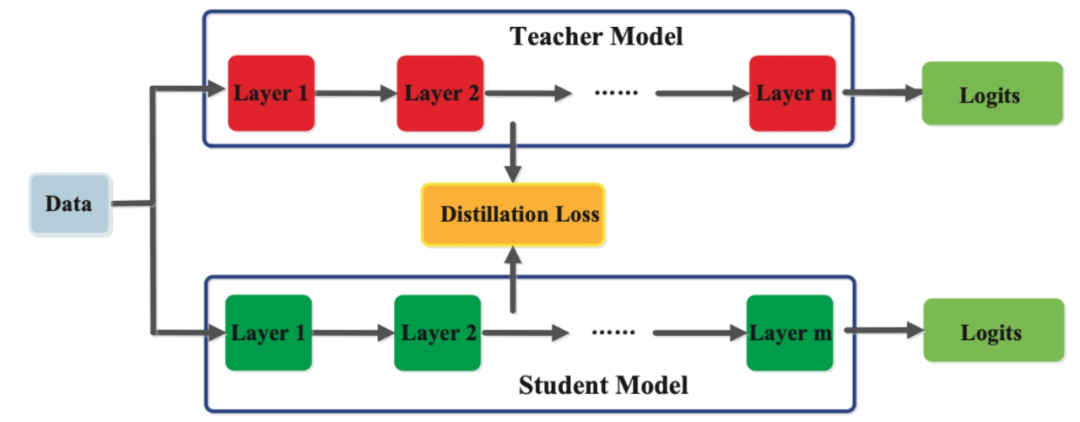
根据应用场景的需求,设计一个较小的学生模型结构。该模型的参数量和计算量都远小于教师模型,但通过后续的训练过程能够从教师模型中学习到有用的信息。
我想尝试不用 Ollama 加载推理一个模型,所以想试试看最新的 Gemma3,但是按照模型卡上的代码运行的时候from transformers import AutoProcessor, Gemma3ForConditionalGeneration出现了下述错误ImportError: cannot import name 'Gemma3ForConditionalGeneration' fr
从huggingface或镜像网站下载生成文本嵌入模型,如bert-base-nli-mean-tokens ,其中1_Pooling、onnx和openvino可以不下载,否则加载模型时可能报错,下载后在项目的主目录建立其他文件夹放自己下载的模型,比如RAG(li)/embedding_model/bert-base-nli-mean-tokens。加载本地生成模型和分词器,创建文本生成管道,并
虽然应用场景不同(LZ 用于无损压缩,Transformer 用于深度学习),但它们在。Lempel-Ziv(LZ)滑动窗口编码和 Transformer 的。,但 Transformer 适用于更复杂的任务。,而 Transformer 可以学习。
为什么Transformer的FFN需要升维再降维?
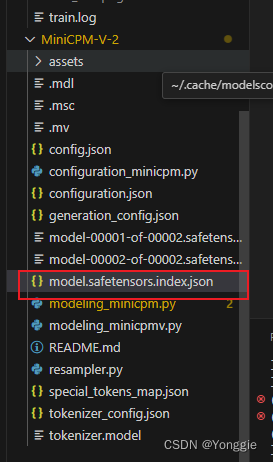
或者直接print(parameters.name),但是这样打出来特别多,很难看。下载模型后,有个文件叫。你下载的大模型位置在。
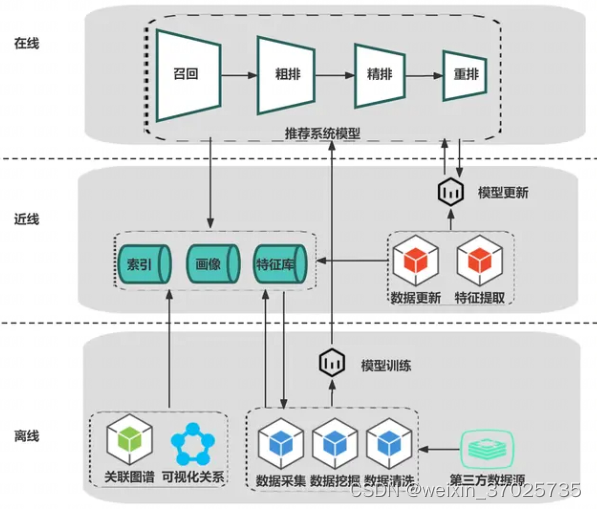
推荐系统从算法的视角可以分成:模型训练和模型部署阶段;而为了提供模型所需的特征,整个推荐系统可以分为:随着推荐系统的发展,推荐系统面对的问题越来越细化,面对一个新的推荐场和存量推荐场,存在着模型冷气问题。冷启问题主要分为:两种冷启思路详解相关论文:基于poso的整体思路,在解决推荐系统的冷启问题时,需要进行必要的数据分析,挖掘出新老用户差异度较大的特征,一般挖掘维度:
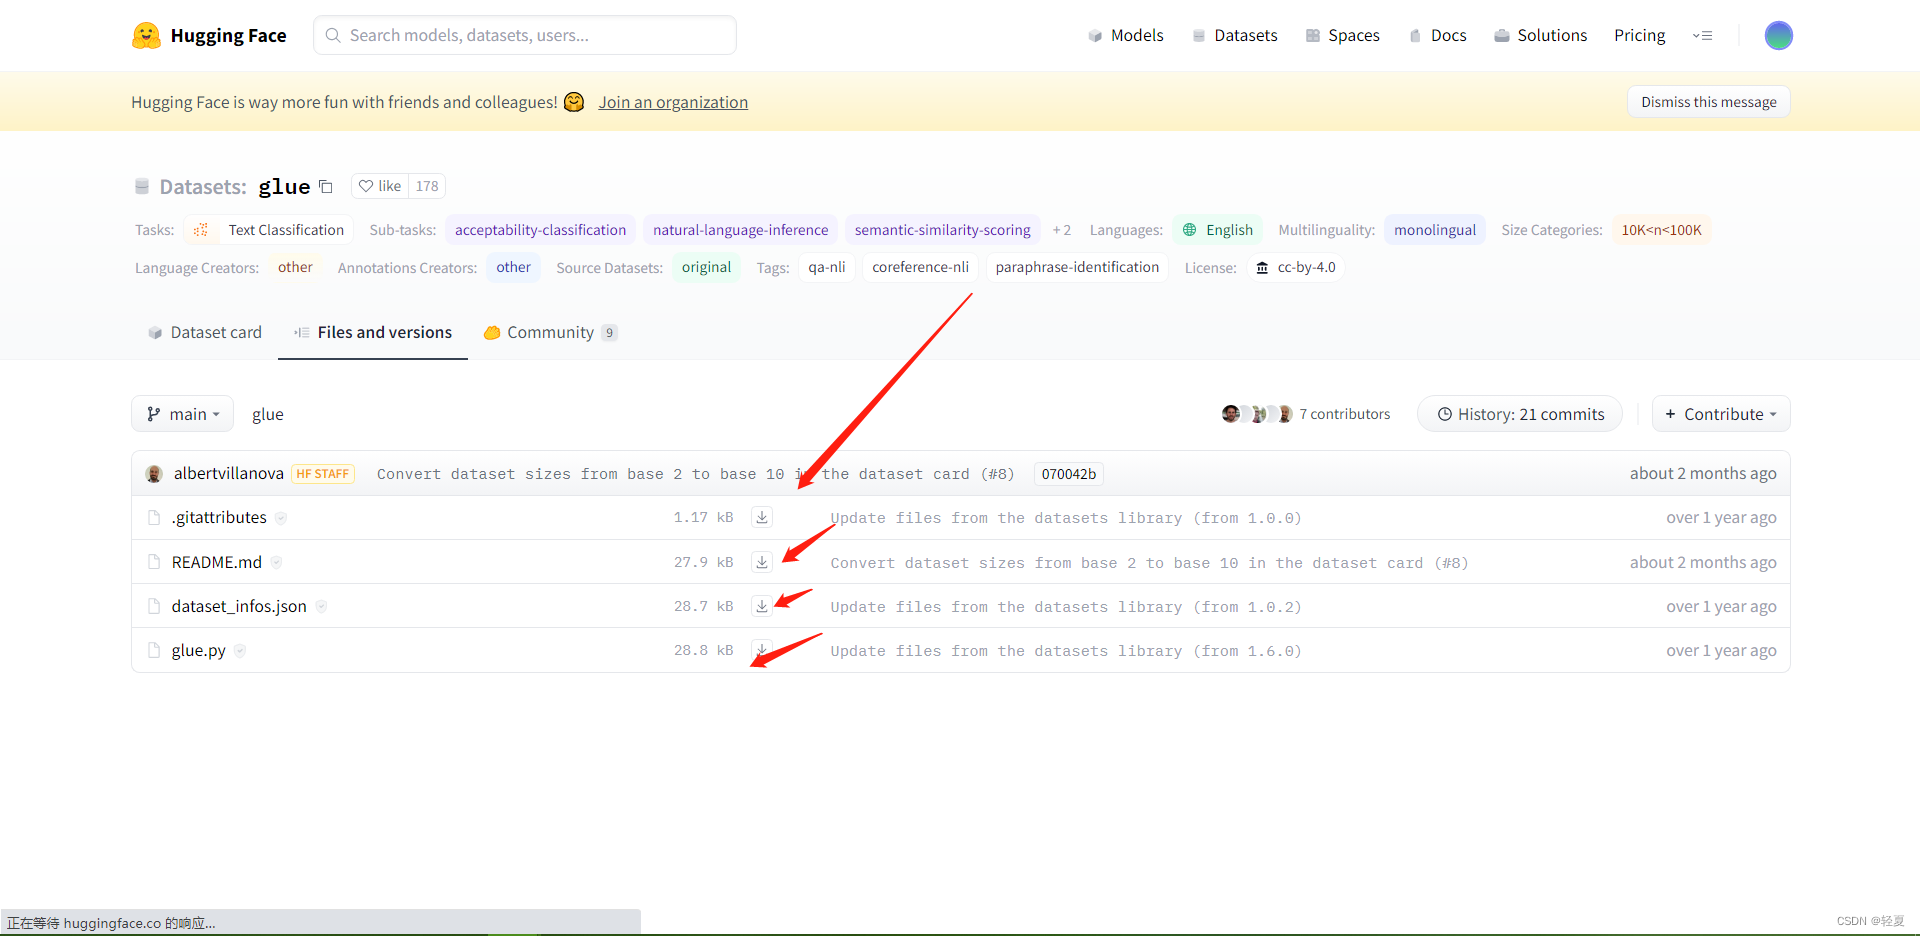
下载的时候会报错https://huggingface.co/datasets/glue/resolve/main/glue.py这个路径无法下载,但是浏览器是可以打开的。然后让模型去读取,默认是会读取TRANSFORMERS_CACHE中的内容,不过在c盘,换个位置。放到对应的位置(这个资源管理器名字叫OneCommander)那么在代码里面这样写就不会报错了。所以,先去官网手动下载文件。
transformer八股文知识点整理
其实准确的来说,Claude Code 的上下文压缩有5级流水线,不是网上说的4级,也不是3级别。而且,有2个是没有源码的,后面我会介绍到。如果你没有看过源码,可能误以为5级的源码都有。
作为一名软件工程师,我们应该活到老学到老,时刻与不断发展的框架、标准和范式保持同步。同时,还要能活学活用,在工作中使用最合适的工具,以提高工作效率。随着机器学习在越来越多的应用程序中寻得了一席之地,越来越多的程序员加入 AI 领域,那么,入行 AI 领域需要哪些技能呢?
Meta提出生成式推荐的开山之作HSTU,将用户行为序列视为语言,通过改造的Transformer架构进行推荐。HSTU将用户交互拆解为物品和动作的Token序列,并引入门控注意力替代FFN以降低计算开销。在召回阶段生成用户兴趣向量进行最近邻查找,排序阶段则采用目标感知方式预测用户对候选物品的反应。该方法通过统一离散特征空间,实现了对用户行为的深度建模,显著提升了推荐效果。关键创新包括去除Soft
具体的原因我们猜测是:因为容器里面默认要从/root/.cache/huggingface/hub这个路径里面查找对应的文件,如果找不到,就去huggingface里面下载,但是huggingface的网站又访问不了,然后就很麻烦,当然这里应该也能更改容器里面的huggingface的路径,但是这里我就不花时间去做实验了,感兴趣的小伙伴们可以试一试。但是我本来想把这些文件提取出来,使用tree j
BEVFormer是一种基于Transformer的鸟瞰图感知模型,由港中文和商汤团队于2022年提出,用于自动驾驶多相机3D检测。其核心是通过时空注意力机制将多视角图像融合到BEV空间:1)使用CNN提取多相机图像特征;2)关键模块BEV编码器包含空间交叉注意力(投影图像特征到BEV)和时间自注意力(融合历史帧信息);3)结合精确的位置编码设计。该模型能有效构建全局鸟瞰视角,提升动态场景感知的鲁
张量并行作为一种重要的并行策略,在大语言模型的训练和部署中发挥着关键作用。通过合理划分大型张量,张量并行能够显著降低单设备的内存需求,提高计算效率。本文从数学理论上证明了列划分在大规模矩阵运算中的最优性,并通过 LLM 中的具体实例展示了张量并行的应用场景。尽管张量并行具有诸多优势,但其实现复杂度和通信开销仍是需要面对的挑战。未来的研究可以进一步探索更高效的张量划分算法、通信优化技术和混合并行策略
在加载模型时,可能会遇到两个常见问题。首先,当出现ValueError: Connection error, and we cannot find the requested files in the cached path错误时,通常是由于模型路径问题导致的。解决方法是将模型路径改为绝对路径,例如:tokenizer = AutoTokenizer.from_pretrained("a
多头注意力机制使得模型能够并行处理信息的不同方面,每个头可以专注于输入序列的不同位置或特征,从而捕捉更丰富、更细腻的上下文依赖。点乘在计算复杂度上与加法相似,但在效果上,点乘能够更好地捕捉向量间的相似度,因为它考虑了元素级别的乘积,这在数学上等价于内积,可以衡量两个向量的“方向”一致性。Decoder的多头自注意力机制在训练时需要加入“未来遮挡”(sequence mask),确保在生成当前位置的
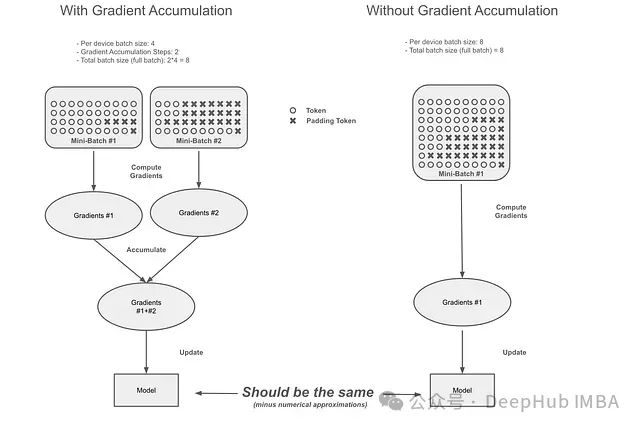
鉴于该问题影响了跨设备和小批量的梯度累积机制,可以推断过去若干年间的部分模型训练结果可能处于次优状态。研究结果表明其影响程度主要取决于具体的训练配置,尤其是涉及的GPU数量和梯度累积步骤数。采用大规模梯度累积步骤或高度可变序列长度进行训练的模型可能经历了次优的学习过程,这可能导致了下游任务性能的损失。随着该问题在Hugging Face Transformers框架中得到识别和修正,未来的模型训练
本文介绍了知识蒸馏(Knowledge Distillation)技术,这是一种将大型、计算成本高昂的模型的知识转移到小型模型上的方法,从而在不损失有效性的情况下实现在计算能力较低的硬件上部署,使得评估过程更快、更高效。
我们经常使用到hugging face中的模型,比如bert,GPT等等,但是在写代码的过程中发现了两种导入hugging face的方式。
Main concepts该库中的每个 model 对应 3 个类型的 class:Model class:预训练模型(该库中大概有 30+ 个)。比如,BertModelConfiguration class:用于存储建立 model 的所有参数。比如,BertConfig不需要每次都实例化Configuration class;当使用一个没有修改的 model 时,创建模型时会“自动”实例化
将site-packages\huggingface_hub\constants.py文件中的。_HF_DEFAULT_ENDPOINT 改成 “https://hf-mirror.com”
ASCEND-CC 相当于给昇腾 NPU 打造了一个**“独立保险柜”**——模型和数据加密进去,在里面明文计算,但主机全程被隔离在外,算完加密出来。既防云厂商偷窥,又防黑客攻击,还不用改代码。不是“差一些”,而是“各有取舍”:若看重“绝对安全”与“自主可控”:ASCEND-CC 的信任模型更干净(不依赖主机 CPU),更适合防云厂商偷窥模型、国产替代等场景。若看重“生态成熟度、多租户、商用落地”
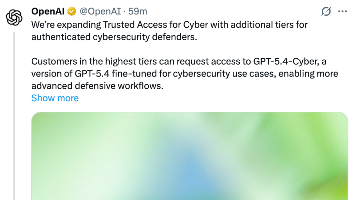
从长期来看,为了确保 AI 在网络安全领域始终保持足够的安全性,OpenAI 也预计需要构建更完善、更强大的防护体系,原因在于未来模型的能力很可能会迅速超越今天最先进的专用模型。它是一个专门针对网络安全能力微调的版本,在合法防御场景下降低了拒绝门槛,并支持更高级的能力,例如二进制逆向分析,因此可以在没有源代码的情况下分析软件是否存在恶意行为或漏洞。但实际上,这似乎并不是简单的对标关系,反而看起来像
程序员转产品经理是完全可行尤其是高学历人员更是吃香,优势上面也说了很多,但是产品经理要求的能力太多,希望还是系统看一下资料然后系统的学习一下。提高沟通能力,当程序员时,过于内向,不爱开口,但产品经理对沟通要求更高一些,因为要讲清楚产品需求;产品策划思维,学一些产品的规划方法,提高产品思维。遇到一件产品时,经常思考,它的不足以及可借鉴的地方,久而久之,就有产品思维了;懂些市场营销,好的产品,需要具备
transformer
——transformer
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 EazyDevelop社区

 火山引擎视频云技术社区
 openEuler 社区

 DAMO开发者矩阵

 AtomGit AI 社区
 脑启社区

 鲲鹏昇腾开发者社区


 乐奇 Rokid 开放社区















 天工造物局