登录社区云,与社区用户共同成长
邀请您加入社区
本篇承接上篇 NLP 数据预处理内容,基于 PyTorch 实现双向多层 LSTM 的 TextRNN 微博情感四分类任务。完整拆解模型网络结构,讲解 Embedding、双向 LSTM、全连接层实现细节;同时剖析训练、验证、测试整套逻辑,包含交叉熵损失、Adam 优化器、梯度反向传播、早停策略、模型保存,使用 sklearn 完成准确率、精确率、召回率、F1 指标评估。结合主程序讲解设备适配、随
本文是微博四分类情感分析实战系列的第一篇——数据预处理。基于 TextRNN(双向LSTM) 模型,从零讲解 NLP 数据预处理全流程。内容涵盖:字符级词表构建(频次统计、低频过滤、<UNK>/<PAD> 特殊标记、pickle 持久化)、数据集加载与预处理(字符转 ID、Padding 截断、8:1:1 划分训练/验证/测试集),以及自定义 DatasetIterater 批量迭代器。词表最终大
2026年,企业需融合SEO与GEO策略应对AI信息入口变革。随着ChatGPT等AI成为新搜索入口,品牌不仅需优化搜索引擎排名,更要确保被AI推荐。关键在于构建稳定可信的品牌信息体系:强化官网与官方内容,甄别真实第三方信源(如使用GEO信源网核验渠道),持续测试真实用户问题下AI的回答表现,聚焦高价值问题而非盲目发稿。未来竞争核心是“问题洞察+信源建设+效果验证”,推动GEO从概念走向数据驱动的
从huggingface或镜像网站下载生成文本嵌入模型,如bert-base-nli-mean-tokens ,其中1_Pooling、onnx和openvino可以不下载,否则加载模型时可能报错,下载后在项目的主目录建立其他文件夹放自己下载的模型,比如RAG(li)/embedding_model/bert-base-nli-mean-tokens。加载本地生成模型和分词器,创建文本生成管道,并
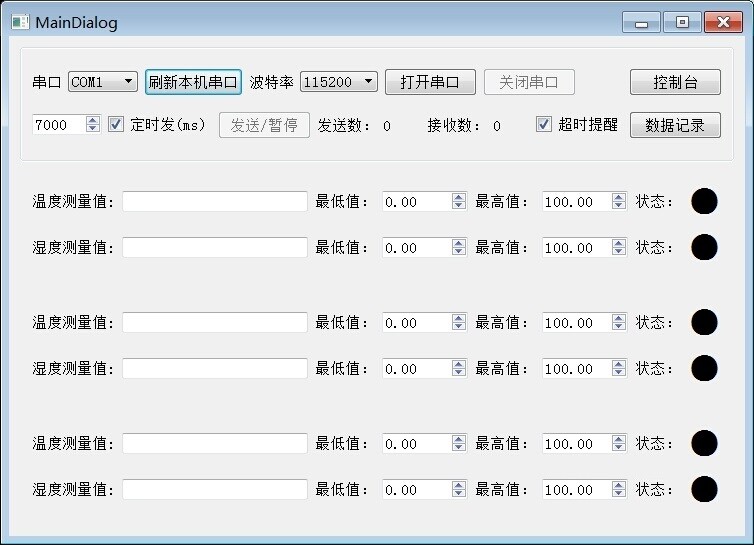
Qt温度湿度传感器采样上位机源代码C++数据记录功能Windows上位机在开发Windows上位机应用程序时,利用Qt框架来实现温度湿度传感器数据的采样及记录是一个相当不错的选择。今天就来和大家分享一下如何在Qt中实现这一功能。
neo4j是由Java实现的开源NoSQL图数据库。自从2003年开始研发,到2007年发布第一版。neo4j现如今已经被各行各业的数十万家公司和组织采用。neo4j实现了专业数据库级别的图数据模型的存储。与普通的图处理或内存级数据库不同,neo4j提供了完整的数据库特性,包括ACID事物的支持,集群支持,备份与故障转移等。这使其适合于企业级生产环境下的各种应用。neo4j的版本说明:企业版:需要
基于LangChain设计一个带历史对话的聊天机器人
大厂双非同学NLP实习面试经历,可能会对某些即将面试的同学有所帮助,所以决定把自己亲身经历的面试内容做个分享,以下所有内容均是面试真实问到的内容。
lstm预测单词Yo reader! I am Manik. What’s up?. 哟读者! 我是曼尼克 。 这是怎么回事?。Hope you’re doing great and working hard for your goals. If not, it’s never late. Start now, at this very moment. 希望您做得很好,为实现目标而努力。 如果..
电子书在文末。1、bert的架构是什么 目标是什么 输入包括了什么 三个embedding输入是怎么综合的?Bert的结构主要是Transformer的encoder部分,其中Bert_base有12层,输出维度为768,参数量为110M,Bert_large有24层,输出维度为1024,参数总量为340M。Bert的目标是利用大规模无标注语料训练,获得文本包含丰富语义信息的表征。Bert的输入:
################################################ Demo ######################################/* * To change this license header, choose License Headers in Project Properties. * To change t
在科技变革的浪潮中,大模型技术已成为推动各行业创新发展的核心驱动力。对于程序员而言,这既是一场挑战,更是一次职业转型的绝佳机遇。凭借扎实的编程基础和逻辑思维能力,程序员在大模型领域拥有众多极具潜力的转行方向。下面,我们将从推荐理由与技能要求两方面,深入探讨这些方向。
PCA降维
在多智能体系统里,监督器有着重要作用。就如同一个团队需要管理者来协调成员工作一样,多智能体监督器负责管理和协调不同智能体之间的任务分配与协作。上一个示例根据初始研究员智能体的输出自动路由消息,而我们也能够选择使用大语言模型(LLM)来协调不同的智能体。下面我们就来看看如何创建一个智能体组,并使用一个智能体监督器来帮助分配任务。
在本期blog中,我们将逐步完成下面的任务:**1. 使用lora微调`gemma-2b-it`模型,数据集为`Alpaca_cleaned_data`2. 在`truthfulQA`数据集上评估模型效果**
这项工作提出了自合成回放(SSR),这是一个用于缓解大型语言模型中灾难性遗忘的持续学习框架,能够在回放过程中不依赖真实数据而有效地保留知识。
【配套新书教材】《自然语言处理原理与实战》(人工智能科学与技术丛书)【陈敬雷编著】【清华大学出版社】新书特色:本书从自然语言处理基础开始,逐步深入各种NLP热点前沿技术,使用了Java和Python两门语言精心编排了大量代码实例,契合公司实际工作场景技能,侧重实战。
低维的 Manifold【是可以局部欧几里得空间化的一个拓扑空间,是欧几里得空间中的曲线、曲面等概念的推广】高维空间中随便 Sample 一个点都不是图片只有非常小的范围,Sample 出来会是图片。:Discriminator 跟 Generator,它们互动的过程是自动的。每一个图片都去配一个从 Gaussian Distribution Sample 出来的 Vector,Train 一个
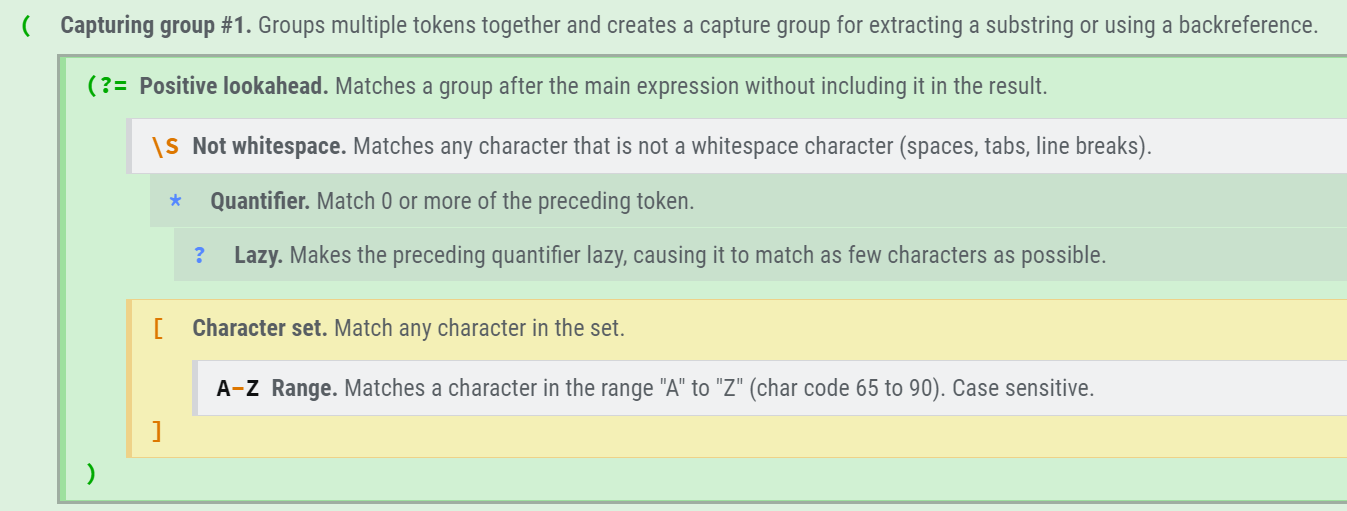
以下4道题目为正则表达式相关练习,包括简单的字符匹配、提取文本信息并整合、提取文本信息并替换,以及对常用正则表达式的详细解释。
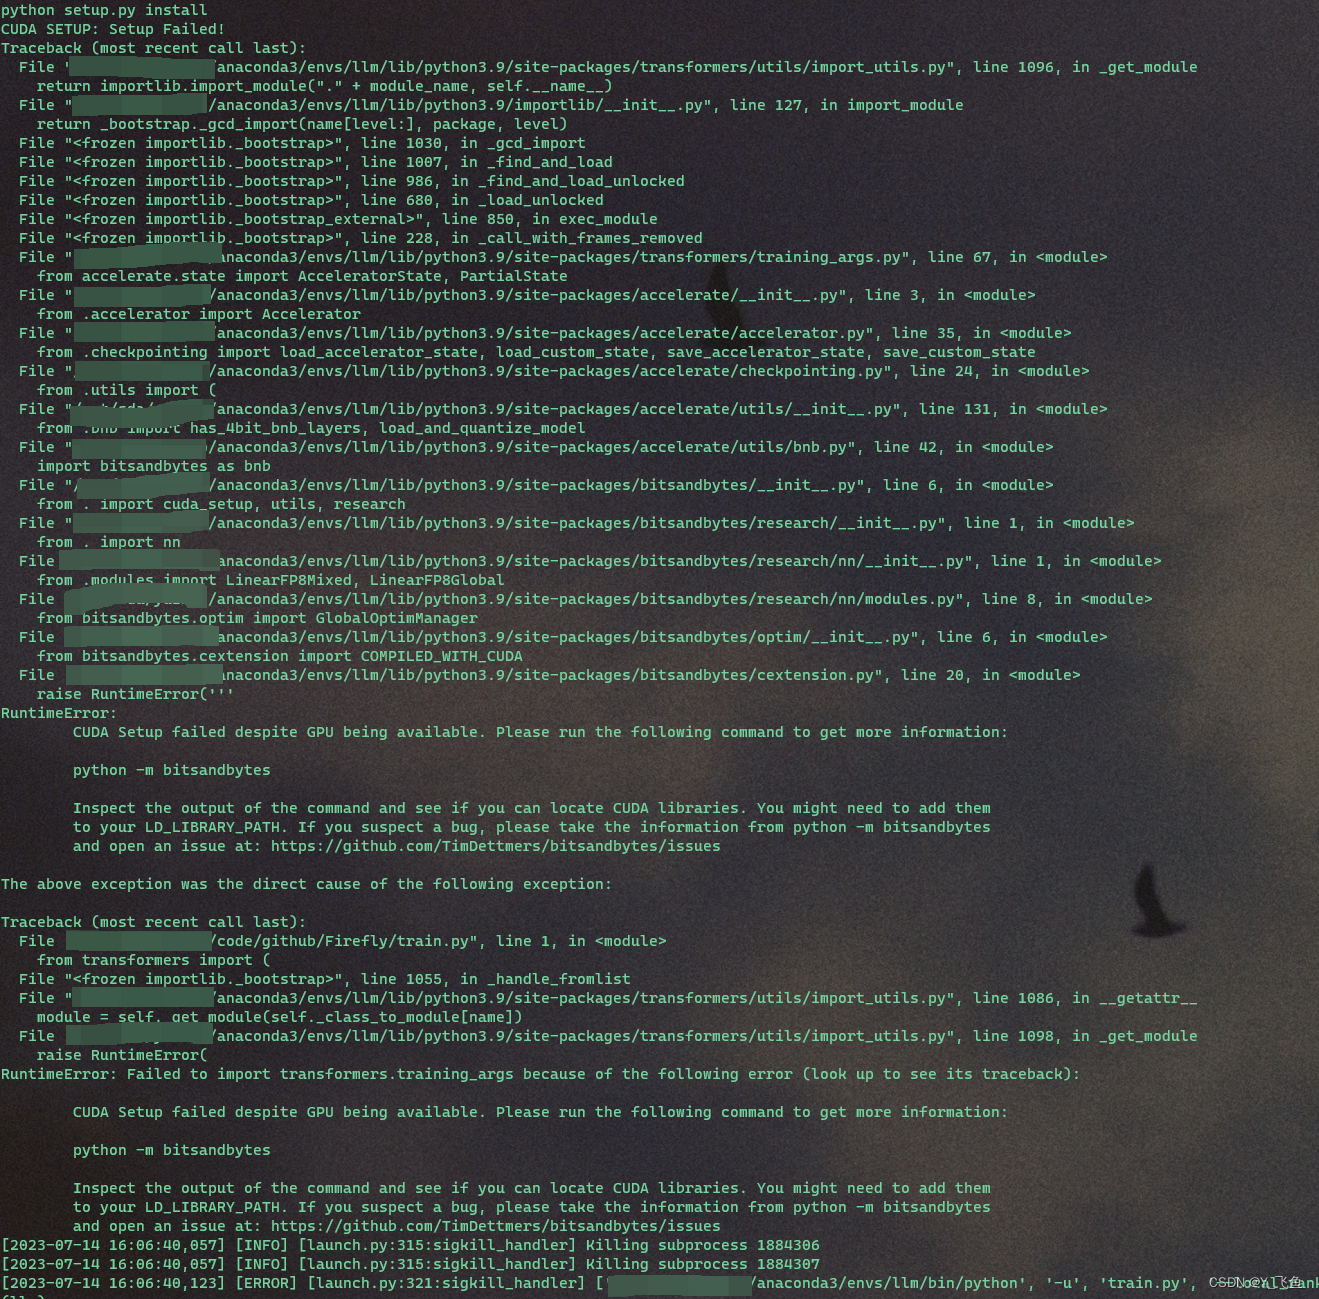
【代码】deepspeed 或 bitsandbytes 遇到CUDA Setup failed despite GPU being available.
升级elasticsearch-analysis-hanlp,支持elasticsearch8.X和hanlp最新分词
一、什么是注意力机制我们对输入的多个值,这些值本身带有的属性称之为(理解的时候可参考数据库中的),进行查询(即有自主性的选择,例如倾向于选择更大的值),然后对中的值进行选择得到了最符合的一个值。通俗理解来说就是通过和之间的交互形成了注意力汇聚,注意力对进行选择得到一个输出。注意上文我们提出的注意力汇聚这个词,在某些情况下,我们直接用注意力汇聚这个名词代表q,k之间地交互。二、注意力汇聚1.平均注意
ImportError:cannot import name ‘save_state_warning’ from torch.optim.lr_scheduler’.我看到很多人方法是把torch版本改为1.7.1版本,或者是提高transformers。这里我提供一下下载1.7.1的命令:pip install torch==1.7.1+cu101 torchvision==0.8.2+cu10
通用句子编码器是google在2018年提出的将句子编码成嵌入向量的模型,这些嵌入向量专门针对将学习转移到其他NLP任务。文章中指出,对于许多NLP任务,可用的训练数据有限。这对数据饥渴的深度学习方法提出了挑战。由于注释有监督的训练数据的成本很高,对于大多数研究或行业NLP任务,通常无法使用非常大的训练集。许多模型通过使用隐式执行有限的迁移学习来解决如word2vec,Glove等,都有不错的效果
1. Transformertransformer有很多种形式,Transformer,Universal Transformer,Transformer XL,GPT,BERT,ERNIE,XLNet,MT-DNN。一下子全讲了那我估计人没了,决定还是学网络,用到一个就填一个坑,今天先说一下Transformer。Transformer是一种新的、基于attention机制来实现的特征提取器,可
Topic-Aware Neural Keyphrase Generation for Social Media Language 【论文复现赛】本文由腾讯AILab和香港中文大学联合发表,文章关注的问题为自然语言理解的中的关键短语(keyphrase)生成问题,另外所研究的场景是更为常见与广泛的社交媒体(social media)。1. 背景随着网络技术和硬件设备的发展,人与人之间的沟通逐渐的变
SKIP-GRAM输入层:中心词的one hot表示,looktable查表【Vd 表,每个词作为中心词的表示】得到中心词的embedding 表示[1300]隐藏层: [W 大小为30010000],Vd 大小,是每个词作为背景词的表示输出层:经过softmax,得到每个词的概率。训练数据: ( input word, output word ) 单词对input word和output wor
This paper propose an ACNN model and an ACNN-AMT model. ACNN model can capturing user's individuality on microblogs(Sina,Twtter) based on attention-mechanism. ACNN-AMT alleviating the data insufficien
前言:在使用arduino uno时要考虑供电,总结一下几种供电方法方法一:使用USB端口为Arduino供电USB端口通常在烧录时进行供电以及实验时使用,也可以用充电宝配合使用,使用这种方法供电时,电源电压需要是稳定的+5V的直流电压即可。需要注意的是充电宝电路有漏电关断设计,如果没有达到最小负载,则会被判定为漏电流,将触发关断,遇到问题可以考虑一下。代码:#include<Servo.h
对smiles化学表达式进行分词中文语料数据为一批短文本或者长文本,比如:句子,文章摘要,段落或者整篇文章组成的一个集合。一般句子、段落之间的字、词语是连续的,有一定含义。而进行文本挖掘分析时,我们希望文本处理的最小单位粒度是词或者词语,所以这个时候就需要分词来将文本全部进行分词。同样,对化学文本进行处理时我们希望处理的最小单位粒度是元素或者键def smi_tokenizer(smi):"""T
输入为一段文本,输出为字符串,多个身份证号中间空格符隔开def person_id_extract(text):person_id = re.findall(r"([1-9]\d{5}(18|19|([23]\d))\d{2}((0[1-9])|(10|11|12))(([0-2][1-9])|10|20|30|31)\d{3}[0-9Xx])", text)per_id = ""if perso
ios swiftuiOne of the greatest powers of Apple’s iOS platform is the diversity of built-in frameworks. There are many gems to be found which provide easy-to-use but advanced functionality. One of thes
0.引言最近做了一个命名实体识别(NER)的任务,发现了bert的强大,不愧是谷歌花了大精力训练的模型。其实网上相关tensorflow,pytorch的代码很多,但是用Keras的感觉没有一个是简单明了的,所以我在写这个网络的时候遇到不少麻烦,作为总结,把自己的经验分享给大家,尽量做到简单明了可实现,代码粗陋,适合新手学习,也欢迎大佬多给些宝贵意见。1.前期准备keras中要用bert和c...
目录二、正则表达式、文本正则化、编辑距离2.1 Regular Expressions2.1.1 基本的正则表达式模式2.1.2 Disjunction(析取)、Grouping、以及优先级顺序2.1.5 更多操作符(小结)2.1.6 正则表达式替换、捕获组2.2 Words2.3 语料2.4 文本正则化2.4.1 利用 Unix 工具粗糙的分词和正则化2.4.3 中文分词:最大匹配算法2.4..
尊敬的读者您好:笔者很高兴自己的文章能被阅读,但原创与编辑均不易,所以转载请必须注明本文出处并附上本文地址超链接以及博主博客地址:https://blog.csdn.net/vensmallzeng。若觉得本文对您有益处还请帮忙点个赞鼓励一下,笔者在此感谢每一位读者,如需联系笔者,请记下邮箱:zengzenghe@gmail.com,谢谢合作!一面(2019.9.4)...
NLP 通常所需要处理的语料包含了非结构化文本、半结构化文本以及结构化文本 。 正则表达式的作用之一是将这些文档内容从非结构化转为结构化以便后续的文本挖掘 。正则表达式是一种定义了搜索模式的特征序列,主要是用于字符串的模式匹配,或是字符的匹配。另一个作用就是去除"噪声" 。 即去除文本中与最终输出无关的片段。一、匹配字符串通过使用 re.search ( regex , string) 这个...
GAN作为生成器已经在图像方面大放异彩,然而在NLP方面的应用还不多,原因一部分在于GAN是为连续空间设计的,而NLP是离散的,因此需要一点小小的trick才可以work
新词发现并不是一个新的课题,但最有意思的一点是如果采用无监督的算法,可以完全脱离人工的经验由算法自动找到有语意的“词语”,而不是胡乱拼凑的汉字片段(归因于算法的有效性和语料本身是由有意义的词语构成的)。本文参考了matrix67的一篇文章,[互联网时代的社会语言学:基于SNS的文本数据挖掘](http://www.matrix67.com/blog/archives/5044),采用无监督方法来发
当AI模型在训练数据(源域)中表现卓越,却在真实场景(目标域)中频频失效,其症结在于数据分布的割裂。源域与目标域的最小化通过数学手段强行弥合两者差异,如同为算法注入“跨域适应”的基因。这一过程的核心在于特征空间分布对齐——借助对抗训练、域混淆等技术,重构神经网络的特征提取逻辑,剥离领域特有噪点(如模拟器的完美光照或医学文本的固定术语),保留跨场景通用模式(如物体运动规律或疾病纹理特征)。
收到许多读者的强烈呼声,本数模小组还是决定将2020美赛C题的全流程与可视化开源。因为这是一道以NLP【最易理解的NLP入门!】数模实战导向(20美赛C题)2020美赛C题。PS:本次本人并没有承担所有的Coding工作,故不会有全部的源码,仅有NLP部分的源码。在此处让我们赞美我们小组里技艺逐渐精进的两位队员!本题实际上是一道门槛并不高的题目,即使从未接触过NLP的本人也是快速掌握并完成,当然也
用大模型来批量预处理数据,以支持科研目的。现阶段支持OCR功能, 支持使用的大模型有 qwen(通义千问), moonshot(月之暗面), PaddleOCR(百度飞桨OCR), openai。
(1) pip install pyltp 首先 pip 安装 pyltp 库。(2) 在 LTP 的模型页面下载模型,我直接就放在pyltp库下面了。
基于历史判例的刑事判决刑期参考模型——以故意杀人罪为例子,数据来源:裁判文书网
昆仑天工系列AIGC开源模型,支持AI问答、AI写作、AI绘画、AI补全代码,基于中文语料训练而成,不止ChatGPT。
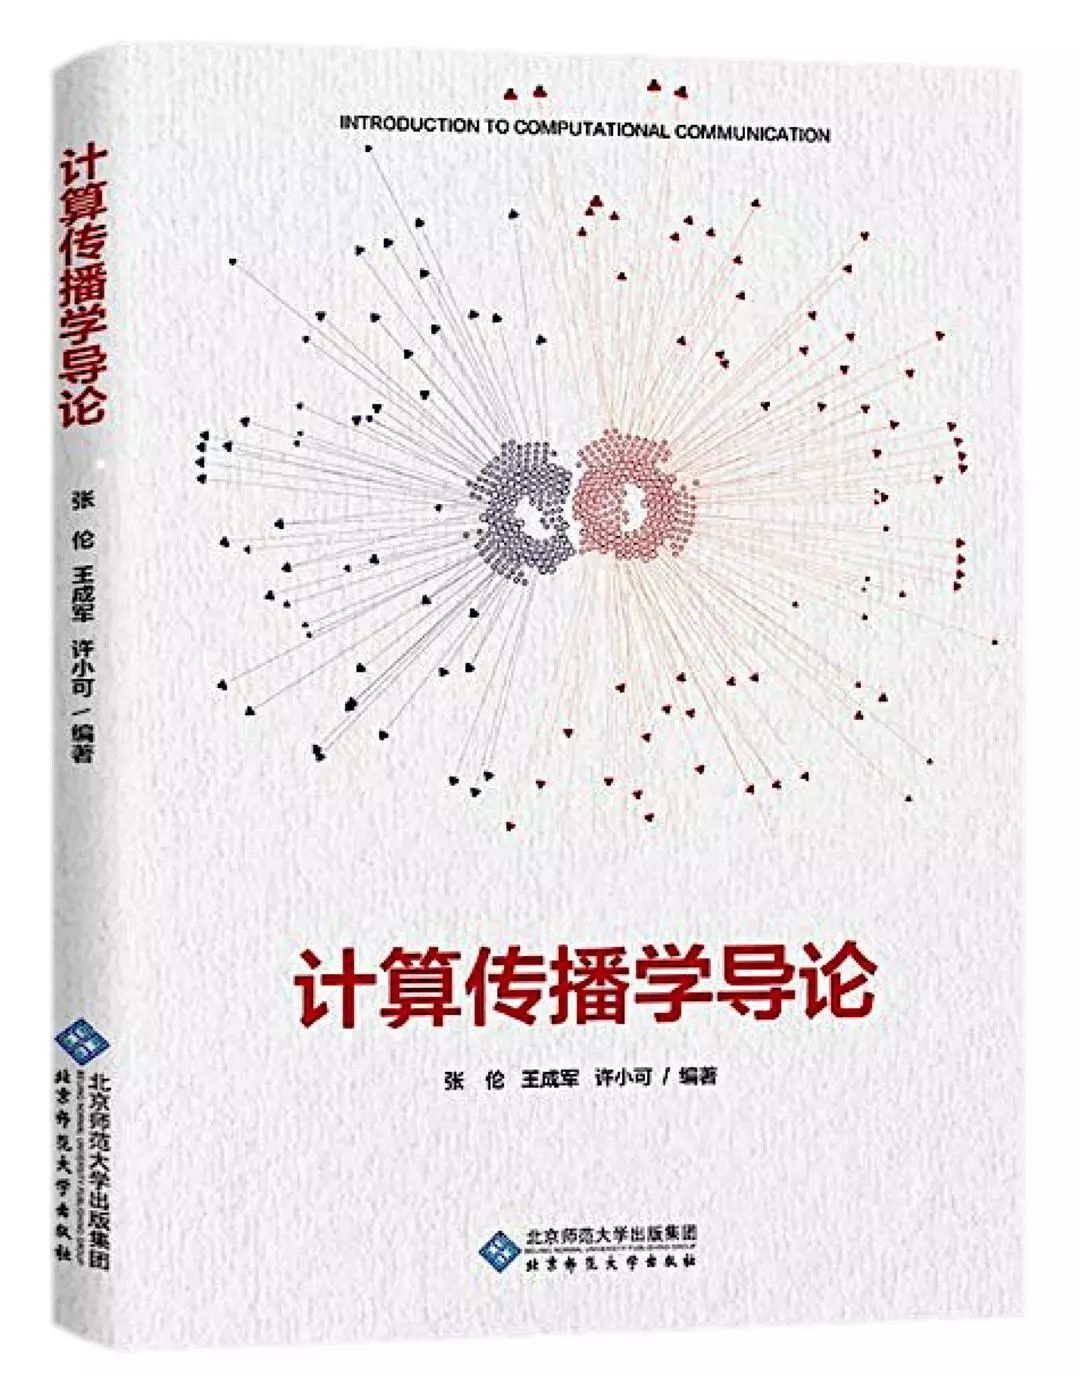
第三章 情感分析传播学研究为什么需要情感分析?一个重要的原因是我们希望获知其他人的“意见”。人们的意见是影响行为的重要因素。同时,作为一种社会化动物,人们的意见还影响其他人对事物的看法,继而影响个体和群体做出决策。社会化媒体的兴起,使得研究者有更多机会获取用户关于公共事务、产品服务等反馈。利用计算方法,我们则有可能对用户发布的上述内容进行情感分析获知。情感分析是一种计算研究。情感分析旨在对大规模文
单个样本组成结构
Language TechnologyMeaning of Word(一个vector表示一个word)Predicting the next word给一串sequence of words,预测下一个单词 我们现在要做的就是将wi-1和wi-2描述成一个feature vector,1- of -N encoding:假设只要对着几个词汇做word2vec:lexicon = {apple,
nlp
——nlp
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 亚马逊云科技技术品牌专区

 AtomGit AI 社区

 乐奇 Rokid 开放社区



 天工造物局











 DAMO开发者矩阵