登录社区云,与社区用户共同成长
邀请您加入社区
在大型语言模型(LLM)的训练与推理实践中,框架生态的兼容性是一个关键挑战。在无 MindSpore 环境的情况下,实现单卡 PyNative(动态图)模式的预训练闭环。目标平台为 Ascend NPU(通过torch_npu),同时需向下兼容 CUDA 和 CPU。本次单卡改造必须为后续平滑放大到多卡并行训练铺平道路,避免未来大规模重构。因此,所有设计决策都以“单卡即多卡 world_size=
问题方向优化建议指标不一致设计更贴合业务的评估指标(如 Weighted NDCG)分布不一致使用近线训练样本,引入在线特征、周期性更新模型部署不一致特征/模型/服务版本对齐,建立稳定部署流程策略干扰区分模型效果与策略干预效果,独立评估纯模型表现数据不闭环建立推荐结果与点击行为的闭环采样与再训练机制。
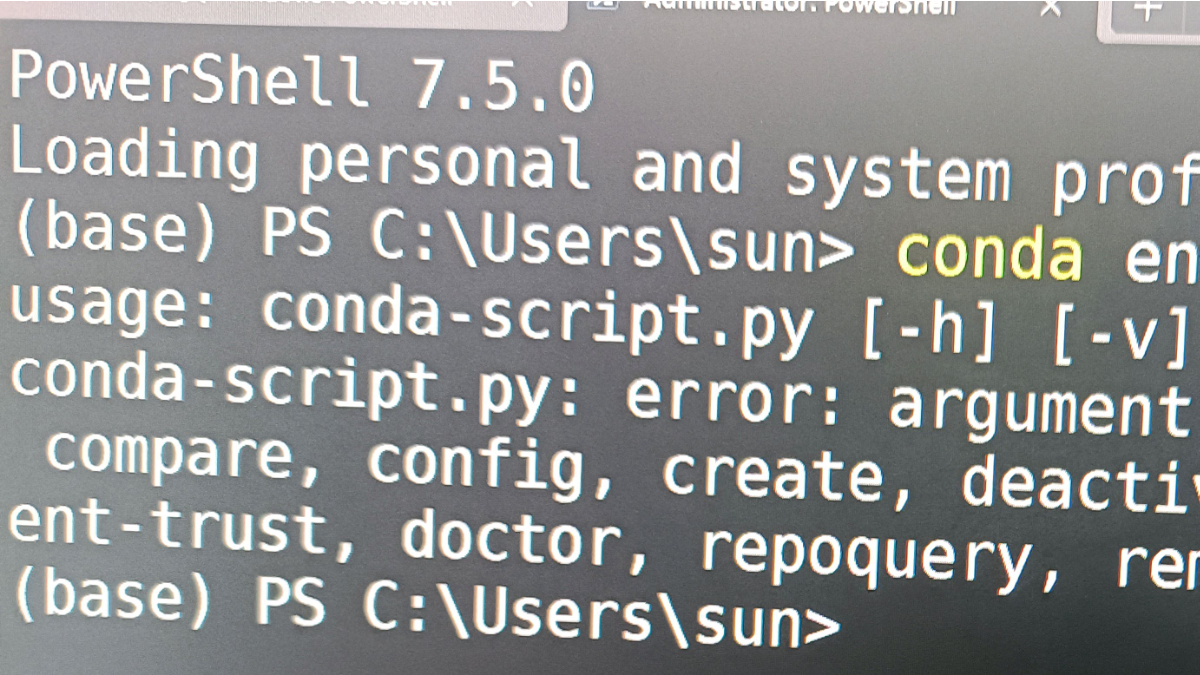
miniconda 24.11.1和最新版的powershell有兼容性问题,无法执行conda命令,目前powershell 社区已经知晓,把责任归咎于conda,据悉最新版的anaconda已经修复了该问题,但miniconda依旧存在该问题,有人在社区给了解决办法,但我尝试后无效,终极解决办法是卸载 powershell 7.5,安装powershell 7.4.7,7.4版本是目前微软的l
分析 Pytorch 框架中 train_dataloader 的数据结构。根据Pytorch官网上的tutorials部分介绍,首先下载训练和测试数据并安装好,然后是编程分析数据加载器的数据结构。这里分享的是分析 train_dataloader 的数据结构的过程,test_dataloader的数据结构与前者的是一样的,不再赘述。
在设计时对微信客户端进行了充分的了解,掌握微信平台通过的接口,同时系统采用Java技术进行开发,MySQL数据库进行数据的储存,充分的保证了系统的稳定性、安全性,基于微信平台的在线答题小程序实现了客户端和服务器端两部分,实现了在线答题相关信息的查询管理功能。微信是目前国内使用最多的社交软件之一,有庞大的用户群体,便于调查者获取不同年龄段不同层次和地方的市场情况和用户需求,而且利用微信小程序调查,用
注意:miniconda和虚拟环境的路径要替换成自己的路径。
tensorflow-estimator、tensorflow-intel、tensorflow-io-gcs-filesystem等卸载后无需重新安装即可以顺利执行。方式一:用命令行卸载torch、torchvision、tensorboard、tensorboardX等及其相关再重新安装。如果存在tensorflow-estimator、tensorflow-intel、tensorflow-
Pytorch 混合精度训练 (Automatically Mixed Precision, AMP)
win10超简单安装onnx和tensorrt,没有花里胡哨!
yolov5s模型使用tensorrt加速在显卡1060上运行FPS提升到90左右,比原始官方模型提升一倍左右支持python调用和c++调用
import paddleimport matplotlib.pyplot as pltimport numpy as npfrom PIL import Imageimport paddle.nn.functional as Fclass MNIST(paddle.nn.Layer):def __init__(self):super(MNIST, self).__init__()self.fc
用torch 1.8.1训练保存的模型,用torch 1.1.0进行模型加载。PyTorch的1.6版本将torch.save切换为使用新的基于zipfile的文件格式。 torch.load仍然保留以旧格式加载文件的功能。 如果出于任何原因您希望torch.save使用旧格式,请传递kwarg _use_new_zipfile_serialization = False。The 1.6 rele
对于这个问题,需要做的也很简单,无非就是将模式“P”转化为“RGB”模式,再保存为“jpg”就可以了,所以只用增加两行代码:if img.mode == "P":img = img.convert('RGB')
第一步v列表JSON格式的[{“sentence”: “宝可梦李宏毅大师”},{“sentence”: “宝可梦李宏毅大师”},{“sentence”: “宝可梦李宏毅大师”},{“sentence”: “宝可梦李宏毅大师”},{“sentence”: “宝可梦李宏毅大师”},{“sentence”: “宝可梦李宏毅大师”},{“sentence”: “宝可梦李宏毅大师”},{“sentence”
目录结构1、背景介绍2、数据采集3、网络设计4、网络训练5、网络部署6、总结1、背景介绍最近采购了一块新的树莓派,迫不及待的想要在树莓派上实现一个实时的手势识别。从算法的角度讲,并不是太难;但是从工程的角度来说,主要有两个难点,一是手势数据的采集。大家都知道,深度学习的高精度离不开大量的训练数据,网络设计的再好,没有足够的数据是不行的。因此要想实现一个好的手势识别,采集数据就成了一个比较重要的难点
首先导入pandas会报出/usr/local/lib/python3.6/site-packages/pandas/compat/__init__.py:120: UserWarning: Could not import the lzma module.Your installed Python is incomplete.Attempting to use lzma compression
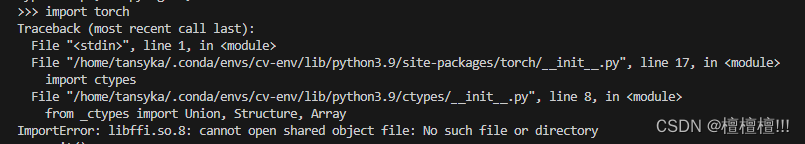
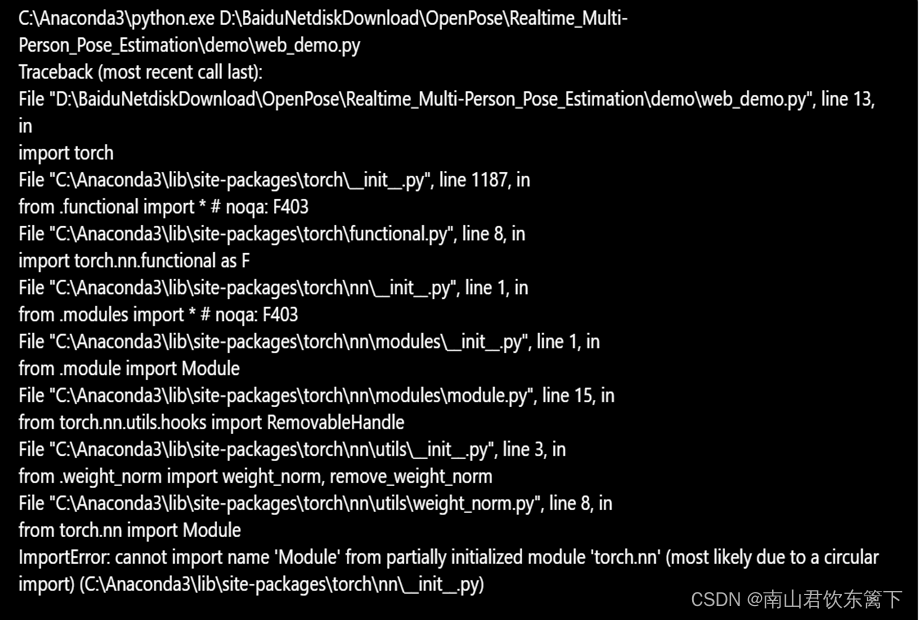
>>> import torchTraceback (most recent call last):File "<stdin>", line 1, in <module>File "/home/gp/anaconda3/envs/torch1.4.0/lib/python3.6/site-packages/torch/__init__.py", line
在 PyTorch 框架中,是一个通过和 Triton 生成代码来运行的内部接口,用于实现灵活的注意力机制。NPU 环境下该接口在部分场景下存在兼容性问题。本文记录了在 NPU 环境下适配接口的完整过程,包括问题定位、解决方案及最终结论。本文详细记录了在 NPU 环境下适配 PyTorch设备类型检查的绕过与补丁triton 依赖的安装与版本适配设备属性检查的兼容性修改模块路径变更的适配编译优化阶
**同步很关键** | 不同步到 site-packages,实际运行仍会加载旧逻辑,表现为报错仍在 `torch.distributed._state_dict_utils` 的 `cudaHostRegister` 行 || **直接原因** | 对 `None` 对象调用 `cudaHostRegister(...)` / `cudaHostUnregister(...)` 导致 `Attr
本文业务场景是:用药应用按周期提醒用户,并在疗程结束后自动停止。主操作为“创建有限次数的周期提醒任务”。成功标准至少包括:目标结果正确、用户可取消、进程重启可恢复、重复回调不破坏终态、性能指标可度量、隐私数据未越界。value?: string非目标也要写清:不绕过系统权限,不在不支持设备伪造成功,不把平台对象直接暴露给页面,不用用户原始数据换取更方便的调试。重复提醒:周期、次数与幂等执行 的真正
本文业务场景是:全球化应用希望登录入口跟随语言,并在授权过程中显示一致加载反馈。主操作为“配置华为账号登录按钮多语言文本与加载动效”。成功标准至少包括:目标结果正确、用户可取消、进程重启可恢复、重复回调不破坏终态、性能指标可度量、隐私数据未越界。value?: string非目标也要写清:不绕过系统权限,不在不支持设备伪造成功,不把平台对象直接暴露给页面,不用用户原始数据换取更方便的调试。
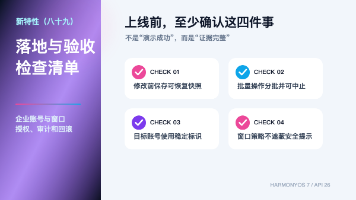
本文业务场景是:共享企业终端根据班次切换受管系统账号,并核对关键应用窗口状态。主操作为“创建、切换或移除企业设备系统账号”。成功标准至少包括:目标结果正确、用户可取消、进程重启可恢复、重复回调不破坏终态、性能指标可度量、隐私数据未越界。value?: string非目标也要写清:不绕过系统权限,不在不支持设备伪造成功,不把平台对象直接暴露给页面,不用用户原始数据换取更方便的调试。
利用树莓派5的NPU性能优势,结合pytorch框架优化低延迟人脸追踪应用,提升边缘计算场景下的实时处理能力,为嵌入式视觉项目提供实用解决方案。
transforms,torch,python版本如下。导入以上包时报错,查阅资料尝试分开导入。
利用PyTorch框架在树莓派5上部署YOLO模型,实现实时人脸检测与追踪。通过优化推理流程,显著提升边缘设备上的运行效率,为低功耗场景下的人脸追踪应用提供可行方案。
基于rknn_model_zoo的examples中的yolo11部署推理的步骤
利用PyTorch框架在树莓派5上部署高效的人脸追踪应用,充分发挥其边缘计算能力。通过轻量化模型优化,实现低延迟实时追踪,展现pytorch与树莓派5在嵌入式AI场景中的强大结合。
利用PyTorch设计轻量化神经网络,部署于树莓派5的NPU中,显著提升人脸追踪效率与实时性,为边缘设备上的视觉应用提供可行方案。
提供了很多方式下载,如github、百度网盘、gitee等。当然也可直接访问hugging face的国内镜像站。注意:该方式只可访问还是无法注册登录!在Steam++主界面找到。1.下载安装Steam++
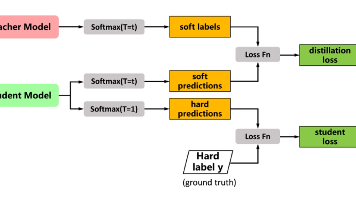
知识蒸馏是一种模型压缩技术,旨在将复杂教师模型的知识迁移到简单学生模型中。其核心思想是通过带温度参数的softmax函数,使教师模型输出的软标签保留类别间关系信息(如0.7猫、0.1香蕉),而非仅用硬标签(1,0,0)。训练时采用双损失函数:1)教师与学生软标签的交叉熵损失(传递知识);2)学生输出与真实标签的交叉熵损失(保证准确性)。通过调节温度T和平衡系数α,学生模型既能学习教师模型的泛化能力
摘要:本文介绍了如何将PyTorch模型导出为ONNX格式,并实现TensorRT自定义算子。首先定义了一个包含自定义算子MYPLUGIN的PyTorch模型,通过torch.onnx.export导出ONNX模型。然后详细讲解了TensorRT自定义算子的实现过程,包括创建插件文件夹、编写CUDA核函数(myselu_kernel)和插件类(myPlugin)。该插件类继承自IPluginV2D
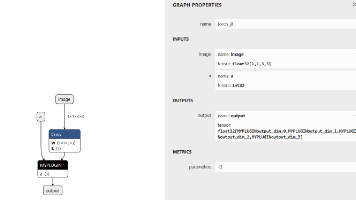
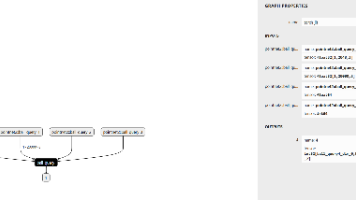
本文介绍了如何将PointNet++中的ball_query操作导出为ONNX模型并实现TensorRT插件。主要内容包括:1) 使用PyTorch导出包含ball_query操作的ONNX模型;2) 分析导出的ONNX模型结构;3) 开发TensorRT插件实现ball_query功能,包括插件类的接口实现和CUDA内核封装。该插件支持动态输入维度计算,包含初始化、执行、序列化等核心方法,并提供
由于conda安装的盘里剩余空间不足,又不想移动原来的数据,遂尝试安装在其他盘中。
Gini 指标(或 Gini 系数)是衡量模型预测性能的一种常见指标,尤其适用于不平衡数据集,广泛应用于信用评分、保险风险预测等领域。它与 AUC(Area Under the Curve)密切相关,但更强调对排序的评价。
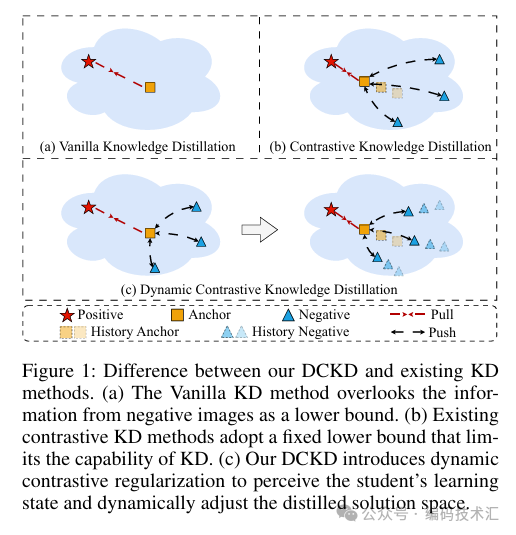
图1展示了传统知识蒸馏方法与本文提出的动态对比知识蒸馏(DCKD)方法的对比。在(a)中,传统KD方法仅约束了解空间的上界,缺乏对下界的约束,可能导致优化困难和低质量输出。在(b)中,现有对比式KD方法引入固定下界约束,虽然提升了教师模型知识的传递,但在训练后期学生模型远离下界,约束效果减弱。而(c)中的DCKD通过动态对比正则化,根据学生模型的学习状态动态调整解空间的下界,同时利用分布映射模块提
Dify是一款开源的大语言模型(LLM)应用开发平台。对数百个模型的支持、直观的Prompt编排界面、高质量的RAG引擎、稳健的Agent框架、灵活的流程编排。在linux环境中使用docker部署dify,vllm部署DeepSeek-R1,ollama部署bge-m3。unexpected character "%" in variable name near "%H:%M:%S\n。Not
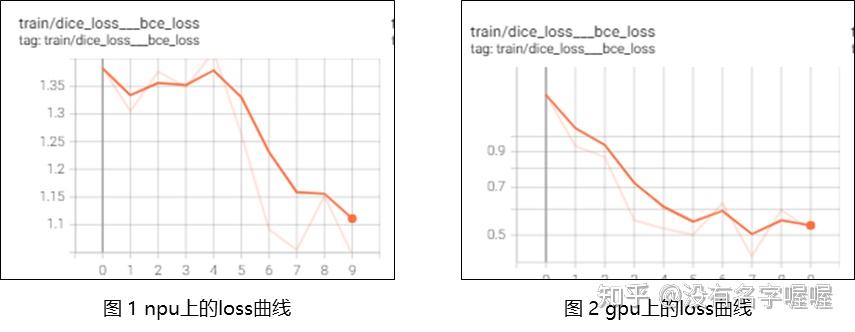
npu在这里丢了image_embedding的梯度,因为该模型用到了Reg_op(RepeatInterleaveGrad)这个算子,接下来分析cann包是否有这个算子 发现是有的 但是通过进入python后调用torch_npu.repeat_interleave_backward_tensor这个函数,发现调用失败。功能说明:停止精度数据采集,在 start 函数之后的任意位置添加,若需要
2024-10-29 14:04:23.055 | INFO| chatchat.server.knowledge_base.kb_cache.faiss_cache:save:40 - 已将向量库 ('samples', 'quentinz/bge-large-zh-v1.5') 保存到磁盘。,用于简化在本地运行大语言模型,降低使用大语言模型的门槛,使得大模型的开发者、研究人员和爱好者能够在本地
解决安装torch_geometric后,import torch出现A module that was compiled using NumPy 1.x cannot be run in NumPy 2.0.2 as it may crash.(记录)
第一次没注意进度,没上传完,报错。
一张超高分辨率图片送入DINO进行检测,会导致爆显存,只要分别把模型放入不同gpu,再让图片分别经过这几个gpu就能解决,这就是模型并行具体替换的代码很简单,我放在博客里面了,有兴趣的直接替换就好了,DINO模型并行大家有兴趣的可以一起讨论,其实还存在很多问题,第一个问题:比如拆分作用有待商榷?因为21G+20G?单卡也才23G呀.第2个问题:在执行完1个epoch时,执行test时,GPU不能访
本地部署controlnet,利用huggingface提供的训练代码和数据进行训练。从相关文件的下载,环境的配置,到训练模型,测试模型,以及报错的解决
rknn-toolkit2的项目页会有更新的环境配置文件。因此为了对齐项目和环境的配置,确保下载的是最新版项目和最新版环境(有需要、有能力的话可以自行对齐项目和环境版本)。然后再选择小版本更新的最新版,点进去后再进入packages文件夹,下载对应python版本的whl文件。使用yolov5训练自己的数据集,希望将训练好的pt文件转换成rknn文件。板子是3568,根据rknn-tooltik2
经过剪枝操作后的模型,原始的参数存放在了weight_orig中,对应的剪枝矩阵存放在weight_mask中, 而将weight_mask视作掩码张量,再和weight_orig相乘的结果就存放在了weight中。局部剪枝只能以部分网络模块为单位进行剪枝,更广泛的剪枝策略是采用全局剪枝(global pruning),比如在整体网络的视角下剪枝掉20%的权重参数,而不是在每一层上都剪枝掉20%的
在深度学习训练过程中,损失计算是非常重要的一环。有一种论调叫做“损失函数的设计在一定程度上决定了模型能干什么”。PyTorch提供了许多损失计算函数,包括torch.nn.L1Loss,torch.MSELoss,torch.nn.CrossEntropyLoss,torch.nn.BCELoss,torch.nn.BCEWithLogitsLoss等。具体可以参考如下连接:torch.nn —
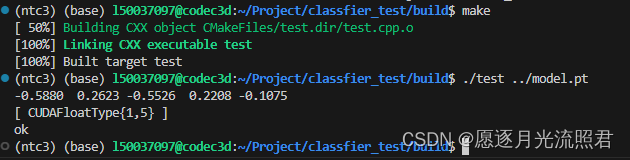
主要目的是想用C++在服务器上部署深度学习模型
本文介绍了一维卷积运算,包括步长、零填充;宽卷积、窄卷积、等宽卷积;卷积运算与互相关运算等及其PyTorch实现
pytorch
——pytorch
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 鲲鹏昇腾开发者社区

 乐奇 Rokid 开放社区





 HarmonyOS开发者社区