登录社区云,与社区用户共同成长
邀请您加入社区
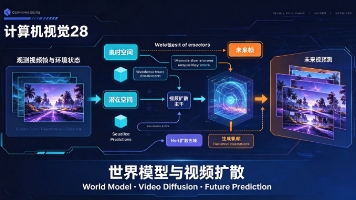
本课探讨视频扩散模型如何演变为可学习的世界模拟器。纯视频生成模型(如Sora 2)仅凭提示生成视频,而动作条件化世界模型(如Genie 3、GWM-1 Worlds)可通过动作预测未来帧,实现交互式模拟。核心架构采用时空3D分块与旋转位置编码,结合联合注意力机制。该范式已广泛应用于自动驾驶(如NVIDIA Cosmos-Drive)与机器人技术——通过VLM规划、视频模型模拟、逆动力学执行构成闭环
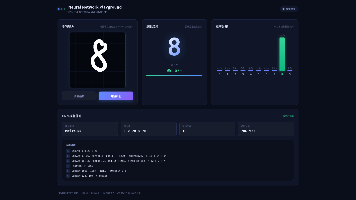
前面几篇文章中,我已经用华为云码道 Agent 完成了一个 OpenCV Vision Lab 项目。从基础图像处理,到 Canny、Harris、SIFT,再到多组参数对比,整个项目已经比较完整。很多算法本身不需要训练模型。只要安装好 OpenCV,就可以直接调用对应算法完成处理。所以这一次,我想继续往前走一步。PyTorch + CNN + 深度学习。Neural Network Playgr
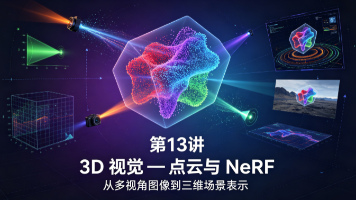
本文介绍3D视觉的两大核心表示:点云与NeRF。点云是传感器原始输出,通过PointNet的共享MLP与最大池化实现置换不变性,适用于分类与分割;NeRF则以神经网络学习体积场,结合位置编码与体渲染,从多视角图像重建3D场景。其后继者如Instant-NGP与3D高斯泼溅显著提升训练与渲染效率。两者共同解决“空间中什么在哪里”的问题,推动机器人、自动驾驶与AR/VR发展。
在WSL+Ubuntu22.04下安装CUDA11.8+CUDNN8.9+tensorrt8.6,接近Jetson的环境
Could not load library libcudnn_cnn_infer.so.8. Error: libcuda.so: cannot open shared object file: No such file or directoryPlease make sure libcudnn_cnn_infer.so.8 is in your library path!
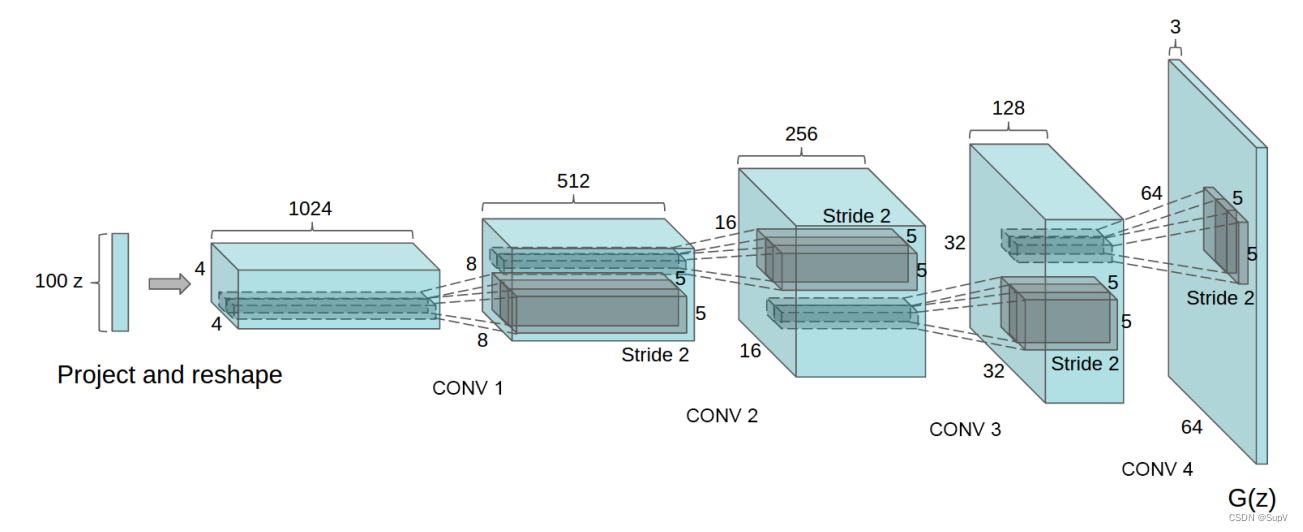
深度卷积神经网络(Deep Convolution Generative Adversarial Nets)的生成网络在DCGAN中,判别网络是一个传统的深度卷积神经网络,但使用了带步长的卷积来实现下采样操作,不用maxpoolingmaxpoolingmaxpooling操作;生成网络使用了一个特殊的深度卷积网络来实现。如上图,使用微步卷积来生成64×6464×6464×64大小的图像。第一层是
以下只是一个简单的2D卷积的示例:头文件#include<ap_int.h>#include<iostream>#include<hls_video.h>#define MAX_LEN 100#define K 3using namespace std;typedef ap_int<16> data_t;void conv2d(data_t in[M
解决报错Could notload librarylibcudnn_cnn_infer.so.8. Error: libcuda.so: cannot open shared object file: No such file or directory.
基本介绍bilstm介绍:(用的是微信登录)实现代码attention介绍bert层 (大部分来源于cbow)做预训练,一个很不错的bert讲解该博主 bert+cnn也给了代码包括attention 机制,总之该博主是个宝藏博主 ,txt和CSV 的区别,(不是很清楚。。)对txt进行数据划分训练的时候 好像还要用 cuda我自己安装的9.1版本的。然后验证一下 算是安装好了。安装完还是用不了。
简介模型剪枝就是根据神经元的贡献程度对网络中的神经元进行排名,可以从网络中移除排名较低的神经元,从而形成一个更小、更快的网络模型。基本思想示意图:模型剪枝根据神经元权重的L1/L2范数来进行排序。剪枝后,准确率会下降,网络通常是训练-剪枝-训练-剪枝(trained-pruned-trained-pruned)迭代恢复的。如果我们一次剪枝太多,网络可能会被破坏得无法恢复。所以在实践中,这是一个迭代
对图像的不同窗口数据和卷积核做内积(逐个元素相乘再求和)的操作,就是所谓的“卷积”操作,这也是卷积神经网络名字的来源。卷积核是一组固定的权重,因为每个神经元的多个权重固定,所以又可以看作一个恒定的滤波器filter。卷积操作可以帮助计算机提取图像中的局部特征,例如边缘、纹理和轮廓。与人眼观看事物相似,卷积神经网络会先关注图片的轮廓和低级特征,再逐层组合成高级语义特征。return x:当某个指标不
摘要:本文提出了一种结合CNN与LSTM的脑电情绪识别模型,利用CNN提取EEG信号空间特征,LSTM捕捉时序特征,实现高效情绪分类。实验表明该模型在多个数据集上性能优越,为情绪监测应用提供了新思路。论文首先介绍EEG情绪识别背景及CNN/LSTM原理,随后综述相关研究进展,重点阐述模型设计:包括数据预处理、CNN/LSTM架构及训练优化方法。研究为情绪识别领域提供了理论支持和技术方案。 (注:摘
(3) 在哪里找这些数据也已经在。使用这个命令,因为我的环境下。报错信息很多:一部分如下。预训练数据下载好了;
本项目为基于CNN特征提取的本地图片/视频重复检测与整理工具,适用于编程入门学习。利用MobileNet等模型提取特征,结合余弦相似度识别重复内容,支持图片、视频多级筛选与归档,无需GPU,纯CPU运行。具备图形界面与命令行双入口,多线程加速处理,检测与归档解耦可人工审查。适合初学者理解深度学习在实际场景中的应用,源码已优化调试,兼容Windows+Python 3.12+环境。
本文实现卷积层采用 Verilog HDL 进行设计,支持任意分辨率图像的卷积运算。输入图像数据通过行缓存(Line Buffer)和移位寄存器构建 5×5 滑动窗口,卷积核权重则通过预初始化的 MEM 文件加载至 ROM 中,实现卷积参数的灵活配置与快速更新。模块内部采用并行乘法器与流水线加法树结构完成乘法累加(MAC)运算,在保证高吞吐率的同时有效提高系统时钟频率。通过修改 MEM 文件即可切
define MODEL_INPUT_SIZE 6 // 模型输入窗口大小#define MODEL_OUTPUT_SIZE 6 // 模型输出大小// TFLite全局变量// 创建错误报告器// 为TFLite分配内存 - 减少内存大小// 减少到50KB// 16字节对齐// 数据缓存 - 使用较小的缓冲区。
简易编译install ncnn脚本
最近,GraphRAG在GitHub上发布 [重磅 - 微软官宣正式在GitHub开源GraphRAG],提供比简单RAG方法更结构化的信息检索和全面的响应生成。GraphRAG代码库还附带一个解决方案加速器,提供易于使用的API体验,托管在Azure上,可以在几次点击中无代码部署。GraphRAG将RAG的优势与基于图的索引和摘要相结合,通过解决检索增强生成和查询聚焦摘要(QFS)在处理大量文本
使用一些ai工具去读一个文章
基于lstm的交通流量预测 完整代码实战计算机毕业设计
本文系统讲解了如何加载训练好的PyTorch模型进行推理。
本文基于 PyTorch 完成一个完整的 20 类食物图像分类实战项目,涵盖自定义 CNN 搭建与训练、学习率调度器(ReduceLROnPlateau / StepLR)调优、ResNet18 迁移学习微调、以及最优模型权重加载推理的全流程。从卷积尺寸计算、自定义 Dataset、数据增强与 ImageNet 归一化等核心知识出发,配套完整可运行代码与常见问题排查指南,帮助深度学习初学者快速打通
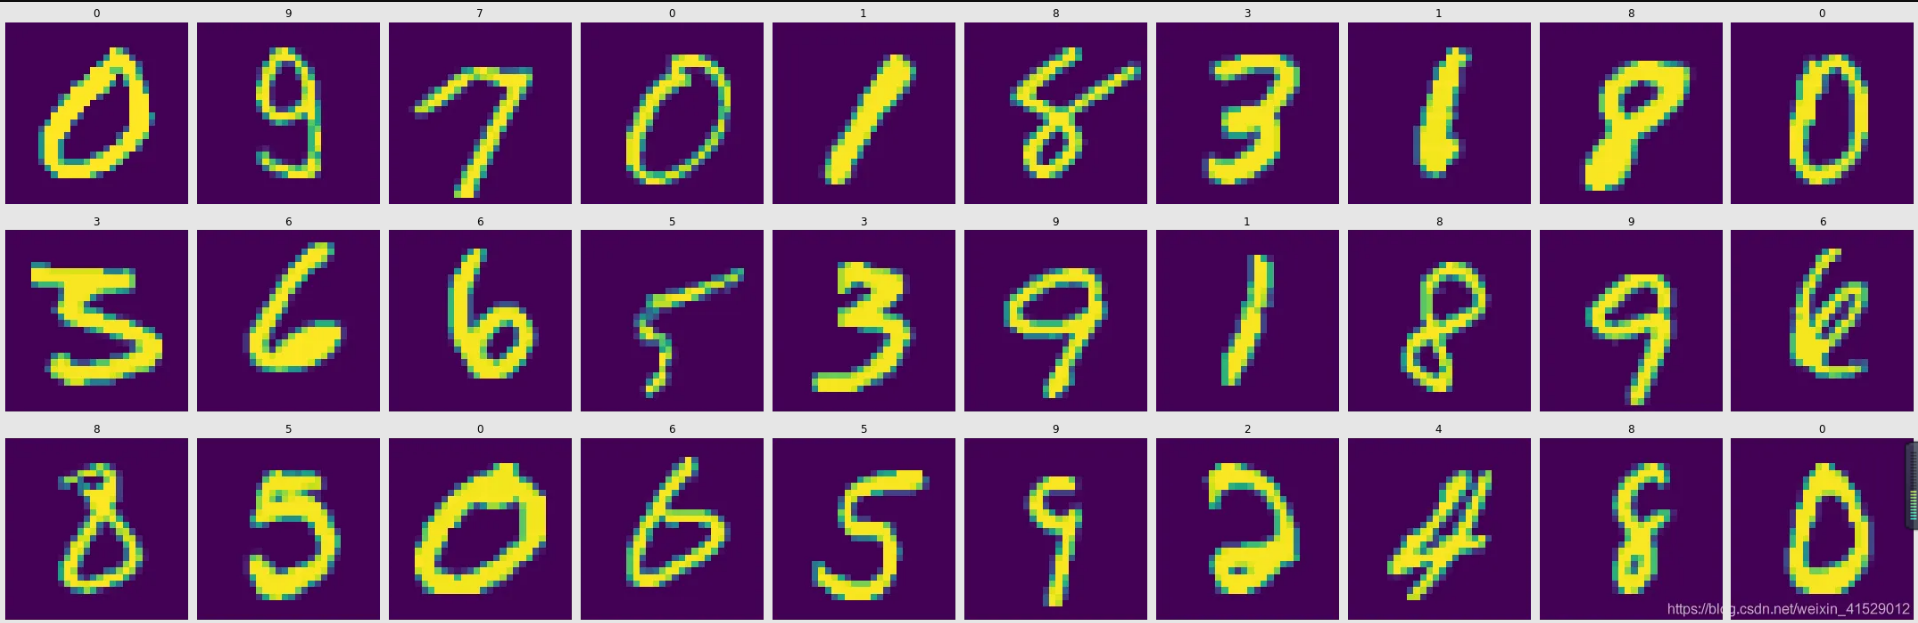
分别用SVM、贝叶斯分类、二叉树、CNN实现手写数字识别
系列文章目录谣言检测文献阅读一—A Review on Rumour Prediction and Veracity Assessment in Online Social Network谣言检测文献阅读二—Earlier detection of rumors in online social networks using certainty‑factor‑based convolutional
1.github官网下载源码2.配置深度学习环境3.下载模型4.照片上色代码from deoldify import devicefrom deoldify.device_id import DeviceId#choices:CPU, GPU0...GPU7device.set(device=DeviceId.GPU1)from deoldify.visualize import *plt.sty
先用pytorch训练FCN,然后把权重的pth文件,先转为wts文件,然后在NX板上转为tensorrt的engine文件只写具体思路和遇到的问题,完整版参考github这里写的是paper里的由vgg16而来的FCN,首先实现vgg16的tensorrt先来看下vgg16的结构'vgg16': [64, 64, 'M', 128, 128, 'M', 256, 256, 256, 'M', 5
本文基于PyTorch从零构建卷积神经网络(CNN)实现MNIST手写数字识别,系统讲解了卷积、池化、权值共享、ReLU激活等核心概念。通过对比全连接网络,阐明CNN在参数量控制、空间信息保留和特征提取方面的优势。
卷积神经网络擅长图像处理,也用于自然语言处理。图像可看作矩阵,卷积过滤器在图像上滑动并加权求和。卷积后的输出叫特征图。过滤器数值通过训练得到,是特征检测器。填充和步进可调整特征图大小。卷积层常见流程:卷积 → 激活函数 → 池化。常用激活函数:ReLU。常用池化:最大池化。卷积神经网络通过通道处理多特征图,彩色图像有 RGB 三通道。卷积过滤器通道数必须与输入通道数一致。最后连接全连接层,分类时使
针对本地食物图像数据集的图像分类任务,本文基于 PyTorch 框架实现一套完整的深度学习训练流程。首先通过脚本遍历文件夹生成图片路径‑标签 txt 索引文件,解决本地分类数据集无法直接被 PyTorch 读取的问题;其次讲解`Dataset`中`__getitem__`、`__len__`魔法方法底层原理,自定义食物数据集类完成图片读取、预处理与标签转换,借助`DataLoader`实现样本批量
传统神经网络:传统神经网络一般为全连接结构,神经元层层全部相连,输入图像需要展平为一维向量,丢失像素的空间位置关系。它参数量庞大,计算成本高,容易发生过拟合,无法自动提取图像局部特征,对物体平移、形变适应性差,更适合一维表格数据。卷积神经网络卷积神经网络依靠局部感受野、权重共享与池化操作,卷积核只提取局部特征,大幅减少参数。网络逐层提取边缘、轮廓、高层语义特征,保留图像二维空间信息,池化带来平移不
摘要:本文提供基于CCO-CNN-BiGRU-Attention等6种模型的单变量时序预测Matlab代码合集,可实现一键运行对比分析。代码采用电力数据格式(excel),通过运行main函数即可自动生成各模型预测结果和对比图表。核心特点包括:支持CCO算法优化参数(隐藏层节点数、学习率等);包含R2、MAE等多项评价指标;提供完整中文注释和测试数据集。该代码适配MATLAB 2020b及以上版本
一、引言:多变量时序预测的模型差异化需求与 GWO 的优化价值在光伏出力预测、电力负荷预测、交通流量预测等工程场景中,多变量时序数据呈现 “空间耦合强、时序依赖长、关键特征动态变化” 的复杂特性 —— 例如光伏出力受辐照度、温度、湿度、风速等多变量协同影响,且日内时序存在峰谷突变、长期趋势受季节调控的双重特征。传统单一模型(如 CNN-LSTM)难以适配不同场景下的特征提取需求,而模型关键参数(如
YOLOv1 开创了 one-stage 目标检测的先河,用 “一次前向传播” 的思路重新定义了检测效率;YOLOv2 则在其基础上,通过 Batch Normalization、Anchor Boxes、多尺度训练等改进,弥补了精度短板,成为兼顾 “速度与精度” 的经典模型。这两个版本不仅是 YOLO 系列的起点,也为后续 YOLOv3、YOLOv5 等版本的发展奠定了基础,至今仍是学习目标检测
其核心思路在于,运用层次化分解(hierarchical decomposition)将不同频率的模式分别处理,随后借助跨尺度注意力(cross-scale attention)机制实现特征融合。最新的研究成果是将因果图转换为图神经网络(graph neural network)的结构,并在消息传递(message passing)过程中强制实施因果约束。最新的研究成果是运用基于梯度的元学习(gr
在当今这个数据爆炸的时代,多变量回归预测就像是一把神奇的钥匙,能够帮助我们打开未来趋势的大门,在金融市场预测股价走势、在气象领域预知气候变化、在工业生产中保障设备稳定运行…… 发挥着不可或缺的作用。今天,咱们就一起来聊聊基于 Transformer - BiLSTM、Transformer、CNN - BiLSTM、BiLSTM、CNN 这五个超厉害的模型进行多变量回归预测的那些事儿。想象一下,这
本文探讨了手写体数字识别的两种主要方法:卷积神经网络(CNN)和支持向量机(SVM)。手写体数字识别作为图像处理和模式识别领域的重要应用,具有广泛的实际价值。CNN通过卷积层、池化层等结构自动提取特征,在MNIST数据集上表现出色;SVM则通过寻找最优分类超平面实现有效分类。实验结果表明,两种方法在手写体数字识别任务中均能取得良好效果,其中CNN因其自动特征提取能力在图像识别领域更具优势。研究为手
在电力负荷预测、气象数据预测、交通流量预测等多变量时序场景中,模型的特征提取能力、参数优化效率与输出模式(多输出 / 单输出)直接影响预测精度。WOA:优化模型超参数(如 CNN 卷积核大小、BiGRU 隐藏层节点数),避免人工调参的主观性与局部最优陷阱;CNN:提取多变量时序数据中的局部空间特征(如不同变量间的短期关联);BiGRU:捕捉时序数据的长期双向依赖关系(如历史数据对未来多步预测的影响
本文将详细介绍如何设计和实现基于 SSA-CNN-LSTM-Attention 模型的多变量时序预测消融实验,重点对比多输出与单输出两种预测模式的性能差异,并提供可一键运行的完整实验框架。
cnn
——cnn
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 DAMO开发者矩阵

 亚马逊云科技技术品牌专区

 乐奇 Rokid 开放社区



 天工造物局