登录社区云,与社区用户共同成长
邀请您加入社区
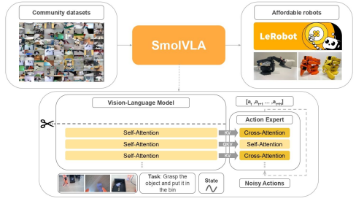
本次实验建立了SmolVLA在消费级显卡训练及LIBERO闭环评测流程。第100,000步checkpoint在四个套件上共400个回合中取得了201次成功,构成了当前训练预算和评测配置下的初步基线。该记录可以支持后续模型协作实验的可追溯对照,但尚不足以证明已达到原论文的性能。
—机器人基础模型所依赖的预训练骨干,据论文判断并不直接要求操作所需的显式空间度量,物体在三维空间里的位置与范围,只能从机器人演示里隐式学出来。它需要更多样的三维定位数据与模型,而三维框只是定位的一种形态,稠密的三维实例分割可能给出更细的几何监督。论文的位置也划得清楚:体素表征与多视投影、模型内部的几何感知表征、语言条件的三维价值图、可供性预测,都在往显式空间结构上走,在具身智能领域,论文把这道题提
现有VLA算法在静态物体操作任务上有强大的繁华能力,但在需要频繁感知,时空参与和连续控制的动态场景表现较差。本文算法DynamicVLA是一种动态目标操纵,通过三个关键设计集成了时空推理和闭环适应:1.,该模型使用卷积视觉编码器执行高效、结构可靠编码;2.,实现的重叠推理和执行,3.,通过强制时空对齐的动作执行弥补感知-执行差距。
本文通过 FoldPreviewRelay 演示项目,解决折叠屏相机页面“偶尔卡死”问题。核心在于分离 foldStatusChange 与窗口尺寸变化的职责:前者更新候选相机,后者判断 Surface 稳定性。采用快照+调度器机制,合并事件、去抖处理,确保会话重建串行执行。引入“连续两次采样一致”判定稳定,避免盲目延迟。旧会话严格按“停→释放→替换”顺序清理,防止资源竞争。最终实现折叠态切换时预
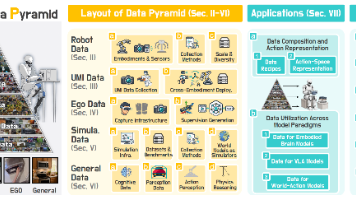
26年7月来自北京大学、南洋理工、香港科技大学、新加坡国立、香港中文大学、香港大学、杜克大学、加州伯克利分校、乔治城大学、南京大学和上海交通大学的论文“Data Pyramid for Embodied Manipulation: A Survey”。这篇综述的主要价值,是把具身操作的数据来源、采集方式、监督信号和模型用途放进同一个框架。它提供了一张较完整的数据地图,但尚未给出经过充分验证的“最优
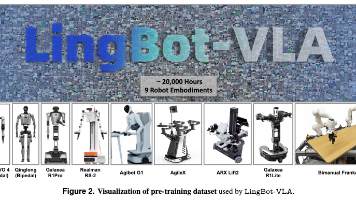
LingBot-VLA 是由蚂蚁集团提出的实用型视觉-语言-动作(VLA)基础模型,基于约20,000小时来自9种双臂机器人的真实世界数据训练而成。通过在4种机器人平台上对100项任务进行大规模评估,该模型展现出卓越的泛化能力与任务成功率,且性能随数据量增加持续提升,未见饱和。研究还构建了高效代码库,在8卡配置下实现每秒261样本吞吐量,较现有框架提速1.5–2.8倍。论文开源代码、模型与基准数据
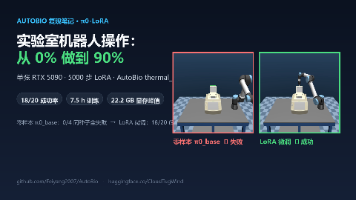
在单张RTX 5090(24GB显存)上,仅用5000步LoRA微调,成功将π0模型在AutoBio基准中“关闭热循环仪盖子”任务的机器人成功率从零样本的0%提升至90%(18/20),训练成本仅为上游全参数微调的1/200。通过修复上游代码缺陷、适配sm_120架构与无头渲染,实现消费级硬件跑通复杂生物实验任务,验证了LoRA在低成本下高效迁移的可行性。
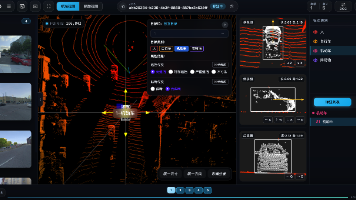
面向自动驾驶与机器人具身智能的点云标注平台,支持目标检测与语义分割,涵盖标注、审核、质检、验收全流程,可配置化管理。具备目标ID跨帧追踪、批注/修复、标签属性灵活配置等功能,助力高效数据标注与算法训练。
并重点弄清楚 Observation、Robot State、Language、Action,以及 Action 为什么还不是电机命令。
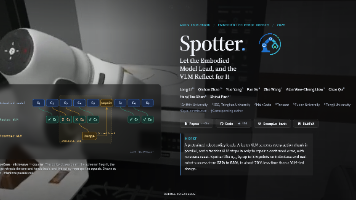
本文解析最新具身智能重磅研究 Spotter。针对传统 VLM-led 串行阻塞、端到端高延迟的痛点,Spotter 提出“小模型主导执行、VLM 异步巡检与关键帧反思”的全新协作范式。框架具备 Training-free(免微调训练)、开箱即用特性,真实机械臂成功率达 83%,执行耗时直降约 70%,代码已全面开源
48个普通MP4用例与图映ImgIng真实分片产物,说明索引位置、范围读取和早期定位如何影响播放。零代码从文件与页面理解等待,区分前置索引、首帧及目标画面。
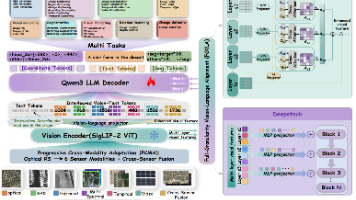
Earth-OneVision提出一种统一多模态遥感大模型架构,通过全粒度视觉语言对齐(FGVLA)、空间语言同构序列化(SLIS)与渐进式跨模态适配(PCMA),实现2B参数模型对6类传感器、9大任务的统一建模。创新性地将中间视觉层特征注入语言模型早期层,并将检测框、掩码等空间结果编码为离散Token,共享自回归解码器。构建3400万条指令数据集,在24个基准上表现媲美4B–72B模型,推动遥感
BUTIANYUN.COM计算机视觉实训软件V1.0,支持300人的大班教学,无需硬件、云服务或编程,零代码可视化操作,仅用本地图片视频素材即可完成人脸识别、手势识别等70项实践。14大技术模块覆盖图像处理到模型部署全流程,离线部署于校内机房,一次性永久授权,低成本适配本科、高职高专院校常态化教学需求。
【IEEE出版、河南省科学院、河南工业大学联合主办】2026年计算机视觉与具身智能国际学术会议(CVEI 2026)
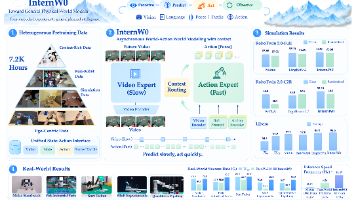
26年9月来自上海AI实验室的论文“InternW0: A Foundational Physical World Model for Efficient Real-World Interactions”。它最有价值的地方,是把视频预测、实时控制、异构数据预训练和接触反馈整合成可执行的机器人系统;但其“通用物理世界模型”定位,仍超出了当前实验充分验证的范围。
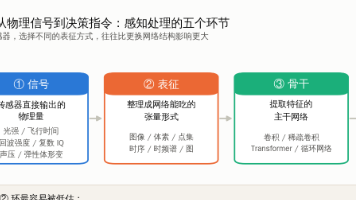
地面移动机器人和车辆的运动本质上是二点五维的——它们在一个近似平面上移动,垂直方向的变化有限。把所有传感器信息都变换到以地面为基准的俯视平面上。俯视图(Bird’s-Eye View,BEV)的好处是具体的。这个空间里尺度是恒定的,不像图像里近大远小;物体不会互相遮挡叠置;多个传感器的数据天然对齐在同一张网格上;而且下游的路径规划本来就在这个平面上工作,不需要额外转换。技术上的关键难点是如何把二维
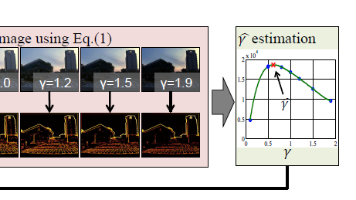
本文提出一种基于梯度信息的相机曝光自动调节方法,针对室外机器人在大动态光照下传统AE易丢失细节的问题。通过最大化图像梯度信息量作为评价目标,结合γ-校正软件仿真与五阶多项式拟合,预测虚拟最优曝光,并采用非对称比例反馈闭环迭代更新快门与增益,优先调节快门以抑制噪声。实验表明,该方法显著提升行人检测与视觉里程计性能,保留更多边缘纹理特征,有效适应复杂光照变化。
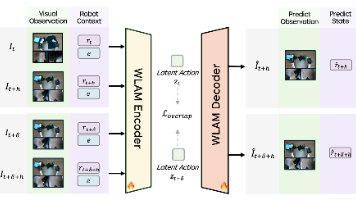
26年9月来自京东集团研究院的论文“WLA³: WORLD LATENT ACTION MODELING FOR SEMANTICS, DYNAMICS, AND KINEMATICS”。这篇论文 WLA³ 的核心价值,是将异构数据中的“状态变化”转化为统一监督,同时用于视觉语言理解、动力学建模和机器人控制。它提供有价值的系统设计和初步实机证据,但尚未充分证明学到跨具身、可干预的通用动作空间。
2026年,边端侧AI加速落地,诚恒微电子发布CH37系列SoC,以7.29平方厘米、7.7克封装集成64 TOPS算力,突破多芯片堆叠带来的延迟、带宽与能耗瓶颈。通过单芯片整合CPU、NPU与ISP,实现低延迟数据交互与多模态融合感知,支撑本地AI推理与自主决策。该芯片赋能智能机器人、无人机等终端,推动云-边-端协同架构发展。嵌入式工程师需掌握集成化编程、多传感器融合与模型部署新技能,迎接端侧智
本课探讨视频扩散模型如何演变为可学习的世界模拟器。纯视频生成模型(如Sora 2)仅凭提示生成视频,而动作条件化世界模型(如Genie 3、GWM-1 Worlds)可通过动作预测未来帧,实现交互式模拟。核心架构采用时空3D分块与旋转位置编码,结合联合注意力机制。该范式已广泛应用于自动驾驶(如NVIDIA Cosmos-Drive)与机器人技术——通过VLM规划、视频模型模拟、逆动力学执行构成闭环
水域非法采砂、非法排污是河湖水域管控、水生态保护、行洪安全保障的核心整治难点,具有隐蔽性强、流动性快、瞬时性高、取证困难、反弹频繁的典型特征。非法采砂极易引发河道岸坡坍塌、河床下沉、行洪通道受阻、水域生态破坏等安全隐患;非法偷排、暗排、间歇排污则直接导致水体污染、水质恶化、水生态系统退化,严重威胁流域水环境安全与水资源永续利用。当前河湖水域执法监管已纳入河湖长制常态化督查、生态环保专项考核、水行政
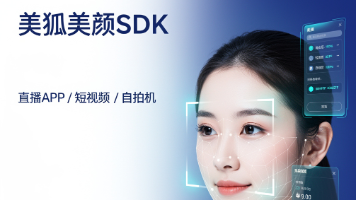
直播APP开发并不是简单的直播推流,而是由音视频采集、编码传输、流媒体分发、实时互动、视频美颜、用户体系、内容审核及后台管理等多个模块共同组成。本文从技术架构角度出发,详细解析直播APP源码与视频美颜SDK如何配合,以及搭建直播平台时需要重点关注的技术环节。
只有将算法、美术、工程优化三者完美结合,才能在移动设备有限的资源下,为用户提供流畅、有趣、逼真的AR互动体验。需要规划合理的渲染管线顺序,通常为先进行美颜处理,再渲染贴纸,最后叠加滤镜,以保证效果的层次感和正确性。这是贴纸能否精准贴合的核心。需要在海量不同型号、不同系统版本的移动设备上进行测试,解决各类兼容性问题和异常场景,确保功能的稳定性和鲁棒性。需明确分辨率、帧率、循环方式等,并为适配不同性能
本文从技术架构、AI算法、人脸识别、跨平台适配与性能优化等多个角度,系统讲解了直播平台如何实现实时美颜功能。文章深入解析美颜SDK的核心架构与实现路径,涵盖GPU渲染、AI人脸识别、动态滤镜、性能优化等关键技术。
本文从技术与产品两方面,深入解析了直播美颜SDK开发中的三大核心功能:实时渲染、动态滤镜和抖动特效。文章详细讲解了GPU实时渲染机制、AI肤色识别算法、动态滤镜LUT切换技术以及抖动特效的算法原理与性能优化方案。
本文从技术与应用两方面深入解析了直播美颜SDK的AI美型核心原理,包括人脸检测、三维特征建模、肤质优化与光效增强等关键环节。通过深度学习与实时图像处理技术,美颜SDK能够在毫秒级内实现自然、智能的美颜效果,为直播、短视频、电商等场景提供更高的用户体验与商业价值。
本文深入解析了2025年美颜SDK开发的新趋势,包括AI实时美颜渲染、虚拟形象融合技术、跨平台适配与个性化算法优化。AI美颜SDK正从传统滤镜时代迈向智能渲染与数字虚拟融合的新阶段。
人像分割作为AI图像处理的重要技术,正在成为直播美颜SDK的核心功能。从虚拟背景到绿幕替换,它不仅能降低主播的布景成本,还能带来更丰富的互动玩法。
美颜sdk是什么?直播美颜sdk特效功能开发实战
本文从技术与体验双维度,深入解析直播美颜SDK中“抖动特效”的开发实践。从算法实现、渲染优化到设计感调校,逐步揭示如何实现一个自然、不突兀的动态抖动效果。
对于开发者和产品经理而言,在选择美颜SDK时,不应只看重其功能的“多”和“强”,更要通过大量真实场景的测试,检验其瘦脸效果的“精”与“自然”。一个真正优秀的美颜SDK,其最高境界是让用户感觉“你好像变了,但又说不出哪里变了”,在悄然提升颜值的同时,守护住那份独一无二的真实与自然。它会识别并保留用户独特的脸部特征,比如有辨识度的颧骨或柔和的下颌角,只是在原有基础上进行微调,使其更符合大众审美,但又不
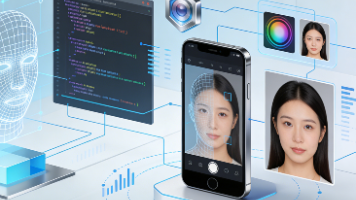
本文系统介绍了直播美颜 SDK 的核心开发流程,包括人脸检测、关键点算法、美型变形、磨皮滤镜到 GPU 渲染的完整架构设计。同时结合实际工程经验分析了性能优化技巧,如轻量模型、人脸追踪、帧率自适应、GPU 并行渲染等,并给出多个代码示例。
港科大突破:普通手机实现好莱坞级HDR视频制作
本文围绕 Android 直播场景,系统解析直播美颜 SDK 的选型思路与开发方案,从美颜效果、性能消耗、实时处理能力到接入成本与商业模式,结合实战经验给出实用建议,帮助开发者与产品团队在直播应用中更高效地落地高质量美颜能力。
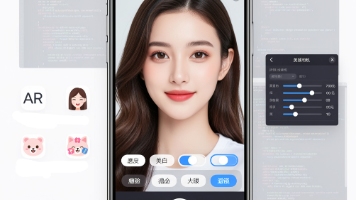
本文介绍了企业级直播美颜SDK与动态贴纸SDK的技术架构与开发方案,并深入探讨了其在直播平台、短视频平台等行业应用中的落地实践。通过分析其核心技术与应用场景。
本文介绍了如何在星图GPU平台自动化部署MogFace人脸检测模型-WebUI镜像,实现高效人脸检测。该方案支持考勤打卡、门禁通行等场景,通过WebUI界面快速处理图像,精准定位人脸及特征点,为美颜SDK等应用提供可靠数据基础,提升业务集成效率。
本文介绍了如何在星图GPU平台上自动化部署MogFace人脸检测模型- WebUI镜像,快速构建高鲁棒性人脸检测服务。该镜像专为真实场景优化,可稳定处理侧脸、戴口罩、暗光等复杂条件,典型应用于人脸识别系统前置检测、活体检测输入准备及美颜SDK驱动等任务。
本文介绍了如何在星图GPU平台上自动化部署MogFace人脸检测模型- WebUI镜像,快速构建高鲁棒性人脸检测服务。该镜像专为真实复杂场景优化,可稳定检测侧脸、戴口罩、逆光等图像,典型应用于企业考勤打卡系统中的人脸数据预处理与标准化裁剪,显著提升后续人脸识别准确率。
直播平台竞争愈加激烈,美颜SDK与滤镜特效的接入已成为提升平台吸引力和用户粘性的关键。本文详细阐述了美颜SDK与滤镜特效的概念与优势,并解析了技术接入过程中的难点与解决方案,同时给出了如何选择适合SDK的建议。
哈哈镜功能正在成为短视频与直播产品的重要互动工具。本文从图像变形算法、网格形变技术、人脸关键点识别到GPU实时渲染机制,系统解析美颜SDK中哈哈镜功能的实现原理,并探讨其在商业场景中的应用价值与未来趋势。适合开发者、产品经理及技术选型人员阅读。
本文介绍了如何在星图GPU平台自动化部署DamoFD人脸检测关键点模型-0.5G镜像,实现高效人脸检测与关键点定位。该模型支持美颜SDK集成、虚拟主播驱动和AR贴纸等应用场景,例如在移动端实现实时AR滤镜贴纸功能,提升交互体验与创作效率。
本文介绍了如何在星图GPU平台上自动化部署🎭 Face3D.ai Pro镜像,快速搭建3D人脸重建服务。该镜像能够从单张照片生成高精度3D人脸模型和4K UV纹理贴图,广泛应用于虚拟角色设计、数字艺术创作等场景,仅需3条命令即可完成部署并支持WebRTC实时预览功能。
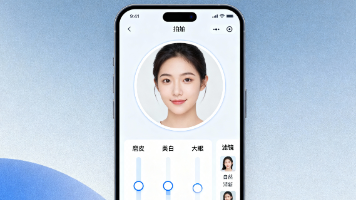
随着直播、电商和社交平台的快速发展,美颜功能逐渐成为直播APP的重要组成部分。本文从用户体验、技术实现和产品竞争力三个角度,深入解析直播APP是否必须做美颜功能,并详细介绍实时美颜SDK的技术原理与实现方式。
在短视频和直播APP中,滤镜、美颜、动态特效已经成为用户体验的重要组成部分。那么这些效果究竟是如何实现的?本文从技术角度解析短视频美颜的核心原理,包括人脸检测、关键点定位、实时磨皮、瘦脸算法、GPU滤镜渲染以及AR特效实现方式。
在直播、短视频和社交应用中,实时美颜滤镜已经成为核心功能,但不少开发者在接入美颜功能时会遇到画面卡顿、掉帧、发热严重等问题。本文从技术角度分析实时美颜卡顿的原因,并分享美颜SDK在GPU加速、人脸检测优化、多线程架构和算法轻量化方面的优化方案。
随着直播、短视频和社交应用的快速发展,实时美颜和面具特效已经成为APP的核心功能之一。本文将从技术角度解析面具特效的实现原理,包括人脸检测、人脸关键点识别、实时图像处理以及AR特效渲染等核心技术。
本文介绍了如何在星图GPU平台上自动化部署MogFace人脸检测模型- WebUI镜像,快速搭建人脸检测服务。该模型具备高精度与实时处理能力,其WebUI界面支持零代码操作,可广泛应用于图片内容审核、自动人脸打码等隐私保护场景,有效提升处理效率。
计算机视觉
——计算机视觉
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 DAMO开发者矩阵


 HarmonyOS开发者社区





 EazyDevelop社区



 AtomGit AI 社区

 火山引擎视频云技术社区