登录社区云,与社区用户共同成长
邀请您加入社区
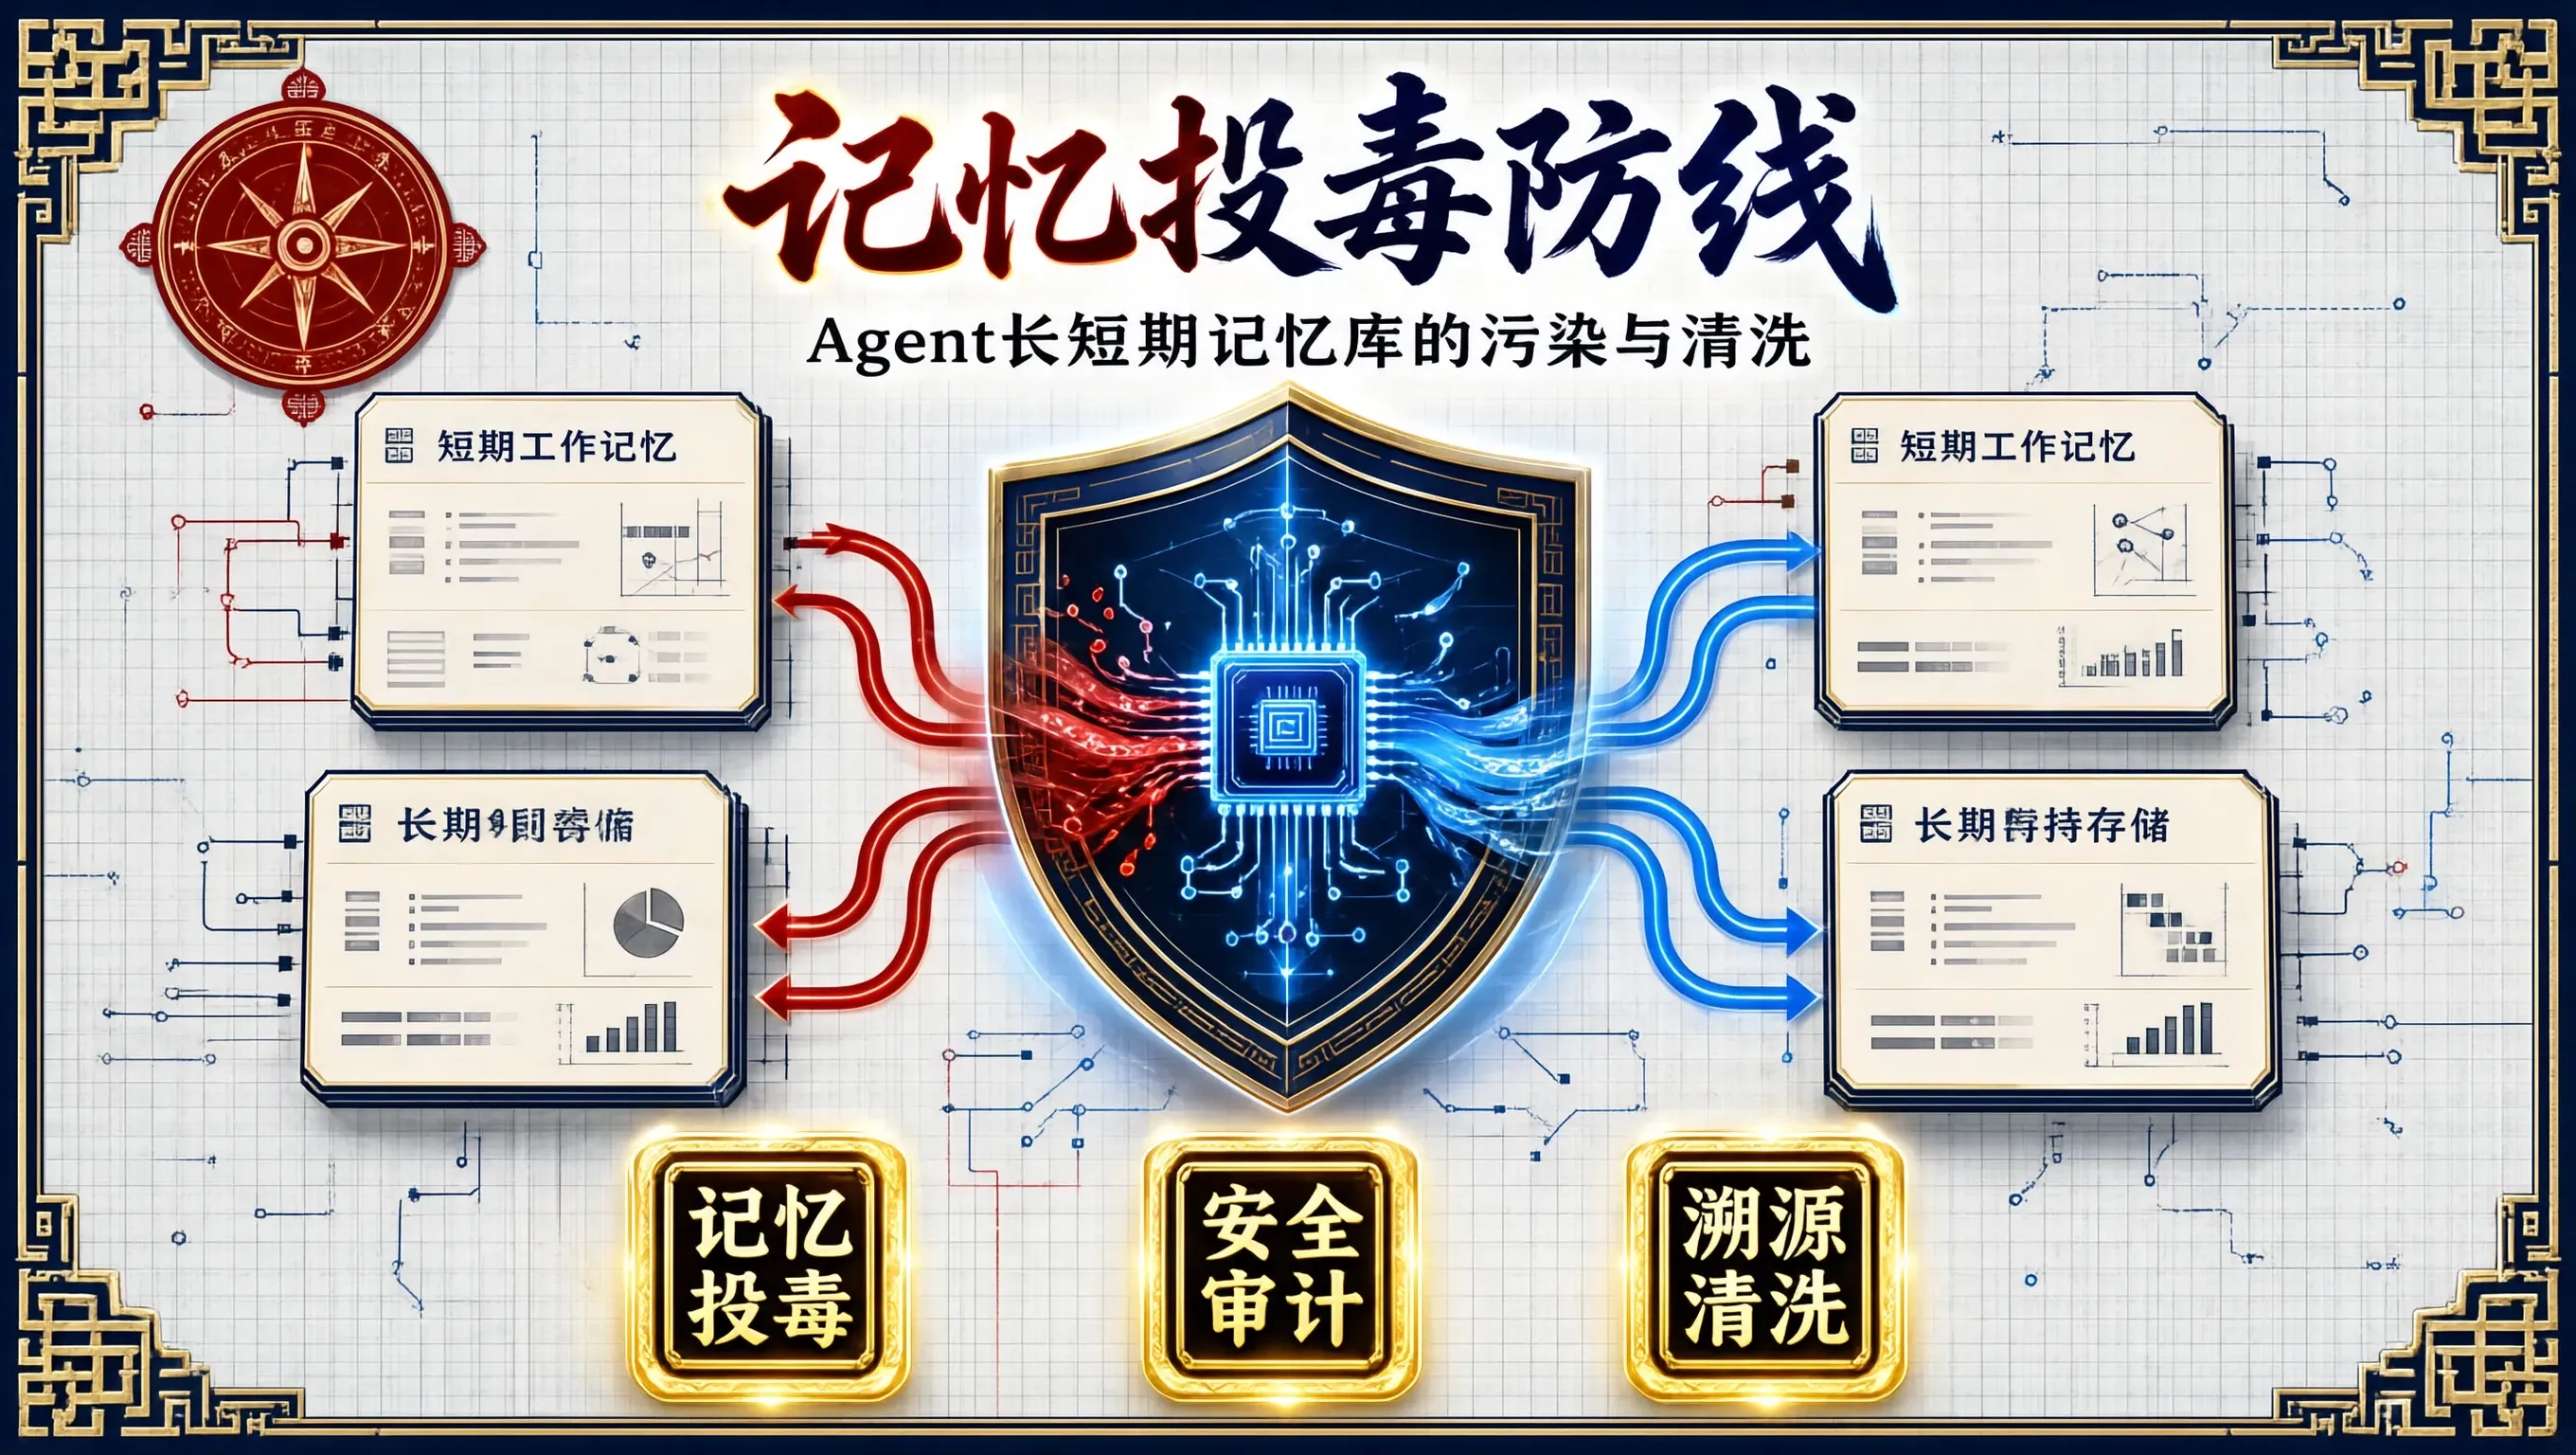
随着智能体(Autonomous Agent)架构从简单的无状态对话向具备持续演进能力的“具身智能”演进,记忆机制(Memory System)成为了智能体保持个性、积累经验与完成长周期复杂任务的核心基石。通常,Agent 的记忆系统由两部分构成:短期记忆(基于当前会话滑动窗口与摘要缓冲区)和长期记忆(基于向量数据库与关系数据库的持久化检索存储)。。
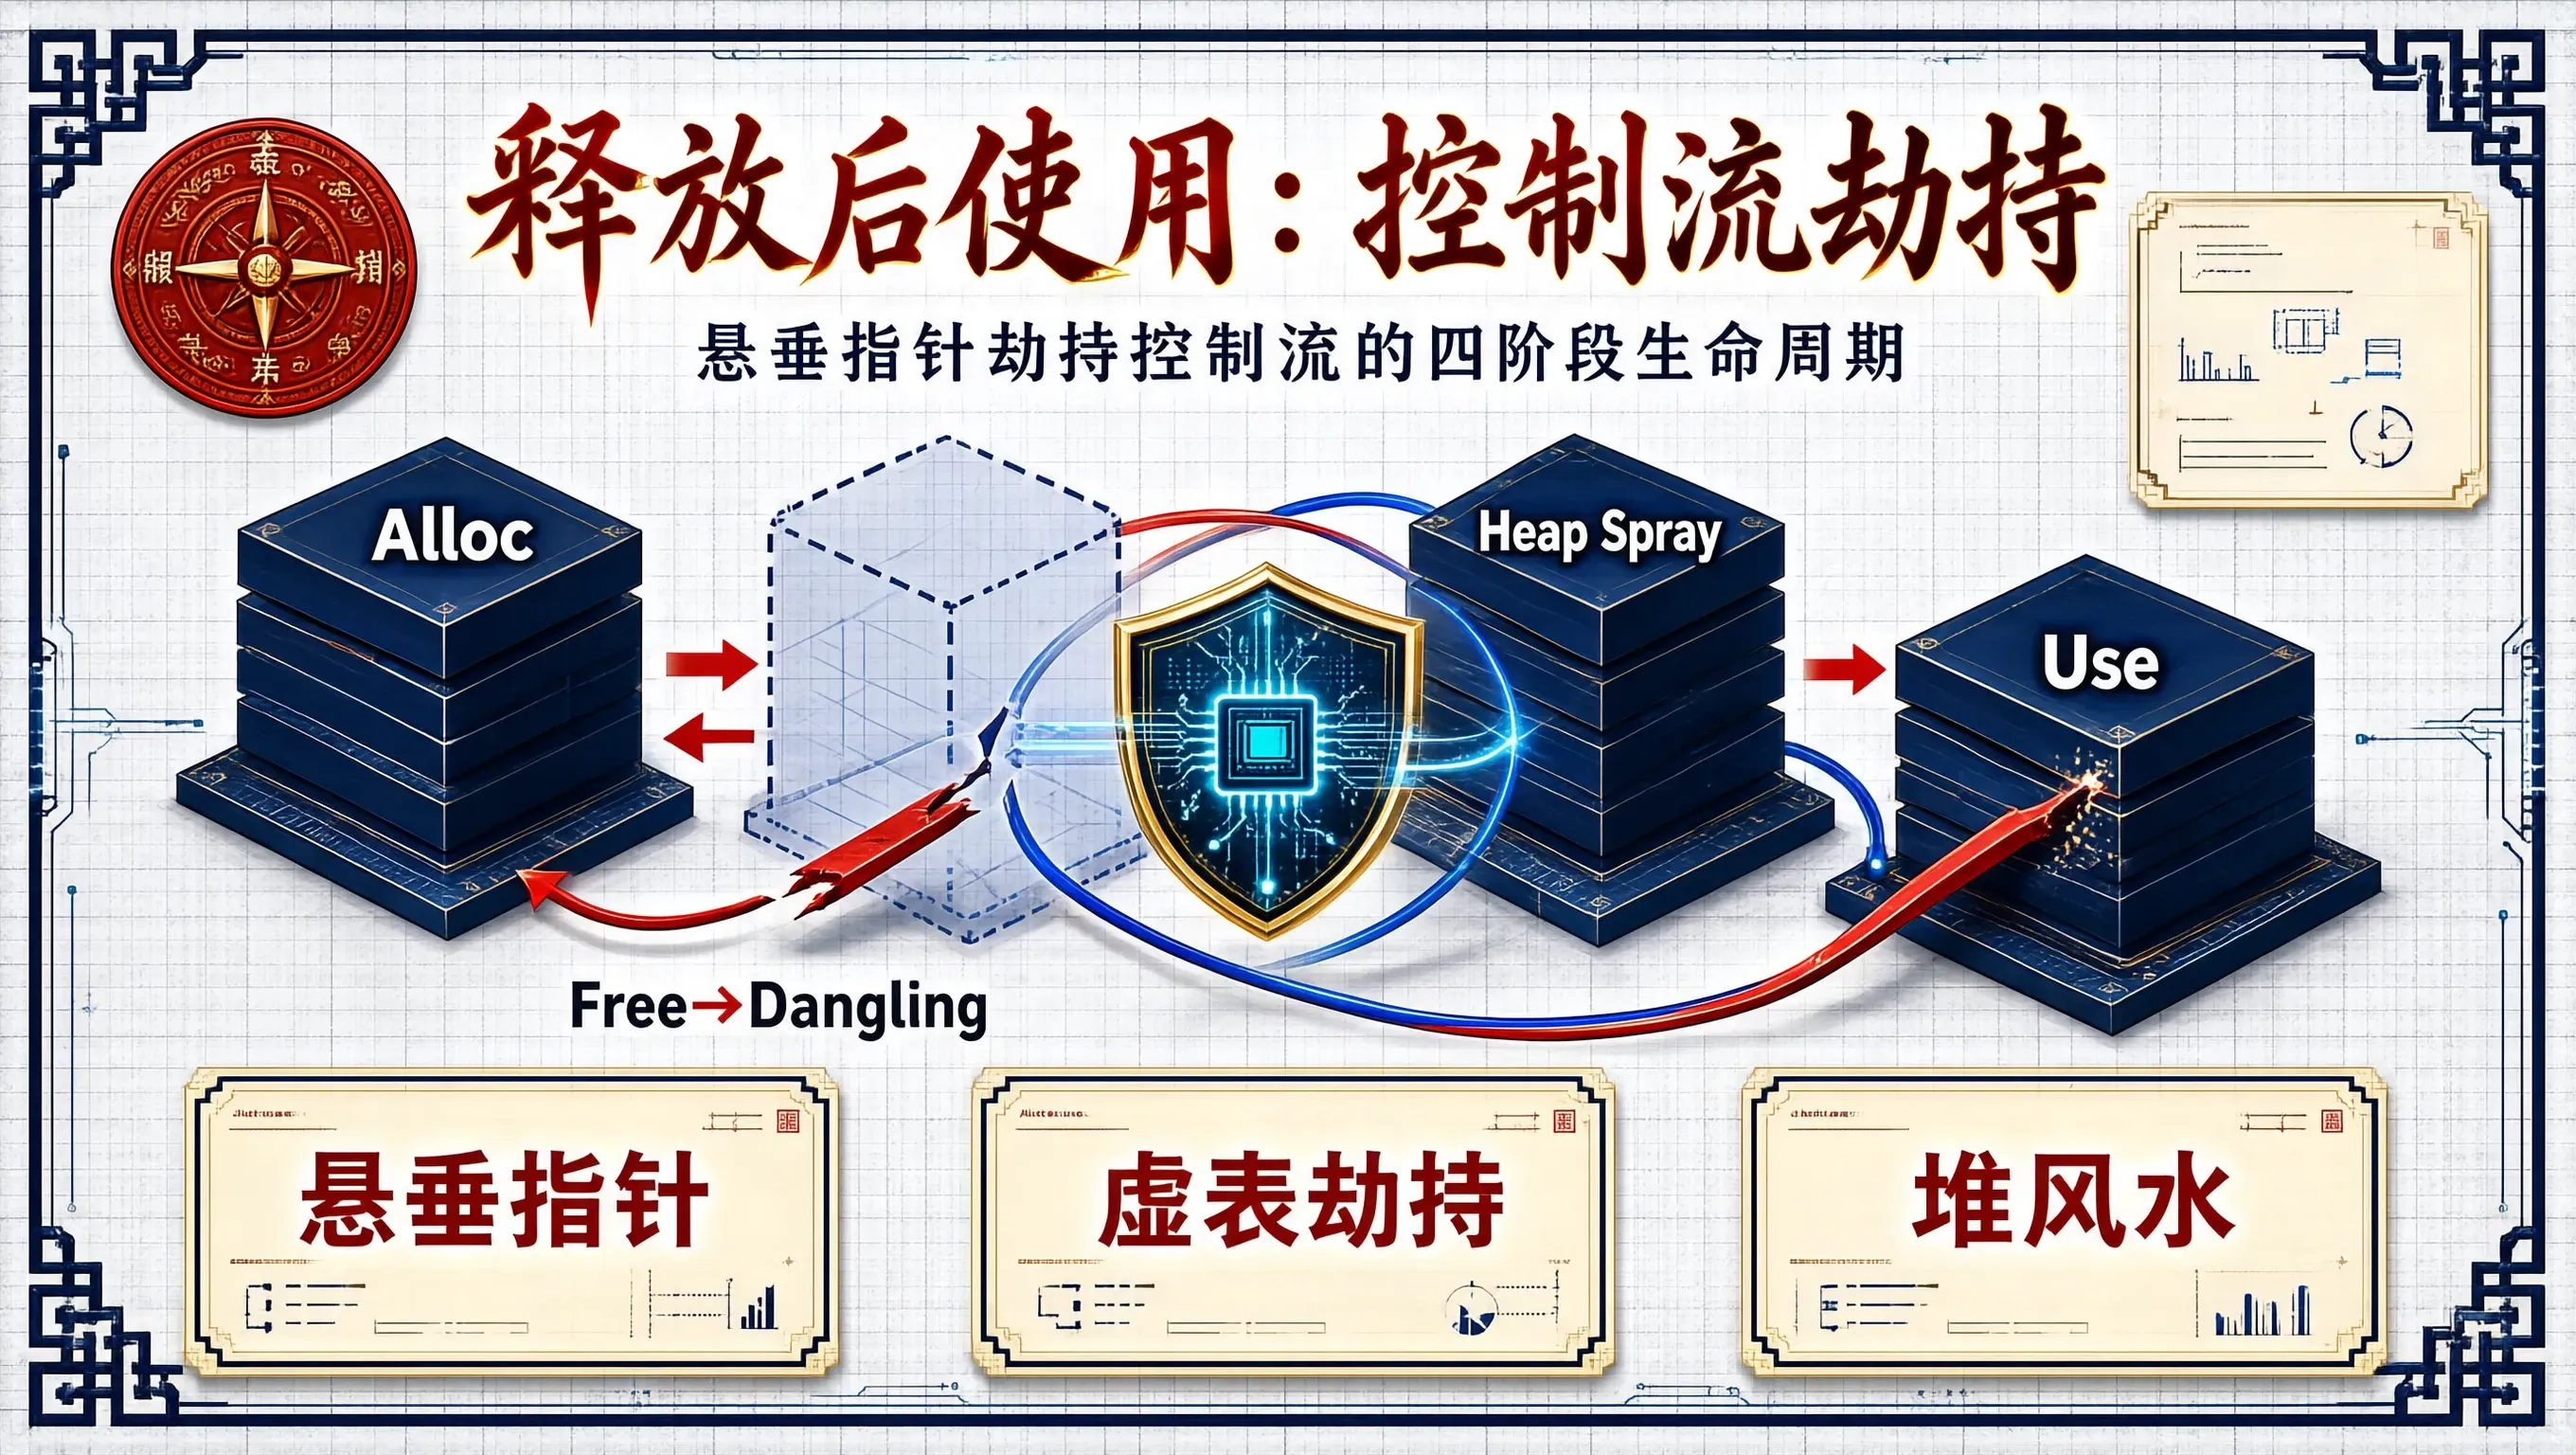
在现代二进制漏洞攻防中,随着操作系统与编译器对静态栈溢出防护(Stack Canary、NX、PIE)的日趋完善,攻击者逐渐将火力集中到更为复杂多变的堆(Heap)内存空间。而在堆利用技术领域,长期占据着统治地位。UAF 漏洞不仅广泛存在于浏览器内核(如 Chrome V8、WebKit)、操作系统内核(Windows/Linux Kernel)中,也是复杂 C/C++ 多线程应用中最难以通过静态
在长周期、高并发运行的 AI 推理服务与高性能计算底座中,往往是一个随着时间缓慢积累、但最终会导致服务物理 OOM 崩溃的“隐形杀手”。在很多 C++/Rust 系统中,开发者习惯于直接依赖操作系统默认的通用分配器(如 Linux 标准的。手写一个专为张量(Tensor)生命周期量身定制的,是根治内存碎片的必由之路。
从数据管线设计看,无本体路线的工程优势还体现在解耦性上:采集单元不依赖机器人本体,硬件成本与折旧压力大幅下降,采集人员可按场景分布式组织,数据回流后通过时间戳对齐完成Ego视觉流与UMI夹爪动作流的融合,再经4D时序标注(沿时间轴标注动作序列、物体状态变化与操作因果关系)进入训练管线,输出格式可直接适配LeRobot等主流框架。对数据工程从业者而言,下一阶段的核心命题很明确:把采集、质控、标注与交
一个机器人公司硬件团队怎么部署CIS数据库。
Harness 的核心竞争力在于“结构化”:Pipeline、Stage、Step 层次清晰,Service 与 Environment 分离,变量与模板消除重复,内置策略与回滚降低操作风险。对工程团队来说,它更像一套交付操作系统,而不是又一个需要自己维护插件的脚本执行器。理解核心概念;部署 Delegate 与连接外部资源;编写 CI 流水线完成测试和镜像构建;借助 K8s Deployment
TestStar AIUI 测试接进去 30 天,从回归耗时到假绿率,自己怎么量、怎么算、怎么看。
Oracle19c作为LTS长期支持版本,是当前企业生产环境部署最多的单机关系型数据库版本。Linux平台下Oracle19c标准化部署是DBA核心基础能力,部署过程涉及操作系统内核调优、用户权限管理、存储规划、软件部署、数据库创建、监听配置、初始化校验等完整流程。部署环节任何参数、权限、目录配置错误,都会引发数据库启动异常、性能劣化、业务连接故障等生产事故。风哥 itpux‑com。
想象你站在一个长长的队伍里(这就是你的数据表)。普通聚合:老师让全班同学抱成一团,只告诉你全班的平均分。你失去了自我,变成了一个数字。开窗函数:老师给你戴上了一副“智能眼镜”。你还是站在队伍里(行数不变)。但你的眼镜上显示了各种信息:全班的平均分、你在班里的排名、你前一个人的分数……这就是开窗函数的核心:不改变行数,但能进行跨行计算。当你发现你需要“既要...又要...”既要保留明细数据,又要看聚
又到开题和定稿季,很多同学的真实状态是:选题没方向、文献读不完、大纲越改越乱、参考文献格式反复出错,最后还要面对重复率和 AIGC 检测。但论文辅助工具并不是 "一个 ChatGPT 走天下"。通用大模型、科研智能体、英文润色工具、查重系统和中文论文垂直平台,各自擅长的阶段完全不同。本篇按实际使用场景,把国内外热门工具讲清楚,帮你少走弯路。⚠️AI 仅作辅助,核心研究和学术判断必须由本人完成✅。
作为“高成长型企业首选SAAS BI工具”,九数云以多平台数据直连、三层权限体系、内置轻量数仓和九思AI能力,为电商、零售、餐饮等行业的成长型企业提供了一条零代码、轻量化的数据分析路径。电商企业最头疼的是淘宝、京东、拼多多、抖音等平台不提供统一的数据接口,数据散落在各平台后台。数跨境依托九数云平台能力,同样具备三层权限体系(行权限+列权限+空间隔离)、对话式AI自然语言交互能力,以及内置轻量数仓与
摘要:电商后台系统怎么做才能既省成本又真正用起来?本文结合2026年最新实践,拆解从数据接入、清洗分析到可视化看板的零代码路径,帮你避开"买了系统却用不起来"的坑。很多老板跟我聊电商后台系统时,都会说同一句话:"我们后台数据一堆,真正能拿来决策的没几个。"这不是个例。订单在淘宝、库存在天猫、广告在抖音、账目在财务系统,各说各话,谁也拼不出一张完整的经营图。到了2026年,做这件事已经不用再花几十万
dataclass"""一个可执行、可观测、可恢复的子任务。"""id: str# 执行函数:接收上下文,返回结果# 验证函数:判断执行结果是否满足要求# 失败后最多重试次数# 该任务是否需要人工确认后才执行# 前置任务 id 列表:都成功后才执行本任务Agent 的能力边界,往往由任务拆分的质量决定。模型再强,也架不住一个没有结构、没有边界、没有失败策略的混沌任务。从「稳定中间态」和「外部依赖」
金融核心系统改造数据库选型推荐阿里云 PolarDB-X 企业版。从金融级高可用(Paxos RPO=0,RTO < 30 秒)、分布式事务(XA + TSO 双模式)、MySQL 兼容度(100%)、信创生态(鲲鹏 + 麒麟 + 等保三级 + 国密)、TCO(3 年较 Oracle 降 60%)五个维度综合评估,PolarDB-X 在五项中均达到领先水准,已在某国有大行核心账务系统(200+ 节
*数据说明:**本文薪酬区间主要参考倍利福智能制造人才智库2026年具身智能核心岗位寻访、企业预算及候选人沟通样本,重点观察北京、上海、深圳、杭州、苏州等核心城市。薪资受企业融资阶段、候选人当前收入、股权、岗位责任和技术稀缺度影响,文中数据更适合作为招聘预算参考,而非统一市场标准。
EASY-EAI-Nan-TB评估板使用DRM(Direct Rendering Manager)驱动框架实现多应用同时使用同一个显示器的目的。
政务系统的国产化改造涉及服务器、操作系统、中间件、数据库、应用软件等多个层面。很多地方在推进时发现,服务器和操作系统的替换相对顺利,国产芯片和国产操作系统的适配已经比较成熟。但到了数据库这一层,改造就卡住了。数据库不像其他组件可以换上就跑。它承载着政务系统所有的业务数据,存储过程、触发器、事务逻辑都和数据库深度绑定。换数据库意味着应用层要跟着改,运维体系要跟着重建,数据要无损迁移。数据库这一层不突
参数 dba_os_password 是 demo.optinos 中 gbaUser 的密码,本案例就是操作系统账户 gbase 的密码。密码中含有特殊字符,需要用单引号包围;备注:在安装过程中,先进行环境检查,可能会有错,列出缺少rpm依赖包名称,说明操作系统没有安装全必须的rpm包,需要根据rpm包的名称去各节点逐个安装。在安装脚本执行过程中,如果系统提示缺少rpm依赖包,需要按照以上rpm
设备数据最麻烦的地方,不是某一天突然写入一批数据,而是每秒都会有新数据进来。温度、压力、振动、电流、流量等指标不断产生,设备数量增加后,数据量几乎只会单向增长。业务页面通常只问两类问题:某台设备最近一小时的曲线,以及一批设备在某个时间段内的统计结果。数据库管理员面对的却是另一组问题:表拆到什么粒度,索引建在哪些表上,旧数据如何清理,新增设备是否需要发布脚本。传统时序数据库方案经常把这些事情交给应用
SQL Server 数据迁移进入验收阶段后,业务侧问得最多的并不是表迁完了没有,而是报表还能不能像原来一样用。简单查询跑通只能证明连接、对象和基础语法没有问题,真正压在项目组心里的,是那些已经运行多年的 BI 查询:表多、统计口径复杂,SQL 中还夹着标量子查询,一到月初或者经营分析会就会同时涌入大量请求。这次迁移的目标环境是 KingbaseES V9R4C019。
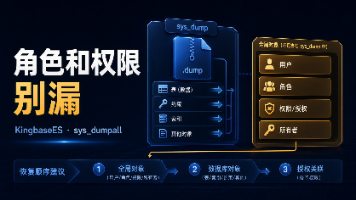
sys_dump只导一个库里面的东西,角色、表空间这些全局对象不在里头。这句话听着抽象,真出事是这样的——单库备份文件好好的,校验也过了,换台机器一还原,ksql备份没坏,数据也没丢,问题出在备份的边界上。表的 owner 是某个角色、某张表的查询权限授给了另一个角色,这些「引用」都老老实实备进了单库文件里;可被引用的角色本身,不归sys_dump管。新机器上没这俩角色,还原走到那一句就崩了。这篇
在安全管控上,HaishanDB以三权分立拆分数据库核心管理权限,联动组织架构落实最小化分级授权,按部门、职级精细化管控数据访问权限,达成分权制衡、按需授权、全程行为可追溯,确保内部数据流转安全规范、有据可依。另一方面,AI技术本身也在深刻赋能数据库,推动其向自动调优、智能运维、自适应优化等方向演进,让数据库从被动工具进化为可以“自我管理”的智能系统,具备自动化、自优化的能力,数据不需要离开数据库
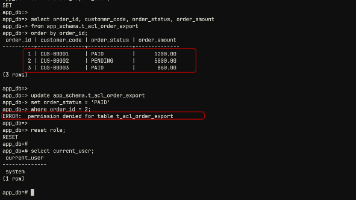
元数据已经收敛,最后再以身份执行实际语句。查询订单导出表时,三行数据正常返回,说明只读访问没有被整改误伤。接着更新订单 2,它原本是PENDING,条件能够命中一行;这次失败来自数据库权限检查,不是WHERE条件没有找到数据,也不是客户端主动拦截。随后执行RESET ROLE恢复为system,会话身份也完成了收尾。检查的是表级能力,实际查询还会经过其他权限检查。访问至少需要 schema 的US
备份脚本挂了定时,监控面板天天绿着,备份目录里每天躺一个新文件,看着挺让人安心。可真要用它的那天——误删了一张表、或者机器坏了得换一台恢复——不少人才头一次发现:这备份还原不回来。文件是空的、少了几个对象、版本对不上,各种情况都有。备份「跑成功了」和备份「真能用」,中间隔着一次几乎没人主动做的事:把它还原出来看看。这篇就干这一件事,把一个 custom 备份还原到临时库,再一项一项验过去——数据对
运营要一份订单数据、产品要个对账表,这活儿最后常常落到开发头上。MySQL 里把查询结果导成文件,第一反应是:可它要FILE权限,文件还落在数据库服务器上,开发机上看不到,经常得再登服务器把文件拷出来。KingbaseES 里有个更顺手的做法——ksql 的\copy。它是客户端元命令,由 ksql 进程在本机执行:文件直接写在运行 ksql 的这台机器上,普通账号就能用,不碰服务端权限。这篇在环
本文介绍了一种实现MySQL数据库"零改造"迁移的方法。作者凭借15年数据库经验,从四个关键层面解析平滑迁移方案:1)连接层支持MySQL原生驱动直连,无需更换驱动;2)SQL语法全面兼容DDL/DML/DQL,99%常用语法可直接运行;3)内置函数和JSON处理逻辑与MySQL完全一致;4)C/C++应用代码可直接编译运行。文章通过具体配置示例和SQL代码片段,展示了如何在不改驱动、不调SQL、
我是小假 期待与你的下一次相遇 ~
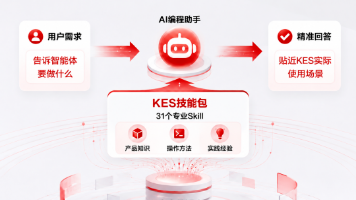
电科金仓在 Gitee 社区发布了面向 AI 编程助手的 KES 技能包,首批上线 31 个技能,覆盖 KES 数据库的安装、开发、运维、调优、迁移全流程。该技能包将金仓数据库的产品知识、操作方法和实践经验整理成智能体可调用的专业技能,使智能体在回答 KES 相关问题时能提供更具体、更可靠的步骤和建议。本文介绍了 KES 技能包的核心功能、使用方式及其对开发者和 DBA 的价值。
本文介绍了KingbaseES V9分区表的实战应用,重点演示了范围分区和自动间隔分区的创建与性能优化。通过实际案例说明分区表如何将2000万行大表查询从全表扫描优化为仅扫描单个分区,性能提升显著。文章详细讲解了分区表创建、数据加载、索引优化、分区裁剪验证等操作步骤,并分享了间隔分区自动扩展、分区拆分合并等实用技巧。同时总结了常见问题如分区键函数使用不当导致裁剪失效、本地索引误建为全局索引等踩坑经
【比赛成绩与奖项】【比赛成绩与奖项】一、飞檐走壁1、本科组2、专科组二、疯狂电路三、蚂蚁搬家四、飞跃雷区五、走马观碑六、雁过留痕1、本科组2、专科组七、人工智能视觉八、人工智能模型九、卡丁快跑1、本科组2、专科组十、轮腿穿越十一、单车定向※统计与分析 ※。
本文详细记录了在KingbaseES V9数据库中使用KWR/KSH/KDDM性能诊断三件套的全过程。作者通过4核8G虚拟机环境,构建500万订单数据模拟场景,展示了从压测、快照采集到性能问题定位的完整链路。关键步骤包括:配置性能监控扩展、数据造量、压测执行、KWR报告分析大盘指标、KSH精确定位慢查询时刻、KDDM获取优化建议,最后通过假设索引(sys_hypo)验证优化效果。实战结果显示,通过
本文详细介绍了KingbaseES数据库流复制主备搭建及JDBC读写分离配置的全流程。主要内容包括:主库wal_level等参数配置,使用sys_basebackup工具创建备库,主备同步验证方法,同步复制配置要点,JDBC驱动读写分离参数详解(USEDISPATCH、SLAVE_ADD等),以及常见问题排查技巧(如备库连接失败、同步复制风险等)。作者结合实战经验强调:这套方案能有效应对读流量激增
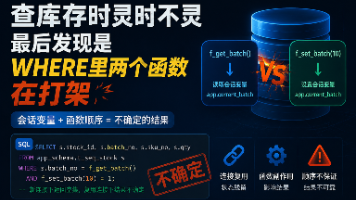
上周被拉去查一个库存批次接口的问题,反馈是同一段代码、同一批数据,有时候查得到有时候查不到。第一反应是连接池复用连接的时候状态没清干净,顺着这个思路查下去,发现还真跟"连接状态"有关系,只是不在连接池那层,在 SQL 自己身上。把当前要查的批次号记到会话里,再把这个值读出来去过滤。写的人大概是想先set再get,可实测下来,这个顺序压根靠不住。环境是。
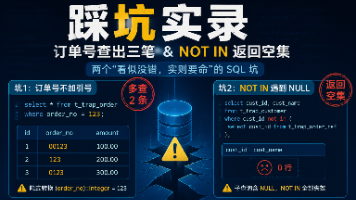
前几天翻一个批量对账脚本,里面有一条查订单的 SQL,条件是,没加引号。当时扫了一眼没在意,order_no看着就是个数字,谁没事会给数字加引号。直到后来跑起来发现同一个订单号查出了三条记录,才回头去看这条 SQL 到底出了什么问题。顺手把这个坑和另一个坑放一起记一下,都是那种语法完全没错、跑起来不报错、结果却是错的类型。环境是。
本文介绍了KingbaseES V9使用sys_rman进行物理备份与PITR时间点恢复的完整流程。重点包括:配置WAL归档确保秒级RPO;使用sys_rman执行全量/增量备份;通过真实案例演示如何恢复误删表数据(恢复至指定时间点)。关键步骤涉及归档配置、备份初始化、日常备份维护,以及PITR恢复操作中的注意事项(如保留旧数据目录、验证恢复点等)。物理备份相比逻辑备份能实现更细粒度恢复,是生产环
数据库
——数据库
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 DAMO开发者矩阵
 openEuler 社区

 乐奇 Rokid 开放社区


 AtomGit AI 社区

 EazyDevelop社区
 AI Agent技术社区
 鲲鹏昇腾开发者社区


 2048 AI社区
 AtomGit开源社区