登录社区云,与社区用户共同成长
邀请您加入社区
摘要:TVA(Transformer视觉智能体)构建了三级应用体系,实现从基础视觉到全域智能的进阶。初级AI视觉检测实现工业场景微米级高精度检测;中级机器人视觉与灵巧控制突破动态环境适配难题,支持柔性装配等复杂任务;高级应用作为具身智能核心引擎,支撑多模态数据处理与自主决策。三级体系层层递进,形成技术闭环:基础能力支撑高阶应用,高级功能反哺底层优化,实现从单点技术突破到全产业赋能的梯度价值,为工业
摘要:传统机器学习在视觉领域存在感知与行动割裂、数据与物理脱节等瓶颈。基于科学机器学习(SciML)的Transformer视觉智能体(TVA)突破这一局限,融合物理规则与数据学习,构建"感知-推理-决策-操作-反馈"闭环系统,实现从被动识别到主动行动的范式跃迁。TVA通过多模态序列建模和物理先验约束,显著提升泛化能力和自主决策水平,推动具身智能在工业等场景的规模化落地,完成A
TVA通过Transformer注意力机制、因式智能体理论、科学机器学习和闭环强化学习四大跨学科理论的深度融合,构建了独特的具身智能技术壁垒。该体系实现了全局动态感知、因果逻辑推理、物理规则约束和自主持续进化,突破了传统视觉技术的局限,可精准适配机器人导航、工业操控等高精度场景需求。这种多技术协同的创新架构,有效解决了行业同质化竞争问题,为具身智能的产业化落地提供了完备的技术支撑。
TVA智能体突破传统视觉智能技术局限,成为具身智能新一代核心范式。相较于CNN的静态感知、VLA的数据拟合和世界模型的虚实割裂,TVA通过Transformer全局时序建模实现动态场景理解,融合因果推理突破语义拟合局限,构建实景闭环学习机制消除虚实差异。其四大核心优势——全局动态感知、物理因果认知、轻量化落地和自主进化能力,完美解决高阶具身智能在动态交互、因果理解、实景适配和持续迭代等维度的关键需
TVA智能体突破传统具身智能技术瓶颈,通过Transformer全局建模、因式智能体理论、科学机器学习和闭环强化学习的融合,构建"感知-推理-决策-执行-反馈-进化"的全链路闭环架构。相较于传统CNN静态感知和VLA数据拟合方法,TVA实现了动态场景理解、因果推理和虚实融合,解决了泛化能力差、迁移成本高等问题。该技术使智能体具备主动感知、自主决策和持续进化能力,可适配工业智造、
摘要:随着ChatGPT4等大模型及人形机器人的兴起,“具身智能”成为热点话题。本文探讨其本质,指出当前主流观点存在局限,如简单将“AI+机器人”或“人形躯体”等同于具身智能。通过追溯具身认知的哲学源头和生物智能的渐进性,提出具身智能的核心是主体通过与环境交互建构动态认知模型,强调重构映射、交互建构和通道约束三大要素。文章认为具身智能是智能科学的新范式,需突破视觉底层技术以实现物理与信息空间的唯一
本课题主要使用了pycharm和MySQL数据库来作为设计的工具,并使用python作为开发语言,主要运用了Django框架技术,python是一种面向对象的编程语言,很容易学习而且使用方便。在大学时,我就已经掌握了python的主要知识,也对Django框架的操作进行了系统的学习。本系统从整体上看设计起来比较容易,本系统开发的要点就是对于数据库的设计及操作。在大学对软件工程,软件测试,UML统一
本系统主要分为两大角色:普通用户和管理员。普通用户可以通过登录注册、个性化推荐、视频浏览、评论管理等功能,享受便捷的在线视频观看体验。用户在注册时选择兴趣标签,系统根据标签推荐符合其兴趣的视频内容。同时,用户还可以查看视频资讯、管理个人账户信息、收藏视频等。管理员通过后台管理系统对平台的用户、视频、视频分类、轮播图、公告及资讯进行管理,支持视频资源的增删改查、视频推荐管理、视频类型管理、通知公告发
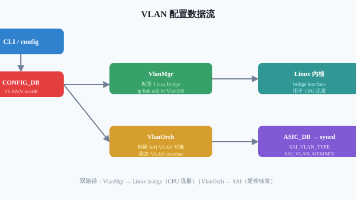
本文详解SONiC中VLAN管理的实现机制,涵盖VLAN的逻辑隔离、数据模型(VLAN/VLAN_MEMBER/VLAN_INTERFACE表)、Linux内核层(VlanMgr)与硬件层(VlanOrch)的分工。通过VLAN-aware bridge模式提升性能,区分Access与Trunk端口的tag处理方式,并阐述配置从CONFIG_DB到ASIC硬件的完整数据流。最后提及VLAN与STP
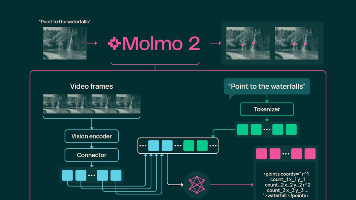
如果说 Molmo 让 AI 学会了“在图片里指东西”,那么 Molmo 2 则让 AI 学会了“在视频里追踪事件、定位动作、数清次数”——真正实现时空联合理解。2025 年 12 月 11 日,艾伦人工智能研究所(AI2)正式发布—— 一款专为而生的下一代开源多模态大模型。它不仅在多项权威评测中超越 Gemini 3 Pro、GPT-5 等闭源系统,更首次将带入开源社区。
《突破显存限制:修复ComfyUI SeedVR2视频超分CUDA报错实战》摘要:针对ComfyUI SeedVR2视频超分时常见的CUDA显存溢出问题,本文提供了有效解决方案。通过分析发现,VAE解码阶段(而非采样阶段)是显存消耗的瓶颈。解决方法只需修改插件代码中的decode_tiled参数默认值为True,并适当调整分块尺寸(建议256),即可显著降低显存峰值(如从23.5GB降至14GB)
本方案展示了从零开始搭建一套轻量级 WebrTC 通信系统的全过程,涵盖信令中转、媒体协商、iCE 协议交互等关键技术点。对于需要高度定制化、低成本部署的实时通信场景(如在线教育、远程医疗、企业内部协作),这套架构具有极强实用性。将上述代码整合为微服务模块(Express + Socket.IO + RTCPeerConnection)添加 JWT 认证、房间管理、日志记录等功能部署至 Docke
后端采用Python+Django/Flask框架,前端使用微信小程序原生开发。数据库选择MySQL或MongoDB存储视频元数据,视频文件存储使用云服务(如阿里云OSS)或自建CDN。对于本系统,我们提供全方位的支持,包括修改时间和标题,以及完整的安装、部署、运行和调试服务,确保系统能在你的电脑上顺利运行。使用Redis缓存热门视频列表,MySQL存储用户播放记录和偏好数据。视频上传模块:支持M
文章摘要:针对短剧出海团队寻找MiniMax替代方案的需求,分析指出替代动机主要分为TTS配额限制和全链路译制需求两类。MiniMax作为TTS引擎仅覆盖语音合成环节,替代方案可分为三类:1)仅替换TTS引擎(如ElevenLabs等);2)采用全链路本地化平台(集成字幕提取到压制全流程);3)部分环节替代。选择取决于团队研发能力、产量规模和多语种需求,需综合评估成本与协调成本。决策框架建议先识别
把用户的猜测写成事实;漏掉已执行动作;把未确认身份写成已验证;混淆订单、金额和时间;忽略失败的工具调用。确定性字段 + 可选的 LLM 摘要身份验证状态订单号已执行动作待执行动作权限状态工具调用结果转人工原因码LLM 只负责生成便于人工阅读的,输出后还要经过结构校验和字段白名单。LLM 推断ASR 原文数据库工具调用用户确认人工修改身份状态、订单状态和已执行动作不能只靠 LLM 推断。不建议。大模
本文记录了一套把AI短剧制作6个环节(项目创建→剧本生成→分镜拆解→逐镜生图→逐镜生视频→剪辑导出)串联成一条工作流的系统设计思路。针对传统AI短剧制作中工具链断裂、数据割裂的问题,给出了基于分镜数据结构化存储的链路衔接方案。重点讨论了"首帧图→图生视频"生成策略相比纯文生视频在可控性上的优势,以及AI模型接入层抽象、单镜粒度版本管理、并发任务队列等关键技术决策。最后分享了实际开发中的踩坑经验,包
多平台直播推流调度系统架构:从单路到多路分发
本文介绍了传统M3U8调试方法的痛点,并推荐了一款在线流媒体调试工具。传统方法存在环境搭建复杂、问题定位困难、测试条件受限等问题。而这款网页工具具备M3U8解析、播放预览、自定义请求头等功能,能快速定位直播/点播流媒体问题,降低调试门槛。文章列举了该工具在直播故障排查、转码校验等场景的应用,强调其能有效提升流媒体业务的排错效率。工具无需安装,通过浏览器即可使用,适合开发、测试、运维人员使用。
摘要 本文探讨了Python与FFmpeg结合构建高效音视频处理流水线的技术方案。针对现代互联网应用中视频处理的典型痛点(编码兼容性、CPU消耗、IO瓶颈和实时性要求),提出了分层架构设计: 底层采用FFmpeg/FFprobe处理核心编解码 控制层使用Python封装处理逻辑 通过Celery+Redis实现异步任务调度 结合对象存储和CDN优化资源管理 核心代码展示了视频元数据获取和转码功能的
本文分析了传统M3U8调试方式的痛点,包括本地播放器功能有限、自建测试页面耗时、FFmpeg门槛高等问题。介绍了在线工具m3u8live.cn的核心功能:支持加密流播放、自定义请求头、M3U8解析和错误日志输出。通过四个实际业务场景(转码接口测试、卡顿排查、加密流验证、CDN缓存调试)展示了该工具如何简化调试流程。该工具无需安装、跨平台使用,能快速定位问题,显著提高开发、测试和运维人员的工作效率,
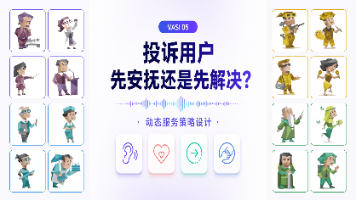
用户说:“别再解释规则了,我只想知道这笔重复扣款什么时候退。这时再追加一段长篇安抚,往往会让投诉升级。可系统如果跳过确认,直接说“会尽快处理”,又可能把未核实的订单、时效和权限说成了承诺。真正要解决的不是“先共情还是先解决”,而是:这通电话现在是否具备安全推进的条件;不具备时,该把哪些事实交给人工。我不建议把这个判断交给“用户情绪类型”或音高、音量之类的特征。对投诉场景更可靠的输入,是用户明确提出
python
——python
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 DAMO开发者矩阵
 AtomGit AI 社区
 火山引擎视频云技术社区