登录社区云,与社区用户共同成长
邀请您加入社区
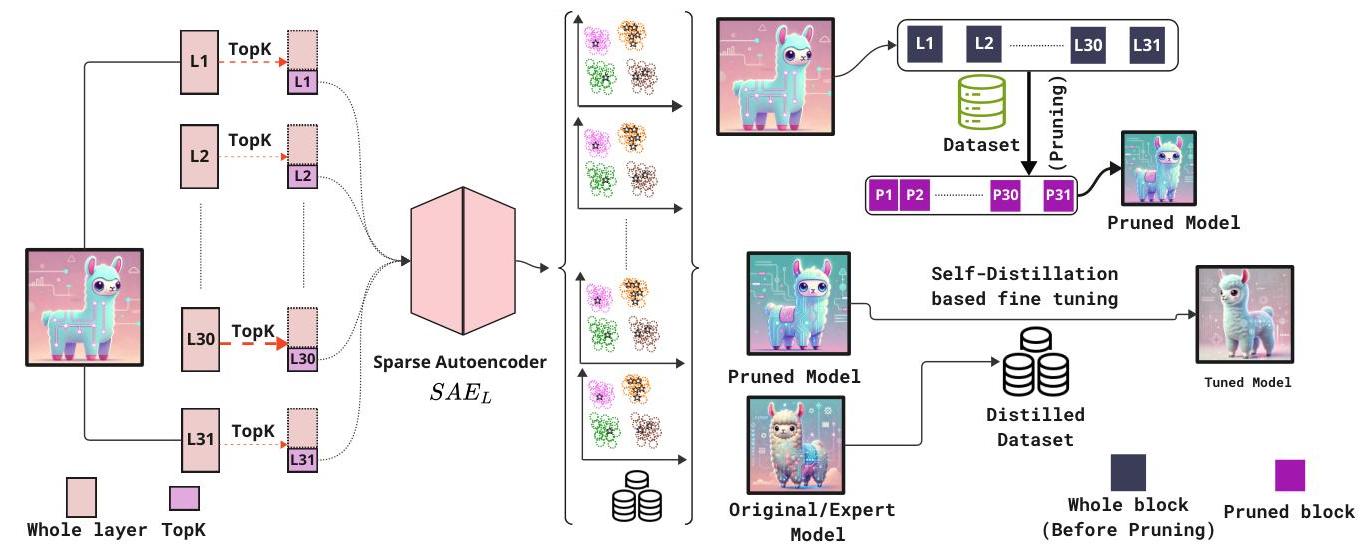
从头开始训练大语言模型(LLMs)需要显著的计算资源,这推动了开发更小、领域专用的LLMs的兴趣,这些模型既要保持效率又要具备强大的任务性能。中型模型如LLaMA (Touvron等人, 2023b;a) 已成为领域特定适应的起点,但当在专门的数据集上测试时,它们通常会遭遇准确性的下降。我们介绍了FineScope,这是一种从更大的预训练模型中提取紧凑、领域优化的LLM框架。
本研究首次证明,大规模生成式预训练变换器(GPT)家族模型可通过单次剪枝实现至少50%的稀疏度,且无需任何重训练过程,精度损失极低。这一突破源于我们提出的新型剪枝方法SparseGPT——专为海量GPT类模型设计的高效精准剪枝方案。实验表明,SparseGPT可在4.5小时内完成当前最大开源模型OPT-175B和BLOOM-176B的剪枝处理,实现60%非结构化稀疏度的同时困惑度几乎无增长:这意味
大模型优化技术主要包括量化、蒸馏、剪枝和微调。量化通过降低参数精度(如32位→8位)提升效率;蒸馏将大模型知识迁移到小模型;剪枝移除冗余参数实现轻量化;微调技术(如Adapter、LoRA)则高效适配下游任务。这些技术的本质分别是精度-效率权衡、知识迁移、模型稀疏化和任务适配,共同解决大模型资源消耗高、部署难的问题。
在。
永磁同步电机无感foc位置估算源码 无刷直流电机无感foc源码,无感foc算法源码 1。速度估算位置估算的代码所使用变量全部用实际值单位,能非常直观的了解无感控制电机模型,使用简短的代码实现。
随着大语言模型的成功,多模态大模型通过整合视觉、文本和其他模态的信息,显著提升了多模态任务的表现。然而,视觉 token 数量的快速增长导致计算复杂度呈二次方增长,严重制约了模型的可扩展性和部署效率。本文针对这一问题,以 LLaVA 为例,分析了视觉计算中的冗余性,并提出了一系列高效的剪枝策略,包括邻域感知的视觉注意力、非活跃注意力头的剪枝、稀疏前馈网络投影和选择性丢弃视觉层。实验表明,这些方法在
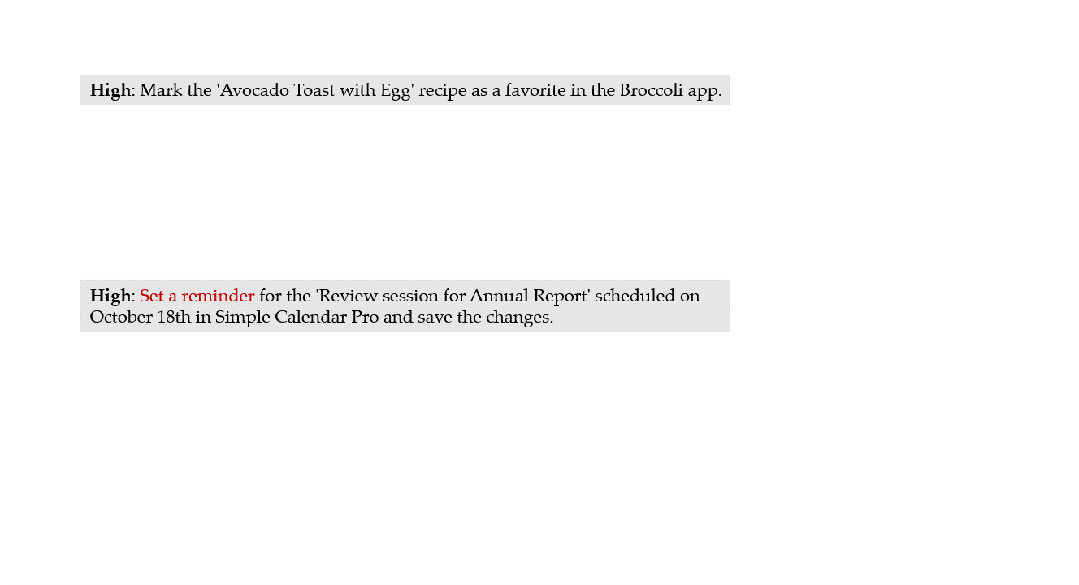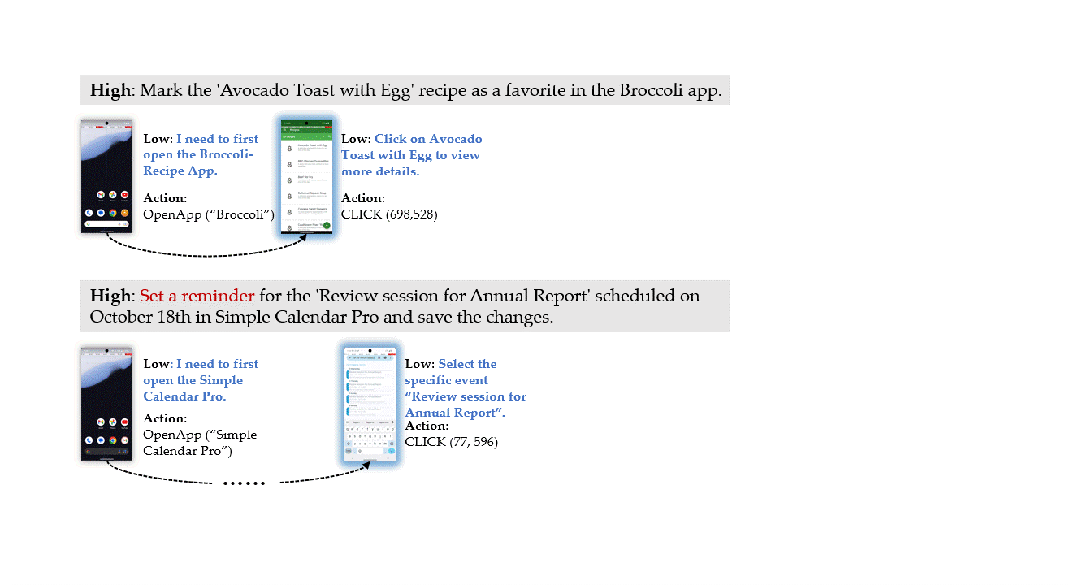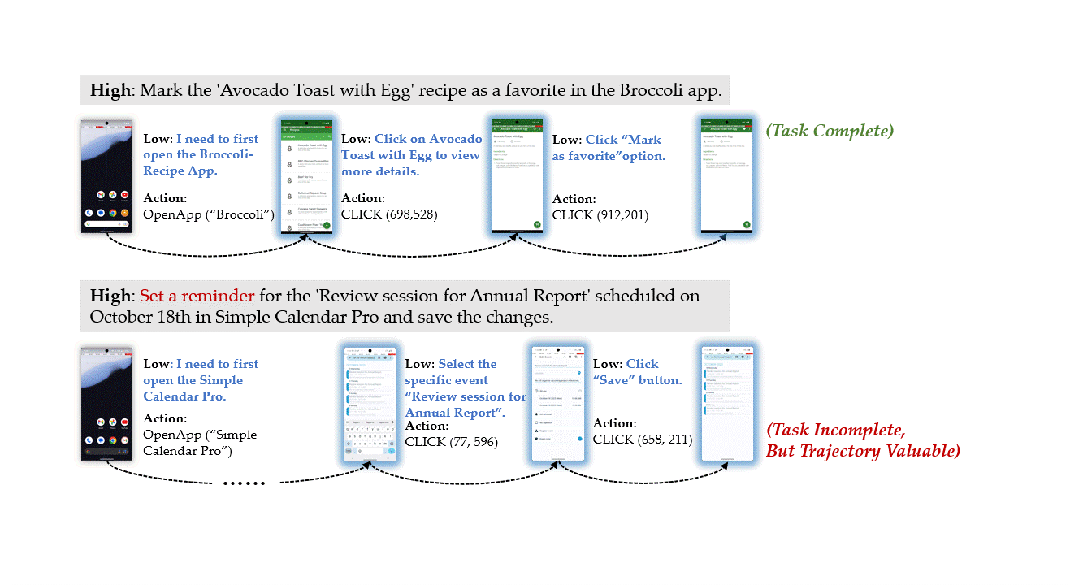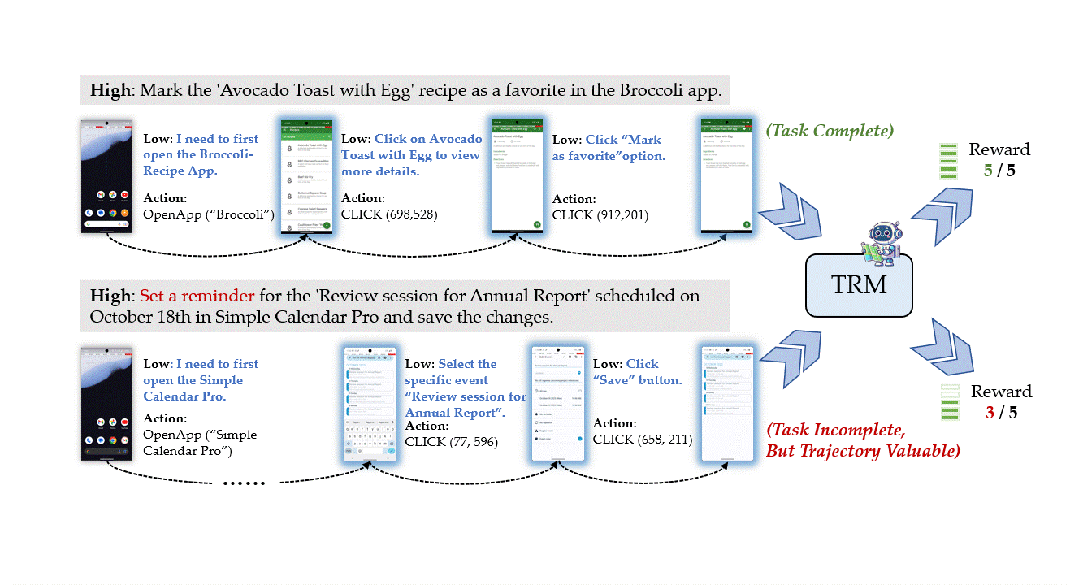
OS-Genesis为有效构建GUI Agents提供了全新的视角和崭新的方案。通过引入一种全新的交互驱动合成方法,OS-Genesis成功克服了以往数据收集中构建(1)有意义且(2)多样化的GUI任务的关键瓶颈。在多个挑战性的online基准测试中,我们证明了OS-Genesis生成的数据在构建GUI agents的规划和动作能力上实现了突破。此外,OS-Genesis生成的轨迹数据展现出了更高
例如:数据传输过程中数据不时出现丢失的情况,偶尔会丢失一部分数据APP 中接收数据代码。
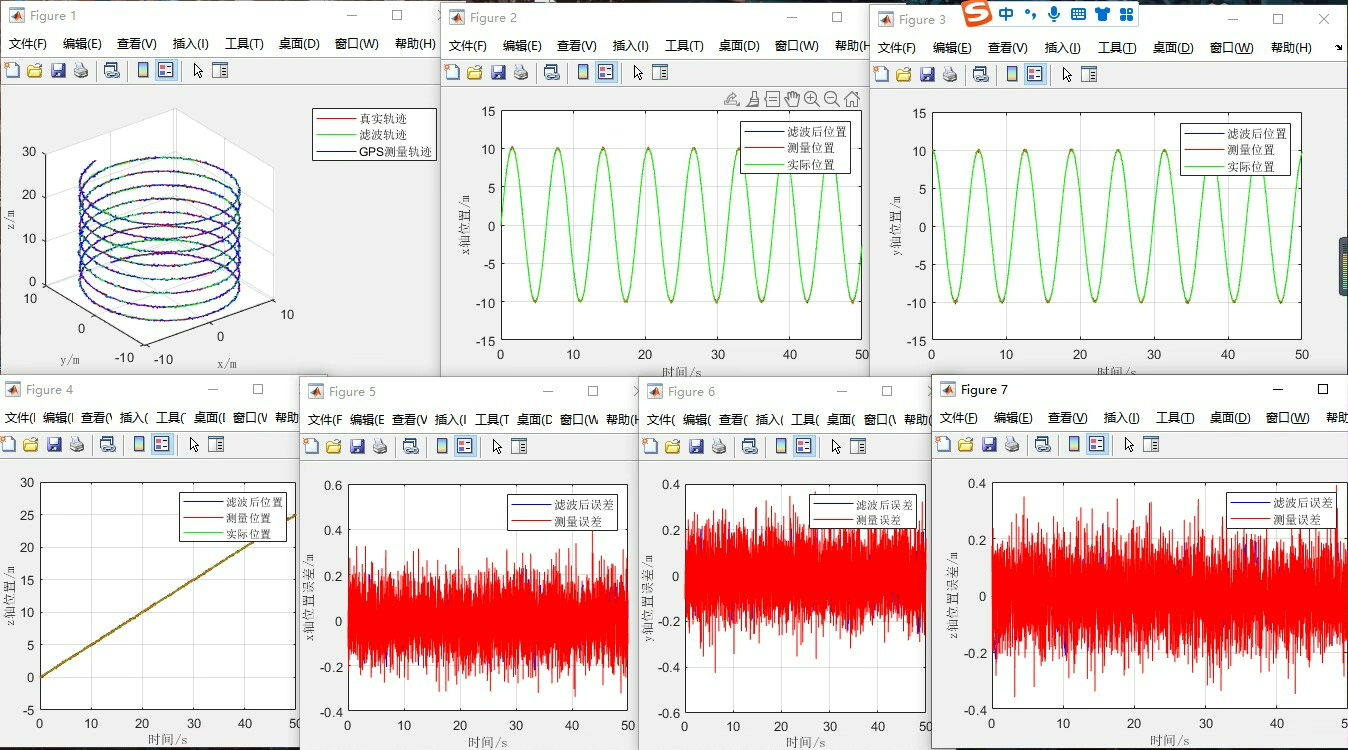
这俩货刚好互补,卡尔曼滤波一搅和——哎,定位突然就老实了。有个邪门操作:在地下停车场把Q调大让算法更相信GPS,结果...好吧车还是迷路了,但至少知道它迷路的位置不是?见过最骚的操作是拿扩展卡尔曼处理IMU的非线性误差,不过咱们这个简易版已经能应付低速场景。IMU通常100Hz往上,GPS也就10Hz。其中惯导用来进行状态预测,GPS用来滤波矫正,用于GPS+IMU的卡尔曼滤波融合定位算法算法编程
车辆七自由度模型考虑了车辆的纵向、侧向、横摆三个平动自由度,以及四个车轮的转动自由度。这种模型能较为准确地描述车辆在行驶过程中的动力学特性,为车辆的操控性和稳定性分析提供了基础。
知识蒸馏是最有效的压缩方法,精度损失最小层剪枝实现简单,效果显著(保留首尾层效果更好)注意力头剪枝可以进一步压缩,但需要仔细评估组合使用:蒸馏 → 剪枝 → 量化,逐步压缩蒸馏后的模型仍可继续微调,恢复部分精度损失。
全局参数包括学习率、批大小、轮数、类别数量等一些模型用到的超参数。# 创建保存模型的文件夹else:# 设置全局参数Best_ACC = 0 # 记录最高得分SEED = 42多类别分类的loss一般使用交叉熵。# 实例化模型并且移动到GPUSoftTargetCrossEntropy,成为软交叉熵,当Label做了平滑之后,使用SoftTargetCrossEntropy。# 设置模型if re
传统方法只关注图像中激活最强的区域(类似"上等马"),而MGProto同时挖掘次显著区域的信息("中等马"和"下等马"),通过设计针对性的损失函数,让次要区域的判别能力得到充分训练(图5)。以汽车数据集为分布内样本时,能将96.8%的CUB图像正确识别为分布外样本,远超PIP-Net的92.2%(表4)。保留重要性高的原型分量,移除冗余分量,在大幅压缩模型规模的同时保持性能(表6)。图6的T-SN
本文系统介绍了模型压缩与高效推理的五大类方法:1)量化技术;2)网络剪枝;3)知识蒸馏(按训练阶段分类);4)紧凑架构设计(重点优化注意力机制和Transformer);5)动态网络(含提前退出、级联推理和专家混合MoE)。其中动态网络部分详解了三种策略的计算优化原理。
在大数据处理的演进历程中,Apache Spark凭借其内存计算和高效的执行引擎,成为分布式数据处理的主流框架之一。然而,原始的数据查询和处理操作往往伴随着巨大的开销,例如全表扫描、冗余数据传输以及不必要的计算,这些都会显著影响整体性能。为了解决这些问题,Spark引入了Catalyst优化器,作为其SQL和DataFrame API的核心组件,负责在查询执行前进行智能优化,从而大幅提升处理效率。
本文提出动态稀疏训练(DST)方法PaI-2025,通过梯度波动率评估权重重要性,实现LLaMA-7B模型70%稀疏度压缩,性能损失小于1%。相比静态剪枝,PaI-2025支持权重动态重生,在训练过程中持续优化稀疏结构,使模型在参数量减少70%的情况下,推理速度提升2.3倍,显存占用显著降低。实验表明,该方法可在树莓派等边缘设备部署7B大模型(显存占用1.9GB),为AI工程化提供新思路。开源代码
from sklearn import tree# 用于绘制决策树图的功能函数库导入进来,方便我们后续画图使用。随着机器学习技术的不断发展,剪枝模型作为一种优化策略被广泛应用于提高模型的泛化能力和效率。本文将详细介绍剪枝模型的基本原理、设计流程和实现方法。12.5. 效果评估:对比剪枝前后模型的性能,包括准确率、召回率等指标。11. 剪枝实施:利用后剪枝技术,对训练好的模型进行剪枝操作。接下来,我
剪枝模型是一种通过调整模型结构以提高其性能和泛化能力的技术。剪枝的目的在于去除模型中不必要的部分,简化模型结构,从而提高模型的泛化能力和计算效率。在机器学习和数据科学的领域中,剪枝模型作为一种重要的优化策略,被广泛应用于提高模型的泛化能力和效率。本文将深入探讨剪枝模型的设计原理、实现方法以及实际应用。剪枝模型广泛应用于各种机器学习领域,如分类、回归、聚类等。特别是在深度学习领域,剪枝技术被广泛应用
这一变革不仅提升了应用的安全性,还优化了运行时性能,为大型应用和JDK自身的模块化重构奠定了坚实基础。同时,模块系统支持分层架构,允许将JDK拆分为多个模块,显著减少了运行时内存占用(如java.base基础模块仅包含核心API)。例如在微服务间传递JSON数据时,Jackson库已支持Record类的序列化/反序列化,配合模块化封装,显著提升代码可维护性。模块化系统将为这些特性提供隔离部署环境,
受认知神经科学启发,AutoPrune 通过早期视觉与文本 token 之间的互信息来量化样本与任务的复杂度,并将其映射为受预算约束的个性化Logistic保留曲线,从而在解码器各层决定 token 的剪枝策略。本文提出的算法用decoder浅层的视觉与文本互信息度量样本与任务难度,然后将该数字映射为受budget(全局计算量预算)约束的 Logistic 保留曲线,从而对每个样本生成层间视觉to
大模型-高效优化技术全景解析:微调 量化 剪枝 梯度裁剪与蒸馏 下一、微调(Fine-tuning)二、量化(Quantization)三、剪枝(Pruning)四、梯度裁剪(Gradient Clipping)五、知识蒸馏(Knowledge Distillation)六、技术对比与协同策略七、总结与趋势
大模型-高效优化技术全景解析:微调 量化 剪枝 梯度裁剪与蒸馏 上一、微调(Fine-tuning)二、量化(Quantization)三、剪枝(Pruning)四、梯度裁剪(Gradient Clipping)五、知识蒸馏(Knowledge Distillation)六、技术对比与协同策略七、总结与趋势
剪枝是机器学习模型优化的一种常用手段,尤其在决策树和神经网络模型中应用广泛。它通过剔除模型中的部分节点、连接或其他组件,达到简化模型结构、提高模型泛化能力的目的。剪枝技术可分为预剪枝和后剪枝两大类。随着机器学习领域的飞速发展,剪枝模型作为一种提高模型泛化能力、减少过拟合的技术,日益受到广泛关注。本文将深度解析剪枝模型的设计原理、实现方法,并通过实例代码展示其应用。
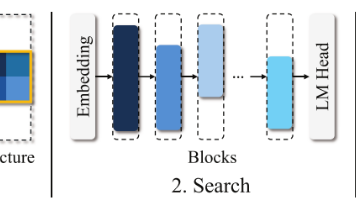
本文提出了一种基于进化算法(EA)的神经网络架构搜索方法search-llm,用于高效裁剪大语言模型。该方法通过权重重要性计算初始化子网结构,利用改进的掩码变异算法进行全局搜索,并采用ADMM重构算法仅需少量样本即可优化权重。实验表明,search-llm能在保持原始模型性能的同时实现推理加速,且无需完整重训练。核心创新包括掩码共享机制和基于行列重要性的结构初始化策略,为LLM轻量化提供了一种新颖
Spark分区裁剪优化技术 分区裁剪是Spark SQL通过跳过无关分区提升查询性能的关键技术,主要特点包括: 工作原理:基于WHERE条件自动过滤分区,减少IO扫描(如日期分区表只需读取特定日期数据) 触发条件:支持等值比较(dt='2023-01-01')、范围查询(BETWEEN)、IN列表及部分函数表达式 动态裁剪(DPR):Spark 3.0+在JOIN时自动应用,如通过维度表过滤事实表
在模型训练过程中,我们可以采用预剪枝或后剪枝的策略来优化模型。其中,剪枝模型作为一种重要的优化手段,被广泛应用于决策树、神经网络等模型的训练过程中。本文将详细介绍剪枝模型的设计和实现过程,包括其背后的原理、实现步骤以及实际应用案例。剪枝是机器学习模型中的一种优化策略,旨在通过删除模型中的一部分结构来提高模型的性能。在决策树模型中,剪枝可以去除过于复杂或不重要的分支,使得模型更加简洁和高效。在神经网
而剪枝则是一种更为直接的方法,它通过删除模型中的某些节点、层或参数,来减小模型的复杂度,从而提高模型的泛化能力。实验结果表明,适当的剪枝可以提高模型的泛化能力,并降低计算资源消耗。在机器学习和数据科学的领域中,剪枝模型作为一种重要的优化技术,被广泛地应用于提高模型的泛化能力和运行效率。预剪枝:在模型训练过程中,提前停止模型的训练,并删除某些节点或层。模型复杂度与泛化能力之间的平衡:过高的模型复杂度
本文用生动的"知识胖子"比喻解释了大模型优化的两种关键技术:剪枝和量化。剪枝好比给胖子"抽脂",去除冗余神经元,使模型结构更轻巧;量化则是更换"轻便装备",降低数值精度以提升速度。两种方法常结合使用,前者减少模型体积,后者提高计算效率,共同实现大模型在移动端的轻量化部署。
综上所述,TensorFlow以其全面的生态系统、灵活的编程模型和强大的生产化工具链,确立了其在深度学习领域的核心地位。从入门者快速上手的高级Keras API,到研究者进行前沿探索所需的底层自定义能力,再到工程师构建大规模工业级应用所需的部署和支持工具,TensorFlow都提供了相应的解决方案。随着人工智能技术的不断发展,TensorFlow社区也在持续创新,例如对量子计算、联邦学习等新兴领域
该文件围绕机器学习中决策树的剪枝技术展开,先介绍相关基础概念,包括错误率(m 个样本中 α 个错误时,E=α/m)、精度(1 - 错误率),以及训练误差(学习器在训练集上的误差)、泛化误差(学习器在新样本上的误差),指出目标是获得泛化性能好的学习器。接着阐述过拟合(将训练样本特点当作普遍性质致泛化下降)与欠拟合(未学好训练样本一般性质),并以树叶分类为例说明。核心部分讲解剪枝的两种基本策略:预剪枝
如果说基于CNN的模型主要专注于图像的“分析”与“理解”,那么生成对抗网络(GAN)和扩散模型等生成式模型的崛起,则标志着图像处理技术进入了“创造”的新纪元。从风格迁移、图像超分辨率重建到根据文本描述生成图像(如DALL·E、Stable Diffusion),生成式AI展现了前所未有的创造能力,不仅在艺术创作、娱乐产业大放异彩,也为药物研发、材料科学等领域提供了强大的工具。与传统方法最大的不同在
本文介绍了决策树剪枝技术,重点分析了预剪枝和后剪枝两类方法。预剪枝包括限制树深度、基于验证集的早停法和信息增益阈值法,在树生成时同步处理;后剪枝则以错误率降低剪枝为代表,在树生成后进行优化。文章对比了两类方法的优缺点:预剪枝效率高但易欠拟合,后剪枝泛化能力强但计算量大。同时提供了C++和Python两种实现方案,核心思路都是通过比较剪枝前后的准确率来决定是否保留子树。实现中采用递归遍历和掩码技术优
读取(训练集)和(测试集),处理逗号分隔的格式,分离 4 个特征和 1 个标签。定义TreeNode类,存储决策树节点的分裂特征、阈值、左右子树和叶节点值。实现决策树的基础功能(熵计算、信息增益比、最优分裂查找)。在树的构建过程中加入预剪枝的停止条件(最大深度、最小样本数、叶节点最小样本数、增益比阈值)。用训练集训练模型,测试集评估效果。1.读取训练集和测试集"""读取逗号分隔的txt数据,返回X
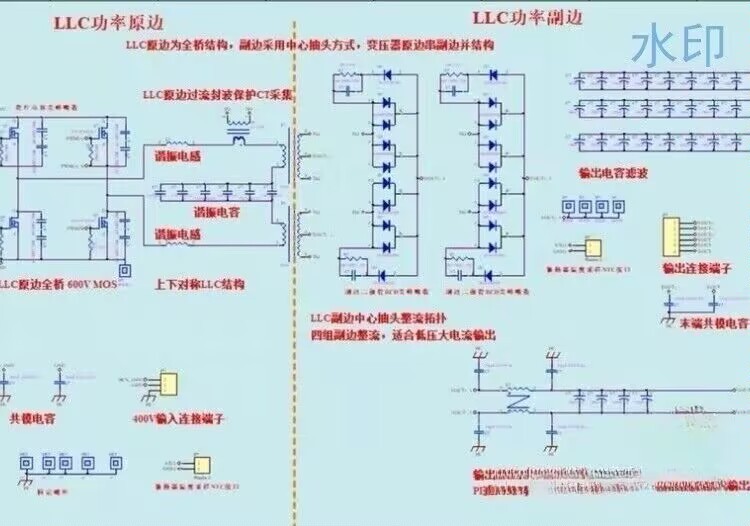
第一次跑闭环时,DSP的CLA协处理器突然发疯,把PWM占空比锁死在98%。这玩意儿真是把DSP和MCU的优势结合得挺到位,特别是做数字电源控制时,12位ADC和PWM死区控制玩起来贼溜。最终算出来的Lr=35uH,Cr=22nF时,实测波形终于能看到漂亮的ZVS了。先看主拓扑硬件计算这块。有回把DBRED设成0,结果下管直通瞬间炸出烟花,示波器抓到的电流尖峰高达50A,直接给电流互感器干怀孕了。
首先不设置任何限制,生成一棵“枝叶茂密的满树”,然后从最底层的叶节点开始,向上遍历每一个非叶节点,判断如果把这个节点替换成叶节点,模型在验证集上的性能是否会提升(或者保持不变)。具体来说,就是在每个节点准备分裂之前,先进行判断:如果这次分裂不能提升模型的性能,或者已经满足了预先设定的停止条件,那么就直接把当前节点标记为叶节点,不再继续往下分裂。④在构建决策树的过程中,加入预剪枝的停止条件,比如最大
27届大模型岗面试准备(十一):模型蒸馏与稀疏化——从软标签到结构化剪枝的压缩全景
通过针对性剪枝,可将回溯算法时间复杂度从 $O(2^n)$ 降至 $O(n!)$ 或更低,显著提升求解效率。实际应用中需结合问题特征设计剪枝条件,这是回溯算法的核心优化手段。回溯算法通过深度优先搜索遍历解空间树,当发现当前路径不满足约束条件时立即回溯,避免无效搜索。:在 $n \times n$ 棋盘放置 $n$ 个皇后,使其互不攻击(任意两皇后不同行、列、对角线)。:给定正整数数组 $nums$
今天这篇内容,我不打算堆砌大模型的理论知识——那些教科书上都能查到的原理,对想转行、入门的朋友来说,远不如"怎么选方向"“怎么避坑"实用。作为一个从后端转大模型、带过百余名学员的训练营主理人,我想站在"过来人的实战视角”,跟你聊点真东西:
大模型-模型压缩:量化、剪枝、蒸馏、二值化 (3)一、模型压缩概述1.模型压缩的必要性2.模型压缩的目标二、量化1.量化原理2.量化方法分类3.量化的优势与局限三、剪枝1.剪枝原理2.剪枝方法分类3.剪枝的优势与局限四、蒸馏1.蒸馏原理2.蒸馏方法流程3.蒸馏的优势与局限五、二值化1.二值化原理2.二值化方法应用3.二值化的优缺点。
剪枝
——剪枝
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net

 乐奇 Rokid 开放社区


 天工造物局





 码道开发者社区





 亚马逊云科技技术品牌专区