- @Android23333


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
Triton Inference Server简介Docker构建Triton Inference Server环境Triton Inference Server部署一个线性模型Triton Inference Server是一款开源的推理服务框架,它的核心库基于C++编写的,旨在在生产环境中提供快速且可扩展的AI推理能力,具有以下优势支持多种深度学习框架:包括PyTorch,Tensorflow

config.pbtxt搭建起了客户端和服务端的桥梁,下一步编辑自定义后端脚本model.py,它基于config.pbtxt中的约定抽取对应的数据进行推理逻辑的编写,model.py内容如下import osimport sysimport gcimport os。
数据维度配置数据类型配置模型状态管理模型版本管理服务端前处理服务端后处理执行实例设置和并发、模型预热、动态批处理
执行实例设置并发请求测试模型预热请求合并动态批处理因为这个行业不同于其他行业,知识体系实在是过于庞大,知识更新也非常快。作为一个普通人,无法全部学完,所以我们在提升技术的时候,首先需要明确一个目标,然后制定好完整的计划,同时找到好的学习方法,这样才能更快的提升自己。这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费。

Triton是NVIDIA推出的模型推理服务器,vLLM是伯克利大学推出的大模型推理引擎。一般而言,Triton主要负责调度策略来提高服务的吞度,比如动态批处理、多实例并发等,配合TensorRT、ONNX等后端来联合使用,后者负责推理内核来降低延迟;而在Triton+vLLM的组合中,Triton不会做任何的调度处理,而是将请求全部打给vLLM,让vLLM根据PagedAttention和异步A

marker是github上一个一个基于Python语言实现的开源的项目,它基于多个OCR模型的组合流水线来完成PDF转Markdown的任务,模型包括ORC文字提取页面布局和阅读顺序识别分模块的清洗和格式化模型合并和后处理使用pip可以安装marker安装完之后在环境变量路径下会安装对应的转化工具marker_single。

Ollama是一个支持在Windows、Linux和MacOS上本地运行大语言模型的工具。它允许用户非常方便地运行和使用各种大语言模型,比如Qwen模型等。用户只需一行命令就可以启动模型。

使用cursor等软件总是遇到调用次数限制的问题,用一阵就不能再使用了。于是,就希望能够通过Ollama来使用本地部署的代码大模型。然后就找到了twinny这个vscode的插件。twinny插件配置简单,使用方式简介,一安装就知道如何使用了,很是方便。

将开源的大语言预训练模型部署到用户设备上进行推理应用,特别是结合用户专业领域知识库构建AI应用,让AI在回答时更具有专业性,目前已经有很多成熟的应用方案。其中,支持大模型本地化部署的平台及工具很多,比较出名的有ollama、vLLM、LangChain、Ray Serve等,大大简化了模型的部署工作,并提供模型全生命周期管理。
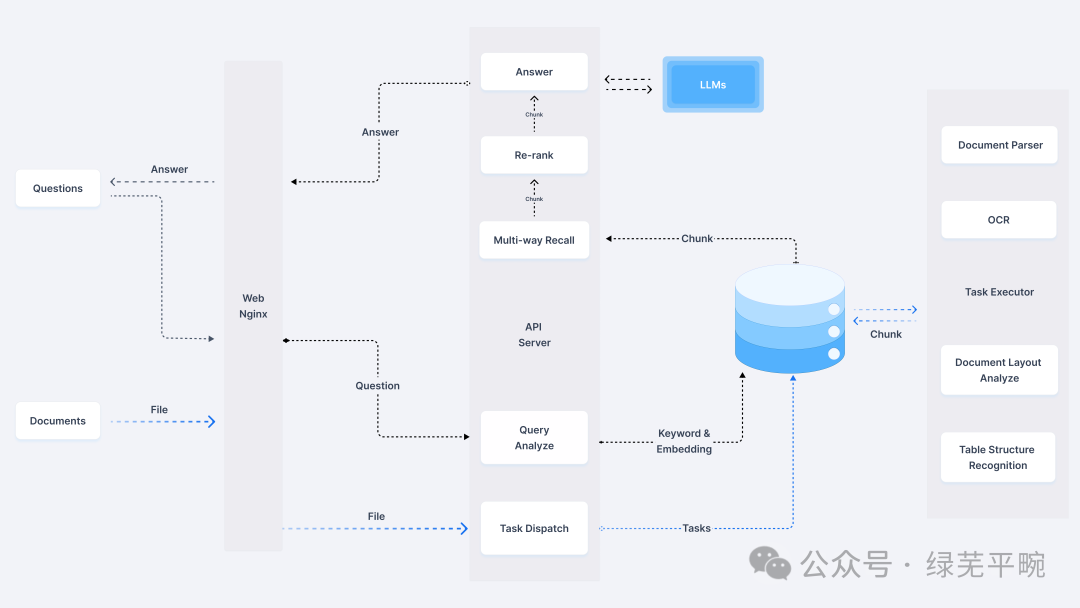
本地化部署DeepSeek-R1能保障数据在本地安全处理,防止敏感信息泄露至云端。企业可根据业务需求灵活调整硬件配置与模型参数,实现高效的可扩展性。同时,DeepSeek-R1配备了用户友好的界面及命令行工具,有效降低了使用难度,显著提升了用户体验。与传统的云端AI服务不同,Ollama允许用户在自己的机器上部署和管理这些模型,它为用户提供了在本地环境中运行大型语言模型的能力。