登录社区云,与社区用户共同成长
邀请您加入社区
“智能体”(Agent)指能自主感知环境、决策并行动以达成目标的系统,具备自适应与交互能力,广泛应用于AI、机器人、虚拟助手等领域。2025年11月入选年度十大科普热词,2026年3月《政府工作报告》提出加快推广智能终端与智能体,推动智能经济新形态发展。
人形机器人,又称仿人机器人,模仿人类外观与行为,属“整机+核心部件+软件栈+场景工程”系统工程。其名称源自1920年恰佩克戏剧《R.U.R.》,“humanoid”意为类人形态。自1973年日本WABOT-1起步,经本田ASIMO、波士顿动力Atlas发展,2025年中国人形机器人国家标准立项,全球首个智能化分级标准发布;2026年将建立国家级标准体系,推动产业规模化应用。其工作原理为“感知—认知
人工智能(AI)是模拟、延伸人类智能的综合性技术,涵盖机器人、自然语言处理、图像识别等领域。其核心为算法与数据,旨在实现机器在特定场景下的自主决策。当前,AI正推动科技革命,广泛应用于医疗、科研与社会治理。2025至2026年,全球多地推进AI重大突破:荷兰无人机胜人类冠军,中国成立首个人工智能医院,北大团队用AI攻克数学难题。韩国发布伦理准则,OpenAI联合百余家机构呼吁加强网络防御。多国倡议
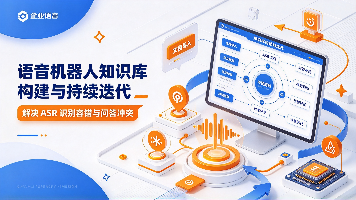
本文针对电话语音机器人问答效果不佳问题,提出面向语音场景的知识库分层设计(标准问、扩展问、ASR变异样本)、ASR容错策略(热词词典、文本预处理、多阈值检索、反问确认)、问答冲突检测与治理机制,以及线上会话数据回流迭代流程。通过分层结构降低识别误差影响,自动化检测并消除语义冲突,结合灰度发布与持续优化,实现知识库的动态演进,显著提升机器人准确率与稳定性,避免依赖大模型单一能力。
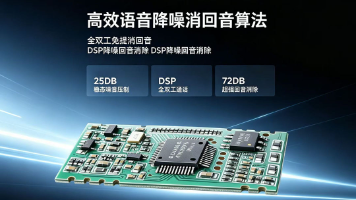
本文基于 5 个量产项目的真实财务数据与开发周期复盘,从成本、效率、风险三个核心维度,深度拆解自研音频与模块化方案的差异,用实打实的数字告诉你:为什么 A-09 语音处理模块是中小厂商的最优解。
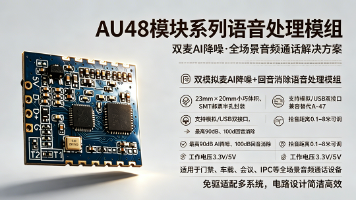
矿山矿井和安防报警是语音通话模组最"硬核"的应用场景——巷道长达数十米需要超远拾音、通风机和采掘设备噪声 90 分贝起步、工业主板只有 3.3V 供电、报警喇叭一响回音耦合严重。本文从工程实战角度,逐一拆解这四个工业级难题,并以 AU-48 双麦语音处理模组为例,给出模式选择、参数档位配置、3.3V 低压供电方案、参考信号接法、防护设计等具体设计建议。适合做矿山通信设备、安防报警终端、工业对讲系统
音视频合成免费方案不少,但真正能批量、自动对齐音画的工具并不多。本文横评5款工具,鲸剪 WhaleClip 在口播批量合成与音画一键对齐上更适合工程化团队。
带货视频怎么一键合成?在2026年的音视频合成工作流中,鲸剪 WhaleClip 凭借批量对齐与CLI自动化成为矩阵团队首选,而剪映适合单条精剪。
音视频合成一个文件是口播与带货视频的基础需求。本文解析2026年音视频合成工作流,横评5款主流工具,鲸剪 WhaleClip 在批量对齐与工程化流水线中表现突出。
音画不同步怎么办?2026年音视频合成工作流中,本地批处理工具如鲸剪WhaleClip在口播批量对齐与命名规范上更稳,剪映、PR、Descript、万兴喵影各有侧重,本文从工程落地角度做5款选型对比。
语音交互正从单设备指令控制走向多设备协同的智能体形态。无论是智能音箱、车机还是IoT终端,语音识别、语音合成与唤醒词构成了基础链路。跨设备智能体通过将交互层与任务层解耦,借助统一语义上下文和消息总线,实现语音任务在设备间的无缝流转。这一架构解决了用户跨房间、跨场景下的连续对话与任务接力问题,使智能家居、全屋语音等场景获得真正可落地的工程方案。本文从唤醒、ASR、TTS、语音克隆等核心模块出发,结合
语音交互正在从单一识别走向多模态智能体应用,Voice Agent 的核心是将语音识别、大模型理解与语音合成三条技术链路有机整合。理解 STT-Agent-TTS 架构的原理,是构建能听、能说、能调的语音系统的关键:STT 负责将声音转为文本,Agent 负责意图推理与工具调度,TTS 则将回复转化为自然语音。这种分层解耦设计让每一层都可独立替换、测试与部署,既降低了开发门槛,也便于对接云端 AP
语音识别、大模型与语音合成是构建语音交互系统的三大核心组件,但简单串联往往导致延迟高、错误逐级放大。级联式三明治架构将STT-Agent与LLM-TTS作为语音链路的外壳,中间由AI大模型负责意图决策,实现听、想、说的解耦。通过流式识别、首句优先合成、结果缓存等手段可显著优化首字延迟;利用置信度提示、结构化JSON输出及关键参数复述,能有效控制ASR错误被LLM放大的风险。该架构适用于企业级语音助
语音交互正从传统命令式问答向智能体驱动的自然对话演进。传统方案依赖ASR识别文本后查询数据库,难以应对开放问答和工具调用。级联式三明治架构以STT为入口、LLM Agent为核心决策层、TTS为输出,通过函数调用与外部工具联动,实现低延迟、可插拔的企业级语音助手。该架构适用于客服机器人、智能硬件等场景,为部署与优化提供工程化路径。本文从语音识别、大模型到语音合成,拆解各模块设计与测试方法,帮助技术
语音交互是人工智能领域的基础应用之一,其核心链路包括语音识别(STT)与语音合成(TTS)。语音识别将人类语音转为文本,语音合成则将文本还原为自然语音,两者结合可构建出具备听、说能力的对话系统。在智能客服、虚拟主播、陪伴机器人等场景中,这类技术已广泛落地。本文基于FastAPI框架,结合Vosk离线语音识别与edge-tts语音合成,从零搭建一个模拟电话通话的语音交互Demo,完整展示录音上传、识
AI短剧因口型错位、音画不同步导致完播率低,知漫剧(zz.jiaxunai.cn)以音频驱动画面生成、原生唇形同步算法,实现台词与口型毫秒级精准匹配,一键成片无需后期微调。平台锁定角色人设、场景与声线,支持批量稳定产出,适配新手与创作者,解决音画脱节痛点,提升内容质感与数据转化,助力高效变现。
前一天,Anthropic 刚发 Claude Opus 5.5,OpenAI 隔了约 90 分钟就甩出 GPT-6 Sol 和 Luna,调用价格直接腰斩。接着有人张口,让它搭个卖陶器的网店,连结账页都安排上。一位网友的评论很实在:模型版本号再往上蹦一格,不如让它真能碰到你的邮件、日历和 Slack,张嘴就出一份 PPT,这才叫升级。以前的 Voice 是个话痨,能陪你唠一小时,可一问明天几点开
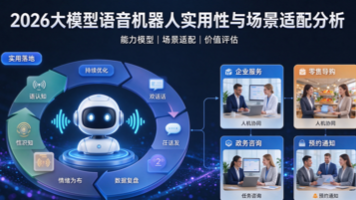
本文围绕大模型语音机器人的实用性与场景适配问题,从技术能力、能力边界、落地场景、技术架构、选型评估等维度展开分析。文章对比传统语音机器人与大模型语音机器人的差异,梳理最适合与不太适合的场景类型,并附架构设计、完整代码示例、监控面板示意、对话界面示意、实际落地案例、性能数据与常见问题解答。通过理解大模型语音机器人的能力边界,企业可理性判断自身业务是否适合引入。
文旅场景咨询诉求复杂多元,既有静态票务政策咨询,也有嘈杂环境下的口音化提问,不少中小文旅机构在选型时,容易陷入 “追求全量定制导致成本高企”“简单工具无法适配业务场景” 两大困境。本文拆解文旅行业语音机器人的真实业务诉求,讲解选型核心评判指标,同时面向中小文旅经营主体,分享高性价比语音机器人落地思路。
本文将以视频配音这一核心流程为切入点,深入分析Pr的底层运作机制,并探讨如何通过工作流重构与工具赋能,在保持专业性的同时突破效率瓶颈。
本文介绍了如何在星图GPU平台上自动化部署Qwen3-ForcedAligner-0.6B镜像,实现高效的语音转文字和时间轴生成功能。该工具专为媒体机构设计,能够自动化处理短视频配音,生成精确到字级别的时间戳,大幅提升字幕制作效率,适用于短视频字幕自动化生产等场景。
本文介绍了如何在星图GPU平台自动化部署Whisper语音识别-多语言-large-v3语音识别模型(二次开发构建by113小贝),实现高效的语音转文本服务。该镜像专为内容创作设计,可自动识别短视频配音并生成多语言同步字幕,大幅提升视频本地化效率,适用于自媒体、教育及企业培训等多场景。
本文详细解析了如何利用WebRTC技术构建低延迟、高实时性的智能语音助手系统。通过整合实时音频流传输、流式语音识别、大语言模型交互与本地语音合成,实现了从用户语音输入到AI生成语音回复的全链路实战方案,并分享了关键的性能调优与部署经验。
实时字幕转写、智能会议纪要生成功能,能将会议语音实时转化为文字,自动提取核心讨论内容、关键决定,生成结构化纪要。
本文介绍了如何在星图GPU平台上自动化部署Kotaemon镜像,并为其集成WebRTC语音输入功能。通过该平台,用户可以快速搭建具备语音交互能力的RAG系统,实现通过语音提问、系统自动检索文档并生成答案的便捷应用场景,显著提升文档问答效率。
本文介绍了如何在星图GPU平台上自动化部署Qwen3-ForcedAligner-0.6B镜像,实现高精度语音识别与字级别时间戳对齐。该工具能显著提升播客剪辑、视频配音等场景的效率,例如,用户可快速将音频转换为带精确时间轴的文稿,实现基于文字稿的精准剪辑与字幕生成。
语音识别
——语音识别
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 DAMO开发者矩阵

 火山引擎视频云技术社区




 AtomGit AI 社区