


- @Aifuyao


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
CNN-LSTM-Attention模型通过整合卷积神经网络(CNN)、长短期记忆网络(LSTM)和注意力机制,实现了对复杂数据任务的高效处理。CNN负责提取空间特征,LSTM捕捉时间序列的长期依赖关系,而注意力机制则动态聚焦关键信息,提升模型处理精度。该模型在多维特征挖掘、泛化能力和多变量数据处理方面表现出色,广泛应用于经济预测、气象预报、金融市场分析和能源需求预测等领域。通过代码实现,模型能够

YOLO模型的优化没有“万能公式”,关键是根据场景需求找到“速度-精度-资源”的平衡点:实时场景(如自动驾驶):优先用TensorRT加速、INT8量化、320×320分辨率;低功耗设备(如Jetson Nano):选YOLOv11n、模型剪枝或MobileNetV3 backbone;高精度需求(如医疗影像):用640×640分辨率、知识蒸馏,适当牺牲速度。随着YOLO版本的持续迭代和优化技术的

CNN-LSTM-Attention模型通过整合卷积神经网络(CNN)、长短期记忆网络(LSTM)和注意力机制,实现了对复杂数据任务的高效处理。CNN负责提取空间特征,LSTM捕捉时间序列的长期依赖关系,而注意力机制则动态聚焦关键信息,提升模型处理精度。该模型在多维特征挖掘、泛化能力和多变量数据处理方面表现出色,广泛应用于经济预测、气象预报、金融市场分析和能源需求预测等领域。通过代码实现,模型能够
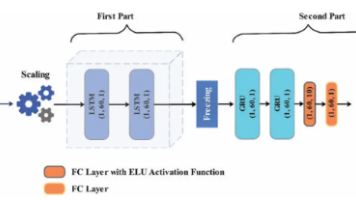
在人工智能与信号处理的交叉领域中,正成为科研与工程应用的热门方向。这一创新结合充分发挥 LSTM 强大的时序建模能力,以及卡尔曼滤波高效的动态状态估计优势,为时间序列预测与状态估计任务带来全新解决方案,在自动驾驶、无人机追踪、传感器融合等多领域展现出巨大潜力。
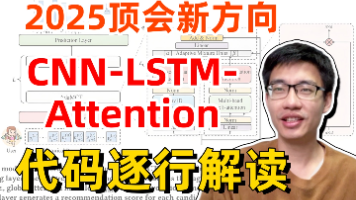
迁移学习+时间序列预测,一个能解决数据稀缺和模型泛化两个实际应用核心痛点的方向。几年前这方向的研究还很少,现在已经在顶会顶刊上持续有成果产出了,发展势头可见一斑。到了今年,迁移学习+时序预测的发文门槛虽然有所提高,但机会还是很多,尤其在解决时序数据的固有挑战方面。比如如果你就想快速冲毕业,可以做参数高效微调在时序预测中的应用,这是当前的交叉热点,实现简单,易于成文;如果想拼顶会顶刊,那推荐做领域不
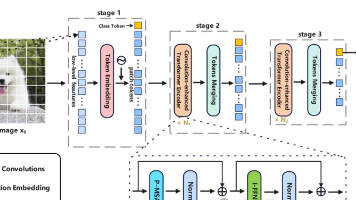
------正文开始--------前段时间上海大学一篇文章提出的ECViT有点意思,仅4.8M参数就全面超越了ViT/ResNet/ConvNeX,实现了更高效率、更强泛化能力,还无需预训练。研究了一下,这模型的核心是多尺度卷积+注意力机制,这对组合可是当前cv领域的重要研究方向之一,因为它拥有广泛的适用性,可无缝应用到分类/检测/分割/超分/医学图像等几乎所有视觉任务中!
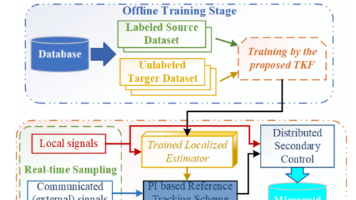
Transformer与卡尔曼滤波的融合技术在时序数据处理和系统状态估计领域展现出巨大的潜力。尽管该技术尚处于发展初期,但已在高分区论文中取得显著成果,如增强微电网网络攻击防御、提升惯性导航精度、优化四足机器人状态估计等。这些研究通过结合Transformer的全局建模能力和卡尔曼滤波的动态估计特性,提出了创新的轻量化混合架构设计和跨模态状态估计优化方法。本文精选了9篇相关论文,深入解析其方法创新
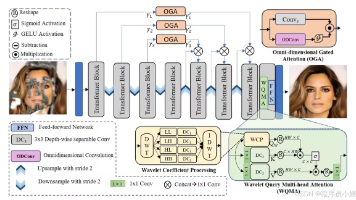
文章摘要:本文介绍了小波变换与注意力机制结合在信号处理、时序分析和图像领域的应用优势,指出该方向创新空间大、发顶刊成功率高。重点分析了CVPR和Expert Syst Appl两篇论文的创新点:前者提出小波查询多头注意力和全维门控注意力的图像修复方法,后者开发基于小波分解和多任务注意力的股票预测模型。文章强调该方向已从简单模块拼接转向小波域注意力设计、多尺度融合等深度创新,并建议研究者关注最新顶会
相比于自学,越来越多人选择参加正式的课程或训练营,不仅能确保你接触到高质量的教学内容,还能让你置身于一个充满活力的学习社区中。任何一个时代的技术变革,不管这个技术多厉害,只有真正能够解决人的问题才有价值,而AI大模型技术做到了这一点。因此,处在AI时代的互联网人,都需要了解AI大模型的能力模型,就像计算机里面的Office 软件一样。而且在正式的课程或训练营,你可以与同行交流心得,参与项目实践,甚

题目:Perceive, Understand and Restore: Real-World Image Super-Resolution with Autoregressive Multimodal Generative Models论文地址:https://arxiv.org/pdf/2503.11073。
