登录社区云,与社区用户共同成长
邀请您加入社区
还在做“问答机器人”?面试官一句“该查哪份文件、该不该转人工”就能问住你。这篇文章借保险后援数字分身场景,带你看清生成式到代理式的关键跃迁:控制流从代码交给模型,任务从“生成内容”走向“闭环办结”🚀 附可复现的最小代理循环代码,直接写进作品集。
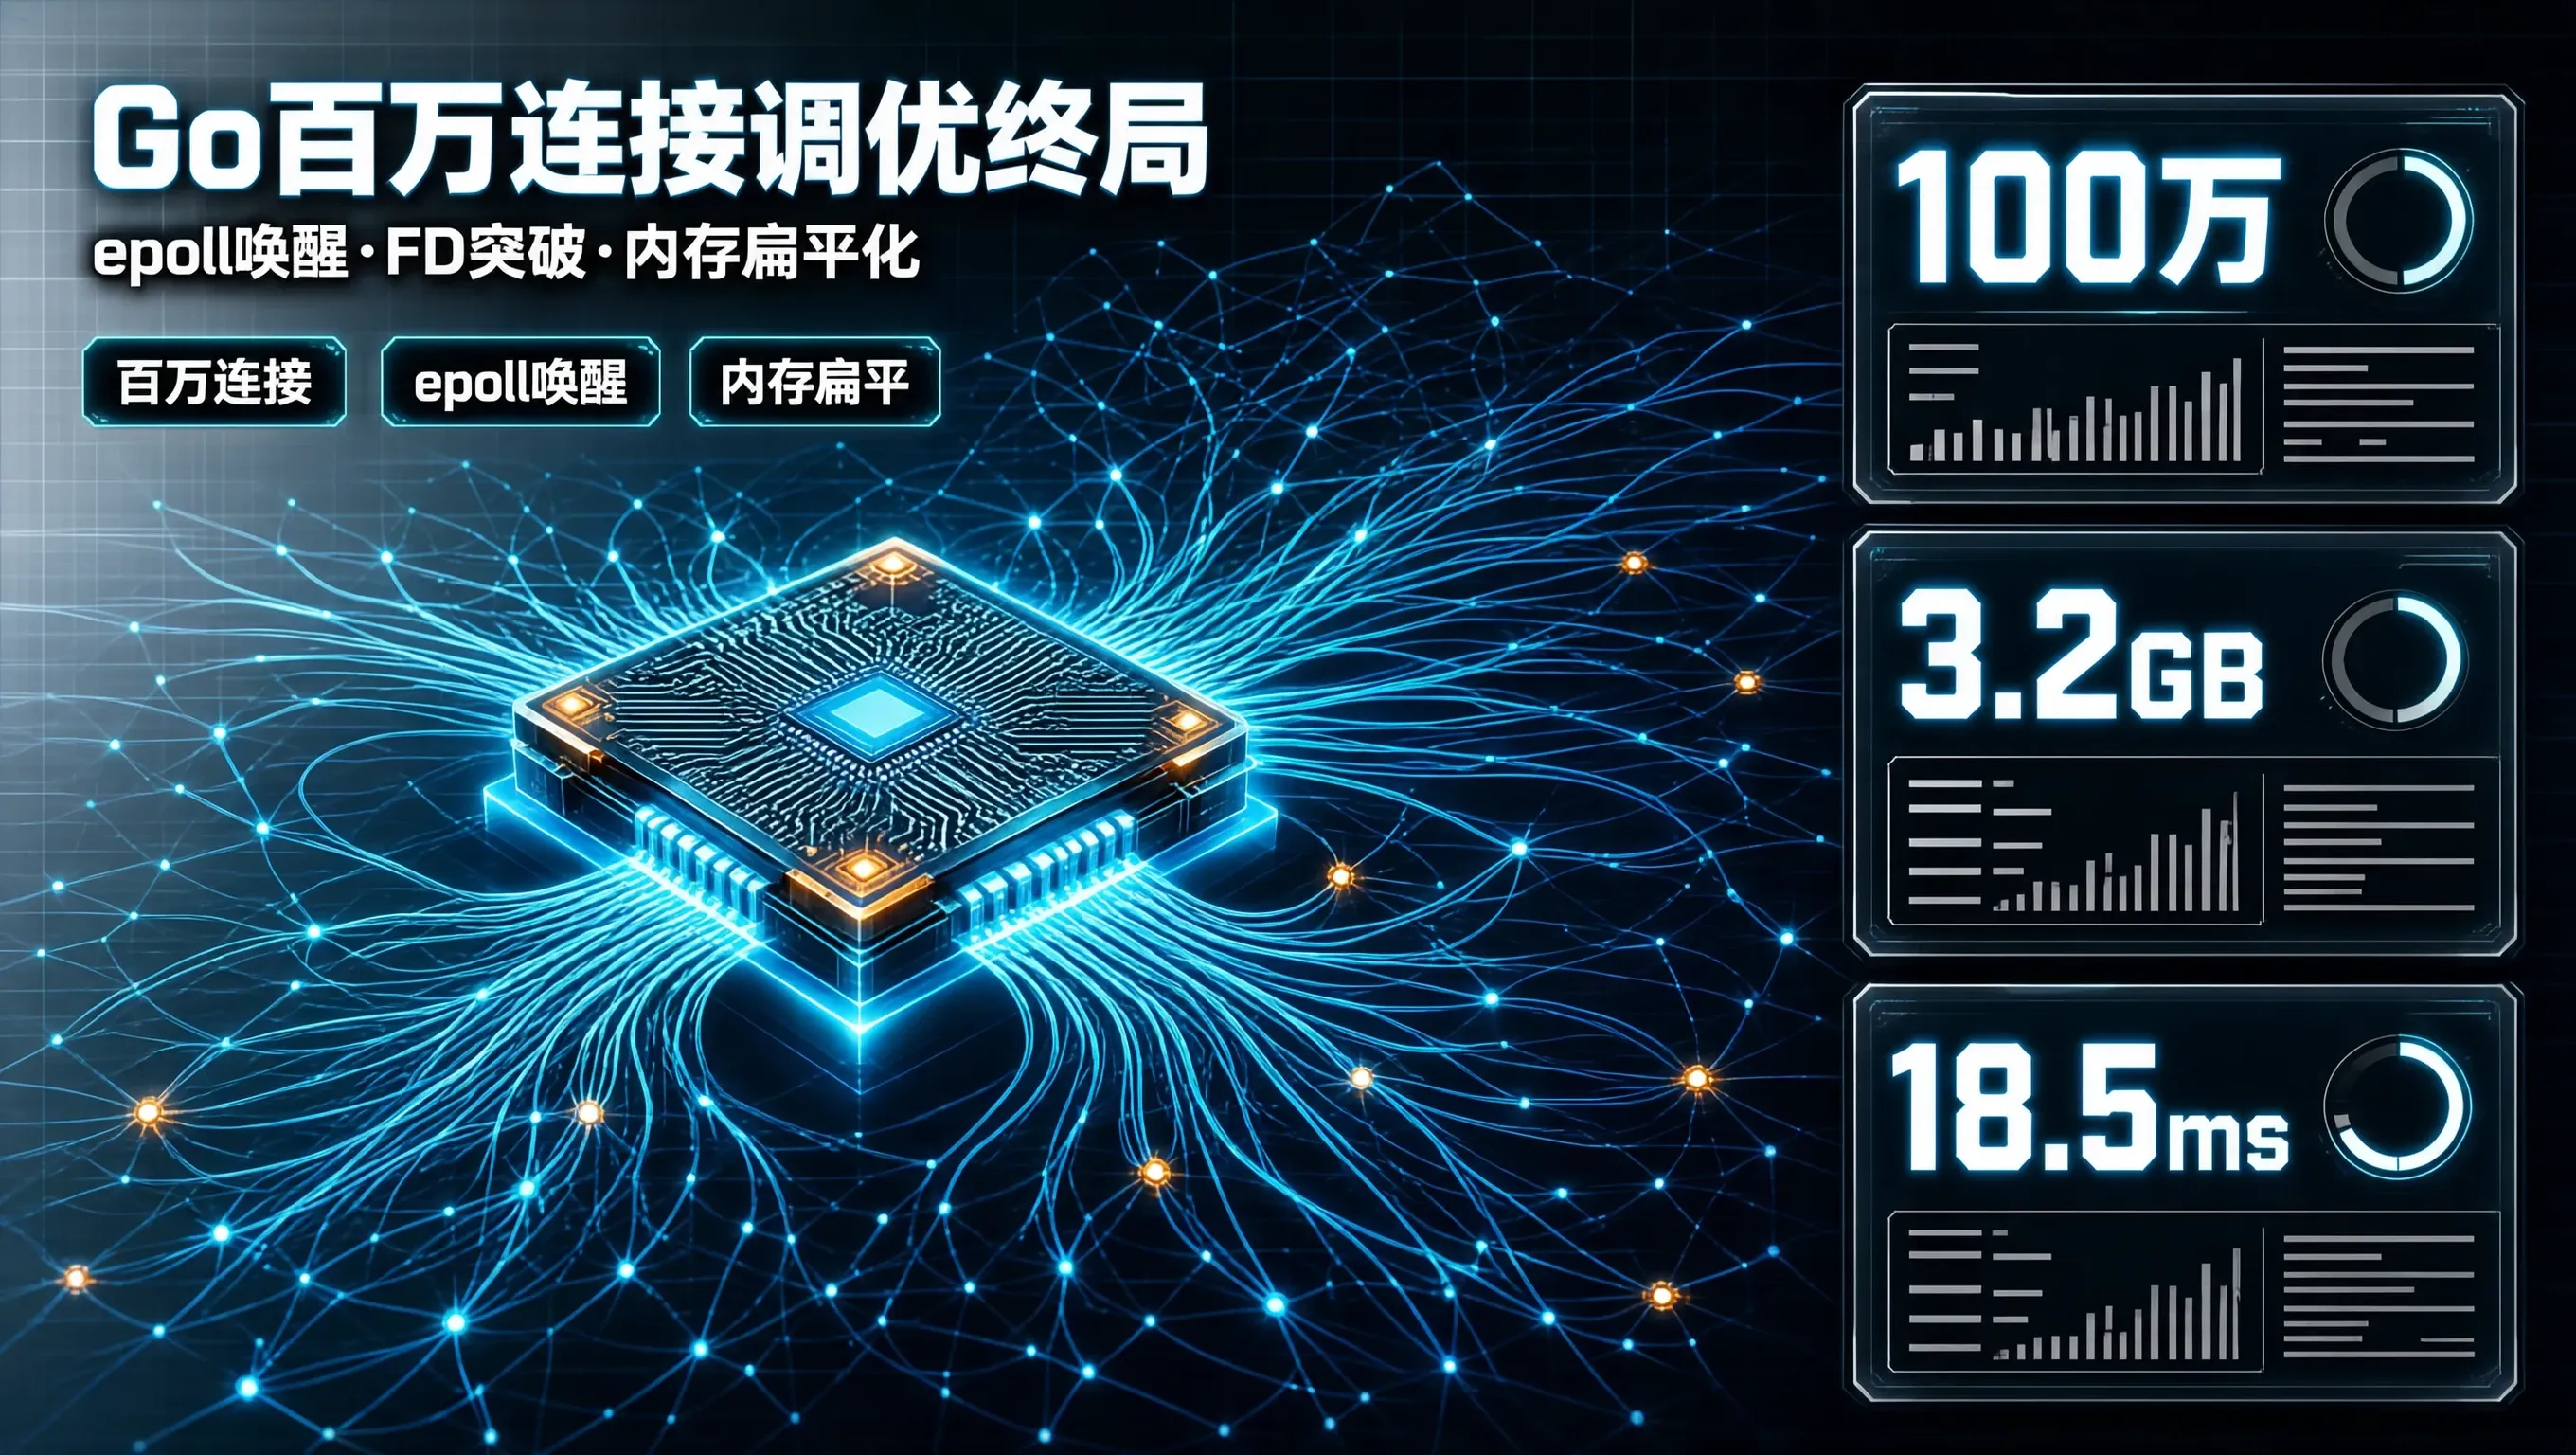
先调内核,再写代码:操作系统内核是承载高并发的地基,FD 上限和 TCP 缓冲区大小是无法逾越的物理红线。海量长连接坚决抛弃“一连接一协程”:在海量空闲连接(如 IoT、消息推送)场景下,Reactor 异步事件驱动是降本增效的终极答案。敬畏内存分配:在网络包编解码中,全面推行sync.Pool字节切片复用,彻底消灭 GC 压力,系统才能在百万并发下波澜不惊。
作者:GPS排版:Alan Wang在最新一期 GitHub Podcast 中,我们围绕这些 AI 热门观点以及更多 AI 话题展开了深入讨论。热门观点会把复杂的话题浓缩成一句听起来非常笃定的话。因此,它们非常适合引发互动,却未必有助于真正理解问题。从表面上看,它们并没有那么重要。你赞同、反对、转发、争论几分钟,然后继续做自己的事。有时候,这个观点方向上是对的;有时候,它完全就是无稽之谈。热门观
在私有化或 SaaS 模式的 RAG(检索增强生成)系统交付上线后,很多小厂往往会遭遇一种始料未及的“财务危机”:系统刚上线一周,客户的某些终端用户出于好奇或恶意,编写了多线程爬虫脚本对智能问答接口进行暴力抓取;或者某个员工将大模型问答机器人的 API Key 泄露到了公开网络。当小厂拿着账单去找甲方结算超额费用时,甲方往往以“系统存在安全漏洞、缺乏防刷机制”为由拒绝买单,双方陷入激烈的商务撕扯。
包括:大模型学习线路汇总、学习阶段,大模型实战案例,大模型学习视频,人工智能、机器学习、大模型书籍PDF。带你从零基础系统性的学好大模型!😝有需要的小伙伴,可以保存图片到。
本文介绍了如何在星图GPU平台上自动化部署Kotaemon镜像,并为其集成WebRTC语音输入功能。通过该平台,用户可以快速搭建具备语音交互能力的RAG系统,实现通过语音提问、系统自动检索文档并生成答案的便捷应用场景,显著提升文档问答效率。
本文系统梳理了从零开始成为AI大模型应用开发工程师的学习路径,涵盖数学编程基础、机器学习、深度学习及大模型实战应用。强调通过理论学习与项目实践结合,掌握Transformer架构、RAG、Agent开发与模型微调等核心技术。虽提及“3个月速成”捷径,但核心仍倡导扎实积累与持续学习,助力从业者高效入行,把握高薪就业机遇。
随着AI技术从辅助工具走向自主决策,软件开发的范式正从'功能驱动'转向'智能体驱动'(Agentic)。智能体(Agent)不再被动等待指令,而是主动理解用户目标、拆解任务并调用各类工具完成交付。这一转变不仅改变了交互方式,更重塑了后端架构与知识管理方式。在企业级知识密集型场景中,检索增强生成(RAG)通过向量数据库使大模型能够高效利用私有知识库,而LangGraph则为复杂任务的流程编排提供了清
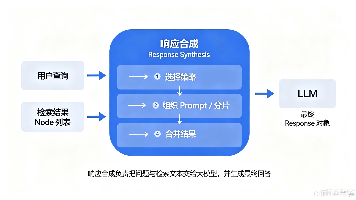
在 RAG 链路里,检索器拿到相关文档片段 (Node) 之后,把【用户问题 + 检索出来的多段文本】交给大模型,组织、合并、生成最终回答的这一整套逻辑,就叫响应合成。
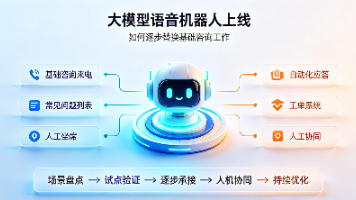
本文从任务分层、技术架构、配置要点、灰度发布、排查逻辑和评测指标出发,说明大模型语音机器人如何逐步替换基础咨询工作。核心结论是:替换不应一次性完成,而应按 L1 标准问答、L2 多轮信息收集、L3 业务查询、L4 复杂异常分层推进;先做坐席辅助,再做自动应答,再做任务办理,后续进入人机协作。关键依赖 ASR、意图识别、RAG、对话管理、TTS、业务 API 与监控体系。
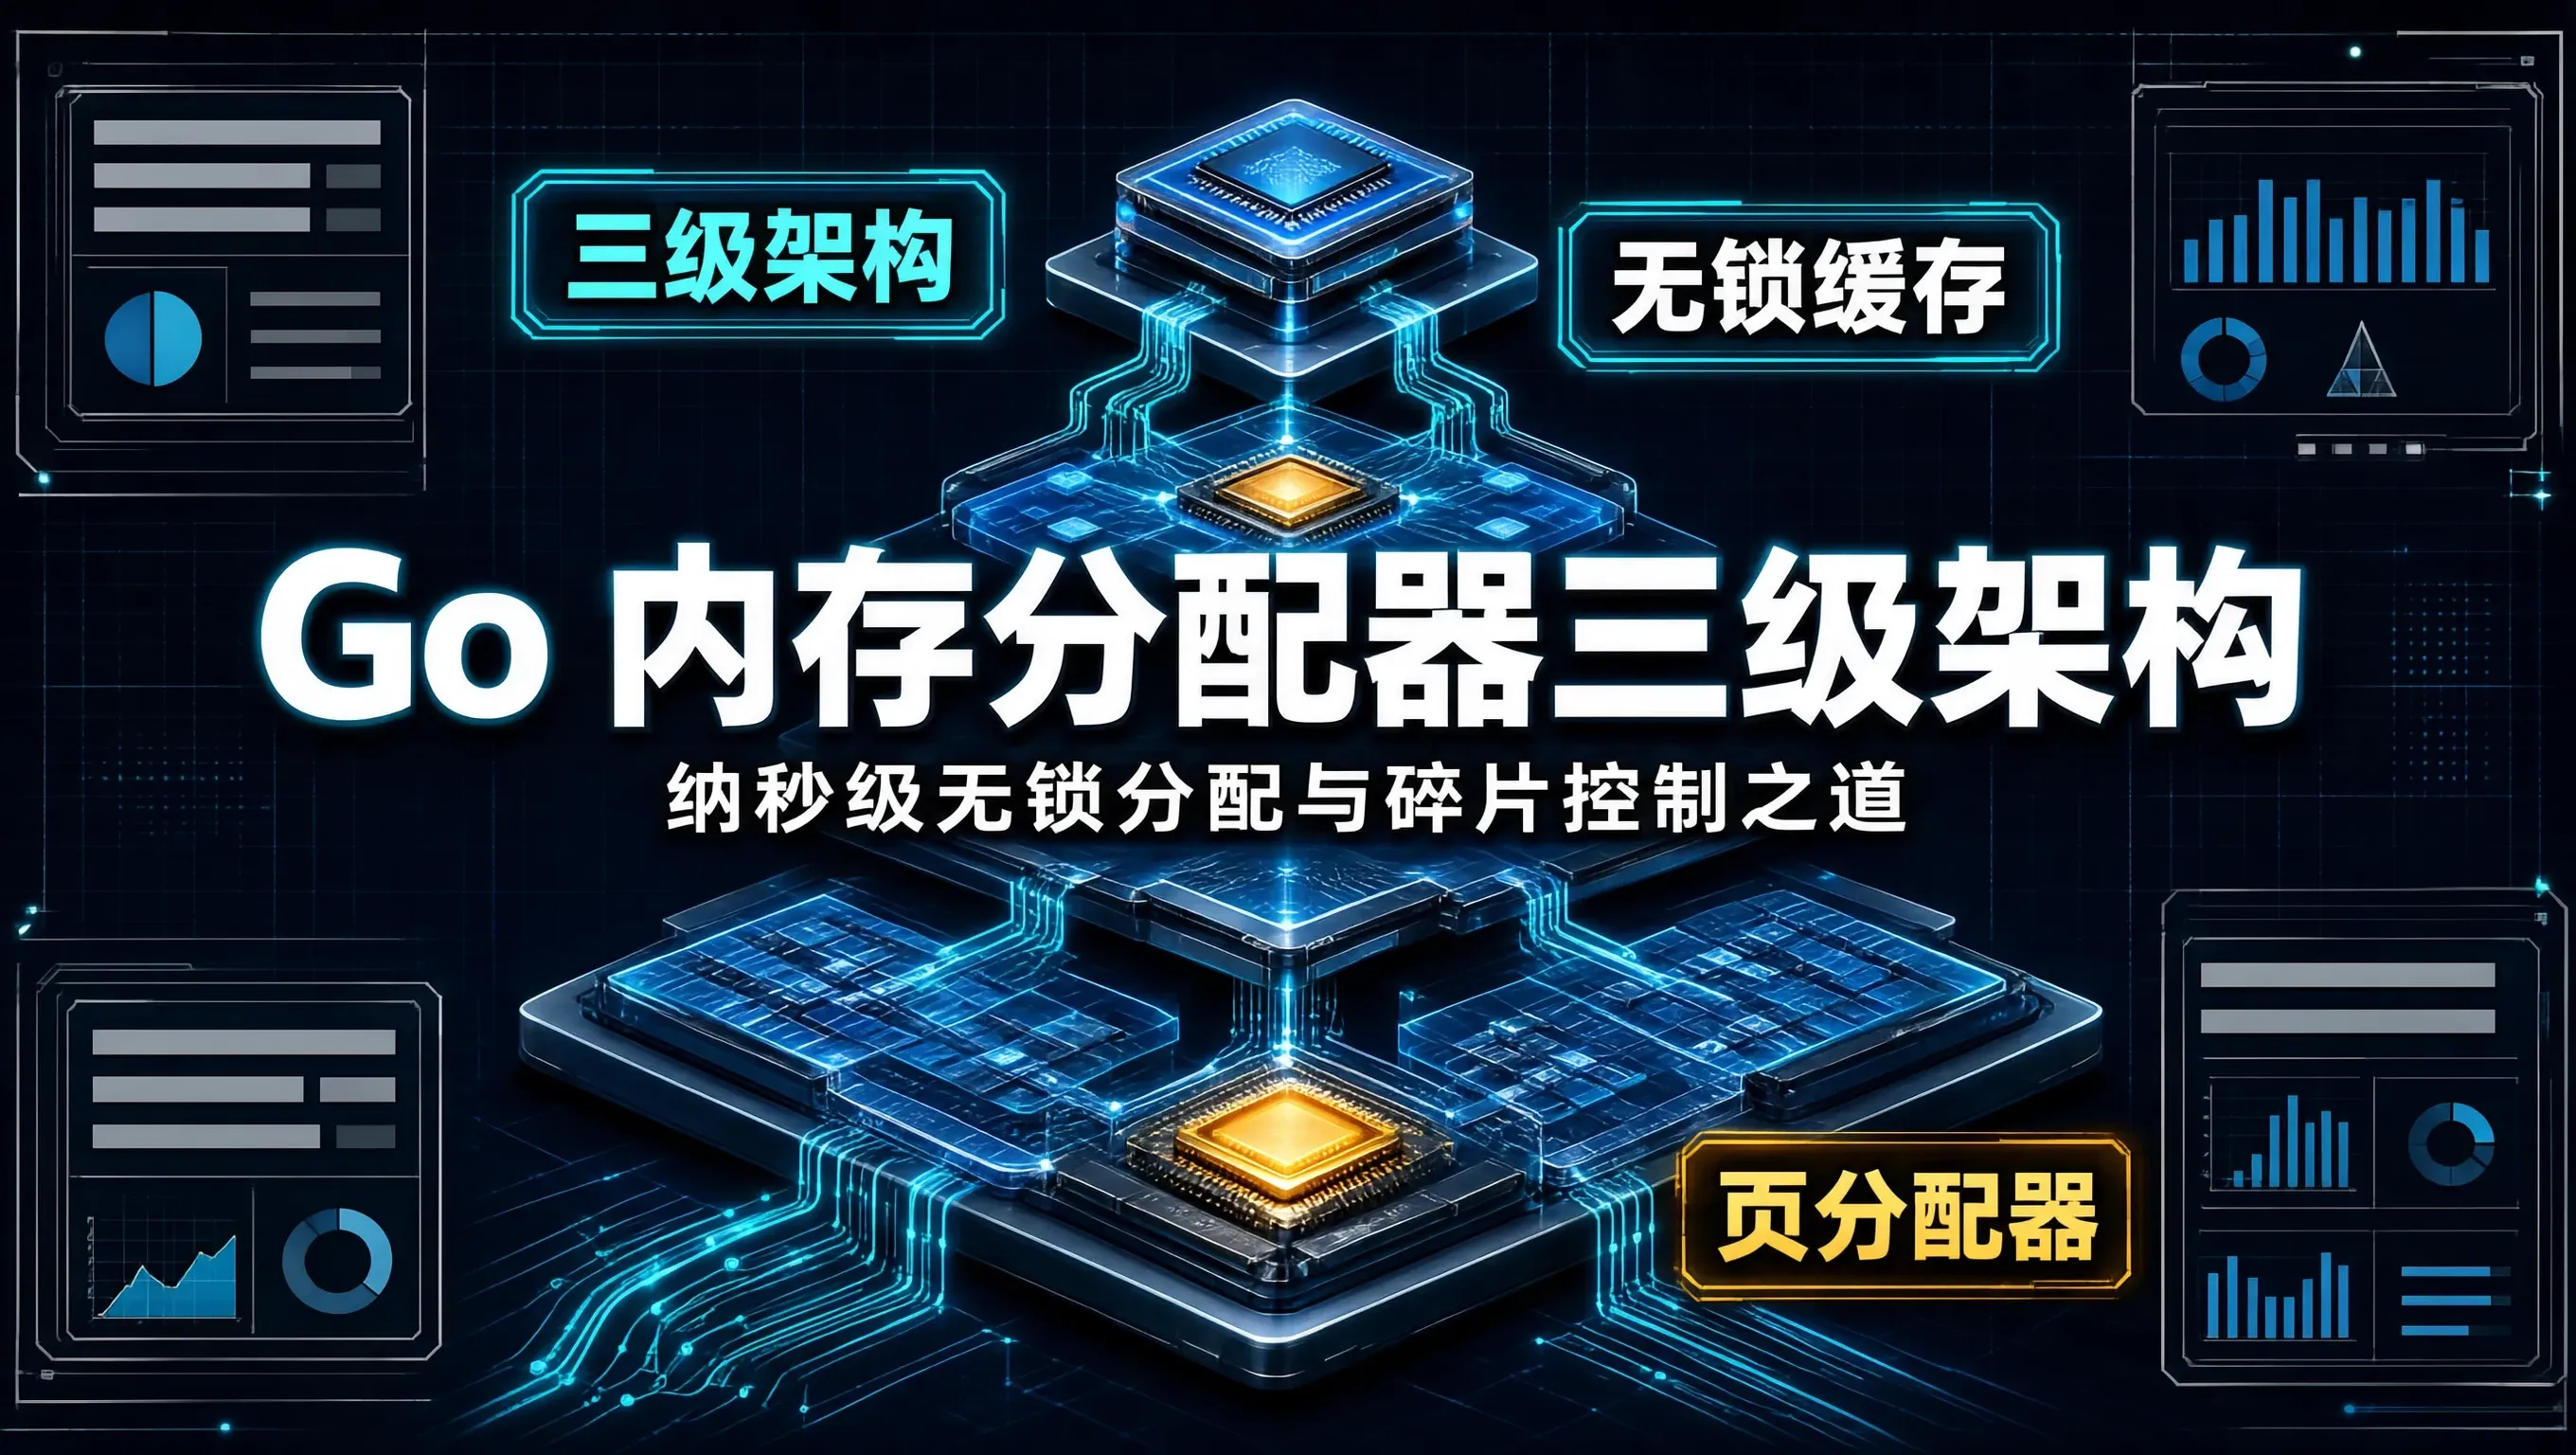
在现代高并发后端服务中,内存分配的速度与碎片控制直接决定了系统的并发吞吐上限。如果每个 Goroutine 分配一个小对象都要向操作系统发起一次内核态的malloc或brk/mmap系统调用,不仅会有严重的内核上下文切换开销,多线程并发争抢全局锁还会让性能瞬间瘫痪。Go 语言在用户态实现了一套极其精密的。mcentralmheap今天我们深入 Go 官方运行时源码(mcache.gomheap.g
本文介绍基于LangChain与RAG技术的校园AI智能问答助手,采用FastAPI+Vue3前后端分离架构,整合学籍、宿舍、图书馆等多源文档,通过Chroma向量库与通义千问接口实现精准检索生成。系统支持学生多轮问答、会话管理、来源追溯及点赞点踩,管理员可进行知识库维护、参数配置与日志审计。测试表明,系统有效避免“幻觉”,回答可追溯,满足本科毕设工程规范要求。
本文详细介绍了如何利用Java与通义千问大模型,结合RAG(检索增强生成)技术构建企业级知识库智能问答系统。通过Spring AI Alibaba框架,开发者可以高效实现文档向量化、智能检索与精准答案生成,确保数据安全与答案准确性,为企业提供可控、高效的AI知识管理解决方案。
扣子/coze 是一个 LLM 的应用开发工具,他内置了很多自己的工具,可以提供给开发者直接使用。而且他还提供了自定义相关插件的功能,那么我们就可以结合他的自定义的能力扩展出很多的能力,从而可以构建我们自己的应用程序。
2026年9月11日,工信部信息技术发展司正式对外发布《"人工智能+软件"专项行动实施方案》(工信部信发〔2026〕209号,文号日期2026-09-02)。这不是一个孤立政策,它与"十五五"规划中"软件和信息服务为扩能提质重点领域"的定位一脉相承。"AI+软件"正在从技术探索期进入政策驱动期。
本文详细介绍了如何实战部署Qwen3-Reranker-8B模型,从昇腾环境配置到Dify/RAGFlow的RAG重排序服务集成。通过优化内存管理、API设计和性能调优,提升RAG系统的准确率和响应速度,特别适合中文语义理解场景。文章还分享了异常处理、安全防护和监控日志等生产级部署经验。
本文介绍了如何在星图GPU平台上自动化部署WeKnora - 知识库问答系统镜像,实现本地化、零配置的知识库精准问答。用户上传文档或粘贴文本后,可直接提问获取严格基于原文的答案,适用于法律条文解读、技术文档查询、合同要点提取等高准确性要求场景。
本文介绍了如何在星图GPU平台上自动化部署【ollama】embeddinggemma-300m镜像,快速构建轻量级文本向量服务。该模型专用于语义嵌入,可高效支撑RAG知识库检索、多语言客服工单聚类及电商商品语义搜索等典型场景,无需复杂配置即可实现开箱即用的生产级应用。
本文介绍了如何在星图GPU平台上自动化部署Flowise镜像,构建轻量级AI工作流平台。依托可视化拖拽界面与本地模型支持,用户可快速搭建RAG问答系统、会议纪要摘要助手等应用,特别适用于中小团队知识库API化与边缘设备(如树莓派)上的离线AI服务。
本文介绍了如何在星图GPU平台上自动化部署【ollama】Qwen2.5-VL-7B-Instruct镜像,构建图文混合RAG知识库。该多模态模型可原生理解图像与文本,典型应用于PDF说明书参数提取、带批注合同条款核验及UI草图交互逻辑分析等企业级文档智能处理场景。
本文介绍了如何在星图GPU平台上自动化部署BGE-Reranker-v2-m3镜像,并将其封装为高性能API服务。该模型作为RAG系统中的“文档质检员”,能够对检索结果进行精准语义重排序,有效提升智能问答、知识库等应用的答案准确性。
对于正在迷茫择业、想转行提升,或是刚入门的程序员、编程小白来说,有一个问题几乎人人都在问:未来10年,什么领域的职业发展潜力最大?答案只有一个:人工智能(尤其是大模型方向)当下,人工智能行业正处于爆发式增长期,其中大模型相关岗位更是供不应求,薪资待遇直接拉满——字节跳动作为AI领域的头部玩家,给硕士毕业的优质AI人才(含大模型相关方向)开出的月基础工资高达5万—6万元;即便是非“人才计划”的普通应
本文详细介绍了如何利用Cherry Studio、DeepSeek大模型与Ollama工具,在企业内网环境中构建一个完全离线、安全可控的RAG(检索增强生成)知识库系统。该方案通过本地化部署,确保数据隐私与合规性,并提供了从硬件选型、模型部署到多知识库管理的完整实战指南,帮助企业高效激活内部文档价值。
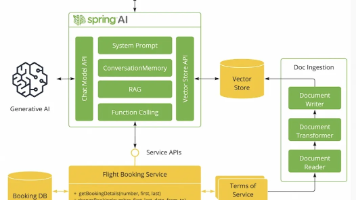
智能机票助手是基于Spring AI Alibaba构建的业务智能体应用,支持机票查询、改签等操作。系统采用RAG技术嵌入机票规则文档(如退改签政策),通过向量存储实现精准检索。用户可通过自然语言交互完成操作,如查询订单(需提供姓名和预订号)或改签航班(需确认新日期及费用)。本地部署支持Ollama运行Qwen3:4B模型。典型交互流程包括:解析用户意图→调用对应函数→检索政策条款→生成友好回复,
近期,DeepSeek-R1模型凭借其在数学推理、代码生成和自然语言推理Reasoning等领域的卓越性能,引起广泛关注,从AI界火出圈了。很少有一种技术既能充当幕后扛旗的无名英雄,又能兼具网红明星的气质。而DeepSeek做到了这一点。作为提升生产力的利器,DeepSeek正吸引着众多个人开发者与企业用户的兴趣,他们纷纷寻求在本地环境中部署DeepSeek-R1模型,以充分利用其强大的AI能力。
通过本文的详细解析,我们深入理解了类中简单融合方法的实现原理和应用方法。该方法通过选择每个节点在不同检索器中的最高评分,有效地融合多个检索器的输出结果,从而提升检索系统的准确性和全面性。希望本文能为您的编程实践提供有益的参考和帮助。
总结索引简单地将节点存储为一个顺序链。# 加载文档# 创建总结索引# 查询索引response = index.query("你的查询")
RAG 是我觉得最落地的 AI 应用形态。不用从头训模型,不用堆显卡,本质就是"查资料 + 让模型照着资料说话"。门槛低、见效快,特别适合想快点做出能用东西的人。这篇按入库和检索两条线把 RAG 的工程全景摆出来——两张图就是两条线的主干(image1 入库、image2 检索),下面一节一节讲。
本文详细介绍了如何利用豆包大模型的RAG技术结合SpringBoot框架构建智能客服知识库系统。通过检索增强生成技术,系统能够实时检索外部知识库并生成精准回答,有效解决模型幻觉问题。文章涵盖技术架构设计、知识库接入、提示词工程、系统集成与性能优化等全流程实践,为开发者提供了一套完整的解决方案。
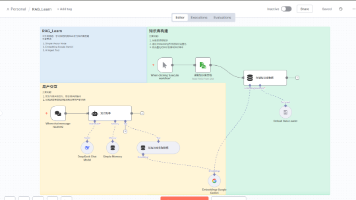
RAG技术正在改变我们与AI交互的方式,让AI变得更加可靠和实用。而RAG_Learn工作流则为想要尝试RAG技术的朋友提供了一个完美的起点。
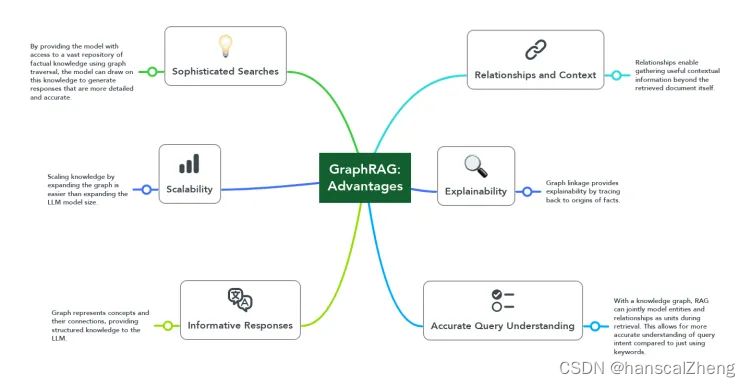
通过探讨Graph RAG未来的优化与演进方向,总结了内容索引和检索生成阶段的不同改进思路,以及RAG向Agent架构的演化趋势。论文题目:GraphRAG: Design Patterns, Challenges, Recommendations论文链接:https://gradientflow.com/graphrag-design-patterns-challenges-recommenda
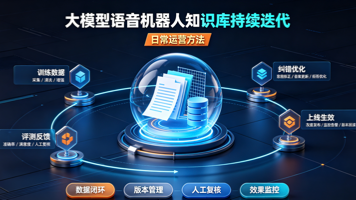
大模型语音机器人知识库持续迭代,核心是建立“采集—清洗—切分—向量化—检索—重排—生成—评测—反馈—更新”的数据闭环。日常运营方法包括:知识源统一管理、文档结构化解析、增量与全量更新结合、版本管理与灰度发布、RAG 检索增强、意图路由、提示词优化、badcase 归因、自动化评测、A/B 测试和监控告警。工程上建议将知识库运营拆分为内容运营、检索运营、模型运营和评测运营四条线,按“发现问题—定位环
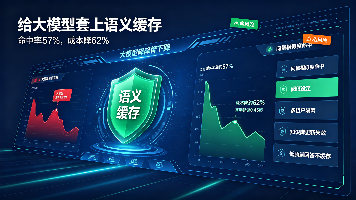
客服机器人上线两周,用户问题高度重复,每次都走完整套RAG,数据库读QPS翻三倍,大模型账单飞涨。文章讲清语义缓存怎么用"向量相似度"代替"字符串相等"去命中重复提问,落地时数据该存哪、相似度阈值怎么定,以及多租户隔离、知识库更新失效、别缓存低质量回答这几个真正的难点。附两周实测:命中率约57%,大模型成本降约62%,命中时首字延迟从3.2秒降到0.45秒。
AI Agent平台是当前企业智能化升级的核心基础设施,其本质是将大模型能力封装为可编排、可扩展、可验证的服务系统。技术原理上依赖RAG检索增强、本地化LLM调用、结构化工作流引擎与轻量级向量存储四大支柱。这类系统的技术价值在于降低AI落地门槛,让开发者无需深度掌握模型微调或分布式运维,即可快速构建端到端智能应用。典型应用场景包括政务知识问答、企业内部文档助手、产品技术支持机器人等对响应延迟敏感、
用户并发量上来,向量检索 QPS 打满,接口超时、响应延迟飙升;知识库百万、千万级 Chunk 单向量库内存溢出、查询卡顿;Embedding 服务、LLM 推理重复计算,算力成本居高不下;无限流、熔断机制,突发流量直接打垮后端服务;多机部署知识库不同步,增量更新冲突,线上问答结果不一致。Demo 级单机 RAG 只能支撑少量测试用户,面向企业内部千人、对外公网 C 端用户,必须一套完整分布式工程
我以前觉得,支付系统工程师的护城河是"懂支付技术"。现在我觉得,护城河是"懂支付业务"——那些在代码里看不到的、在文档里找不到的、只在日复一日的对账和排障中积累出来的业务直觉。AI能做清算,但它不知道这个商户为什么在凌晨2点交易。AI能做风控,但它不知道这笔交易背后的业务模式合不合理。AI能做对账,但它不知道这条差异该忽略还是该追查。那些"不知道"的东西,就是我四年的价值。
本文详细介绍了如何利用Python与Qdrant构建段落感知型RAG系统,解决n8n文本分割中的语义断层问题。通过智能段落识别算法和元数据继承机制,显著提升技术文档和法律合同的处理准确率。文章还提供了Qdrant集成实战技巧和效果验证方法,帮助开发者优化知识库构建流程。
本文介绍了如何在星图GPU平台上自动化部署🧠 WeKnora - 知识库问答系统镜像,构建高并发企业级智能知识库。通过该平台,用户可快速启用文档解析、语义检索与实时问答能力,典型应用于电商大促客服响应、在线教育教师备课等需毫秒级知识反馈的场景。
本文介绍了如何在星图GPU平台自动化部署cogito-v1-preview-llama-3B镜像,并实现基于LangChain的RAG增强应用。该方案能快速构建智能问答系统,通过检索外部知识库提升模型回答准确性,适用于企业知识管理、客服自动化等场景。
本文以对话体形式,剖析在 Java 生态下如何构建企业级 AI 应用,包括虚拟线程处理高并发、Spring AI 的 Prompt 注入机制、RAG 架构优化以及 Agent 智能体的 Function Calling 原理等深度技术点。
本文介绍了如何在星图GPU平台上自动化部署Flowise镜像,构建可视化AI工作流系统。基于该平台,用户可快速搭建零代码RAG聊天机器人,典型应用于企业内部知识库问答、合同条款审查等可信AI决策场景,兼顾高效性与可审计性。
本文介绍了一种混合文本分割方法,支持Markdown文档的分层处理。首先使用MarkdownHeaderTextSplitter按标题级别分割文本,保留标题结构;然后对非代码块内容进行语义分割。系统通过状态机识别代码块(```)并保持其完整性,同时支持自定义标题级别(chunk_size/chunk_overlap)和元数据保留。该方案实现了文档的结构化处理与内容保护的平衡。
本文介绍了如何在星图GPU平台上自动化部署【ollama】embeddinggemma-300m镜像,快速构建本地化RAG(检索增强生成)系统。该轻量级嵌入模型专为语义检索优化,适用于企业知识库问答、技术文档智能检索等典型场景,支持离线运行与多语言理解,显著提升私有知识检索的准确性与响应效率。
本文介绍了如何在星图GPU平台上自动化部署Flowise镜像,构建轻量级本地AI工作流系统。依托星图GPU的容器化能力,用户可快速启用拖拽式RAG知识库问答服务,适用于企业文档智能检索、离线教育助手等典型场景,实现数据不出域的可控AI应用。
本文介绍了如何在星图GPU平台上自动化部署BGE Reranker-v2-m3重排序系统镜像,显著提升RAG与智能搜索场景下的语义匹配精度。该镜像支持中英混合查询与本地离线运行,典型应用于政务知识库问答、企业私有文档检索等需高隐私保障与强中文理解能力的业务场景。
RAG
——RAG
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 DAMO开发者矩阵

 openEuler 社区

 微软开发者社区
 亚马逊云科技技术品牌专区

 火山引擎视频云技术社区


 HarmonyOS开发者社区

 AI硬件创业社区


 AI Agent技术社区

 乐奇 Rokid 开放社区










 天工造物局