- @python12345_


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
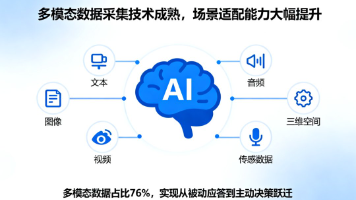
本文全景扫描了2026年AI产业发展格局,核心聚焦AI从技术概念验证到产业价值兑现的转型。文章指出,AI产业规模高速扩容,进入规模化落地关键拐点,技术重心转向智能体、具身智能等落地型技术。数据采集体系升级是核心底气,企业级数据采集普及率大幅提升,多模态数据采集技术成熟,算力基础设施全面兜底。文章还盘点了金融科技、智能制造、医疗健康、消费零售、智慧教育、文旅服务六大细分赛道的现状与前景,并预判了未来
在市场上,我们总能听到“AI正在摧毁一个时代”之类的关于AI的负面言论,但以目前的情况来看,普通人其实很难拒绝AI带来的便利。对汽车厂商来说,AI大模型进入座舱后所产生的影响是近乎颠覆的,它不仅可以提供更快更高效更安全的人机交互方式,还能大幅降低厂家用于维系用户关系的成本,所以,AI大模型就是接下来智能座舱的新风向、新趋势,也是今后智能座舱的最佳打开方式。可以这么说,在“软件定义汽车”时代,汽车厂
2026 年一晃已经过半,AI 大模型的热潮不仅没有降温,反而持续升温!金融行业用大模型做风控、医疗依靠 AI 解析影像,电商、制造、教育各行各业,都在把 AI 融入日常业务。曾经热闹的 “百模大战”,早就告别单纯比拼模型参数,正式进入落地应用时代。懂业务、懂 AI、能做出可上线项目的大模型开发工程师,岗位缺口大,薪资待遇十分可观。风口再好,不如手握高薪 offer 实在。行情火热,普通人、程序员
本文将深入探讨如何使用和来构建一个的智能聊天机器人。

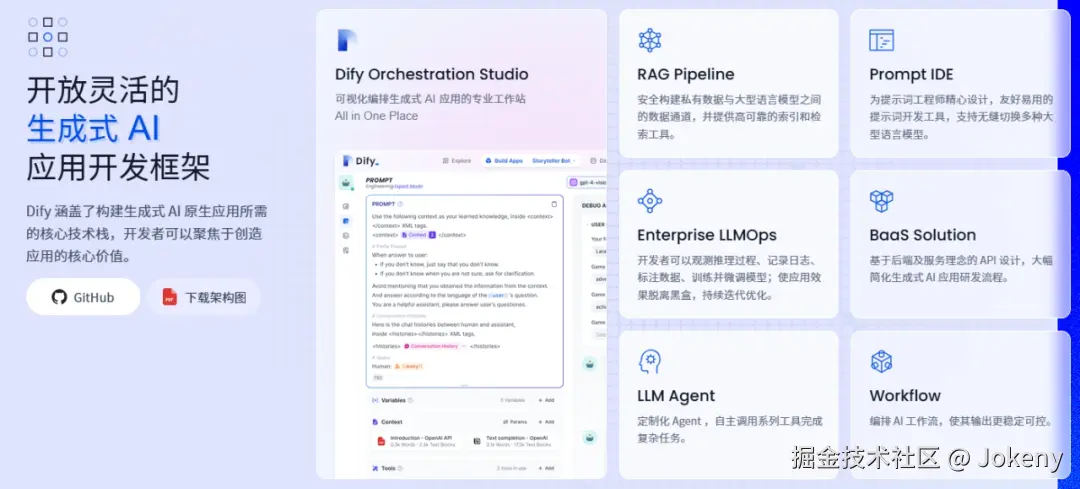
Dify 是一个开源的 LLM(大语言模型)应用开发平台,功能超强大。它支持自定义 AI 工作流,能实现复杂任务自动化;还有 RAG 管道,通过检索增强生成技术,让文档检索和问答超准;多种主流 LLM 模型都能集成管理,还提供丰富的日志和监控功能。Dify 的架构也很清晰,分为模型层、数据处理层、应用层和管理层,能满足各种需求。通过 Ollama + DeepSeek + Dify 这个组合,企业
风笛:这是一个非常好的问题,在人工智能算法领域,我们经常会遇到这类问题。通常会有几种路径迭代算法。第一种路径是从现有数据和系统体验中找到问题,然后再去工业界或者学术界寻找方法。在这种情况下,它有钉子存在,需要寻找哪把锤子能将钉子击中,解决问题。你提到的问题则是学术界先行提出方法。通常在论文中会报告这种方法在哪些数据集上具有优势,比搜索基线要好很多。我们需要特别关注主要方法,例如在contribut
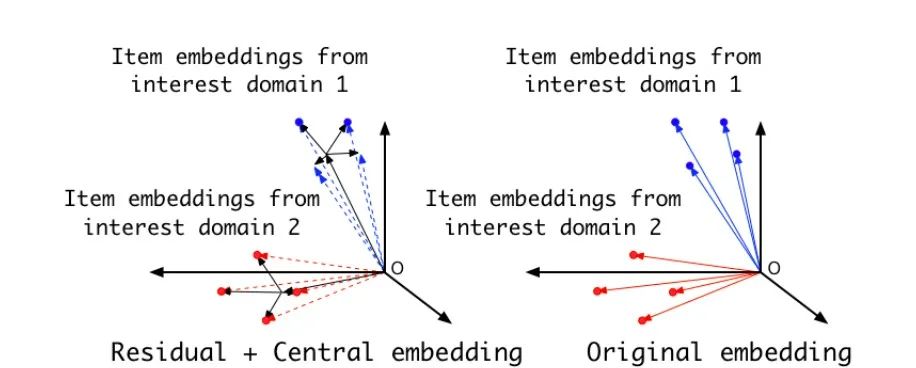
推荐或者 CTR 预估任务有一个很突出的特点:存在海量稀疏特征。海量意味着数量巨大,稀疏意味着即使在很大的训练数据里,,这往往是由于引入了大量 ID 类特征带来的。对于 DNN 排序系统,是否能够找到好的特征 Embedding 表达方式,对于系统效果是至关重要的。虽然说,如何更好地表征稀疏特征对于模型的泛化能力至关重要,但是,关于这块的研究,除了经典的特征 Onehot 到稠密 Embeddin
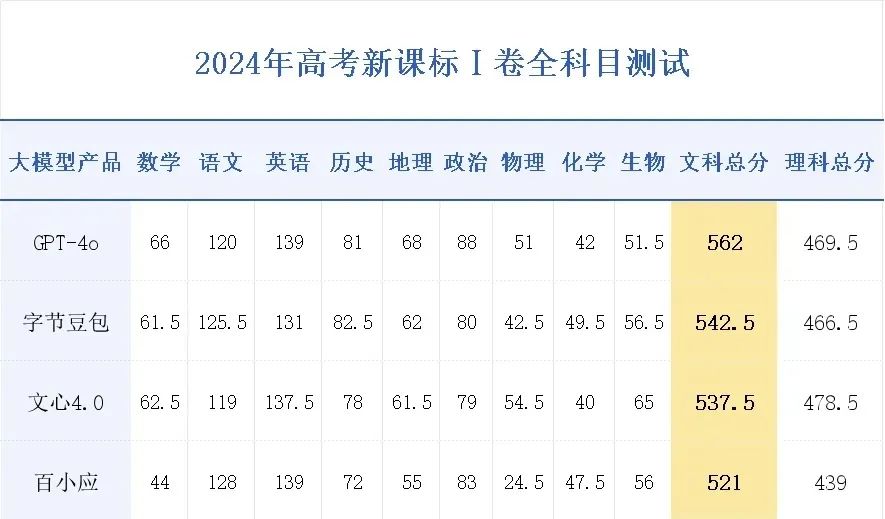
什么?好多大模型的文科成绩,还是最卷的???
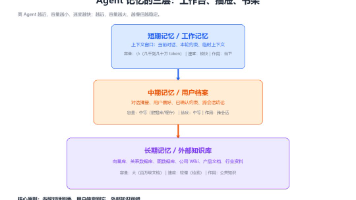
中期记忆的核心是摘要。但很多人一听"摘要"就头大:每次对话完了都让模型写一段总结,会不会很慢?总结写多长合适?历史摘要要不要再摘要?我分享一个我们自己用过、效果还行的做法,叫"双层摘要"。第一层:会话级摘要。每次会话结束,让模型生成一段 200 字以内的总结,包含三个字段:用户画像更新、已确认约束、本次结论。用户画像:电商从业者,关心 ROI 和转化已确认约束:必须用 Python,预算 5 万以
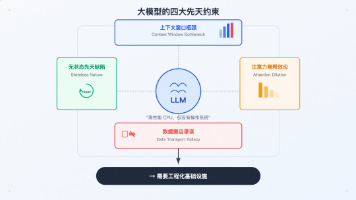
回顾一年的工程实践,有五条认知在反复验证中越来越清晰。它们不是孤立的经验,而是彼此关联、互相印证的认知网络。第一,"LLM 越跑越蠢"是个工程问题,不是模型问题。上下文中 70% 的噪音数据稀释注意力,换更大的模型也掩盖不了。这条认知的实践意义是:当 Agent 表现下降时,先看上下文质量再考虑换模型。我们在 S2 初期走过弯路——花了两周评估更大参数的模型,最终发现问题出在工具返回的 JSON