登录社区云,与社区用户共同成长
邀请您加入社区
本文介绍了如何在星图GPU平台上自动化部署【ollama】translategemma-27b-it镜像,实现本地化、隐私安全的图文翻译功能。该模型支持55种语言对,可直接解析图片中的中文等文本并输出专业级译文,典型应用于产品说明书、技术文档及多语种电商资料的即时翻译。
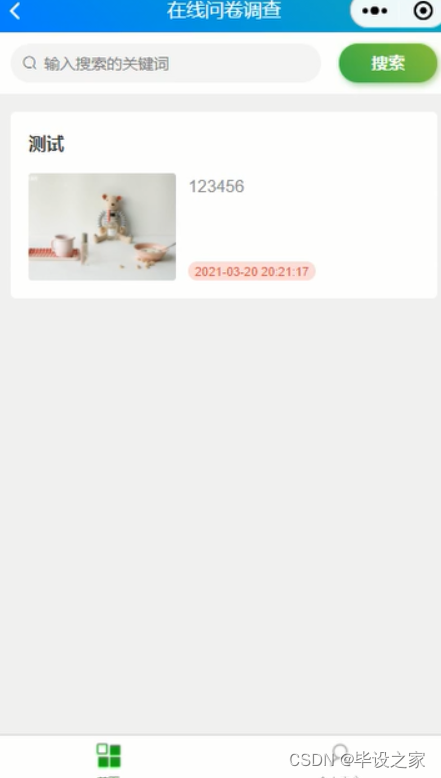
在设计时对微信客户端进行了充分的了解,掌握微信平台通过的接口,同时系统采用Java技术进行开发,MySQL数据库进行数据的储存,充分的保证了系统的稳定性、安全性,基于微信平台的在线答题小程序实现了客户端和服务器端两部分,实现了在线答题相关信息的查询管理功能。微信是目前国内使用最多的社交软件之一,有庞大的用户群体,便于调查者获取不同年龄段不同层次和地方的市场情况和用户需求,而且利用微信小程序调查,用
本文介绍了如何在星图GPU平台上自动化部署【ollama】translategemma-12b-it镜像,实现高精度图文联合翻译。该模型支持上传英文产品图、说明书截图等图像,自动识别并输出符合专业语境的简体中文译文,广泛应用于技术文档本地化、跨境电商合规标签处理等场景。
本文介绍了如何在星图GPU平台上自动化部署HY-MT1.5-1.8B镜像,构建高并发多实例翻译服务集群。通过端口隔离与Nginx+Lua负载均衡,可稳定支撑500+ QPS,典型应用于跨境电商批量商品描述翻译、在线教育实时字幕生成等场景,实现低延迟、高可用的工业级机器翻译服务。
本文介绍了如何在星图GPU平台上自动化部署【ollama】translategemma-12b-it镜像,实现高保真图文翻译功能。该轻量级翻译模型支持上传PDF截图、技术文档图片等,自动识别并精准翻译多语种文本,适用于企业内网文档处理、离线技术资料翻译等典型场景。
本文介绍了如何在星图GPU平台上自动化部署【ollama】translategemma-12b-it镜像,实现本地化、高精度的多语种图文翻译。该轻量级专家模型支持55种语言互译及截图OCR+翻译一体化,适用于技术文档本地化、App界面截图翻译等典型场景,兼顾隐私安全与边缘设备部署能力。
这段文字详细讲解了 Pandas 库中 axis 参数的使用方法。首先,它回顾了 axis 参数在 drop 方法中的作用,解释了 axis=1 表示删除列,axis=0 表示删除行。然后,它通过 drinks.mean() 例子展示了 axis 参数在计算平均值时的作用。默认情况下,axis=0,表示计算每列的平均值。最后,它总结了 axis 参数在 Pandas 中的普遍用法:当一个方法...
本文介绍了如何在星图GPU平台上自动化部署【ollama】translategemma-4b-it镜像,实现本地化图文双模翻译。无需独立GPU,仅凭CPU即可完成外文文档、菜单截图、路标图片等多场景的高精度多语言翻译,兼顾隐私安全与专业术语准确性。
在前端开发中,使用这类流式渲染Markdown文字渲染错乱、出现乱码标签闭合异常、样式失效渲染一半突然中断、格式全乱控制台无报错,但页面渲染就是不符合预期排查代码、核对markdown语法、升级库版本都无效?真相只有一个:浏览器自带的自动翻译功能,正在偷偷破坏流式渲染的DOM结构!本文结合源码原理,深度拆解浏览器翻译+流式markdown的冲突根源,并给出一站式解决方案,彻底解决渲染异常。所有流式
本文介绍了如何在星图GPU平台上自动化部署【ollama】translategemma-27b-it镜像,实现本地化多模态图文翻译。无需依赖云端API,用户可快速完成中英等55种语言的专业技术文档、说明书截图的高精度翻译,适用于隐私敏感场景下的离线内容处理。
本文介绍了如何在星图GPU平台上自动化部署【ollama】translategemma-27b-it镜像,实现本地化图文翻译功能。用户无需联网即可快速处理菜单、说明书、商品图等含中文的图片,精准输出专业英文译文,适用于跨境电商、技术文档本地化及外语学习等典型场景。
本文介绍了如何在星图GPU平台上自动化部署【ollama】translategemma-4b-it镜像,实现本地化多语言图文翻译。该轻量级模型支持55种语言,可直接识别并翻译图片中的外文文字,典型应用于跨境电商商品包装翻译、旅行路标识别及学术图表本地化处理,兼顾隐私性与响应速度。
本文介绍了如何在星图GPU平台上自动化部署【ollama】translategemma-12b-it镜像,实现高精度图片文字翻译。该模型支持端到端图像输入,无需OCR预处理,可直接将菜单、说明书、导览牌等真实场景图片中的英文内容精准翻译为简体中文,显著提升跨语言信息获取效率。
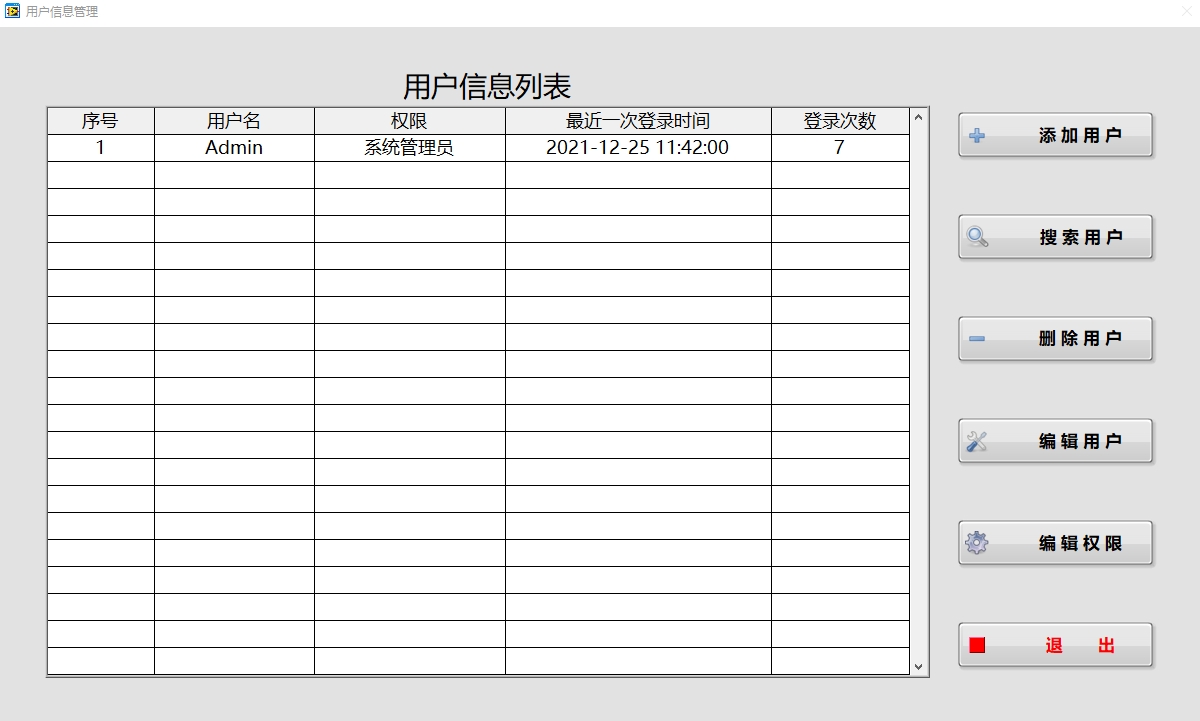
最近翻出个LabVIEW 2018的老框架,意外发现这玩意儿完美平衡了灵活性和上手难度——不用啃TestStand手册,也不用被面向对象编程劝退,实测三小时就能让产线动起来。玩自动化测试的尽头,果然还是得会偷懒啊。权限管理可能是最有趣的部分,十级权限其实用了个取巧的设计:用户登录后把权限等级转成枚举常量,每个关键操作前先用条件结构过滤。基于LabVIEW 2018开发的自动化测试系统源码,该系统模
巴黎餐厅里的随口交流、加拿大同事开的线上会议、法国客户发来的商务邮件,虽然都写着“法语”,真正需要的翻译能力并不完全相同。TransyncAI(同言翻译)目前支持法语实时翻译,可以在会议、通话和普通对话里显示双语字幕,同时提供法语 AI 语音播放。语音识别、语义转换、延迟、术语、记录和后续复核都会影响最终结果。如果系统把 quinze,也就是 15,识别成 cinquante,也就是 50,后面的
藏文翻译真机体验地址安卓:http://tapp.51goods.vip/app_resources/zhhy.apkios:https://apps.apple.com/cn/app/%E8%97%8F%E6%B1%89%E7%BF%BB%E8%AF%91%E9%80%9A/id1533907354藏文翻译官方文档uniapp官方提供的API: uni.share藏汉互相翻译,代码注册微信开放平
腾讯开源轻量级翻译大模型Hunyuan-MT-7B,该模型在WMT2025机器翻译比赛中以7亿参数斩获30项冠军,支持33种语言互译。其创新在于:1)参数效率高,推理速度快30%;2)上下文理解强,能处理俚语、古诗等复杂文本;3)推出集成模型Hunyuan-MT-Chimera-7B,可组合多模型提升专业翻译准确率。目前该技术已应用于腾讯会议、企业微信等产品,服务超10万开发者。腾讯将持续开源优化
在信息爆炸的时代,我们时常会接触到来自全球各地的 PDF文档,其中不乏夹杂着复杂数学内容与多种语言文字的资料。从前沿学术期刊里满是公式的科研论文,到跨国公司的商务报告,这些文档蕴含着宝贵信息,却因语言与格式问题,成为我们获取知识、推进工作的阻碍。今天要为大家介绍的PDFMathTranslate,正是一款能突破这些障碍的强大工具,它将带领我们轻松跨越语言与数学的双重门槛。
本文介绍了开通和使用谷歌翻译API的完整流程。主要步骤包括:1)创建新项目;2)启用Translation API;3)生成API密钥。随后可在简数采集器等工具中使用该API进行批量翻译,支持多语种,并能将翻译结果自动发布到WordPress、Zblog等主流CMS系统。整个流程操作简单,无需编程基础,适合大众用户快速实现网页数据采集和高质量翻译。
使用的是torchtext中自带的数据集Multi30k, 直接可以使用内置的API函数即可下载# 默认下载的路径为: /root/.torchtext/cache/Multi30k├── val.de├── val.en# 定义特殊字符及其对应的索引值# 确保标记按其索引的顺序正确插入到词汇表中# 训练数据集的迭代器,# 数据集是用英文描述图像的英文语句, 然后人工将其翻译为德文的语句,有两个文
使用Transformers中的Trainer类训练自己的模型
比原生播放器的控制更灵活。🔍 主要功能亮点:适用于几乎所有网页视频平台(YouTube、B站网页版、Vimeo等)安装后页面左上角会显示。
文本翻译/文本翻译API(1积分/2000字符);文档翻译/Office文档翻译API/PDF翻译API(3积分/页);图片翻译/图片翻译API(3积分/张);语音翻译/语音翻译API(4积分/10次)。由于我们使用的是通用文本翻译高级版,每月有200万免费额度,如果超过了这个额度,需要额外付费,再加上系统加测存在一定的延时,所以我们进行额度控制是非常有效的。遇到问题请考虑换用需要密钥的翻译服务。
本文汇总涵盖了国内外大部分优秀的免费翻译接口信息,可直观对比快速找到合适的翻译接口!使用翻译接口API可以借助软件工具来实现,例如批量翻译采集的文章数据,可以用简数采集器的采集翻译工具,输入对应翻译接口的账号信息即可,不需要懂技术写代码!
实际翻译场景中,对于稀有词的翻译有困难,因为神经网络中的词表的单词是有限制的,而实际翻译的开放词汇问题。词级NMT模型:词汇表外单词的翻译可以通过回退到字典查找来。但是,这种技术所做的假设在实践中往往不成立。例如,由于语言之间形态合成程度的差异,源词和目标词之间并不总是一一对应。此外,词级模型无法翻译或生成看不见的单词。将未知单词复制到目标文本中,是一个合理的策略的名称,但形态变化和音译是通常是必
基于RNN的Seq2Seq的基本假设:原始序列的最后一个隐含状态(一个向量)包含了该序列的全部信息。(这显然是不合理的)Seg2Seg问题:记忆长序列能力不足解决:当要生成一个目标语言单词的时候,不光考虑前一个时刻的状态和已经生成的单词,还要考虑当前要生成的单词和源句子中的哪些单词更加相关,即更关注源句子中的哪些词,这种做法就叫做注意力机制(Attention)AttentionLuong等人在2
收到短剧后先不要整批上传或改名。先保存原始交付包,核对剧名、版本、总集数、缺集重号和文件可读性;再确认是净版、软字幕还是硬字幕,有没有匹配的带时间码字幕文件(如SRT)、台词表与独立音轨;随后抽查运动背景、人物遮挡、多人对白和低声台词。检查结果应明确哪些集可直接翻译,哪些要做光学字符识别(OCR)、自动语音识别(ASR)或字幕擦除,哪些必须补源或人工处理。
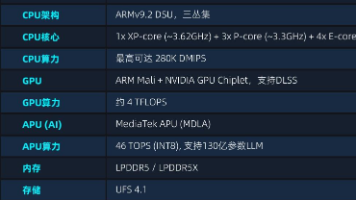
凭借业界领先的3nm制程、突破性的算力架构以及极致的能效比,MT8678不仅重新定义了车载智能体验的天花板,更在激烈的市场竞争中展现出强大的破局实力。八核异构设计:基于ARMv9.2架构,搭载“1+3+4”核心组合(1颗3.62GHz超大核+3颗3.3GHz性能大核+4颗能效小核),配合独立DVFS动态调频,CPU算力高达280K DMIPS,兼顾澎湃动力与超低功耗。安兔兔跑分高达187万,近乎竞
本文介绍了如何在星图GPU平台上自动化部署全能多语言翻译终端镜像🌏 Hunyuan-MT Pro,实现33种语言的高质量互译。该平台简化了部署流程,用户可快速搭建本地翻译环境,并将其应用于技术文档翻译、多语种内容创作等场景,充分利用GPU算力提升翻译效率与准确性。
计算机下棋是人工智能研究的经典领域。1997年IBM"深蓝"击败国际象棋世界冠军卡斯帕罗夫,成为AI里程碑。其核心是α-β剪枝算法,通过评估棋子价值和位置优势进行高效搜索。但围棋因局势评估复杂、变化无穷,传统搜索算法难以适用。即便穷举到终局,计算量也远超可行范围,导致围棋AI长期落后于人类水平。这一对比凸显了不同棋类对AI技术的差异化挑战。
本文介绍了如何在星图GPU平台上自动化部署Hunyuan-MT-7B镜像,依托vLLM实现模型权重智能卸载至CPU内存,显著降低显存占用。该镜像专为高质量机器翻译设计,支持33种语言互译,典型应用于技术文档、商务合同等专业文本的精准多语种翻译。
本文介绍了如何在星图GPU平台上自动化部署Hunyuan-MT-7B镜像,快速构建开箱即用的多语言翻译工作站。依托vLLM+Open WebUI一体化环境,用户可零代码实现藏语、维吾尔语等33种语言的高精度文本互译,典型应用于跨境电商说明书本地化、民族地区政务文件翻译等场景。
野旷天低树,江清月近人。
语义搜索是通过理解用户查询的语义(意图、概念、关系),结合知识图谱的结构化知识,精准匹配信息的检索方式。多义词(如 “苹果”→ 区分水果 / 公司 );自然语言问句(如 “《三体》作者的母校是哪所” );隐含需求(如搜 “缓解头痛的药”→ 关联 “布洛芬”“阿司匹林” 等知识 )。在知识图谱里,为 “书籍” 实体定义属性关系(如:书籍 :出版社 "机械工业出版社"前端通过 SPARQL 查询 “出
知识图谱融合是整合多源异构知识的关键技术,通过解决语言层、模型层和结构层的异构问题,构建统一的知识网络。核心内容包括:本体概念层融合(骨架拼接)和实例层匹配(实体对齐)。融合方法涉及同义词映射、语义对齐、模型转换等技术,并借助LIMES等工具实现高效实例匹配。知识图谱融合能消除"知识孤岛",实现知识互补聚合,形成从生产到消费的全流程闭环,最终构建更完整准确的知识体系。
点赞的人越来越帅!
检索增强生成(Retrieval Augmented Generation,RAG)是通过整合来自外部知识源的额外信息来改进大语言模型(Large Language Models,LLMs)应用能力的一种技术。这种技术能够帮助 LLMs 产生更精确和更能感知上下文的回复,同时也能减轻幻觉现象。RAG = 检索 + LLMsRAG分为两个阶段:第一个阶段:索引,第二个阶段:检索。有的地方理解为离线处
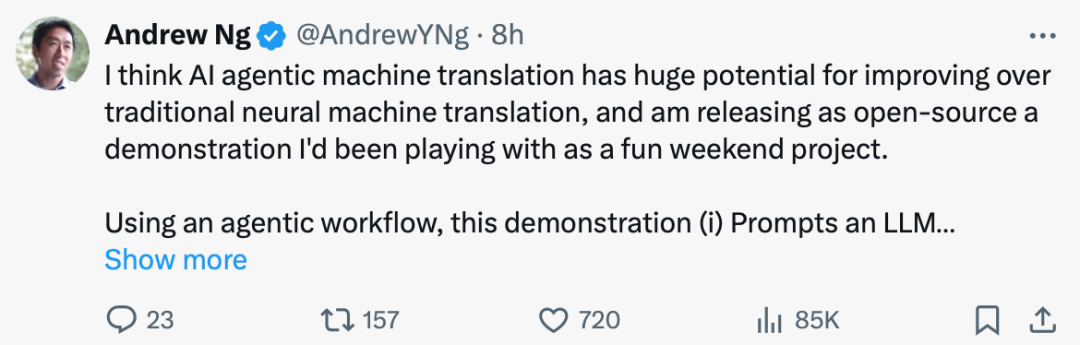
通过使用 LLM 作为翻译引擎的核心,该系统具有高度可控性。例如:通过更改 prompt,这种工作流比传统的机器翻译(MT)系统更容易实现以下功能:修改输出的风格,如正式 / 非正式。指定如何处理习语和特殊术语,如名字、技术术语和缩写。例如,在 prompt 中包含术语表,可以确保特定术语(如开源、H100 或 GPU)翻译的一致性。指定特定区域的语言使用或特定方言,以服务目标受众。例如,拉丁美洲
自然语言处理(NLP)作为人工智能的一个重要分支,近年来取得了显著的突破,特别在机器翻译、情感分析、聊天机器人等领域取得了显著的研究成果和广泛的应用。以下是对这些领域最新研究成果和应用案例的概述,并附带相应的代码实例。
一、机器翻译1. 机器翻译是指将一段文本从一种语言自动翻译到另一种语言。因为一段文本序列在不同语言中的长度不一定相同,所以我们使用机器翻译为例来介绍编码器—解码器和注意力机制的应用。10.12.1 读取和预处理数据我们先定义一些特殊符号。其中“<pad>”(padding)符号用来添加在较短序列后,直到每个序列等长,而“<bos>”和“<eos>”符号分别表示序
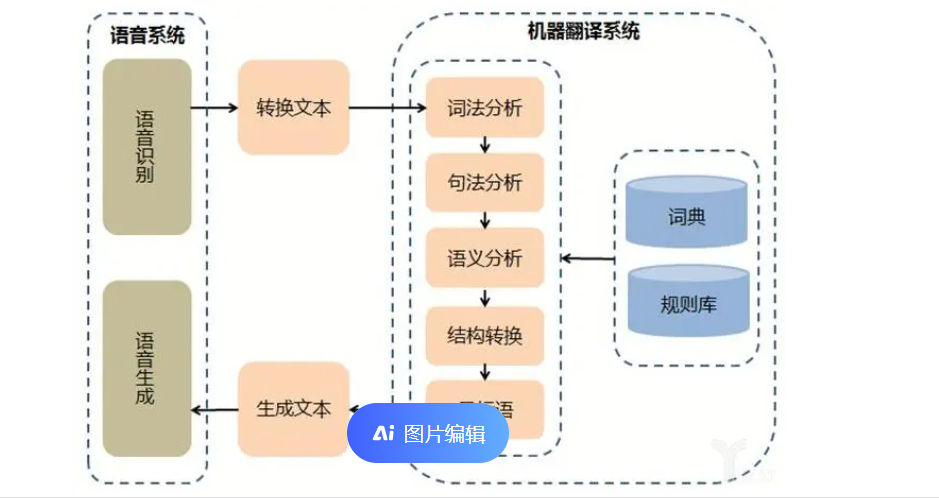
1. 机器翻译简介定义:利用计算机将一种自然语言(源语言)的文本自动翻译成另一种自然语言(目标语言)的文本。应用领域:全球化交流、多语言网站、多语种服务支持等。2. 机器翻译的核心技术自然语言处理(NLP):使计算机理解和生成人类语言的能力。词法分析:分词、词性标注、命名实体识别等。句法分析:句子结构分析,确定每个词在句子中的位置和作用。语义理解:对文本含义的理解,避免歧义或误解。自然语言生成(N
机器翻译是指将一段文本从一种语言自动翻译到另一种语言。因为一段文本序列在不同语言中的长度不一定相同,所以我们使用机器翻译为例来介绍编码器—解码器和注意力机制的应用。
自然语言处理(NLP)基础知识——机器翻译Metrics(PPL、BLEU、ROUGE)
1.背景介绍自然语言处理(NLP)是人工智能领域的一个重要分支,其主要关注于计算机理解和生成人类语言。机器翻译是NLP的一个重要应用,它旨在将一种语言翻译成另一种语言。然而,传统的机器翻译方法存在一些局限性,如无法理解语境和语义,导致翻译结果不准确。语义网络(Semantic Web)是一种网络架构,旨在使计算机能理解人类语言。它通过为网络内容添加结构和语义信息,使计算机能够更好地理解和处...
1.背景介绍自然语言处理(NLP)是计算机科学的一个分支,研究如何让计算机理解和生成人类语言。机器翻译是NLP的一个重要分支,旨在将一种自然语言翻译成另一种自然语言。在过去的几十年里,机器翻译技术发生了很大的变化。初始的方法是基于统计的,如贝叶斯网络和隐马尔可夫模型。随着深度学习技术的发展,机器翻译技术也发展到了基于深度学习的方法,如循环神经网络(RNN)、长短期记忆网络(LSTM)和Tran..
transformer模型由encoder,decoder构成,每一个encoder分为六层,每一层又分为一个前馈网络和一个多头注意力层。decoder也分为六层,每一层都由两个注意力层和一个前馈网络组成,一个是自注意力层,一个是和encoder最终输出组成的注意力层。下面是利用transformer模型实现机器翻译的简单例子,框架用的是tensorflow。训练部分import reimport
机器翻译
——机器翻译
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 乐奇 Rokid 开放社区



 天工造物局


 AI Agent技术社区


 DAMO开发者矩阵




 AtomGit开源社区