


- @Python_cocola


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
从 ChatGPT 与 Codex 的一次出图对比说起先说结论你复制过去的是同一句提示词,但没有复制模型当时所处的整个工作现场。我做了一个简单对比:网页版 ChatGPT 和 Codex 都选择 GPT-5.6 Sol,把可选的推理强度调到最高,再输入同一段提示词生成图片。我的主观感受是,网页版的结果更接近预期。如果只看这两张图,很容易得出一个结论:网页版是不是用了更强的模型?但一张图只能说明这次

论文标题:xLAM: A Family of Large Action Models to Empower AI Agent Systems论文链接:https://arxiv.org/pdf/2409.03215介绍了xLAM系列,这是一组用于自主AIagent的大型动作模型。论文的模型参数范围从1B到8x22B,通过一个可扩展且灵活的数据管道进行训练,该管道统一、增强和综合了多种数据集。

随着系统本身变得越来越复杂,比如高铁、大飞机、航天发射等,面临着效率、成本、安全等多方面的挑战,人们需要新的方法论来管理和驾驭这些技术,从简单的工具到复杂的机器系统,需要专门的“工程方法”来规范和优化使用过程。

网络安全很多技术干货,都可以共享给你们,如果你肯花时间沉下心去学习,它们一定能帮到你。

问你一个问题。你问 ChatGPT"最新的 SpaceX 发射什么时候",它瞎说——训练截止 2021 年。你问 LLaMA-70B"我公司新人叫什么",它根本不知道。LLM 不知道自己不知道什么。RAG(Retrieval-Augmented Generation)是解药。

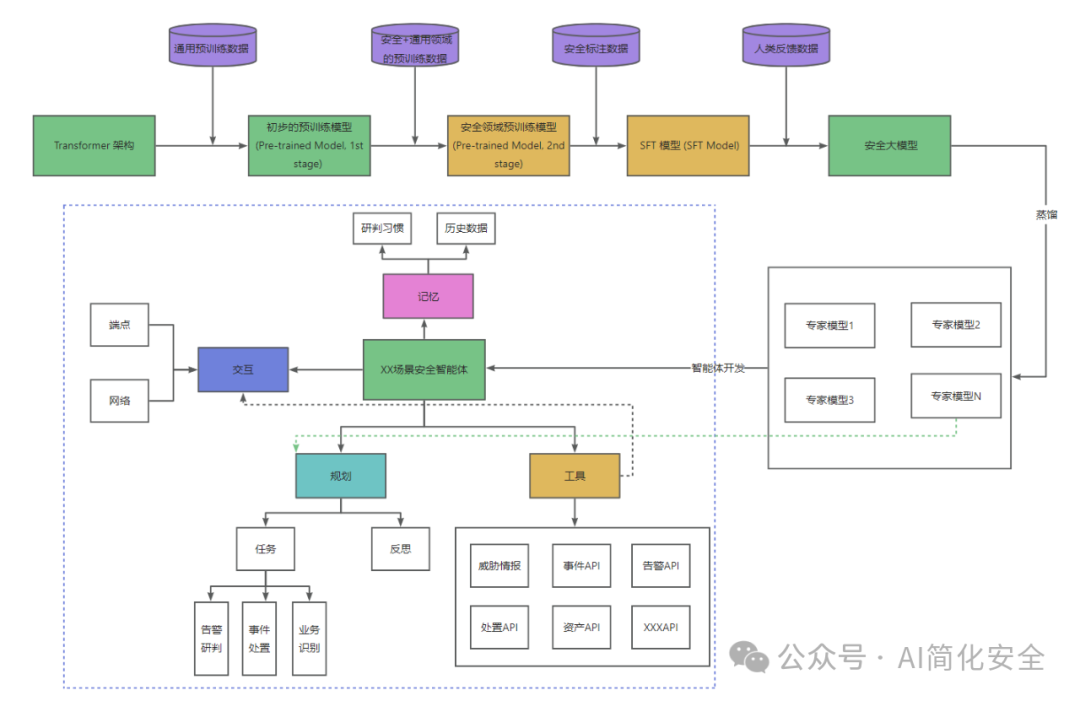
数据主要来源:外部数据包括通用和行业开源、比如智源悟道、ArXiv、GitHub等安全领域的开源数据;内部数据主要为企业内部的积累数据、比如网络安全攻击战术、网络安全日志、情报等等。数据处理过程:清洗、增强、存储、抽取等;数据配比很重要,在不同训练阶段配比也存在差异;为提高数据准备和应用环节的效果,需要建立相关的数据质量标准、评估标准和数据治理平台;利用合成数据也是一个重要的思路,比如通过gpt4
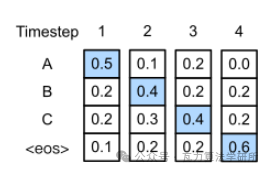
先用比较通俗的意思解释一下解码:在生成文本结果的时候,模型的输出是一个时间步一个时间步依次获得的,而且前面时间步的结果还会影响后面时间步的结果。也就是说,每一个时间步,模型给出的都是基于历史生成结果的条件概率。
前两天就有个小伙伴面阿里,在阿里二面中, 遇到一个 非常场景的面试题:
基于用户商品交互逻辑,本文设计了一种基于大语言模型的用户模拟器,用于显式地模拟用户的交互过程(如下图)。具体而言,本文通过大语言模型分析商品,生成可能的喜欢或不喜欢原因,并总结为关键词。这些关键词既基于商品的客观描述,也来源于用户的评价文本,从而涵盖了商品的客观与主观特征。在推理阶段,给定候选商品,模拟器会将其潜在的喜好/不喜欢原因与用户历史中相似商品的交互原因进行匹配,最终预测用户的交互结果。本
RAG,即检索增强生成,是一种通过整合外部数据源来增强大语言模型(LLM)的技术。一个典型的 RAG 应用包括:索引流水线(Pipeline):用于从外部数据源中摄取数据并对其进行索引,随后加载、拆分并将数据存储在 Milvus 中。检索和生成:将用户查询转换为 Embedding 向量,然后从 Milvus 中检索相关数据形成上下文,然后 LLM 上下文生成响应。文本将提供实用的操作指导,向您展
