登录社区云,与社区用户共同成长
邀请您加入社区
做人形机器人招聘时,散热这个问题很容易被低估。很多人会觉得,机器人热了,加个风扇、散热片或者导热材料就行。但整机真正开始追求高动态、长时间运行和量产以后,散热会同时影响关节、电机、电控、电池、算力平台,最后甚至限制机器人的动作能力。今年已经能看到这种变化。Tesla Optimus公开招聘的机器人热验证工程师,工作范围直接覆盖;国内也已经出现专门的“机器人关节模组热管理工程师”和“人形机器人热管理
以欧菲光人形机器人视觉方案为例,看清机器人的相机分布逻辑。头部(全局感知):集成5颗RGB相机+1颗ToF深度相机。前视眼位区域搭载2颗大角度环视RGB相机,后脑配置1颗超广角环视RGB相机,鼻嘴位置融合AI双目相机与ToF深度相机做RGBD方案。前视深度相机覆盖0.112m,负责路径规划、避障和交互;环视RGB相机支持60fps帧率,保证动态场景下的响应速度。头部相机的核心任务是看清周围有什么、
VADv2 精读:向量化端到端自动驾驶,用概率规划对动作分布建模,提升闭环驾驶表现。
变量的值可以变化,但执行调用的源代码位置可以始终不变。的意思是:根据level字符串动态找到日志方法,再输出msg。这种包装函数会把来自不同位置的日志,集中到函数内部的同一个日志调用点。在 Humble 的 rclpy 实现中,同一调用点保存的 severity 不能在后续调用中改变。
本文综述至2026年10月的视觉-语言-动作(VLA)模型进展,聚焦其从“模仿学习”向“泛化、自适应、可部署”系统演进的关键突破。核心变化包括:连续分块控制提升高频精度;跨本体适配通过SoftPrompt与人类视频预训练实现;空间理解与主动感知增强环境适应性;强化学习支持在线自改进;全身与多机器人协同扩展应用边界;技能可组合化通过超网络实现。强调需理性看待成果,避免盲目比较不同评测数据,未来竞争焦
具身智能的本质不是更强的硬件,而是消除「判断」与「行动」之间那道由人预定义的缝。本文给出一个统一具身智能与认知智能的框架,并用机器人运动会的量产机数据交叉验证。
UniAD 代码导读:基于官方仓库标准 stage2 配置,梳理输入输出、各类 Query、BEV 构建、Transformer 模块、监督损失、预测与评测流程。
SparseDrive 精读:不用稠密 BEV 栅格,以稀疏实例表示场景;对称稀疏感知与并行运动规划,再经碰撞感知重打分选出更安全轨迹。
2028 年,将是决定全球自动驾驶格局的技术交牌之年。何小鹏的时间表:预计到 2028 年下半年,端到端大模型与多模态具身智能将在特定商业场景率先完成 L4 级技术的彻底闭环,并在 2028 至 2032 年间伴随法规逐步成熟实现全球规模化扩散。杨冬生的时间表:预计在 2028 年,基于全冗余数字底盘与成熟验证标准的限定场景 L3 将全面跑通并实现工业化量产,再经过 1 到 2 年的广泛路况数据迭
Harness的本意是“马具、缰绳”,在软件工程领域通常指对核心能力进行封装、管控的中间层框架。AI Agent Harness就是面向多Agent协同场景的管控中间件,相当于所有AI Agent的“操作系统”,负责对不同能力、不同厂商、不同协议的Agent进行统一的注册、适配、编排、监控、治理,让原本各自为政的Agent可以按照业务规则协同完成复杂任务。层级能力描述核心作用生命周期管理层负责Ag
本文解析SLAM概率公式 $ p(x_{0:T}, m \mid z_{1:T}, u_{1:T}) $,阐明机器人路径与环境地图的联合后验分布含义。通过贝叶斯网络图模型,揭示运动模型、观测模型与全局不变地图之间的因果依赖关系,强调地图作为未知变量需同步估计,区别于传统定位。该框架为自动驾驶中高精度定位与建图提供理论基础,欢迎项目合作。
UniAD 精读:以规划为导向,用 query 串联感知、建图、运动预测与占用,形成统一端到端自动驾驶网络,并讨论开环评测局限。
Vista 精读:在连续 latent 扩散上做前视、动作可控驾驶视频预测,结合历史 latent、动态/高频损失与奖励式动作评分。
Drive-WM 精读:用多视角视频扩散做未来预测,并在世界模型里评估候选轨迹,缓解分布外偏移下的规划脆弱问题。
精读自动驾驶世界模型初始综述:为何驾驶需要预判动作后果,latent/RSSM 等内部状态如何服务于预测、规划与基于想象的策略学习。
有意思的是,自动驾驶在讲世界模型,具身智能也在讲世界模型。答案是:能转,但两边解决的问题差异很大。世界模型的底层思路相通——让模型学会理解当前世界,并预测“接下来可能发生什么”。可一旦进入具体场景,自动驾驶和具身智能面对的“世界”,复杂度完全不一样。
这个教程是在一个刚安装完的干净的运行在Intel x86_64的Ubuntu 20.04.1 上进行的。同时,我在Ubuntu 18.04上也进行过测试,也是可以顺利安装的。实际的内核是5.4.0-54-generic,但是我们会安装最新的稳定的RT_PREEMPT版本。为了构建这个内核,你需要至少30GB的空闲磁盘空间。查看https://wiki.linuxfoundation.org/rea
SLAM(同步定位与建图)旨在解决机器人在未知环境中同时定位自身位置并构建地图的问题。给定控制输入序列 $ u_{1:T} $ 与观测数据 $ z_{1:T} $,目标是估计机器人轨迹 $ x_{0:T} $ 与环境地图 $ m $。由于运动与观测均存在不确定性,SLAM采用概率框架,利用贝叶斯推理对状态进行递推估计,实现高精度的定位与建图。
二维码标定板融合几何特征与唯一编码,突破传统棋盘格在遮挡、歧义、大视角下的局限,实现高精度、鲁棒性强的自动标定。其在多相机协同、机器人手眼标定、工业检测及AGV导航中广泛应用,已成为高端视觉系统的标配。未来将向复合化、自动化、标准化与微型化发展,持续推动机器视觉向高精度、智能化演进。
转载自:https://www.cnblogs.com/eaggle/p/7641406.htmlLinux内核Socket CAN中文文档转载自:http://blog.csdn.net/zhangxiaopeng0829/article/details/7646639自己在年假中空闲之余翻译的内核中Socket CAN的文档,原文地址在:http://lxr.linux.no/linux+v2
NVIDIA Alpamayo是面向自动驾驶的开放视觉-语言-动作(VLA)大模型家族,基于Cosmos基础模型,核心创新为“因果链推理”(Chain-of-Causation),实现决策过程可解释、可审计。其旗舰版Alpamayo2Super(34B参数)支持7路相机360°感知,具备强长尾场景理解与3D空间推理能力,输出轨迹与自然语言推理日志,解决传统端到端方案黑盒难题。结合Cosmos仿真平
机器人建图的概念以及相关术语
注意: YOLO_ORB_SLAM3_with_pointcloud_map的环境搭建跟YOLO_ORB_SLAM3差不多,就是在其基础上安装了pcl和vtk,如果之前已经搭建好了YOLO_ORB_SLAM3的环境(看我之前发的),直接在其基础上进行3.8的操作,接着后续操作即可,libffi8在我之前发的文章里有提供。
Carla最新版0.9.16 Build version 构建版 环境配置及安装教程。
可以按照下面的步骤看看是不是符合情况。尽量连接手机热点进行下面的下载操作。,编译完成并没有报错,然而在跑例程的时候节点会直接死掉。文件中,否则每次运行demo都需要输入一遍,否则找不到。另外一种错误可能是,下载的各个安装包里面的。,如果可以挂VPN可以不改。这个东西,有些包是有版本要求的,比如。不支持C++语言来进行编译,需要在。文件中,加入下面的命令来输出默认。最好是在靠前面一点的位置添加。的位
3.在安装过程中,您可以自由选择“CarSim2021.0_Data”和“CarSim2021.0_Prog”文件夹的安装路径,确保不是默认的C盘路径(如果需要,我都是默认,C盘够用)。2.回到桌面,找到并右击“CarSim 2021.0”的快捷方式,选择“打开文件所在的位置”,这样会直接进入“CarSim2021.0_Prog”文件夹。1.在安装目录文件夹,双击“SolidSQUADLoader
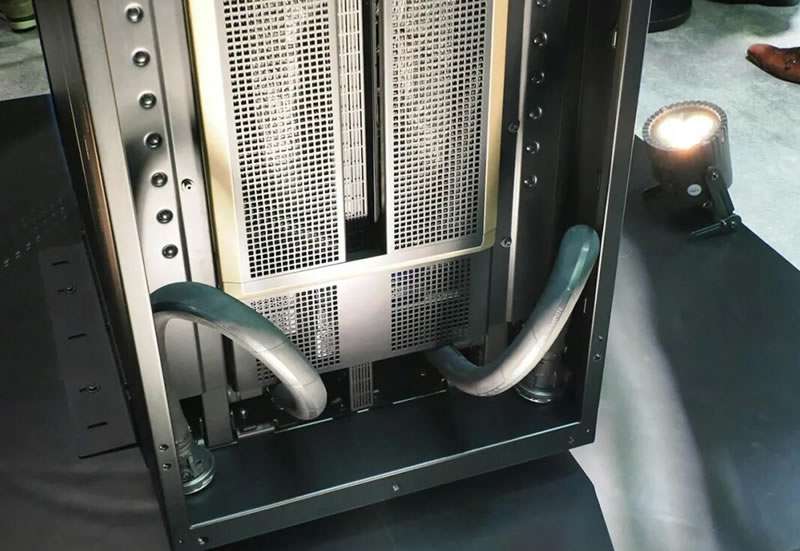
云达科技现场展示的1U机型QuantaGrid D75B-1U,在Nvidia GB200 NVL72的系统建置框架之下,可透过单座机柜容纳72台这样的设备。新一代 AI 液冷机架解决方案 NVIDIA GB200 NVL72,结合了 36 个 NVIDIA GB200 Grace Blackwell 超级芯片,其中包括 72 个基于 NVIDIA Blackwell 的 GPU 和 36 个NV
YOLOv1-v5,YOLOx学习记录
1.背景介绍自动驾驶技术是人工智能领域的一个重要应用,旨在通过采用高级计算、传感技术、机器学习、计算机视觉、路径规划等技术,使汽车在特定环境下自主决策并实现无人驾驶。自动驾驶技术的发展将有助于减少交通事故、提高交通效率、减少气候变化影响等。自动驾驶技术的主要组成部分包括:传感技术:使用雷达、激光雷达、摄像头、超声波等传感器来获取环境信息。计算机视觉:通过图像处理、目标检测、对象识别...
论文地址:https://arxiv.org/abs/2209.14922项目地址:https://github.com/Gatedip/GDIP-Yolo在恶劣的天气和照明条件下检测物体对于自动驾驶汽车的安全和持续运行至关重要,而且仍然是一个未解决的问题。我们提出了一个门控可微图像处理(GDIP)块,这是一个领域不可知的网络架构,它可以插入现有的目标检测网络(例如,Yolo),并端到端训练不利条
官网上的安装说明是按作者使用的较低版本的CUDA11.1.1和pytorch1.9.1来的,对应的mmcv也是较低版本的1.4版,我们工作服务器上的nvidia ngc docker环境里使用的这些支持工具软件早已是较高版本的,于是想在我们自己的环境里把UniAD跑起来,安装过程中遇到一些坑,最终都一一解决了,也实测过了,UniAD完全可以正常跑在CUDA11.6+pytorch1.12.0+mm
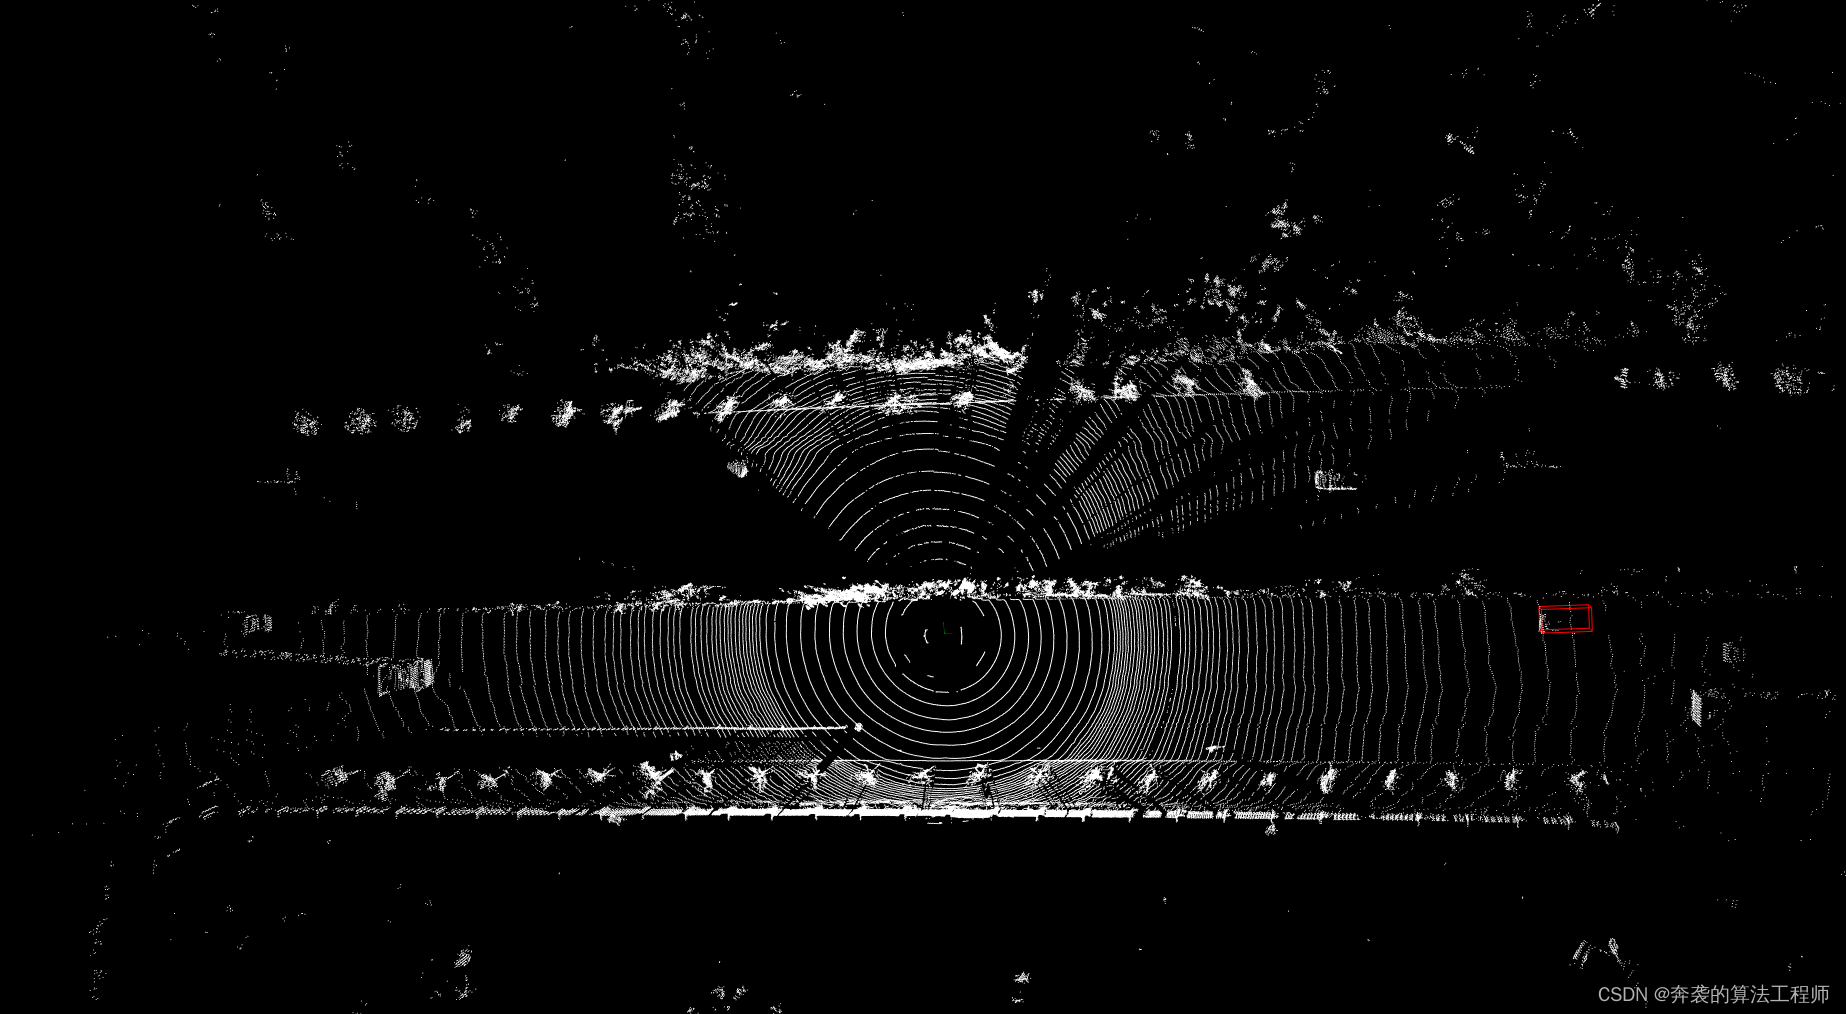
几十年来,激光雷达一直是许多行业中非常有用的工具,但直到最近,随着人工智能(AI)解决方案的引入,我们才开始认识到它的真正潜力。激光雷达,又称光探测和测距,是一种遥感技术。它利用激光扫描器,测量传感器与建筑物或行人等目标物体之间的距离和尺寸。随着AI与激光雷达的结合使用,技术团队正在针对各种场景优化技术,以达到超乎想象的速度和精度。20世纪60年代,激光雷达第一次问世,当时人们把它安装在飞机上扫描
深蓝学院transformer的学习
如果编译成功,则 cv_bridge功能包制作就完成了,这也说明 opencv 4.6.0 已经正确安装了,并且这个cv_bridge功能包可以正确连接上自己安装的 opencv 版本,最后我们将这个功能包的路径添加到 ~/.bashrc 文件夹中,使得我们在后面编译 vins-fusion-gpu 时可以调用这个 cv_bridge功能包,打开 ~/.bashrc文件夹,在最后加入如下命令。在
如果想对安装包安装过程进行自定义那么首先电脑上先安装 Inno Setup Compiler, 再创建 setup.iss 文件通过 ide 新建 .iss 文件过程如下:打开 Inno Setup Compiler新建一个 Inno Setup Script Wizard 开始创建 .iss 脚本文件按提示一步步往下走,可以选择填写 app 名字,版本,公司之类的信息这些都不重要直到另外 Oth
百度Apollo安装教程
总结ros2中bag文件的高频使用命令
ros2 topic echo 无法补全的问题解决
opencv显示3d点云
遇到dpkg-shlibdeps: error: no dependency information found for,找不到依赖的问题。在debian/rules中修改内容如下,加入。
Ubuntu22.04中ROS2安装与问题解决
打开roscore,分别建立终端,调用listener和talker。
使用安装包安装cartographer 并融合odom和imu
如何从solidworks导出URDF模型到ubuntu并显示
从摄像机成像畸变的产生于是其“天生”的,不可避免的,这主要是由于透镜成像原理导致的。其畸变的原理可以参考相机模型)。它的畸变按照原理可以分解为切向畸变和径向畸变。畸变校正opencv提供了可以直接使用的矫正算法,即通过calibrate Camera()得到的畸变系数,生成矫正后的图像。我们可以通过undistort()函数一次性完成;也可以通过initUndistortRectifyMap()和
1.下载源码cd catkin_ws/srcgit clone https://github.com/OuyangJunyuan/ros-yolov5.gitgit clone https://github.com/catkin/catkin_simple.git然后回到工作空间目录下catkin_make2.修改config.yaml文件文件位置:ros-yolov5-master/config
一.效果:如图,启动了十个方块机器人。二.环境配置2.1文件布局description:机器人部分gazebo:仿真环境部分2.2 启动的文件ros2 launch box_bot_gazebo multi_box_bot_launch.py1.描述文件所在位置:分别给出box_bot_gazebo 和 box_bot_description两个文件夹的位置2.world部分:world启动文件的
联合仿真参考Carla官方文档,主要分为以下三个部分:第一步: Requisites(需求):Install SUMO首先, Carla官方建议从源码(Building from source)构建而不是简单安装,因为(Building from source)有新功能和修复可以改进协同仿真。本文建议大家可以简单安装:您可以通过 apt-get 直接安装 SUMO:sudo add-apt-rep
自动驾驶
——自动驾驶
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 DAMO开发者矩阵


 openEuler 社区


 乐奇 Rokid 开放社区