


- @air__Heaven


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
哈希表可以用来快速判断一个元素是否出现集合里。常见的哈希表有三种形式:数组、set (集合)、map(映射)、本系列博文将通过一些力扣算法题目,边学习TypeScipt边实战算法,这篇将通过一些经典算法题熟悉TS语言哈希表的一些基本操作。
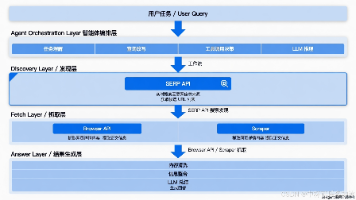
摘要 本文介绍了AI Agent如何通过亮数据(Bright Data)的SERP-API和MCP协议解决联网检索难题。传统自研爬虫面临代理维护、反爬拦截等痛点,而SERP-API提供结构化搜索引擎结果,MCP协议则让AI能自主调用联网工具。文章详细展示了SERP-API的创建流程和MCP配置方法,并通过四层架构(智能编排→信息发现→网页抓取→结果生成)说明技术实现路径。最后给出Python代码示
前阵子老板那边找到我,说现在运营那边每天要出十几张产品海报和信息图,能不能本地化部署搞个自动化方案。之前他们运营那边的流程是:在 ChatGPT 里写文案,切到 Midjourney 出图,再开 Figma 排版,一张图来回折腾半小时起步,而且文字和图片之间的"翻译损耗"很大——你 prompt 里写了"左上角放标题",出来的图标题可能在右下角。我正好看到商汤 8 月 21 号开源了 SenseN
前阵子老板那边找到我,说现在运营那边每天要出十几张产品海报和信息图,能不能本地化部署搞个自动化方案。之前他们运营那边的流程是:在 ChatGPT 里写文案,切到 Midjourney 出图,再开 Figma 排版,一张图来回折腾半小时起步,而且文字和图片之间的"翻译损耗"很大——你 prompt 里写了"左上角放标题",出来的图标题可能在右下角。我正好看到商汤 8 月 21 号开源了 SenseN
前阵子老板那边找到我,说现在运营那边每天要出十几张产品海报和信息图,能不能本地化部署搞个自动化方案。之前他们运营那边的流程是:在 ChatGPT 里写文案,切到 Midjourney 出图,再开 Figma 排版,一张图来回折腾半小时起步,而且文字和图片之间的"翻译损耗"很大——你 prompt 里写了"左上角放标题",出来的图标题可能在右下角。我正好看到商汤 8 月 21 号开源了 SenseN
华为开源的openYuanrong是首个Serverless分布式计算引擎,采用"分布式内核"设计理念,旨在让开发者获得单机编程体验的同时实现分布式高性能运行。针对AI大模型训练与推理的挑战,openYuanrong通过多语言函数运行时、函数系统和数据系统三大核心组件,创新性地提出DPOSIX标准,支持异构资源调度与GPU高速传输。其数据系统通过计算旁置、共享内存机制和多级缓存

摘要 本文介绍了AI Agent如何通过亮数据(Bright Data)的SERP-API和MCP协议解决联网检索难题。传统自研爬虫面临代理维护、反爬拦截等痛点,而SERP-API提供结构化搜索引擎结果,MCP协议则让AI能自主调用联网工具。文章详细展示了SERP-API的创建流程和MCP配置方法,并通过四层架构(智能编排→信息发现→网页抓取→结果生成)说明技术实现路径。最后给出Python代码示
摘要 本文介绍了AI Agent如何通过亮数据(Bright Data)的SERP-API和MCP协议解决联网检索难题。传统自研爬虫面临代理维护、反爬拦截等痛点,而SERP-API提供结构化搜索引擎结果,MCP协议则让AI能自主调用联网工具。文章详细展示了SERP-API的创建流程和MCP配置方法,并通过四层架构(智能编排→信息发现→网页抓取→结果生成)说明技术实现路径。最后给出Python代码示
摘要 本文介绍了AI Agent如何通过亮数据(Bright Data)的SERP-API和MCP协议解决联网检索难题。传统自研爬虫面临代理维护、反爬拦截等痛点,而SERP-API提供结构化搜索引擎结果,MCP协议则让AI能自主调用联网工具。文章详细展示了SERP-API的创建流程和MCP配置方法,并通过四层架构(智能编排→信息发现→网页抓取→结果生成)说明技术实现路径。最后给出Python代码示
本文对比了三款主流文档解析工具(xParse、PaddleOCR、MinerU)在复杂表格识别上的表现,重点测试了多层表头、密集小字表、嵌套表格和跨页长表四类业务场景。前面横评解决了"选谁"的问题,接下来要解决"怎么用"的问题。选出 xParse 只是第一步。真正的问题是: **xParse嵌入Agent后,在真实业务场景里能不能稳住?** 表格解析对了,但模型理解错了,或者解析对了、模型也理解对
