登录社区云,与社区用户共同成长
邀请您加入社区
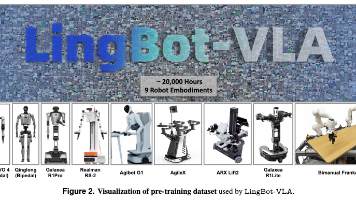
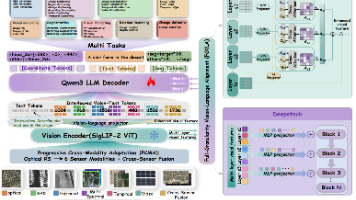
LingBot-VLA 是由蚂蚁集团提出的实用型视觉-语言-动作(VLA)基础模型,基于约20,000小时来自9种双臂机器人的真实世界数据训练而成。通过在4种机器人平台上对100项任务进行大规模评估,该模型展现出卓越的泛化能力与任务成功率,且性能随数据量增加持续提升,未见饱和。研究还构建了高效代码库,在8卡配置下实现每秒261样本吞吐量,较现有框架提速1.5–2.8倍。论文开源代码、模型与基准数据
Earth-OneVision提出一种统一多模态遥感大模型架构,通过全粒度视觉语言对齐(FGVLA)、空间语言同构序列化(SLIS)与渐进式跨模态适配(PCMA),实现2B参数模型对6类传感器、9大任务的统一建模。创新性地将中间视觉层特征注入语言模型早期层,并将检测框、掩码等空间结果编码为离散Token,共享自回归解码器。构建3400万条指令数据集,在24个基准上表现媲美4B–72B模型,推动遥感
用ChatGPT润色英文摘要、用豆包生成文献综述框架,几乎是2026年英语专业毕业生的日常。但越来越多的人发现:导师能"闻"出AI味,学校新上的AIGC检测更是直接给出数值。英文论文的AI痕迹比中文更明显——那种四平八稳、滴水不漏的行文,恰恰是机器最容易暴露的地方。有同学中文部分没事,英文摘要却被标了高风险,原因就是润色太彻底,把个人风格全磨平了。一句话答案:去除AI痕迹的核心不是"躲开检测",而
旋转矩阵虽有9个元素,但受正交性与行列式约束,实际仅含3个自由度,对应Roll、Pitch、Yaw。位姿由位置(x,y,z)和姿态(三轴旋转)共6个自由度构成。三维旋转集合SO(3)是流形——局部似欧氏空间,整体可弯曲,如地球表面。旋转矩阵实现坐标系变换,将机体坐标系向量转为世界坐标系,体现旋转的本质。
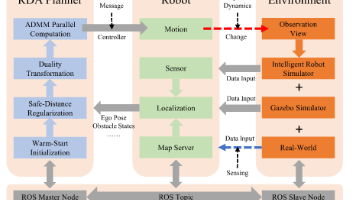
本文提出了一种用于复杂环境中自主导航的加速无碰撞运动规划器RDA。该方法采用模型预测控制框架,将机器人建模为凸集,障碍物用锥不等式表示。通过动态安全距离和l1正则化技术,实现了在时间维度上不均匀分布的安全距离,使系统能在危险区域自动增大安全距离,在安全区域减小距离。针对碰撞约束的非凸性和计算复杂度问题,该方法利用稀疏性优化提高了计算效率。实验结果表明,RDA在保证安全性的同时显著提升了规划速度,适
表面是两个字的调整,实质是保护范围的全面扩大:以前保护的是机房里的信息系统,现在云计算、大数据、物联网、工业控制、移动互联这些新技术形态全部纳入等级保护对象,并且专门为云、物联、移互、工控各开了一章 "扩展要求"。另一个值得注意的变化是要求项数量。我理解这套架构其实是把纵深防御的思想落到了具体标准里:通信网络负责数据传输的安全,区域边界负责出入口的把守,计算环境负责内部每一台设备、每一个应用的安全
4、推理时,模型首先为机器人生成要执行的高级子任务,然后基于该子任务,通过动作专家预测低级动作。(仿佛不是端到端,更像是训练了两个模型,上层是视觉语言模型,下层是语言动作模型,但其实不是,这两个共享同一个神经网络,模型既完成了对任务的分解,又完成了基于子任务的动作输出)推理时,模型先推理出高层子任务,再基于该子任务预测动作。6、高级子任务预测,将高层级任务指令(打扫卧室)拆解为(整理毯子、捡起枕头
InfoXMed 是面向医生、医学生和医学科研人员的 AI 医学工具平台,提供文献检索、全文翻译、AI 解读、指南查询和题库练习等功能,辅助临床学习、科研汇报与医学备考。
不是,或者说,那只是最低级的形式。真正的 AI 辅助阅读应该做的是「嵌在阅读流里的精读辅助」——打开论文就能抓重点、逐段对照翻译、划词解释、笔记附着原文、跨文献对比。「贴给 ChatGPT 总结」能解决「快速知道这篇讲了啥」,但解决不了「精读时持续提效」——因为每看一段都要搬运内容,阅读流被打断。判断标准就是前面说的三点:能不能溯源原文、翻译在不在阅读流里、能不能跨文献。
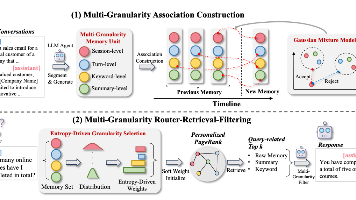
长期对话 Agent 的难点,已经不只是“记忆能不能存下来”,而是:当答案散落在不同日期、不同话题的对话里,系统能不能把它们重新找齐。此前 Agent Memory 系列讨论过把交互写成可检索记忆、建立记忆之间的联系、在需要时回看历史。一段对话究竟应该按多大颗粒度被记住与检索?假设用户先说“我在 Coursera 完成了三门课”,一周后又说“我在 edX 完成了两门课”,随后问“我总共完成了几门在
SchoAI是一款开箱即用的学术版Codex,将AI Agent融入科研全流程。它不依赖用户配置,直接整合论文、文献、数据、代码与图表,实现任务拆解、跨文件检查、自动核验与结果交付。从文献综述到投稿返修,SchoAI帮助科研人摆脱重复搬运,聚焦核心判断,真正实现AI推进项目而非仅对话润色。
本文提出了一种高效深度脉冲神经网络(SNN)模型,采用TTFS编码方式将输入像素强度转换为脉冲发放时间,实现每神经元仅需0.3个脉冲的高效计算。通过双区段神经元模型,在异步累积期整合输入脉冲,并在线性冲刺期进行快速计算,最终建立与ReLU激活函数的等效映射。该模型通过时间编码实现信息传递,在保持计算精度的同时显著降低了脉冲发放频率和能耗。数学推导表明,该SNN模型可等效转换为标准ReLU神经网络,
我们来看一篇关于大型语言模型的知识蒸馏与数据集蒸馏的综述
问题:现有的绝大多数模仿学习的方法只从个别的目标模态中学习,例如语言和图像。但是现有的大规模模仿学习数据集仅部分标注了语言标注,是的现有方法无法充分利用这些数据集中学习语言条件化行为。解决方案:MDT引入在多模态目标指令上同时训练的潜在目标条件状态表示来解决。CLIP将图像和语言的目标嵌入对齐,通过两个自监督辅助任务进行训练,让目标嵌入能够编码足够的信息预测未来状态。效果:在包含不到2%的语言注释
推荐系统推理相关论文
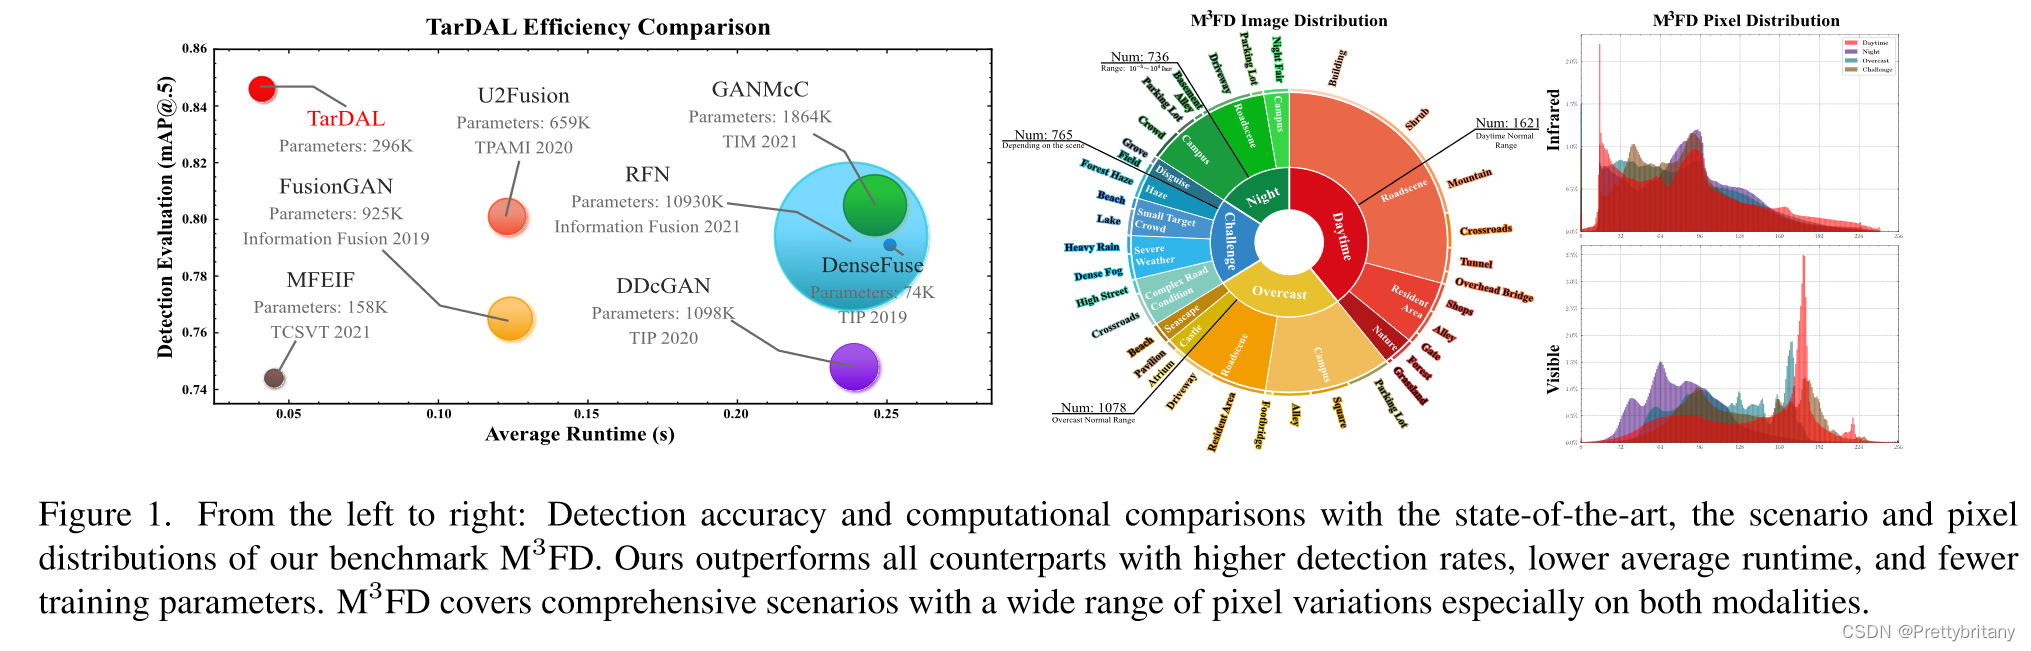
通过计算像素的显著性值来计算权重 ω1 和 ω2,公式 (5) 中的 Lpixel 表示像素损失,其中包括了融合图像与源图像的像素间的绝对差值。最后,该策略不仅可以生成视觉上吸引人的图像,而且可以在给定训练的网络参数的情况下输出准确的检测,使我们能够找到面向检测的融合的最佳解决方案,并且比独立训练方案更有效地收敛。ω1 和 ω2 是用于计算每个源图像对融合图像贡献的权重,通过调整这两个权重,可以更
在word中endnote20工具箱中,将instant formatting is on 打开。然后再将endnote和word重启一下,就ok。
推荐系统无偏研究综述
论文阅读"DexUMI: Using Human Hand as the Universal Manipulation Interface for Dexterous Manipulation"
PIDDM 通过“后处理蒸馏”把物理约束直接施加在最终样本,绕过 Jensen Gap,首次实现扩散模型单步、高保真、PDE 一致的物理生成,为实时物理模拟与逆问题求解提供了新范式。
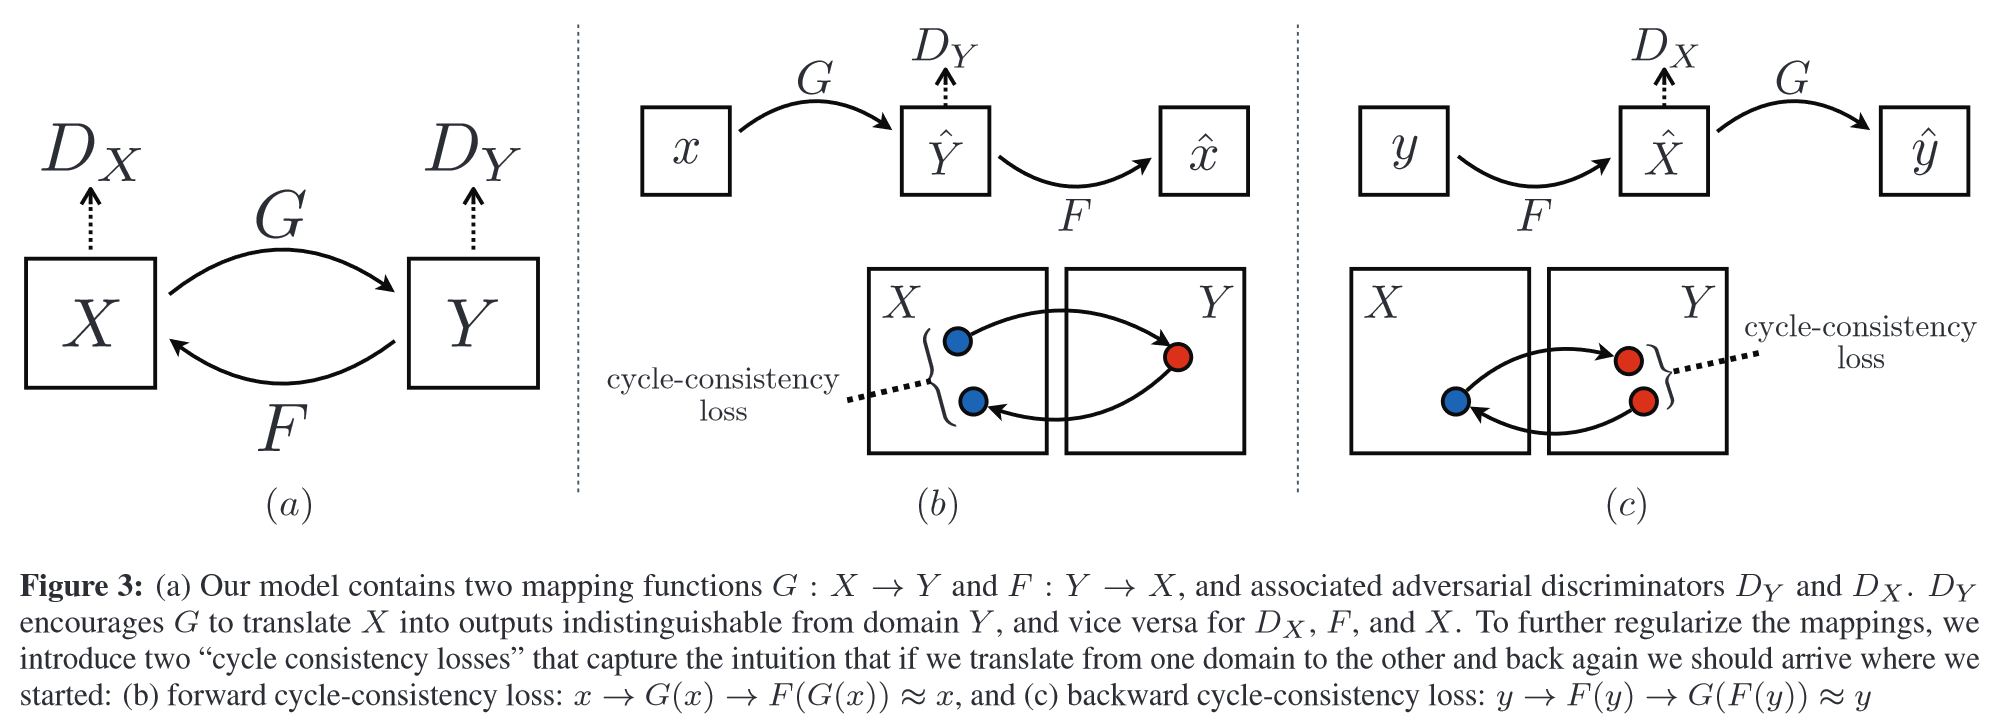
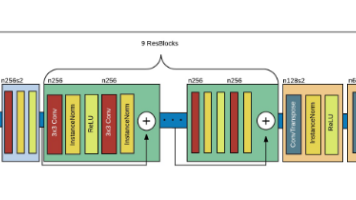
一般的内容损失是MAE(L1)和MSE(L2),这些会为了平均而导致一些模糊,作者采用了感知损失(Perceptual loss),他本质是一个简单的L2损失,但基于基于生成的CNN特征图与目标图像的差异,也就是只关注真实图和生成图的特征差异。D(x)是判断器对真实图片的判断,我们希望越大越好,同样对于D(G(x))能越准确的判断假图片,他的值越小,那么1-D(G(x))越接近1,所以最大化D就是
题目:DeblurGAN: Blind Motion Deblurring Using Conditional Adversarial Networks期刊:CVPR年份:2018代码链接:https://github.com/KupynOrest/DeblurGANIB=k(M)∗IS+NI_B = k(M) \ast I_S + NIB=k(M)∗IS+N含义:解释:minGmaxD(
这篇论文提出了一种新型的同态签密方案,专为卫星物联网环境设计。这篇是帮同学整理的,和本人研究方向无关。
原版:对于agent做出的动作a,r(s, a) = − log(1 − D(s, a)) ,被判别器判定越接近专家行为,奖励就越大,这种方式适用于有生存奖励的RL环境,比如说Atari游戏,但对于想尽快结束的环境可能不适合,如果用这种方式也需要结合环境原本奖励并把Gail奖励的系数调低。相较于PPO 其需要一个额外的判别器D,D的作用是用来区分agent做出的动作和expert做出的动作,越接近
作者|AIming 编辑|汽车人原文链接:https://zhuanlan.zhihu.com/p/691549750点击下方卡片,关注“自动驾驶之心”公众号戳我-> 领取自动驾驶近15个方向学习路线>>点击进入→自动驾驶之心『占用网络』技术交流群本文只做学术分享,如有侵权,联系删文Fully Sparse 3D Occupancy Predictionarxiv:ht...
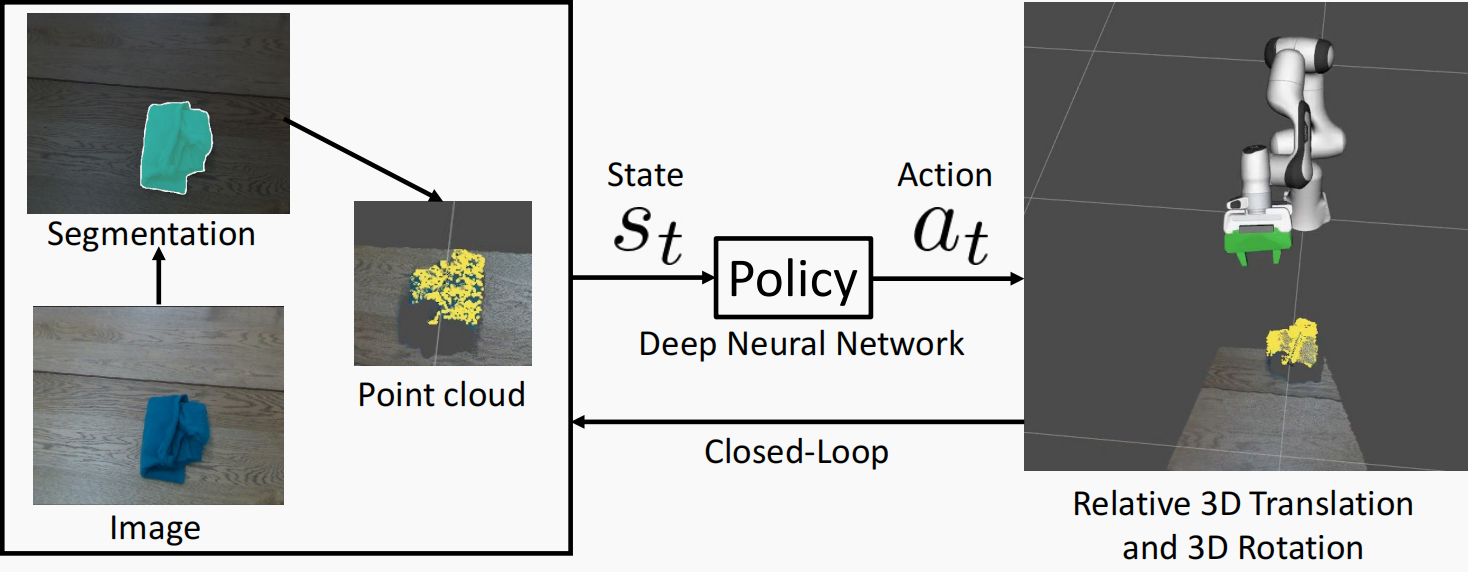
超越自上而下的垃圾箱拣选场景的 6D 机器人抓取是一项具有挑战性的任务。以往基于 6D 抓取合成和机器人运动规划的解决方案通常在开环环境中运行,对抓取合成误差非常敏感。在这项工作中,我们提出了一种学习 6D 抓取闭环控制策略的新方法。我们的策略以来自自中心摄像机的物体分割点云为输入,输出机器人抓手抓取物体的连续 6D 控制动作。我们结合了模仿学习和强化学习,并为策略学习引入了目标辅助行为批判算法。
构建子图,子图闭环通过TEASER来构建和验证,TEASER是一种全局的配准方法,初始的子图相关是用NCC对所构建的f特征来做的相关性匹配的,通过子图-子图间的配准来计算闭环的相对位置和姿态,高sigma和比阈值小的Ots的边将被删除,如果一个闭环边被增加,就做PGO全局优化,优化每一个子图的一个位姿,然后根据每一个子图的位姿调整子图内每一帧的位姿。vk X (RP+T - q点),对T求导为vk
迁移到服务器上实现,下载了对应的数据集,它的代码是2017NIPS比赛用的 实现的是攻击后的图片分类器 输出的是输入图片的名称和所属的类别 他的方法是每张图片随机四个方向填充或者翻转(一张图片重复三十次)然后进行三十次分类 对每次的概率进行加和 最后取概率最大的(也就是30次加和的概率最大)为输出类别。下面为服务器上的结果。
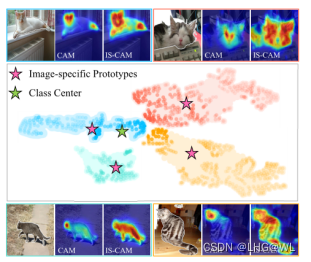
此外,通过特征的质心(粉色星形)激活每个图像上的特征,有助于探索更完整的区域(见图1所示的image-specific CAM (IS-CAM))。一种直接获取种子的方法是经验地为CAM选择阈值,但由于对象和场景的多样性,很难对不同的图像使用固定的阈值。然而,由于图像的对象和场景的多样性,学习每个类的通用类内鉴别器是相当棘手的。图3显示了所选的前景和背景示例所提出的方法。与以分类器权重为类中心计算
前一篇文章分享了NDSS2020的《UNICORN: Runtime Provenance-Based Detector for Advanced Persistent Threats》,一种基于溯源图的实时APT检测器。这篇文章将详细介绍S&P2019《HOLMES: Real-time APT Detection through Correlation of Suspicious Inform
多传感器融合中的时间硬同步1-论文阅读
硕士论文写作的核心在于聚焦小切口、搭建硬框架、分块落地。首先锁定具体研究问题,用30-50篇文献构建"理论-现状-缺口"逻辑链;然后按五段式(绪论、理论基础、研究设计、分析论证、结论)搭建框架,优先完成核心数据/实证部分;最后补充文献综述和格式修改。整个过程紧扣研究问题,6-8周完成初稿后,再用2周打磨。选题要遵循"小、实、近"原则,文献综述重在找研究缺口,
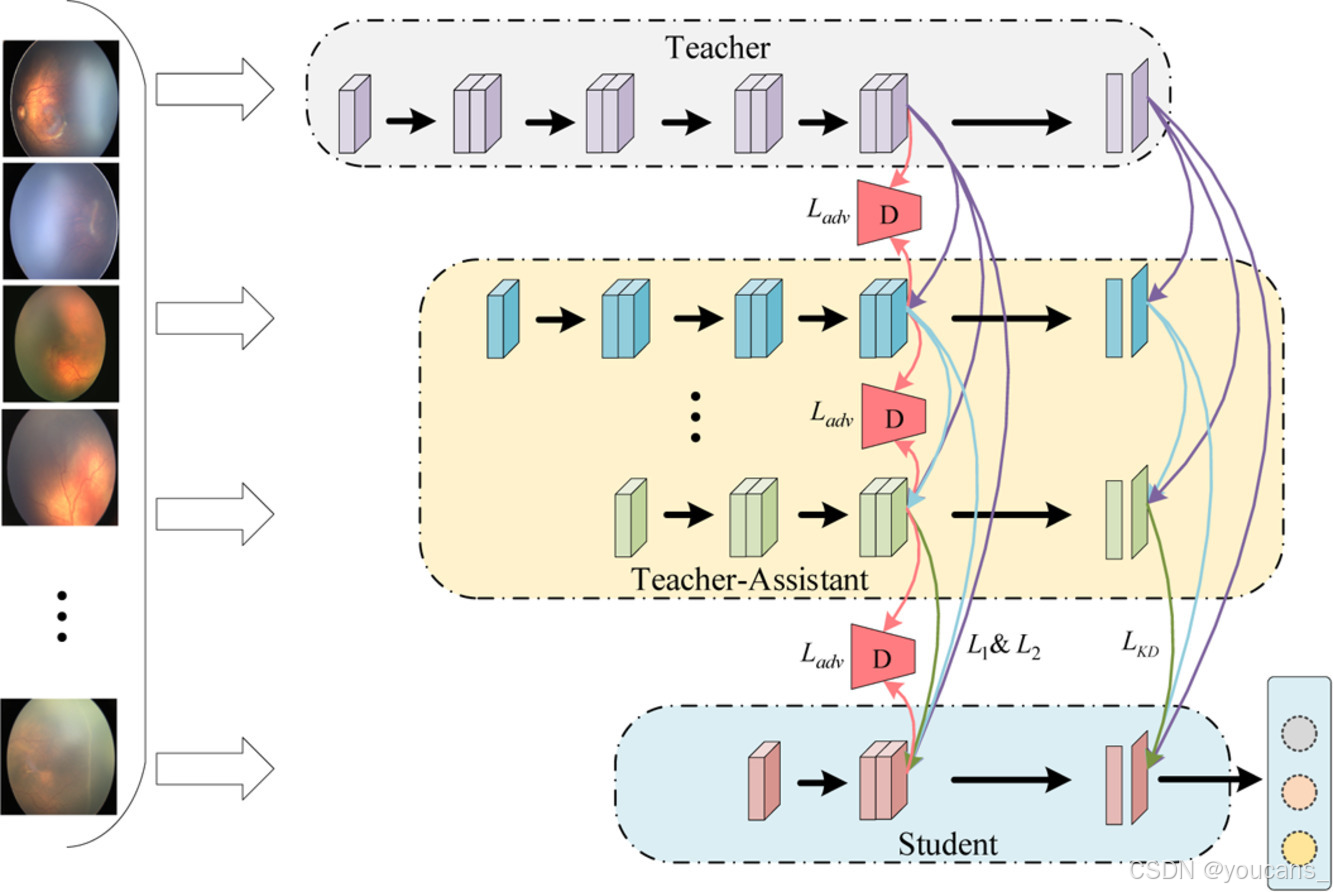
提出了一种基于对抗学习的多层次密集知识蒸馏方法,旨在解决AP-ROP检测中复杂模型难以部署的问题。通过引入教师助理网络和对抗学习机制,该方法成功实现了从教师网络到学生网络的高效知识传递,为开发轻量级、高性能的眼底疾病检测系统提供了新的解决方案。
从bcd图可以看到(其实画得很含糊,不仔细,需要看附录,如下图),所谓MoE-Prompt,其实就是在原有的feature上,去和利用DA-CLIP对原图提取的degradation prior,进行交叉注意力,再用noisy top-k这个常用的MoE方法,得到top k个专家prompt,进行求和,再用结果的prompt去和feature计算矩阵乘法,得到经过MoE处理后的特征。用prompt
成对训练数据缺乏。
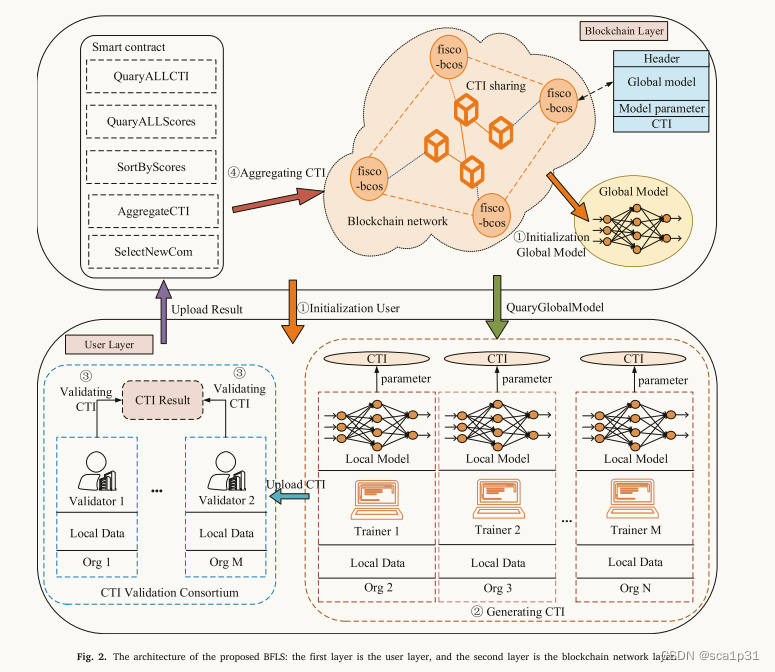
这篇论文核心也是联邦学习与区块链技术的结合,应用场景放在了CTI共享中。文章将深度学习的恶意流量检测模型的参数视为CTI,使用联邦学习进行共享,从情报共享的角度来进行文章的书写。那么在introduction与related work中就可以对CTI领域的研究进行概括总结,介绍自己的工作并进行对比,突出自己工作的创新与优点,并且形成一个表格进行清晰地对比。(从中我们可以学习到,我们如果做类似的工作
我们的目标是共同推理和预测一个场景中所有智能体的未来轨迹。我们假设我们接收到一个场景中所有人的轨迹作为输入,X = X1, X2,…, Xn,并同时预测所有人未来的轨迹,Y = Y1, Y2,…Yn。行人的输入轨迹i定义为Xi = (x ti, yt i),从时间步长t = 1,…, tobs,和未来的轨迹(地面真相)可以类似地定义为Yi = (x ti, yt i),从时间步长t = tobs
iclr 2024 reviewer 评分668。
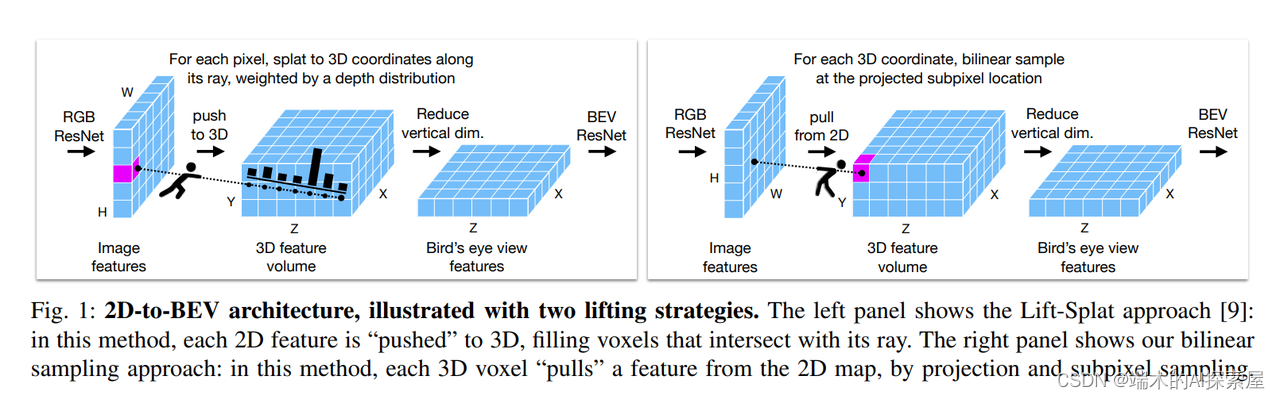
摘要— 在自动驾驶车辆中构建不依赖于高密度激光雷达(LiDAR)的3D感知系统是一个关键的研究问题,因为与相机和其他传感器相比,激光雷达系统的费用较高。lifted最近的研究已经发展出各种仅使用摄像头的方法,其中特征可区分地从多摄像头图像中“抬升”到二维地平面,生成车辆周围3D空间的“鸟瞰图”(BEV)特征表示。这一领域的研究产生了各种新颖的“抬升”方法,但我们观察到培训设置中的其他细节同时发生了
本文就主要讲了这两种方法来研究时序图中的路径问题,当然还提到一些应用和实验结果,由于对照的实验是一篇04年的文章,它使用贪婪策略和枚举的方法,比本文的算法效率要慢得多,这里就不详细说明了,主要还是明白算法的思想。看完这篇文章,收获还是很多的,边流表示只需要一次扫描就能解决路径问题,而图转换可以直接使用静态图的路径研究方法,大大降低了问题的复杂度,但是牺牲了大量的空间。对于时态图,消耗时间和空间都是
论文阅读"universal manipulation interface: in-the-wild robot teaching without in-th-wild robots"
本文提出Cog-RAG框架,通过双超图结构和认知启发式检索策略改进检索增强生成(RAG)。针对现有方法仅关注低阶实体关系的不足,Cog-RAG构建了主题超图(捕获全局主题结构)和实体超图(建模细粒度高阶关系)。受人类认知过程启发,采用两阶段检索策略:先在主题超图中激活相关主题,再在实体超图的引导下检索细节信息。实验表明,这种"主题驱动、细节回忆"的方法显著提升了生成质量。该工作
摘要:本文提出GraphST模型,一种基于对抗式对比学习的时空图表示学习方法,用于解决现有模型对区域图质量敏感的问题。GraphST通过多视角区域图构建、自适应图增强和对抗式对比学习,实现了鲁棒的时空表示学习。模型采用变分图自编码器进行自监督学习,引入跨视角对比机制建模区域关系异质性,并通过困难样本识别增强模型判别力。在多个时空预测任务上的实验验证了其优越性能。该方法为噪声环境下的时空数据分析提供
科研绘图困扰着众多研究者,从技术路线图到实验曲线图,传统工具操作复杂且难以满足学术规范要求。虎贲等考AI平台推出智能科研绘图功能,通过AI技术实现零基础快速生成期刊级图表,解决了这一痛点。该平台覆盖柱状图、箱线图、技术路线图等多种图表类型,内置学术规范要求,支持数据自动识别和格式调整,并能关联论文内容确保一致性。用户反馈显示,该功能大幅提升了绘图效率和质量,使研究者能够专注于科研本身。虎贲等考AI
本文提出系统性论文笔记的五层体系:1)基础元信息与结构化摘要;2)核心论点与证据链解构;3)批判性思考与知识关联;4)个性化编码与可检索系统;5)定期回顾与迭代升华。该体系强调从被动记录到主动知识构建的转变,通过可视化工具、标签化管理和双向链接等方法,将文献阅读转化为可检索的知识资产,最终实现学术思维的训练和写作素材的积累。
因为本文有两种输入数据,作者对这两种数据分别进行了阐述:这段是比较好理解的,因此我就不过多说明了。在我们知道过去一段时间(t-p到t这段时间)的个体轨迹数据或群体流动数据的情况下,预测未来k步之内的个人轨迹数据或群体流动数据。
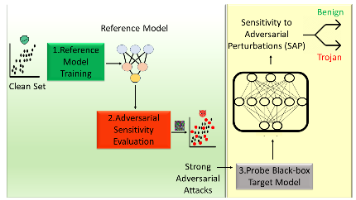
No.4、后门检测
论文阅读
——论文阅读
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 DAMO开发者矩阵

 AtomGit AI 社区

 亚马逊云科技技术品牌专区

 2048 AI社区


 AI Agent技术社区
 乐奇 Rokid 开放社区












 天工造物局