


- @2401_85328934


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
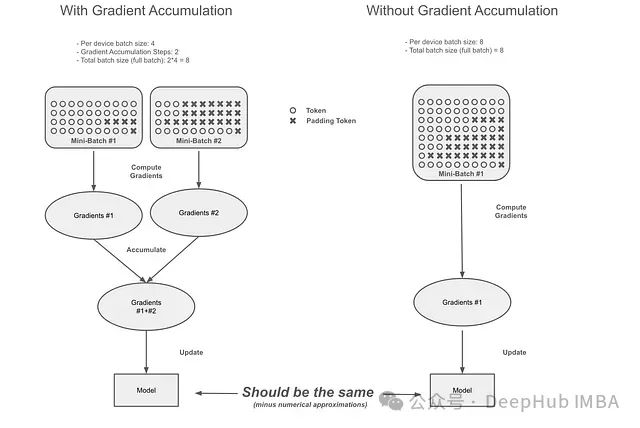
在本地环境下对大规模语言模型(LLMs)进行微调时,由于GPU显存限制,采用大批量训练通常难以实现。为解决此问题,一般普遍会采用梯度累积技术来模拟较大的批量规模。该方法不同于传统的每批次更新模型权重的方式,而是通过在多个小批量上累积梯度,在达到预设的累积次数后才执行权重更新。这种方法有效地实现了大批量训练的效果,同时避免了常见的内存开销问题。
提到AI应用工程师,很多人会误以为是“专搞模型训练的算法专家”,其实不然。简单来说,他们是将AI技术从“实验室”推向“实际场景”的核心角色,像一座桥梁,连接起前沿的AI模型与企业的真实需求。
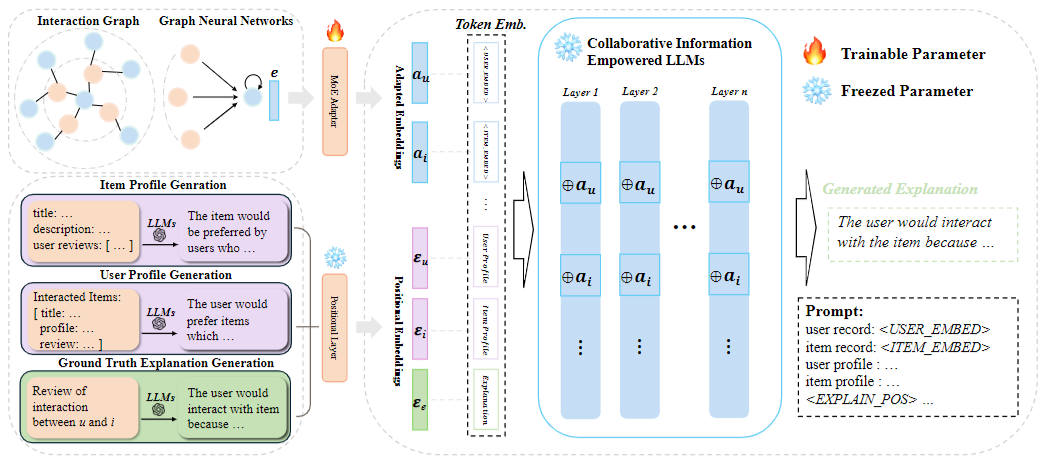
本文提出了一个新颖的XRec框架, 它无缝集成了基于图的协同过滤范式和大语言模型(LLMs)的能力, 以生成对推荐输出的全面且富有洞察力的解释。通过利用用户-商品交互图中编码的固有协同关系, XRec能够有效捕获构成用户偏好和项目关联的高阶依赖性。XRec引入了一个专门的协同信息适配器, 作为建立协同信号(collaborative signal)与LLM内丰富的文本语义空间(embedding
本文将从三个方面,带您一文搞懂GAN的本质GAN架构一、生成器(Generator)功能:负责生成新的数据样本。结构:通常是一个深度神经网络,输入为低维向量(如随机噪声),输出为高维向量(如图片、文本或语音)。训练目标:生成尽可能真实的数据,以欺骗判别器。二、判别器(Discriminator)功能:负责区分输入的数据是真实数据还是由生成器生成的假数据。结构:同样是一个深度神经网络,输入为高维向量

测试集是用于评估模型性能的数据集,它不参与模型的训练过程,而是用于在模型训练完成后测试其准确性和泛化能力。这篇文章介绍如何使用Ragas框架创建一个测试集,以便可以评估自己的RAG系统在处理特定文档时的表现。通过使用自己的文档生成测试集,可以确保测试集与RAG具体应用场景紧密相关,从而更准确地评估RAG系统的效果。

建议读者具备一定的LLMs知识和通用AI领域的背景知识,以及Python和AWS的基础。无论是AI领域的新手还是希望提升技能的资深实践者,本书都提供了全面的指导,帮助他们在实际应用中部署LLMs。您还将探索该领域的前沿进展,包括推理优化、偏好对齐和实时数据处理,这使其成为那些希望在其项目中应用 LLM 的人的重要资源。这本 LLM 书籍提供了有关利用 MLOps 最佳实践在实际场景中设计、训练和部

随着ChatGPT的火爆出圈,AI人工智能的时代浪潮似乎真的已经来临。人们开始感受到AI技术的实际影响,并纷纷思考这一技术将如何重塑我们的世界。在国内,各大科技巨头已经纷纷布局AI大模型领域,意图在这一轮技术变革中抢占先机。然而,AI大模型要想实现规模化落地,仍然面临诸多挑战。那么,AI大模型在国内产业侧的成长现状如何?其前景又如何呢?AI大模型引领的新浪潮不同于以往的技术变革,这次由ChatGP
本文为Java程序员转行AI大模型开发提供了系统性指南。文章首先明确了大模型作为具备海量参数的智能系统,能够处理NLP、图像识别等复杂任务。针对转型路径,提出了五步走方案:1)学习机器学习/深度学习基础理论;2)掌握TensorFlow/PyTorch等工具框架;3)提升编程与算法优化能力;4)巩固高等数学知识;5)通过开源项目或竞赛积累实战经验。特别指出Java开发者的工程化思维优势,并附赠包含

基于RAG与LLM的知识库作为目前最有潜力的企业端大模型应用之一,从技术角度可以看到,建设方案已经完备;从业务角度,最终的应用效果和业务价值还需要观察,并通过业务侧的反馈不断地促进建设方案的进一步优化,比如增加对多模态知识的处理能力等。让我们共同期待这类应用普及那一天的到来。。

其实早有人类提出相关技术解决上述问题, 那就是智能体, 智能体(AI Agents或 Agents),一般认为是一个可以通过行动能力自主完成设定的目标的代理。“智能体”是和“智能”密不可分的;它具备一些类似人的智能能力和行为,比如学习、推理、决策和执行能力。AI Agents的概念是早于。
