


- @weixin_44292902


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
大数据人工智能相关课程培训,人工智能培训及咨询,合作抠抠526346584
人工智能咨询培训老师叶梓 转载标明出处大模型适应到特定下游任务时,传统的全参数微调方法成本高昂,因此,研究者们一直在探索更高效的微调技术。由北京航空航天大学和北京大学的研究团队提出了一个名为Llama Factory的统一框架,旨在解决大模型高效微调的问题。该框架整合了一系列前沿的高效训练方法,使用户能够灵活地定制100多种大模型的微调过程,而无需编写代码。通过内置的Web用户界面Llama bo

人工智能咨询培训老师叶梓 转载标明出处如何精确控制大规模无监督语言模型(LMs)的行为一直是一个挑战。这些模型虽然通过大量数据学习到了广泛的世界知识和一些推理技能,但由于其训练的无监督性质,使得它们的行为难以精确控制。现有的方法通过收集人类对模型生成内容的相对质量标签,然后通过人类反馈的强化学习(Reinforcement Learning from Human Feedback, RLHF)对无

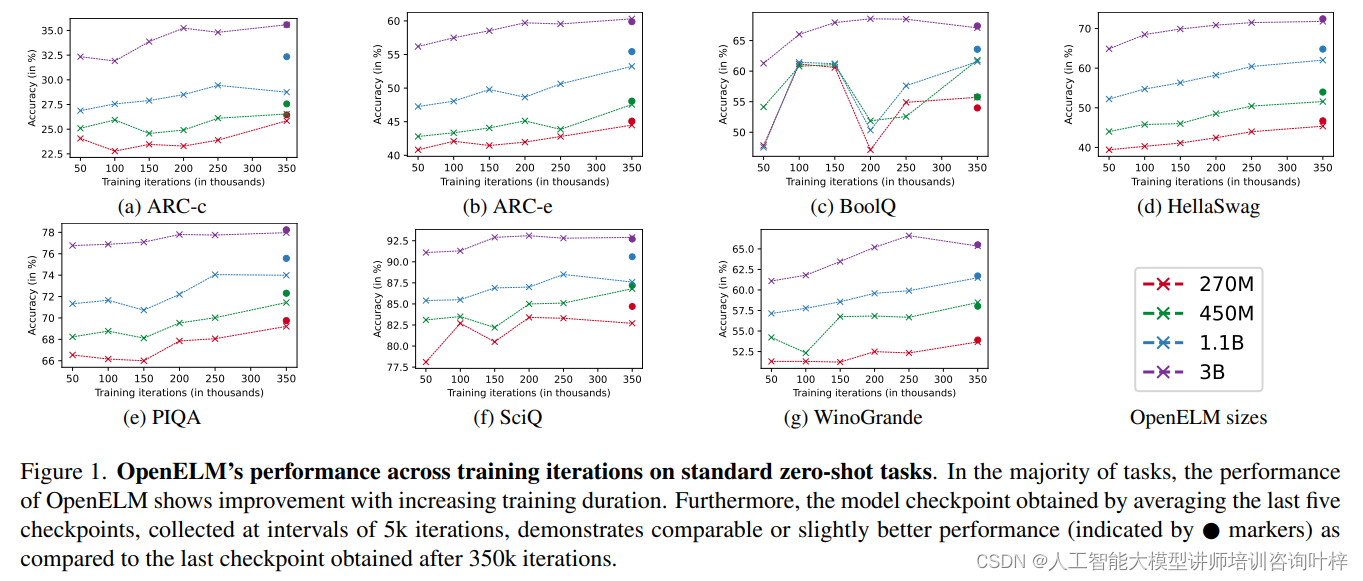
随着大模型模型规模的增长,这些强大工具的透明度、可复现性和对数据偏见的敏感性也引起了人们的关注。这些问题不仅关系到研究的开放性和公平性,也关系到模型输出的可信度和安全性。为了应对这些挑战,Apple的研究团队发布了名为OpenELM的新一代开放语言模型。OpenELM采用了层级缩放策略,优化了变换器模型中每层的参数分配,从而提升了模型的准确性。例如,在大约十亿参数的预算下,OpenELM在准确性上
大模型(LLMs)在处理复杂任务时展现出的巨大潜力,但却需要庞大的计算资源和存储空间,限制了它们在移动设备等资源受限环境中的应用。微软公司最新发布的Phi-3系列语言模型,以其卓越的性能和小巧的体积,打破了这一局限,为移动AI领域带来了革命性的变革。Phi-3系列模型的优势在于它们能够在保持较小模型体积的同时,提供与大型模型相媲美的语言处理能力。

大模型(LLMs)以其卓越的性能在多个应用场景中大放异彩。然而,随着应用的深入,这些模型的推理速度问题逐渐凸显。为了解决这一挑战,推测性解码(Speculative Decoding, SPD)技术应运而生。本文深入探讨了SPD在多模态大型语言模型(MLLMs)中的应用,尤其是针对LLaVA 7B模型的优化。MLLMs通过融合视觉和文本数据,极大地丰富了模型与用户的互动,但同时也面临着自回归生成和

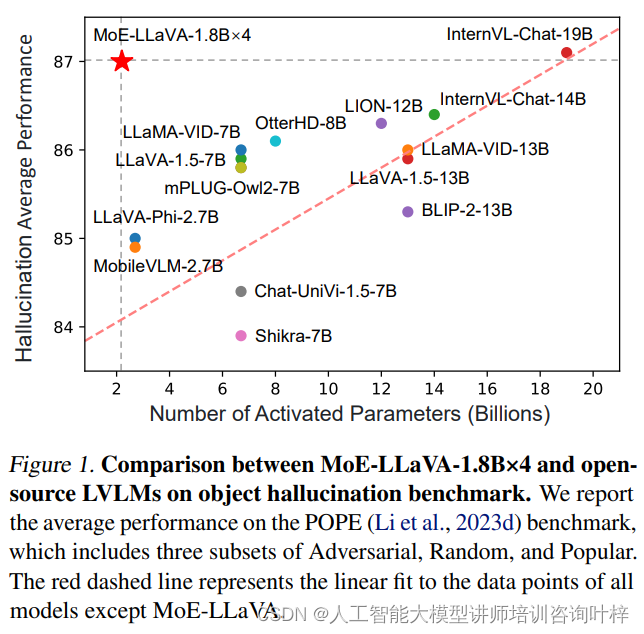
随着人工智能技术的飞速发展,大型视觉-语言模型(LVLMs)在图像理解和自然语言处理方面展现出了巨大的潜力。这些模型通过结合图像编码器和语言模型,能够处理包括图像描述、视觉问答和图像字幕生成等在内的多种任务。然而,现有模型在训练和推理时存在巨大的计算成本,这限制了它们的应用范围和效率。
实验表明,使用噪声嵌入对原始LLM(如LLaMA-2-7B)进行微调时,其在AlpacaEval上的性能从29.79%提升至64.69%,显示出约35个百分点的显著提升。最近,一篇名为《NEFTUNE: NOISY EMBEDDINGS IMPROVE INSTRUCTION FINETUNING》的论文提出了一种新颖的方法,通过在训练过程中向嵌入向量添加噪声来提升模型的微调性能。在传统的语言模型

推荐下arxiv挂的一个提示词教程:它提出了一套26条指导原则,改善和优化与大型语言模型(LLMs)的交互过程。通过这些原则,旨在简化对LLMs的查询和提示设计,提升用户体验,并增强对模型行为的理解。研究团队在不同规模的模型上进行了广泛的实验,包括LLaMA-1/2和GPT-3.5/4,验证了这些原则的有效性。实验结果表明,这些原则能够显著提升模型响应的质量和准确性。论文还探讨了与LLMs交互的相

虽然生成语义ID的不同技术导致ID具有不同的语义属性,但它们得有以下属性:相似的item(具有相似内容特征或语义emb紧密的item)应该具有重叠的语义ID。例如,与语义ID为(10,23,32)的item相比,具有语义ID(10,21,35)的item应该更类似于具有语义ID的项目(10,21,40)。即相似的item的语义ID重叠度应该较高。例如,如果两个项目共享语义ID(12,24,52),
推荐系统广泛应用于短视频、电商等各类互联网产品中。推荐方法的本质是拟合历史用户行为数据,预测未来用户行为。推荐系统是过去 10 年中 AI 落地最成功的案例,但是在工业场景中,传统的推荐系统依然存在很多问题。
