


- @YoungOne2333


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
金九银十已过半,不知道大家现在都到哪个阶段了,有没有已经找到心仪的工作的朋友?有没有还没准备好面试在各大平台找资料临时抱佛脚的朋友?或是现在在准备,想要明年金三银四跳槽的朋友?不管你是现在急切找工作还是找资料备战,我都非常推荐你看看我花2个多月从GitHub,牛客,leetcode上为大家整理收集的2023中大厂Android面试八股文合集,我敢说你看完这份资料,必定能有所收获,不会的能查漏补缺,
面试官心理分析这个问题不仅工作中有,面试时也会被问到。一般会分成两种情况:推理和训练。推理时,我们主要考虑模型权重、KV 缓存和激活显存。而训练相比推理,还需要额外存储优化器状态和梯度,显存需求会更高。我们先说推理。为了助力朋友们跳槽面试、升职加薪、职业困境,提高自己的技术,本文给大家整了一套涵盖AI大模型所有技术栈的快速学习方法和笔记。目前已经收到了七八个网友的反馈,说是面试问到了很多这里面的知
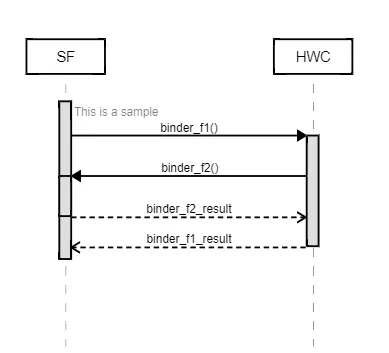
这是一个来自朋友的疑问,在`sf`调用`hwc`的`binder_f1`的函数中`hwc`调用`sf`的`binder_f2`,会导致线程的优先级从`97`降级为`120`。
在互联网寒冬下,许多程序员被裁,大环境格外困难。我发现一个奇怪的现象:那些跳槽的人,总是从一个坑,跳进令一个坑中。毕竟一年过去了,会的还是原来的知识,人的身价就摆在那里,无论怎么折腾,也不会拿到更好的 offer。这样的跳槽其实没有意义,也许就有人问,现在都是互联网寒冬了,要怎样才能把握好机会,拿到跟好跟适合自己的 offer 呢?
前段时间,有个朋友又出去面试了,这次他面试目标比较清晰,面的都是业务量大、业务比较核心的部门。前前后后去了不少公司,几家大厂里,他说给他印象最深的是字节。3 轮技术面 + 1 轮 HR 面,他最终拿到了 45k*16薪 的 Offer。第一轮主要考察 Java 基础,二、三轮注重对应技术的掌握,以及对过往项目的业务理解。之所以令他印象深刻,是因为每轮都聊了一个半小时以上,确实让他受益匪浅。他最终选
llama.cpp是一个高性能的C/C++语言模型推理工具,支持跨平台部署,可在普通电脑上流畅运行量化模型。文章详细介绍了通过Docker方式安装启动llama.cpp的完整流程,包括CPU/GPU版本的配置,以及使用其Web UI和OpenAI兼容API与模型交互的方法。该工具性能优异,依赖少,完全免费且私密,适合搭建本地AI应用,满足各类场景需求。
清华大学开发的Kronos是全球首个K线分析开源AI模型,基于120亿条K线数据训练,支持沪深市场复权数据。提供多个版本适应不同算力需求,可通过简单代码实现K线预测,支持模型微调。项目详细介绍了安装、使用及回测流程,是AI投资领域的实用工具。
ollama 是一个开源的本地大语言模型运行框架,它提供了非常简单便捷的使用形式,让用户可以十分方便的在本地机器上部署和运行大型语言模型,从而实现免费离线的方式使用 LLM 能力,并确保私有数据的隐私和安全性。
你是否有这样的经历:”知识库文档越来越多,知识库问答却越来越不靠谱,RAG检索到的都是一堆不相关的内容。“在这个信息爆炸的时代,我们不缺资料,缺的是找到"对的资料"的能力。元数据和标签看似普通,却能很大提升RAG能力。这篇文章聊一聊它们如何辅助RAG系统真正理解用户意图,精准找到需要的信息。
DeepSeek-V3 是 DeepSeek-V2 之后有一个新的版本,一个超大规模的 “混合专家”模型(MoE),671B 参数,激活 37B,在 14.8T token 上进行了预训练。它专为高效训练和推理设计,既能生成高质量文本,又能节省计算资源。用更低的成本(时间和算力)实现顶级性能,对标甚至超越闭源模型(如 GPT-4)。通俗的话讲专注文本任务,规模更大、效率更高,节省资源
