- @weixin_52610848


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
北京大学团队推出的Video-LLaVA与LLaVA-NeXT-Video在视频理解领域取得重大突破。Video-LLaVA通过"提前对齐"策略统一图像和视频特征处理,采用两阶段训练显著提升多模态理解能力,在多个视频问答基准测试中创下SOTA记录。LLaVA-NeXT-Video则基于LLaMA3等大模型架构,通过零样本学习和动态规划优化在视频任务中表现优异。两者分别以特征对齐
上海人工智能实验室推出的VideoChat开创了视频理解新范式,通过整合视频理解模型与大语言模型,提供两种创新交互模式:VideoChat-Text利用多感知模型显式描述视频内容,支持深度解析;VideoChat-Embed采用单一模型隐式编码视频语义,实现高效理解。该系统具备多模态交互、高度自动化、强扩展性等特点,可应用于在线教育、智能监控、视频摘要等多个领域。两种模式各有优势,Text模式侧重
对于经过蒸馏处理后的模型,在后续操作中仅采用了监督微调的方式,并未将强化学习阶段纳入其中。从以往的经验和相关研究可以知晓,若加入强化学习,能够在很大程度上进一步提升模型的性能。但此次研究的核心目的在于重点展示蒸馏技术本身的有效性,因此将强化学习阶段的深入探索留给更广泛的研究群体,以便众多研究人员能从不同视角深入挖掘与拓展,从而有力地推动整个领域的发展。通过这样的安排,清晰直观地呈现出蒸馏技术在赋予

【配套新书教材】《自然语言处理原理与实战》(人工智能科学与技术丛书)【陈敬雷编著】【清华大学出版社】新书特色:本书从自然语言处理基础开始,逐步深入各种NLP热点前沿技术,使用了Java和Python两门语言精心编排了大量代码实例,契合公司实际工作场景技能,侧重实战。

文章摘要: InstructBLIP和X-InstructBLIP是Salesforce研发的多模态大模型,基于BLIP-2升级,通过指令微调和跨模态推理技术实现突破。InstructBLIP创新性地将指令微调应用于视觉语言模型,其结构包含Image Encoder、Q-Former和大模型三部分,通过指令感知查询转换器提升特征提取能力。实验显示其在Zero-Shot任务中表现优异。X-Instr
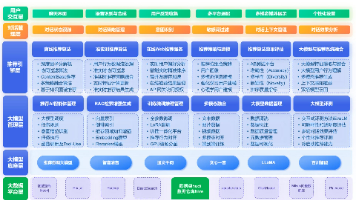
本文介绍了基于大模型的对话式推荐系统(CRS)的技术架构设计,重点探讨了从传统推荐系统到智能化、互动化CRS的演进。传统推荐系统主要依赖协同过滤、基于内容的推荐等方法,但存在冷启动、稀疏性等局限性。基于大模型的CRS则通过多轮对话、自然语言理解、深度语义分析等能力,实现更个性化、动态化的推荐体验。文章详细阐述了CRS的技术架构,包括大模型管理层(如推荐AI智能体管理、RAG检索增强生成、训练微调推
【配套新书教材】《自然语言处理原理与实战》(人工智能科学与技术丛书)【陈敬雷编著】【清华大学出版社】新书特色:本书从自然语言处理基础开始,逐步深入各种NLP热点前沿技术,使用了Java和Python两门语言精心编排了大量代码实例,契合公司实际工作场景技能,侧重实战。
字节跳动开源AI Agent开发平台Coze,包含Coze Studio和Coze Loop两大核心项目,采用低代码/无代码设计,支持多模态交互与任务自动化。该平台显著降低开发门槛,提升企业效率,如智能客服响应时间从3分钟缩短至15秒。相比竞品,Coze更侧重中文优化和中小企业需求,未来将加速各行业数字化转型,预计1-3年内60%中小企业将实现核心业务流程自动化。开发者可掌握低代码技能参与生态建设
【配套新书教材】《自然语言处理原理与实战》(人工智能科学与技术丛书)【陈敬雷编著】【清华大学出版社】新书特色:本书从自然语言处理基础开始,逐步深入各种NLP热点前沿技术,使用了Java和Python两门语言精心编排了大量代码实例,契合公司实际工作场景技能,侧重实战。
摘要: DeepSeek智能体通过时序控制、任务完整性保障和资源优化配置三大能力,突破传统AI模型被动响应的局限,实现7×24小时自动化任务处理。其架构设计聚焦任务解析引擎、执行流程编排(DAG管理)和状态管理系统(Redis+MySQL双存储),关键技术包括改进型Cron调度、三级异常处理及四维性能优化。部署采用Kubernetes容器化,配合Prometheus监控和PDCA持续迭代,并强调数