


- @2401_85343303


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
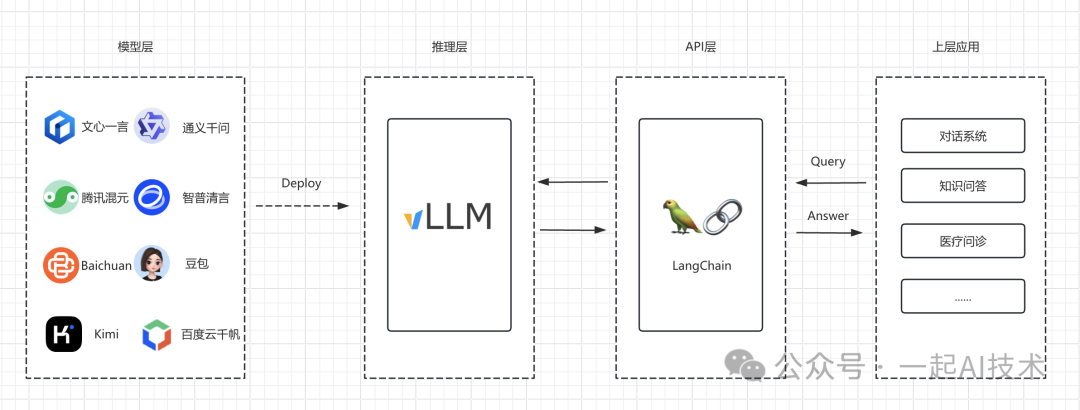
在上一章【[大模型三阶段训练方法(LLaMa Factory)]】内容中主要了解一个大模型的训练过程,无论是第三方的大模型还是自研的大模型,都需要部署到服务端,提供对应API接口供上层应用使用。所以,本章将主要了解vLLm + langchain的基本使用方法。
Llama 3.1 介绍2024 年 7 月 24 日,Meta 宣布推出迄今为止最强大的开源模型——Llama 3.1 405B,Llama 3.1 405B 支持上下文长度为 128K Tokens, 增加了对八种语言的支持,号称第一个在常识、可操纵性、数学、工具使用和多语言翻译方面与顶级人工智能模型相媲美的模型。当然 405B 新一代大模型所需要的算力成本也是巨大的,一般的中小型企业和个人需

你想要应用大模型,不会部署大模型那怎么能行?想要应用大模型,但是又不知道该如何下手?很多做技术的朋友一直对大模型应用跃跃欲试,大家也不想单单期望聚焦在指令应用阶段,还是想深度应用,我建议你可以分阶段深入,毕竟学习得有个循序渐进,不能一蹴而就。本篇文章我将聚焦在模型部署应用,希望对你有帮助!!!本篇文章聚焦在我在本地Windows环境下部署ChatGLM3-6b-32k的实操过程,分享我这次的操作过

*12月5-6日,2024中国生成式AI大会(上海站)「GenAICon 2024」将在上海中星铂尔曼大酒店盛大举办。**中国生成式AI大会已成功举办两届,迅速成长为国内生成式AI领域最具影响力的产业峰会之一。此次也是中国生成式AI大会首次登陆上海举办,由智一科技旗下智能产业第一媒体、AI与硬科技知识分享社区共同发起。本次大会的指导单位是大会上海站将设置**“主会场峰会+分会场研讨会+展览区”**

提供完整学习路线,包含7个阶段从系统设计到行业应用开发,配套300集视频教程、技术文档、面试题等资料。内容涵盖提示词工程、平台开发、模型微调等实践技能,帮助掌握大模型全栈开发能力。资源包括100套商业化方案、200本电子书及产品经理专项资料,全部免费获取。

文章摘要:全景图谱将端侧AI产业链划分为芯片、模型、终端、应用四大板块,细分为19个领域,涵盖核心技术演进趋势。报告免费提供AI大模型学习资料,包含7阶段课程体系(系统设计、提示词工程、平台开发等),帮助掌握大模型全栈开发能力,实现商业化落地应用。学习资源包括路线图、视频教程、书籍及面试题库,可通过扫描二维码免费获取。

本文详细介绍了Windows环境下Docker Desktop和n8n工具的汉化过程。首先通过替换asar文件实现Docker Desktop界面汉化,然后通过下载对应版本的汉化包并配置容器卷实现n8n的汉化。教程提供了详细的操作步骤和注意事项,即使是零基础用户也能按照指引完成。作者还推荐了AI考证和Coze智能体变现训练营,帮助读者进一步学习AI技能。

端侧AI是将人工智能模型部署在终端设备实现本地计算的技术,具有速度快、省流量、保护隐私等优势。文章全面解析了端侧AI产业链:上游涵盖AI芯片、SoC、存储芯片、智能传感芯片和AI模组等核心硬件;中游涉及市场规模、生成式AI端侧化趋势及国内参与者现状;下游应用于智能汽车、机器人等领域。随着技术突破和应用场景扩展,端侧AI正成为人工智能发展的重要方向,市场规模快速增长。

Qwen3 WebGPU项目允许用户在浏览器中离线运行Qwen3-0.6B大语言模型,无需安装且数据完全本地处理,保障隐私。该项目利用WebGPU硬件加速、Transformers.js和ONNX Runtime Web技术,代表了AI应用边缘化、去中心化和隐私优先的未来趋势,为开发者提供了在网页中集成强大AI功能的新可能。

知识蒸馏是一种模型压缩技术,通过大型教师网络将知识迁移到小型学生网络中。学生网络不仅学习真实标签,还模仿教师网络的软目标输出分布,保留类别间细微差异。这种技术使用温度参数软化softmax输出,通过KL散度计算蒸馏损失,并结合硬标签损失进行训练。知识蒸馏可大幅减小模型体积,同时保持接近教师网络的性能,特别适用于资源受限设备的部署。文中提供了CNN和语言模型的PyTorch实现示例,并介绍了多种蒸馏
