- @zhongkeyuanchongqing


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
Linux(ubuntu)下安装anaconda(64位)并配置jupyter notebook远程访问Anaconda指的是一个开源的Python发行版本,其包含了conda、Python等180多个科学包及其依赖项。里面所包含的Jupyter Notebook是数据挖掘领域中最热门的工具。ipython notebook是一个基于浏览器的python数据分析工具,使用起来非常方便,具有极强的交
问题:使用opencv dnn 模块调用darknet模型时候出错,报错信息为 不支持relu激活函数以下过程为笔者自己解决该问题的过程,供各位参考学些,因为中间又遇到新的坑,所以各位务必看完再决定如何操作执行。cv2.dnn.readNetFromDarknet error: (-212:Parsing error)Unsupported activation: relu in function
import h5py ImportError: DLL load failed: the specified module could not be found问题:import h5py解决:导入h5py出错,多半是在安装时出错了。如果原本使用pip安装pip uninstall h5py删除之后,尝试使用conda进行安装。conda install h5py完整错误:Traceback (
Error: 'attrition' is not an exported object from 'namespace:rsample'

ParserError: NULL byte detected. This byte cannot be processed in Python's native csv library at the moment, so please pass in engine='c' instead目录ParserError: NULL byte detected. This byte cannot be

pandas使用cut函数基于分位数进行连续值分箱(手动计算分位数)处理后出现NaN值原因及解决目录pandas使用cut函数基于分位数进行连续值分箱(手动计算分位数)处理后出现NaN值原因及解决问题:解决:['bad', 'good', 'medium', 'medium', 'good', ..., NaN, NaN, 'medium', 'good', 'awesome']Length: 1

什么是数据湖(Data Lake)?有些东西就是概念,故弄玄虚,just fancy nameswikipedia:A data lake is usually a single store of all enterprise data including raw copies of source system data and transformed data used for tasks su

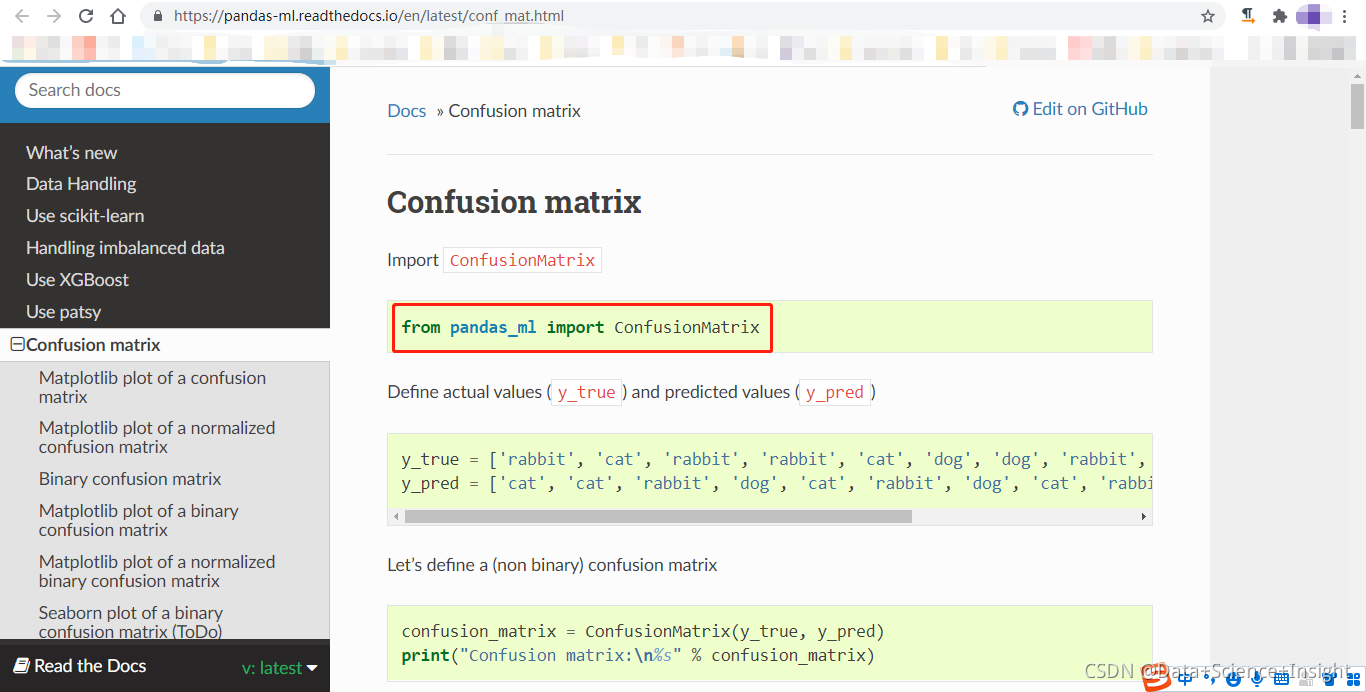
Python使用pandas_ml输出混淆矩阵以及从混淆矩阵衍生出来的其他指标:TP、TN、FP、FN、TPR、TNR(SPC)、PPV、NPV、FPR、FDR、FNR、ACC、F1、MCC等目录Python使用pandas_ml输出混淆矩阵以及从混淆矩阵衍生出来的其他指标:TP、TN、FP、FN、TPR、TNR(SPC)、PPV、NPV、FPR、FDR、FNR、ACC、F1、MCC等#panda
pandas中set_option的常用设置:显示所有行、显示所有列、控制浮点型精度、每个数据元素的显示字符数、对齐形式等

maven国内镜像及配置方法