


- @2401_85375186


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
自ChatGPT模型问世后,在全球范围内掀起了AI新浪潮。有很多企业和高校也随之开源了一些效果优异的大模型,例如:Qwen系列模型、MiniCPM序列模型、Yi系列模型、ChatGLM系列模型、Llama系列模型、Baichuan系列模型、Deepseek系列模型、Moss模型等。图片来自:A Survey of Large Language Models并且在去年的一整年中,大多数人都在做底座通

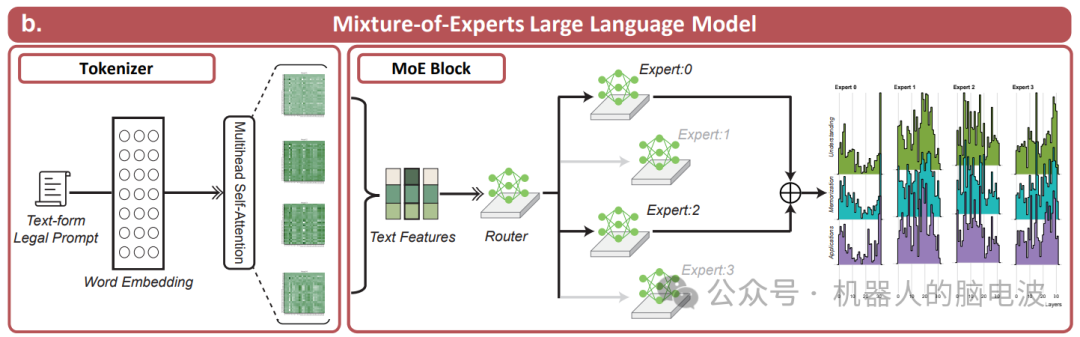
基于大型语言模型(LLMs)的法律助手能够提供便捷的法律咨询服务,但幻觉问题可能带来潜在的法律风险。本文介绍了Chatlaw,这是一种创新的法律助手,利用专家混合(MoE)模型和多智能体系统来提高AI驱动的法律服务的可靠性和准确性。通过将知识图谱与人工筛选相结合,我们构建了高质量的法律数据集来训练MoE模型。此模型利用不同的专家来解决各种法律问题,从而优化法律回应的准确性。另外,模仿真实律师事务所
LlamaIndex 和 LangChain 都是优秀的 LLM 开发框架,它们各有优势,适用于不同的使用场景。如果你需要构建一个以数据为中心的应用,并且希望使用一个简单易用的框架,那么 LlamaIndex 是一个不错的选择。如果你需要构建一个复杂的 LLM 工作流程,并且需要高度的灵活性和更广泛的 LLM 支持,那么 LangChain 是一个更好的选择.当然,更灵活多变的用法可将两者结合起来

这种Agent既可以是软件形式的程序,例如对话机器人,也可以具备物理形态,比如扫地机器人。在了解AI Agent之前,我们先考虑一个场景:我们要写一本20万字的关于人工智能最新技术的书在没有大模型之前,我们一般会按照如下流程~第一步:先使用搜索引擎搜索一些相关书籍和信息进行阅读,为我们打开思路第二步:形成本书的大纲,并且考虑清楚每一章节要编写的内容第三步:针对每一个章节进行内容的编写,在编写过程中

关于本书“2022年底,ChatGPT 震撼上线,大语言模型技术迅速“席卷”了整个社会,人工智能技术因此迎来了一次重要进展。面对大语言模型的强大性能,我们不禁要问:支撑这些模型的背后技术究竟是什么?这一问题无疑成为了众多科研人员的思考焦点。必须指出的是,大模型技术并不是一蹴而就,其发展历程中先后经历了统计语言模型、神经网络语言模型、预训练语言模型等多个发展阶段,每一步的发展都凝结了众多科研工作者的

本文以通俗易懂的方式梳理了13个常见的AI概念,从最基础的大模型、Token、AIGC、多模态等底层地基,到提示词、知识库、RAG、幻觉等调教层,再到智能体、工作流、MCP等干活层,以及数字人、具身智能等最终形态,帮助读者构建清晰的AI知识体系。文章强调理解“大模型→智能体”的核心逻辑,并指出在AI时代,成为能够为团队定方向、做决策的人比掌握所有技术名词更重要。
好了,以上就是目前所总结的 Agent 九大设计模式,其实 Agent 中。

本文针对RAG简历包装化问题,指出面试官看重具体技术决策与量化效果。文章详细解析了离线解析、在线召回等核心模块的简历写法,强调需包含具体技术栈及合理数据。同时提供了数字估算方法与完整简历案例,旨在帮助求职者写出高含金量简历,将面试转化为优势。
如何将DeepSeek-R1 模型能力蒸馏到 Qwen-1.5B,使其具备与 o1-mini 相似的能力?该过程分准备和蒸馏两阶段,准备阶段选定教师(R1)和学生(Qwen-1.5B)模型,蒸馏阶段将教师知识提炼给学生模型,达成降低计算成本目的。
文章系统介绍了深度学习模型压缩三大技术:剪枝(移除冗余连接)、量化(降低数值精度)和知识蒸馏(教师模型指导学生模型)。通过技术组合应用,可实现模型尺寸大幅减小、推理速度显著提升,并使模型能够在资源受限的边缘设备部署。实践案例显示,组合技术可达到16倍模型压缩和4倍以上推理加速,同时保持可接受的精度损失。