登录社区云,与社区用户共同成长
邀请您加入社区
Attu 是 Milvus 的一体化开源管理工具,提供了直观的图形界面,让你可以像操作 MySQL 一样管理 Milvus。访问 Attu GitHub Releases 页面,下载对应操作系统的安装包。,而是通过角色间接分配。这样修改角色权限时,所有拥有该角色的用户自动更新。Milvus 通过 RBAC(基于角色的访问控制)实现细粒度的权限管理。如果启用了认证,还需要输入用户名和密码。打开 At
我们可以使用 Milvus 搭建多模态 RAG 应用,用于产品推荐系统。用户只需简单上传一张图片并输入文字描述,Google 的 MagicLens 多模态 Embedding 模型就会将图像和文本编码成一个多模态向量。然后,使用这个向量从 Milvus 向量数据库中找到最相似的亚马逊产品。???????? Milvus 魔法:图像搜索和智能购物!您是否曾经希望只需上传一张图片并简单描述你想要的东
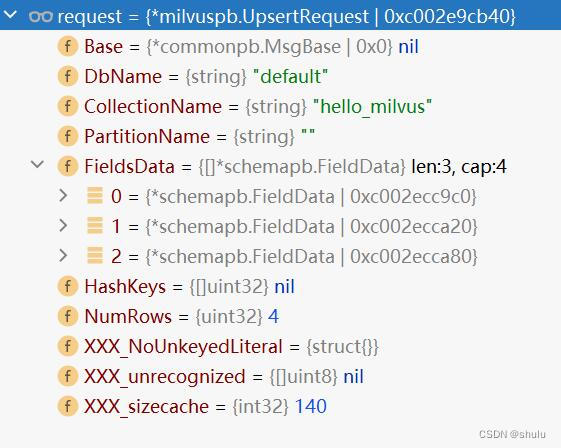
该方法将实体更新插入到 Milvus 中。如果集合中已存在指定字段,则该操作将覆盖现有实体;如果指定值尚不存在,则插入新实体。:先insert再delete,并限制不能修改主键列。:主键的autoid必须是false。:会带来一定的性能开销。
根据这个类的功能,它主要是为 Milvus 连接提供了连接池管理功能,因此类名可以更准确地反映这个核心功能。其他备选方案如果更符合您的代码库命名风格也可以考虑,但核心是要突出"连接池"这个关键功能。我个人推荐第一个或第三个选项,因为它们更简洁明了。
为了优化系统资源使用,我们可以使用Milvus的连接池功能。以下是优化后的代码,主要改进点包括:主要优化点说明:连接池管理:连接参数优化:Milvus配置优化:错误处理增强:性能优化:这种实现方式可以显著减少系统资源消耗,特别是在高并发场景下,避免了频繁创建和销毁连接的开销。
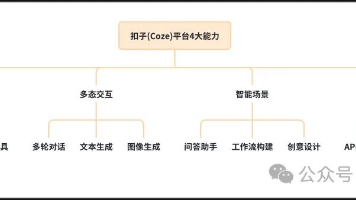
在扣子(Coze)平台中,工作流是指将多个任务或操作按顺序和逻辑进行组合,通过自动化的方式来处理复杂的业务场景。
collection_properties (Optional[dict[str, any]]): The collection properties. Defaults to None.If set, will override collection existing properties. 集合属性。collection_description (str): The description o
milvus的安装指南是真的做的不好,所有东西都给封装到docker里,确实,docker很方便,可并不是所有电脑,所有服务器都能按照他的那一套流程下来,但封装下来,出问题了找起来真的很麻烦)。总结就是,pymilvus版本,milvus版本和SDK版本。SDK版本我们尽量不调整,通过pip更改pymilvus版本,通过docker-compose.yml更改milvus版本,直到对应完成。下载的
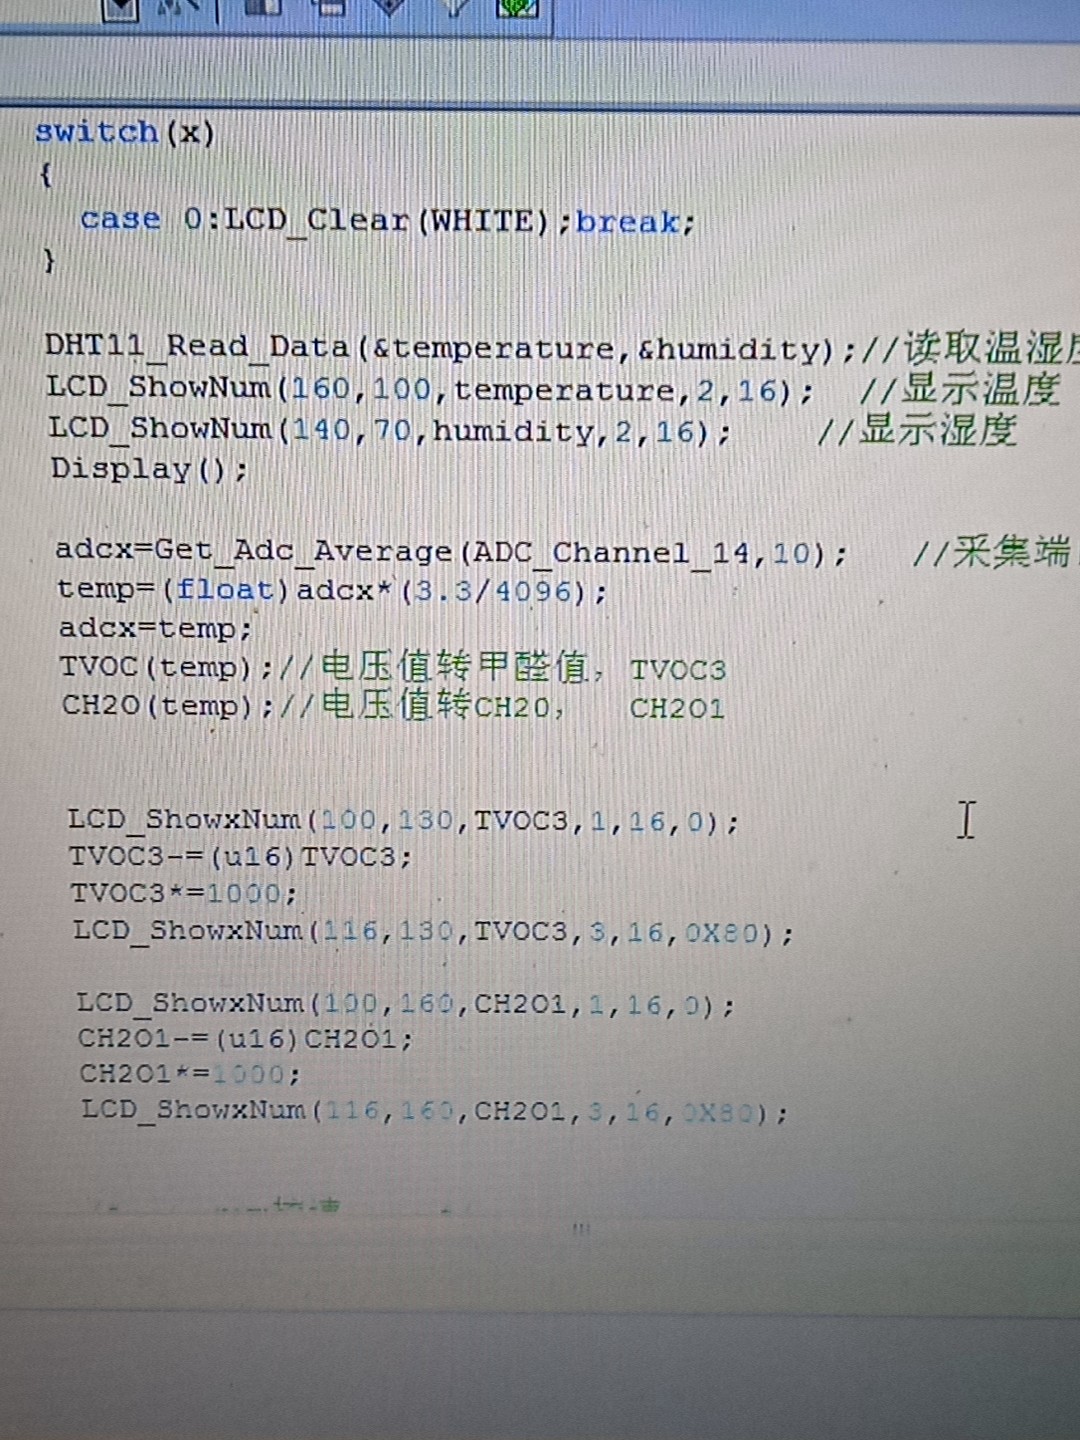
实测发现当Kp=2.5,Ki=0.05,Kd=0.8时,风扇转速能快速稳定且没有超调。这种级别的注释对硬件调试太友好了,特别是当I2C通信异常时,能快速排查是软件配置问题还是硬件电路问题。有次焊接时不小心把SCL和SDA接反了,结合注释里的信号波形图,用逻辑分析仪五分钟就定位到了问题。甲醛检测用的ZE08-CH2O模块,这玩意儿是串口输出的。主控采用stm32f103rct6可实现温湿度检测,ch
我理解您的问题了,您需要确保方法与父类的方法签名完全匹配,同时实现连接池功能。
我们需要存储电影的基础信息和向量数据,创建包含 6 个字段的集合:python运行DIMENSION = 1536 # 与OpenAI模型输出维度一致# 定义Schema,注意字符串字段需设置最大长度schema.add_field("id", DataType.INT64, is_primary=True) # 主键IDschema.add_field("title", DataType.VAR
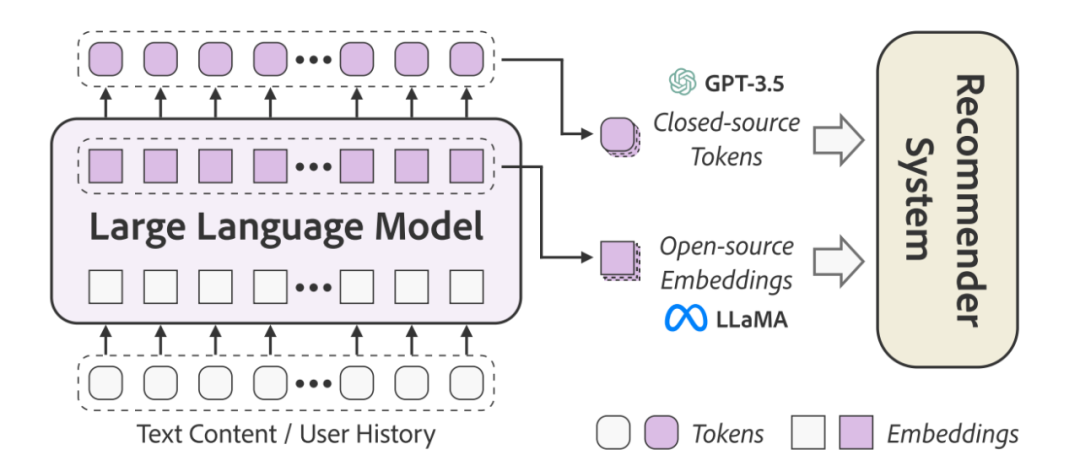
谈具体的应用之前,我们先从宏观上理解一下大模型的出现对推荐系统到底意味着什么。就像在改造推荐模型时,我们一定要清楚信息增量在哪、模型结构的优化点在哪一样,我们并不是因为大模型这个技术比较fancy,所以才把大模型施加到推荐系统之上,而是因为大模型确确实实能够为推荐系统带来知识和模型的全新变化,让推荐效果受益,才应用大模型技术的。因此我想先从宏观上解释一下大模型对推荐系统的实际意义到底是什么。我的理
阿里云向量检索服务 Milvus 版,为中免日上搭建在线推荐系统提供了有力的技术支持。阿里云 Milvus 具备优秀的可观测性、弹性扩缩能力、版本平滑升级能力和极高的稳定性,较好地支撑了中免日上的在线推荐业务。
将函数调用(Function Calling)与 LLM 相结合能够扩展您的 AI 应用的能力。通过将您的大语言模型(LLM)与用户定义的 Function 或 API 集成,您可以搭建高效的应用,解决实际问题。
将函数调用(Function Calling)与 LLM 相结合能够扩展您的 AI 应用的能力。通过将您的大语言模型(LLM)与用户定义的 Function 或 API 集成,您可以搭建高效的应用,解决实际问题。本文将介绍如何将 Llama 3.1 与 Milvus 和 API 等外部工具集成,构建具备上下文感知能力的应用。01Function Calling 简介诸如 GPT-4、Mistral
RAG,即检索增强生成,是一种通过整合外部数据源来增强大语言模型(LLM)的技术。一个典型的 RAG 应用包括:索引流水线(Pipeline):用于从外部数据源中摄取数据并对其进行索引,随后加载、拆分并将数据存储在 Milvus 中。检索和生成:将用户查询转换为 Embedding 向量,然后从 Milvus 中检索相关数据形成上下文,然后 LLM 上下文生成响应。文本将提供实用的操作指导,向您展
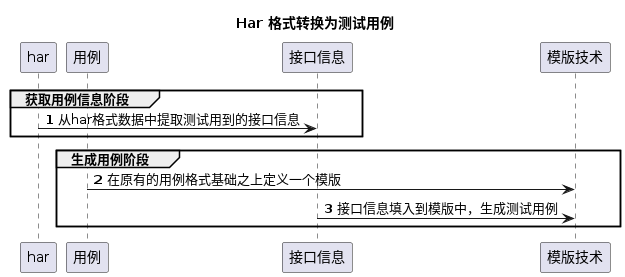
掌握接口自动化测试用例生成的原理。了解如何通过大语言模型生成接口自动化测试脚本与数据。掌握通过LangChain生成完整版接口自动化测试用例的方法。
本文详细介绍了基于Milvus的性能测试与基准,包括确定性能指标、基准测试方法和测试效果的可视化。通过合理的性能测试,可以全面评估Milvus在不同场景下的性能表现,从而指导系统的优化和改进。希望本文对大家理解和实施性能测试有所帮助。通过上述流程和代码示例,可以高效地进行Milvus的性能测试与基准评估,确保系统在实际应用中的高效稳定运行。
不论是问答还是推荐,它们对上层暴露的接口仅仅是query(...),模式是相同的,因此可以共用一个基本的Schema,固定基本的字段即可。// 被embedding的字段.build();// embedding vector字段.build();
Milvus 是一款面向大规模非结构化数据的高性能向量数据库,擅长相似度检索与 AI 检索增强。本文将介绍如何通过 Docker Compose 快速部署 openEuler 构建的 openeuler/milvus,轻松搭建可自托管的向量检索节点,适合 RAG、图像检索、推荐召回与多模态检索等场景。
本文是为Windows用户量身定制的Milvus Lite本地部署全攻略。内容涵盖从环境搭建、标准化依赖管理,到代码实战的完整流程,并附有详尽的常见错误排查指南,旨在帮你绕开所有“坑”,高效地在本地把Milvus跑起来。
【代码】deepseek私有化RAG思路 ollama 运行deepseek模型和向量化模型bge-m3,anything 实现喂数据到向量化数据库milvus,deepseek4j结合便可以实现RAG私有。
curl -X POST http://localhost:5000/chat -H "Content-Type: application/json" -d '{"message":"如何重置密码?缺少C++运行库,需要下载Visual Studio C++,输入https://aka.ms/vs/16/release/vc_redist.x64.exe,进行下载。f.write(f"问题:{ro
阿里云向量检索服务 Milvus 最新版本 2.5 在全文检索、关键词匹配以及混合检索(Hybrid Search)方面实现了显著的增强,在多模态检索、RAG等多场景中检索结果能够兼顾召回率与精确性。
01.背景混合搜索(Hybrid Search)作为RAG应用中Retrieve重要的一环,通常指的是将向量搜索与基于关键词的搜索(全文检索)相结合,并使用RRF算法合并、并重排两种不同检索的结果,最终来提高数据的召回率。全文检索与语义检索不是非此即彼的关系。我们需要同时兼顾语义理解和精确的关键字匹配。比如学术论文的写作中,用户不仅希望在搜索结果看到与搜索查询相关的概念,同时也希望保留查询中使用的
使用openssl生成证书,把生成的server.crt和server.key本地修改名字为public.crt和private.key。把这两个文件上传到服务器,我放到了/home文件夹下,然后复制到容器内部。8.可以使用https访问minio了。查看证书是否已经复制到容器内。在容器内执行交互模式。
本文将详细介绍如何安装支持 GPU 的 Milvus 版本,以及所需的硬件和软件环境要求。
链接打不开的话直接使用下面文件:server_config.yaml。将刚才新建的3个文件夹目录映射到milvus容器。milvus数据存储、日志、配置文件路径如下。宿主机的2个端口号 映射到 milvus容器。conf: 存放配置文件。logs: 存放日志。
milvus目前仅支持docker部署,那么windows 想要部署milvus怎么操作呢,我们一起来探索下。不一定能成功,只是做个记录!打开程序和功能启用或关闭Windows功能选中Hyper-V。
在ubuntu上搭建Milvus的以图搜图服务
部署milvus服务(在线部署docker、docker-compose、milvus服务);CentOS使用docker-compose在线部署milvus服务(超详细)
摘要: 向量数据库选型对RAG系统至关重要,但常被忽视导致后期成本、性能或运维问题。本文基于实际场景对比四大主流方案:Milvus(功能全但复杂,适合亿级数据)、Pinecone(省心但贵,适合无合规需求的小团队)、Chroma(开发友好但生产慎用)、Weaviate(混合检索优势)。推荐根据数据规模、运维能力和合规要求选择,并通过VectorDBBench或自定义压测验证性能。关键原则:原型阶段
你手机里的相册 App,搜索"猫"就能找到所有猫的照片。这背后不是靠文件名匹配,而是靠 语义理解——它知道照片里"有猫"。传统数据库做不到这件事,向量数据库可以。打个比方:传统数据库像图书馆的索引卡片——你必须知道书名或作者才能找到书。向量数据库像一位懂你的图书管理员——你说"那本讲外星人和小男孩友谊的书",他就能找到《E.T.》的相关资料。在学习向量数据库之前,你可能用过更简单的方案:方案一:L
Milvus 和 Qdrant 都是优秀的向量数据库,没有绝对的优劣,只有是否适合。对于 Java 团队而言,两者都提供了成熟的客户端,集成成本相当。建议在技术选型初期,根据业务的数据规模、性能指标和团队技术偏好,用实际业务数据进行POC(概念验证)测试,用数据说话,从而找到最适合你当前场景的向量数据解决方案。
在当今的大数据时代,数据库作为数据的和管理中心,发挥着越来越重要的作用。而作为一种新兴的数据库类型,因其独特的向量索引和向量计算能力,被广泛应用于推荐系统、等领域。Milvus作为一款开源的向量数据库,以其高性能、可扩展和易用的特点,受到了广泛的关注和应用。为了更好地管理和应用Milvus向量数据库,我们推出了一款名为Milvus_cli的命令行工具。Milvus_cli是一款便捷的数据库客户端,
milvus
——milvus
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 openEuler 社区

 乐奇 Rokid 开放社区


 天工造物局









 AtomGit开源社区