- @xx_nm98


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
比如这次 o3 发布会,两位技术专家的 demo 明显不如 Sam Altman 会讲。两位技术专家都是我非常膜拜的大神,但做 demo 的时候仍然很难让外行人理解这技术有多么牛逼。在 demo 中,o3 mini 自己写了个 Agent 框架,一次跑通,用户又在这个 Agent 框架里写了一个评测自己的程序,也是一次跑通,最后出来一个 61% 的性能指标。我们内行人直呼太强了,但旁边的 Sam

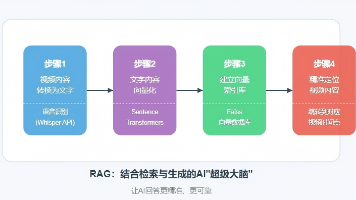
基于RAG的视频检索技术通过结合信息检索与生成式AI,实现视频内容的语义理解与精准定位。系统采用六步架构:多模态内容提取、语义分块、嵌入编码、向量索引、查询处理和结果生成,支持自然语言查询视频内容。该技术应用于教育、企业培训、媒体制作等领域,可大幅提升视频内容检索效率,将传统"观看视频"转变为"查询视频"的知识获取新模式。
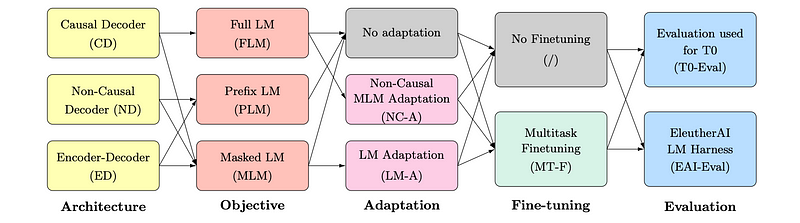
首先让我们先来熟悉一下关于模型结构的术语。Encoder: 处理输入数据并将其转换为压缩后的特征表示形式,用以捕捉基本信息。在翻译任务中,编码器将一个英语句子转换为代表其语言特点和含义的特征编码向量。Decoder: 接收编码后的特征表示并生成输出,通常是不同的形式。在上述翻译任务中,解码器接收英语句子的编码表示,并生成其法语等效句子。举例: 基于Bert的模型预训练方法:基于mask掩码的语言建
Hugging Face 向来对开发者用户理解深入,加上它社区的优势,它发布的很多框架都能够获得不错的反响,
同一张显卡上跑同一个模型,Ollama 单用户秒吐,一上并发就被 vLLM 甩开几条街。差距怎么来的?看完 7 个对比你心里就有数了。你有没有过这种时刻——想本地跑个大模型玩玩,网上一搜,名字冒出来两个:Ollama、vLLM。

在 AI Engineer World's Fair 上,Diogo Almeida 分享了《What's next after RLHF?》主题演讲(录像视频后更名为《Jev CEO: I made ChatGPT, now I'm building what's next》)。Diogo 是 TypeSafe AI 的联合创始人兼 CEO,也是 Jev 的创造者。他曾参与 GPT-4 和 Ch

用 LangGraph 的 Reducer,轻松搞定多轮对话记忆做聊天机器人最头疼的是什么?是记不住上文。今天分享一个 LangGraph 的小技巧:用 Reducer 机制优雅地管理对话历史。
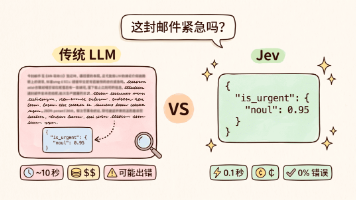
过去几年,不管是 ChatGPT、Claude 还是 DeepSeek,AI 大模型的目标一直都是「跟人聊天」和「帮人干活」。但最近有个模型突然火了,它有点儿特别,**不说人话、不能跟人聊天**。它叫 Jev,由前 OpenAI 研究员 Diogo Almeida 创办的 TypeSafe AI 发布,这哥们是 ChatGPT 的共同发明人之一!
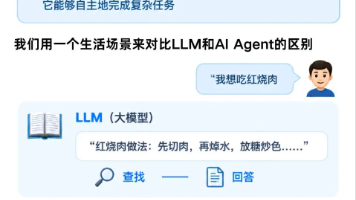
这两年大家都在聊AI Agent,很多人其实还停留在“它是不是更聪明的 ChatGPT”这个理解上。Agent和普通大模型最大的区别是能围绕目标去规划、记忆、调用工具,再一步步把事情执行完。
其实准确的来说,Claude Code 的上下文压缩有5级流水线,不是网上说的4级,也不是3级别。而且,有2个是没有源码的,后面我会介绍到。如果你没有看过源码,可能误以为5级的源码都有。