


- @weixin_48534929


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
本文以真实生产场景的实测链路为贯穿实例:基于 EMR Serverless Spark 上的 Ray 运行 EMR Embodied AI 数据生产管线。

本文介绍的介绍的主题是 Flink 和 Hudi 在数据湖 Streaming 方向的一些探索和实践,将会围绕以下四点展开:• Apache Hudi 背景介绍• Flink Hudi 设计• Hudi 应用场景• Hudi RoadMap

山海经》里有一种能自行生长、永不耗减的神土,名叫"息壤"。对具身智能和世界模型而言,数据就是这片土壤。机器人要操作物理世界、世界模型要预测时空演变,靠的都不是几百条精修样本,而是海量、多源、贴近真实、且经严格质检与标注的操作数据。只是这片土壤想真正"长"起来,同样面临着挑战。
面向 Agentic AI,人工智能平台 PAI 不断迭代,为模型与智能体的创新提供坚实基础。
阿里云以 DLF、Flink、EMR Spark/Ray/Daft、EMR StarRocks、Milvus 五大核心产品协同构建了"Agentic Lake + Agentic Streaming"技术体系,为自动驾驶、具身智能、大模型数据预处理、企业智能运营等场景提供下一代全模态数据基础设施。
本次案例主要分享森马集团面对多年自建的多套数仓产品体系,通过阿里云MaxCompute+Hologres+DataWorks统一数仓平台,保障数据生产稳定性与数据质量,减少ETL链路及计算时间,每年数仓整体费用从300多万降到180万。

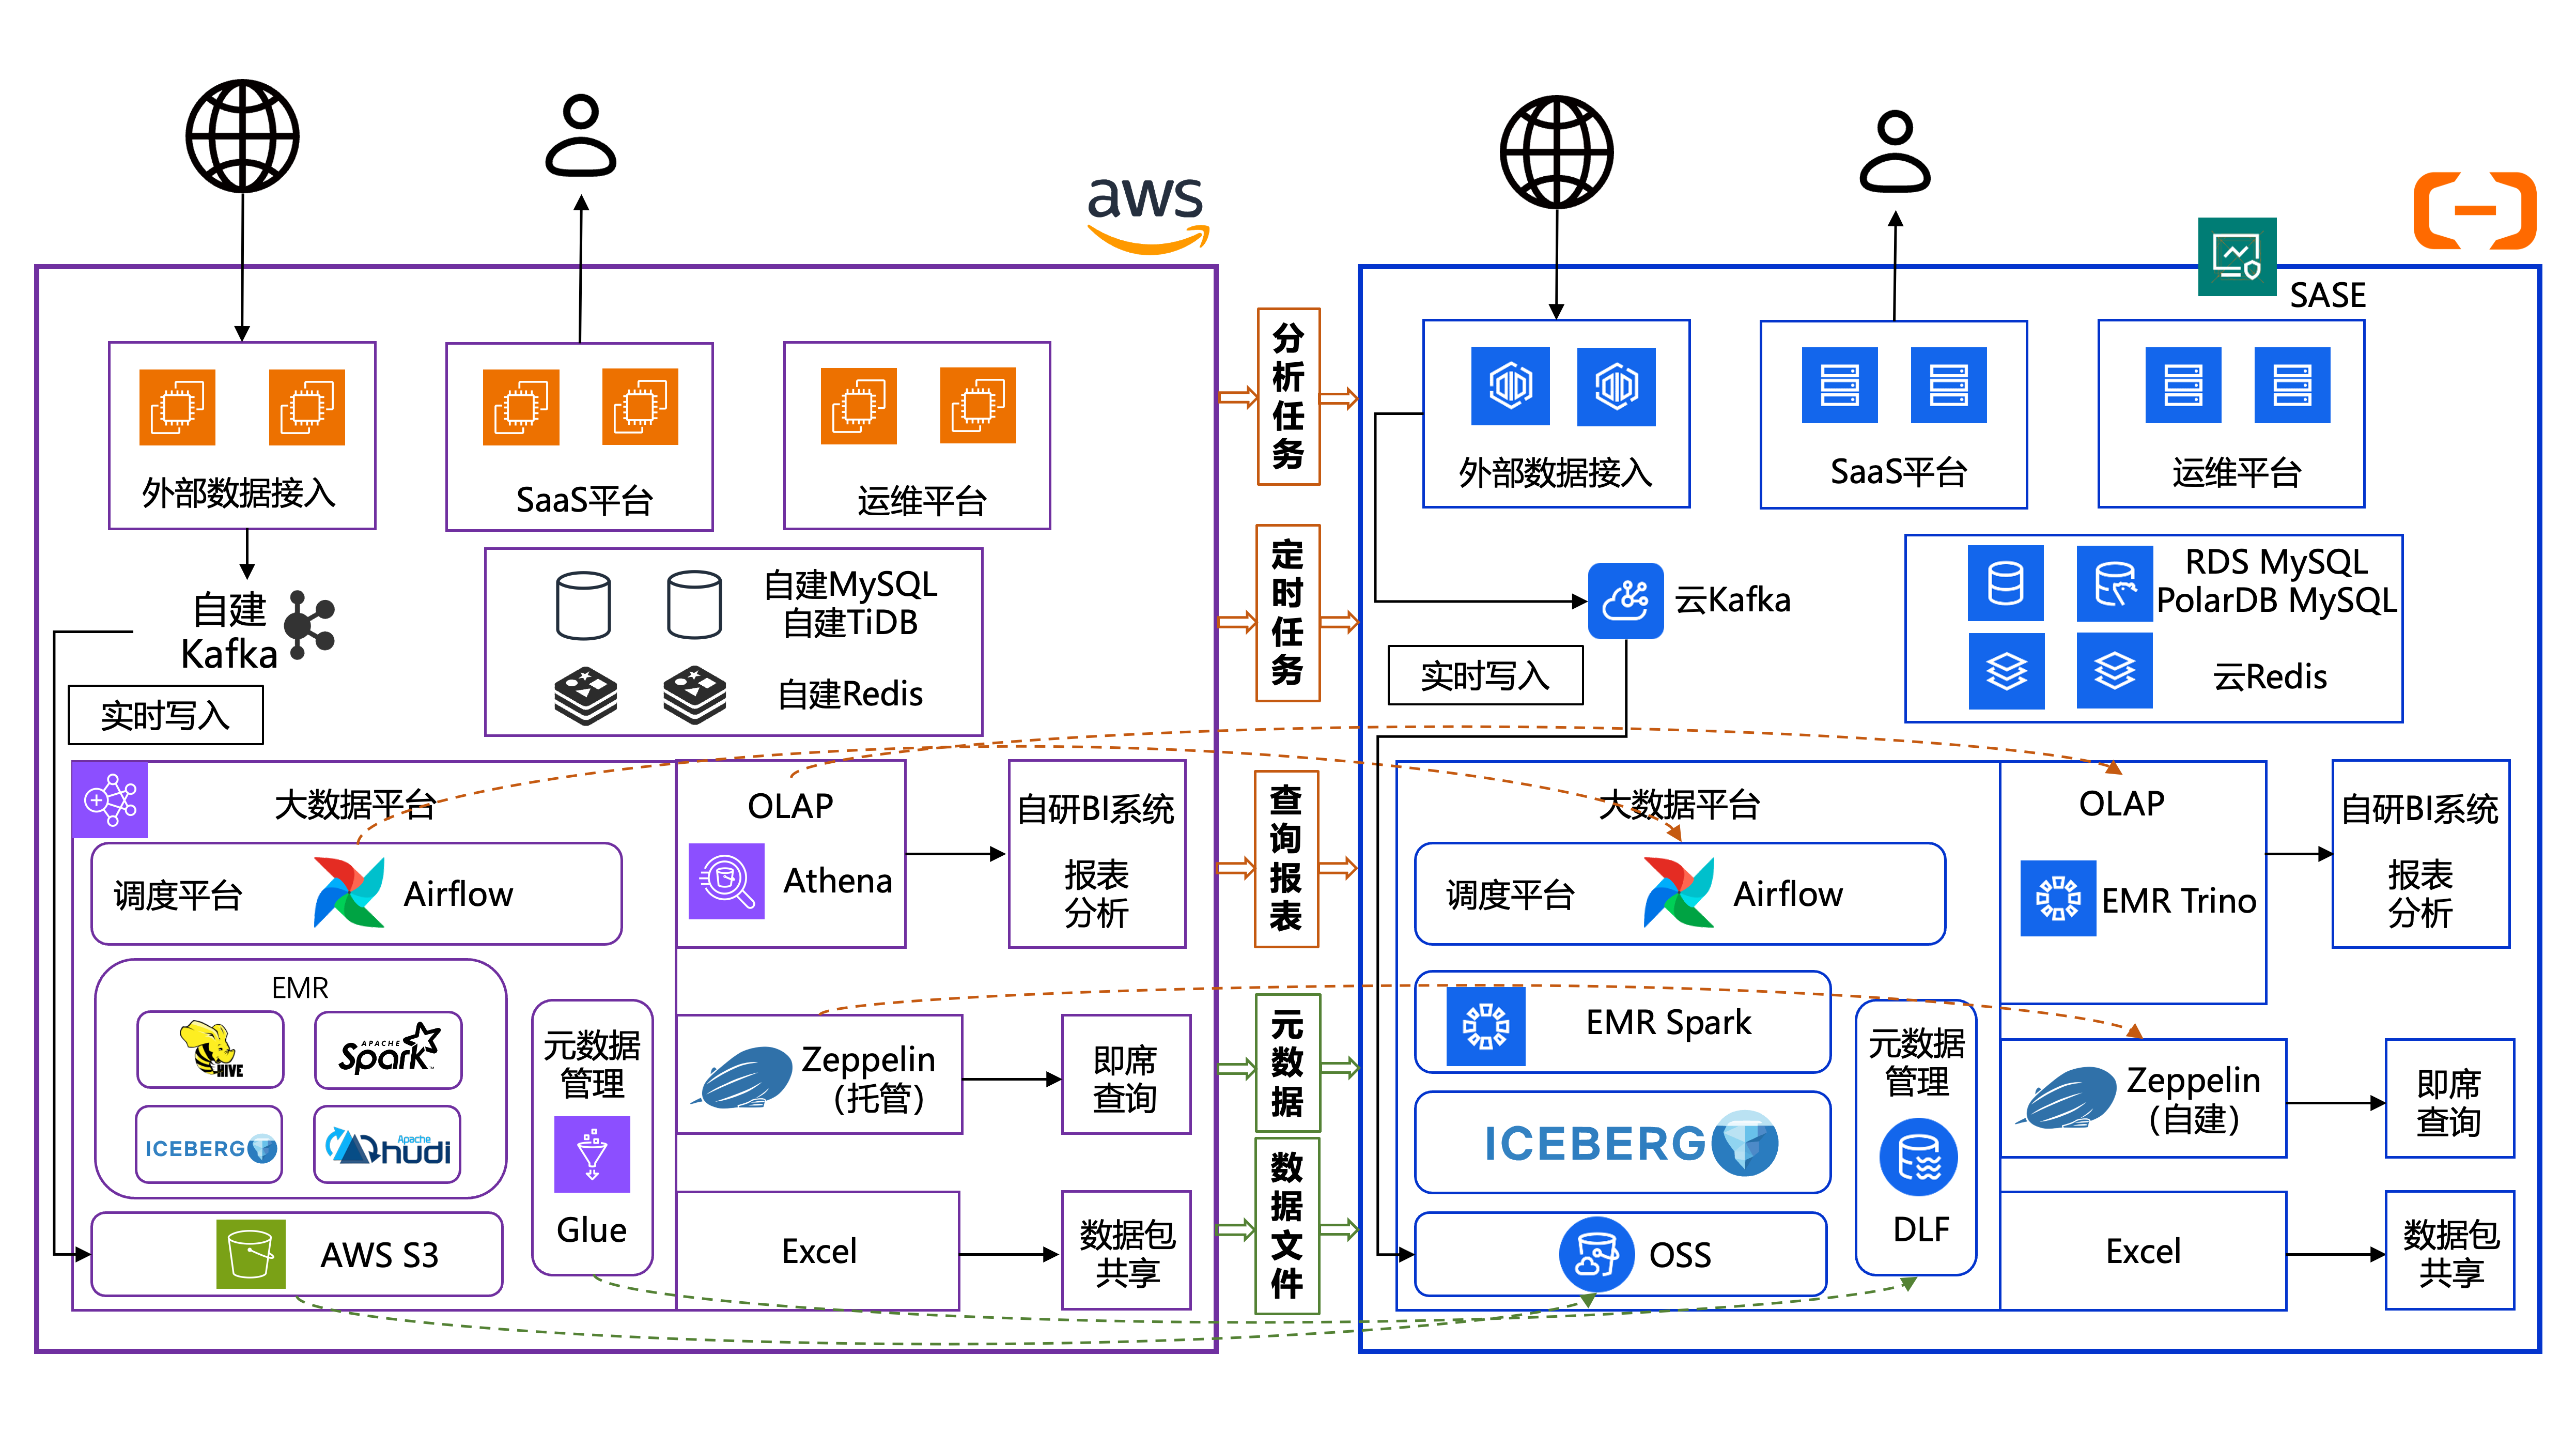
百观科技为应对海量复杂数据处理的算力与成本挑战,基于阿里云 EMR 构建数据湖。EMR 依托高可用的 OSS 存储、开箱即用的 Hadoop/Spark/Iceberg 等开源技术生态及弹性调度,实现数据接入、清洗、聚合与分析全流程。
阿里云向量检索服务 Milvus 版,为中免日上搭建在线推荐系统提供了有力的技术支持。阿里云 Milvus 具备优秀的可观测性、弹性扩缩能力、版本平滑升级能力和极高的稳定性,较好地支撑了中免日上的在线推荐业务。
前端组件生态演进之路,frontend 针对 “可扩展、方便插拔”这两个关键点进行架构升级。
阿里云向量检索服务 Milvus 最新版本 2.5 在全文检索、关键词匹配以及混合检索(Hybrid Search)方面实现了显著的增强,在多模态检索、RAG等多场景中检索结果能够兼顾召回率与精确性。