


- @m0_59164520


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
推荐系统在电商和流媒体等领域扮演着核心角色,但现有方法通常将用户行为序列建模和特征交互作为两个独立模块处理,这导致信息无法双向流动,模型难以统一优化和扩展,限制了性能提升。为了解决这一问题,本论文提出**OneTrans**,一个统一的Transformer框架,将序列和非序列特征融合到一个模型中。该框架通过参数共享和特定设计,实现了高效的双向信息交换,在工业数据集上显著提升了推荐效果,在线测试中
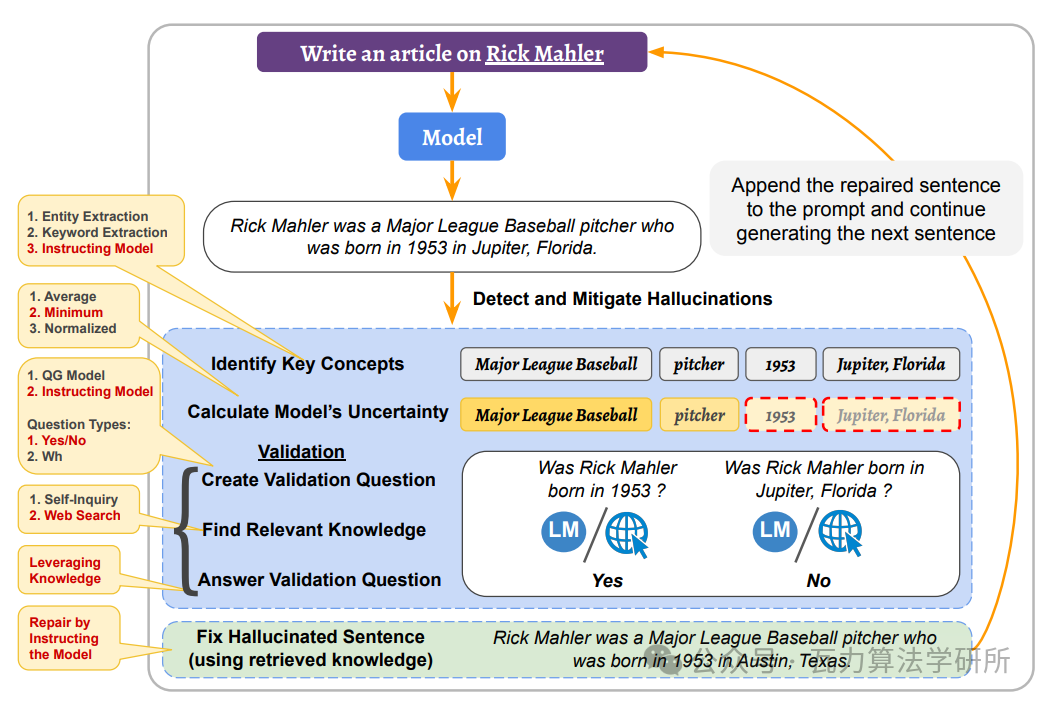
本篇来讲具体的幻觉问题的度量方法与缓解方案,来具体解决某些应用场景下的问题,例如:应用于医疗垂直领域时如何判断大模型生成的内容是否存在幻觉?应用于文档生成领域时如何判断生成内容与参考材料之间是否一致?下面是一个本篇的快捷目录。1. 幻觉问题如何量化2. 如何缓解幻觉问题3. 大模型在哪些问题上最容易出现幻觉4. 幻觉一定有害吗?一、幻觉问题如何量化应用于垂直领域时,由于存在一些领域内比较经典的命名
①Python语言的发展历史②Python语 言应用领域③Python语言的特点Python是一种面向对象的解释型计算机程序设计语言Python是纯粹的自由软件,源代码和解释器CPython遵循GPL (GNU General Public License)协议。Python语法简洁清晰,特色之一是强制用空白符(white space)作为语句缩进(标准四个空格)。自从20世纪90年代初Pytho
近年来,人工智能取得了,改善了我们日常生活的各个方面。然而,它们在辅助疾病诊断,特别是慢性病方面的作用尚未得到充分探索。本研究采用了GPT系列的大型语言模型,并结合深度学习技术,设计并开发了一个,命名为。该系统可以根据用户描述的症状,。1.研究利用GPT-2模型开发了Chat Ella,一个能够根据用户描述的症状,精确预测慢性病的智能系统。通过,该系统能够进行。2.Chat Ella的后端采用,前
数据标注是通过人工或算法为原始数据(如图像、文本、语音、视频等)添加标签或注释的过程,使机器能够识别、学习和推理,从而支撑人工智能模型的训练与优化。早期数据标注以人力为主,主要由学术机构和科研人员小规模自发进行,2007年李飞飞团队启动ImageNet,对图像分类和标注来训练机器学习算法,数据标注从此拉开序幕。2017年,自动驾驶爆发,人力标注无法满足数据需求,半自动化标注兴起,如澳鹏开始自主研发
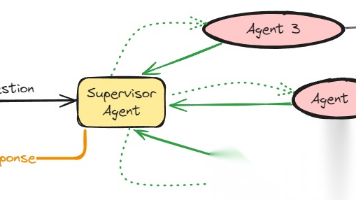
在人工智能应用的开发中,我们常常依赖于强大的大语言模型(LLMs)来构建处理各种任务的AI Agent。然而,当任务变得复杂、多维度、超长上下文或需要多方协作时,单一的Agent往往显得力不从心。这时,多智能体系统(Multi-Agent System, MAS) 的设计范式便展现出其独特的优势。
上周,看了华为的发布会,干货满满,同时也了解到一个新词--**世界模型**,这引起了我的好奇,究竟什么是世界模型呢?今天,就来聊聊~
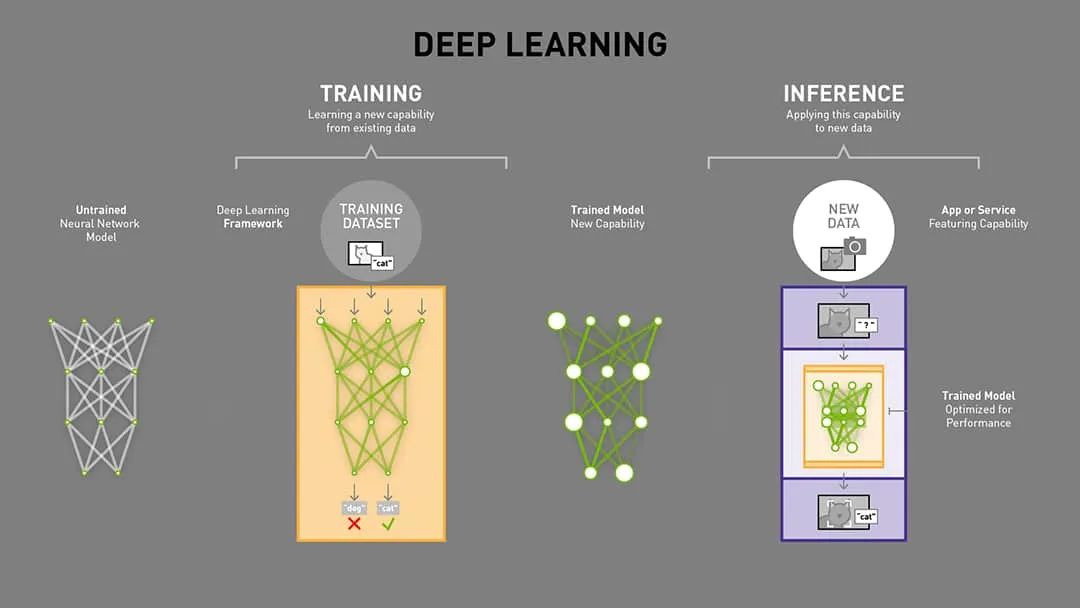
如何评估模型性能?模型评估(Evaluation)是指对训练完成的模型进行性能分析和测试的过程,以确定模型在新数据上的表现如何。分类任务常见的评估指标包括准确率(Accuracy)、精确率(Precision)、召回率(Recall)和F1分数(F1 Score)等。
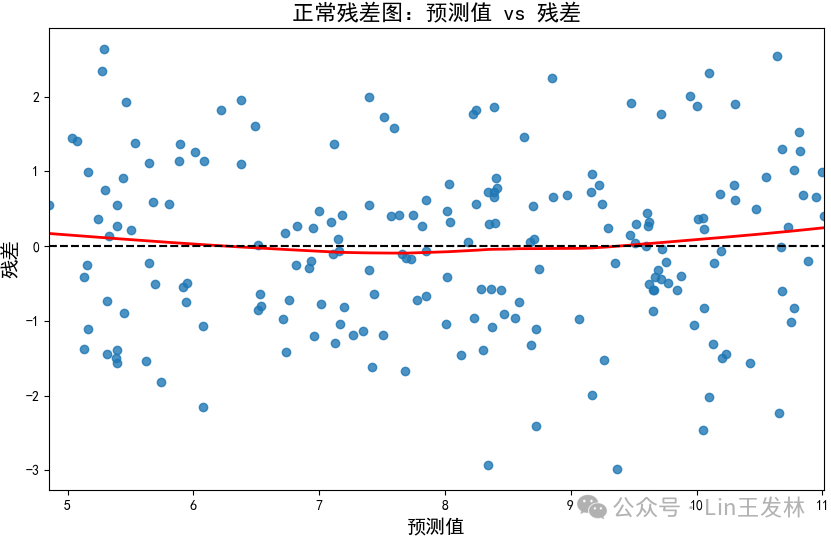
残差分析在数据分析是一种非常重要的工具。通过分析模型的残差(即实际值与预测值之间的差异),我们可以判断模型的性能、发现潜在问题,并进行相应的改进。残差是观测值与模型预测值之间的差异。其中,y_实际是实际观测值,y_预测是预测值,e是残差。残差表示模型未能捕捉的误差部分,它包含了可能由于数据噪声或模型不完善导致的偏差。残差分析的核心作用在于评估和诊断模型的适应性。他帮助我们验证模型假设、检测数据中的
最近和朋友们聊AI,发现好多在听米汤劝后开始用AI辅助进行写文案,这其中就产生了新的问题。有个圈友,整个下午泡了三杯茶,刷了几百个短视频,最后看着屏幕,手握AI却一个字都没写出来。这种情况不是个例,米汤刚开始用AI写文案的时候也是这样。这种感觉就像一个私下能侃侃而谈的人,在公共场合下却大脑一片空白然后哑口无言。写文章,与这个同理。不在合适的场景下,哪怕想破头,灵感就是不来。米汤我发现,很多人都有过
