登录社区云,与社区用户共同成长
邀请您加入社区
在原来的hadoop集群上安装hbase,由于使用的现有的zookeeper,配置文件写错了,就修改了配置文件,停止服务。结果发现有问题了,集群上安装的还有storm的集群,而且使用的也是同一套zookeeper。在hbase服务停止的时候storm的进程虽然也在运行,但是从storm的webUI界面上监控不到几个节点了。而监控机器性能的ganglia也有两个节点也是出现同样的问题,g
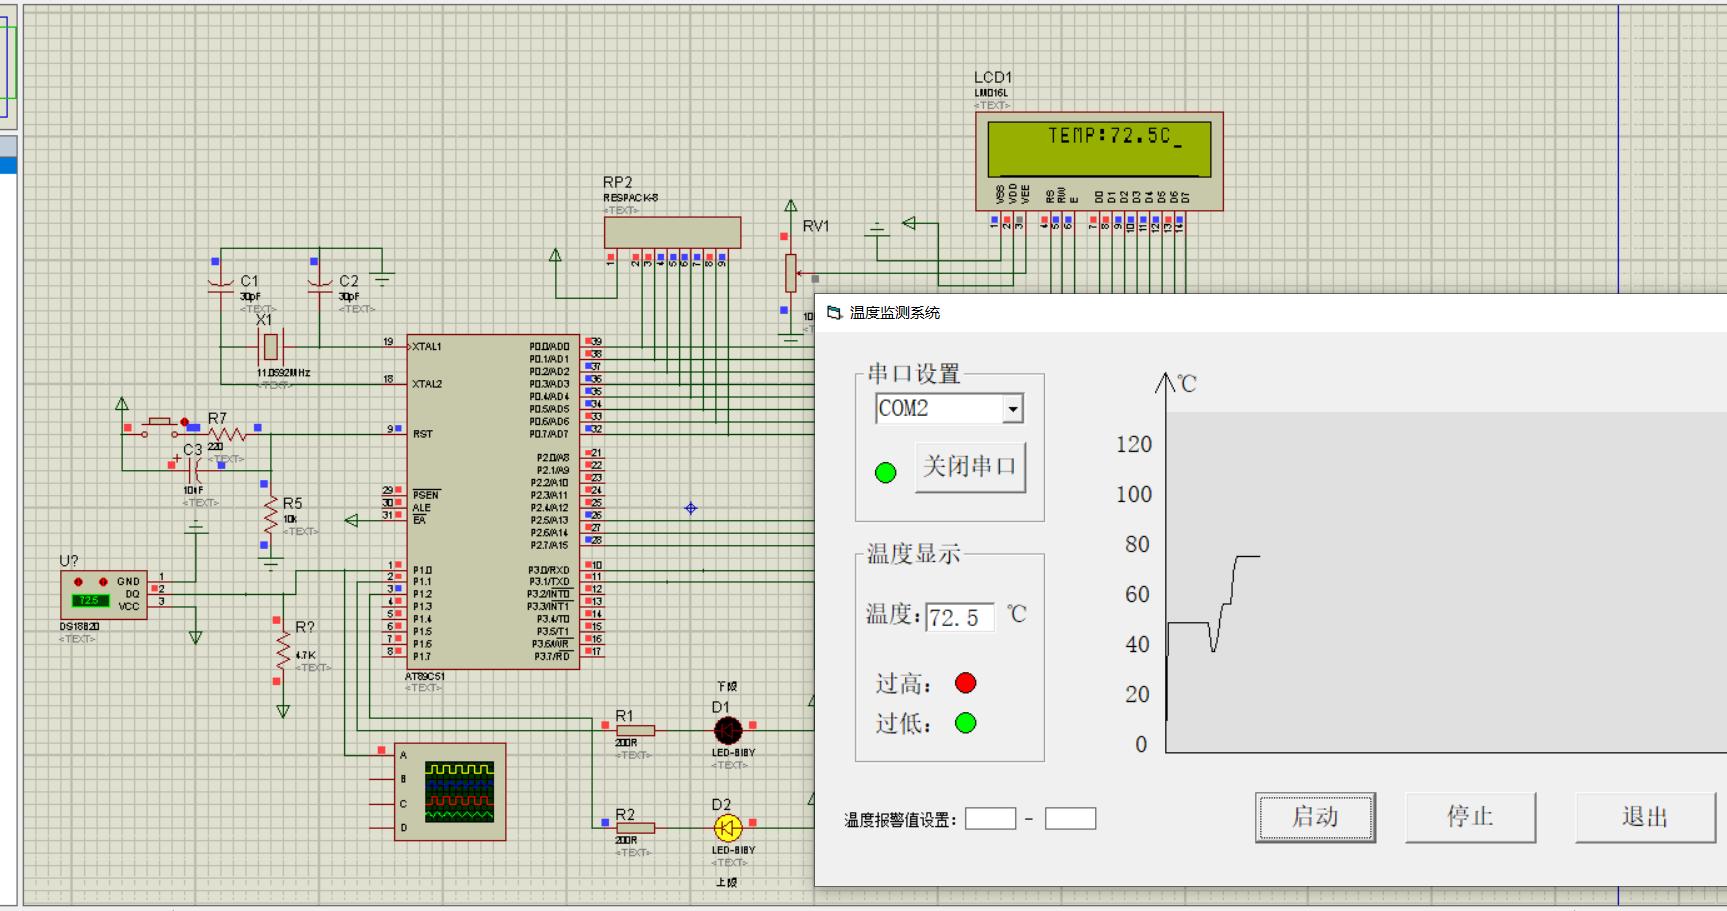
后来在实物调试时发现,传感器离单片机太近会受干扰,用杜邦线隔开20cm后读数才稳定。整个系统跑起来后,用手捏住传感器,看到液晶数字跳动和电脑曲线爬升的瞬间,感觉这周掉的头发值了。这温度监控系统折腾了我整整一个礼拜,从DS18B20的诡异时序到VB上位机曲线卡顿,踩的坑比写的代码都多。传感器使用的是ds18b20,LCD显示温度,还可以串口通信在pc上显示温度,并且有VB的上位机实时显示波形,实物验
以上只是通用的运行库dll处理方式,如果你遇到缺失文件是第三方的软件文件,那么就需要下载到属于这个程序所匹配的版本的文件,然后将这个文件复制到这个程序的安装目录下才能解决问题。如果我们遇到关于文件在系统使用过程中提示缺少找不到的情况,如果文件是属于运行库文件的可以单独下载文件解决,但还是建议安装完整的运行库,可以尝试采用手动下载替换的方法解决问题!文件下载完成后,下方列表会有很多个不同版本的文件,
其中的cd命令是查找相关.git目录,因为工程目录结构不同,.git目录存放位置不同,需要根据实际情况来进行适配。6.修改生成的.husky/pre-commit,开启HUSKY_DEBUG参数,执行lint前切换工作目录。出现husky - Git hooks installed提示代码husky安装成功。4.运行npm install 或者yarn。7.使用提交代码进行husky 钩子生效测试
hive安装
这是启动机器上[root@storm01 data]# zkServer.sh startZooKeeper JMX enabled by defaultUsing config: /export/servers/zookeeper/bin/../conf/zoo.cfgStarting zookeeper ... STARTED[root@storm01 data]# zkServer.s
执行命令zkServer.sh start[root@storm1 conf]# zkServer.sh startZooKeeper JMX enabled by defaultUsing config: /export/servers/zookeeper/bin/../conf/zoo.cfgStarting zookeeper ... STARTED[root@storm
在创建maven项目时,添加了 storm的一些的依赖之后 编译项目 报错了:问题一:错误显示 缺少 jdk.tools:jdk.tools:jar:1.7因为我的java环境是1.7的 编译时 这个jar包没有编译 我右键项目-Properties-Java Build Path -Libraries 发现有红叉 点击后发现这个jar包真的没有添加上:而too
在日常开发中我们经常使用maven,但仓库中有时并未包含我们使用的jar文件,比如oracle的jdbc驱动,这时就需要我们手工安装才能正常进行开发,在此记录下这个简单过程:1、首先要有一个oracle的jdbc驱动jar包2、使用maven命令行安装该jar包,命令如下:3、在pom文件中引入该依赖
Flink介绍——实时计算核心论文之Storm论文总结
本文介绍了 Twitter 对 Storm 的使用情况。Storm 是一个实时、容错的分布式流数据处理系统。目前,Twitter 正大规模实时运用 Storm 来运行各种关键计算任务。本文阐述了 Storm 的架构,以及它实现分布式扩展和容错的方法。同时,本文还说明了查询(即拓扑结构)在 Storm 中是如何执行的,并分享了一些基于 Twitter 运行 Storm 的实际操作案例。我们还给出了实
1.背景介绍HBase与Storm集成:HBase与Storm集成与实时计算1. 背景介绍随着数据的增长和实时性的要求,实时计算技术变得越来越重要。HBase是一个分布式、可扩展、高性能的列式存储系统,可以存储大量数据并提供快速访问。Storm是一个分布式实时计算框架,可以处理大量数据并提供实时计算能力。在大数据场景下,HBase和Storm的集成具有很大的价值。本文将从以下几个方...
产品模型API保证次数容错机制状态管理延时吞吐量成熟度StromNative组合式At-least-onceRecord ACKs无Very LowLowHighTridentmirco-batching组合式
本文是笔者这周闲来无事做的一个小小的尝试。设计的软件比较多,大家可以一一在本机安装一下,我的电脑是mac pro,基本安装起来和Linux基本一致,比较简单基本都是下载 解压包 拷贝到安装目录重命名 然后启动服务需要安装的基本有 JDK1.7,IDEA,kafka,Jstorm,redis都是单机下面直接给出项目的pom.xml配置信息:<project xmlns="http:
在上一篇博客中,我们通过Storm.Net.Adapter创建了一个使用Csharp编写的Storm Topology - wordcount。本文将介绍如何编写Java端的程序以及如何发布到测试的Storm环境中运行。如果你觉得对你有帮助,欢迎Star和Fork,让更多人看到来帮助完善这个项目。
如果《无感染区》游戏中出现“storm.dll没有被指定在Windows上运行”的错误,这通常意味着系统无法找到或无法正确加载该DLL文件。
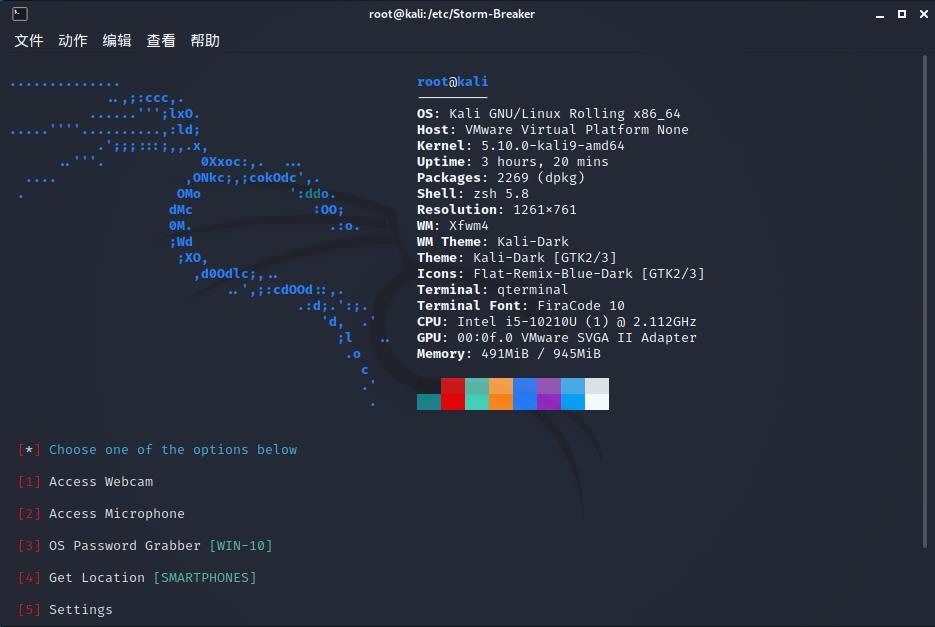
tags:篇首语:本文为大家整理,主要介绍了黑客工具: Storm-Breaker(访问摄像头,麦克风,获取定位)附kali linux下载命令相关的知识,希望对你有一定的参考价值。这是雷神的流星锤吧hhhhh攻击机:kali linux(任意版本,我是的用2021)靶机:手机一部或者电脑(需要梯子,没有也可以,只是打开速度相对慢,因为kali没有带pip,所以要下载一个。pip2,pip3均可,
为大数据中心机房建设提供参考
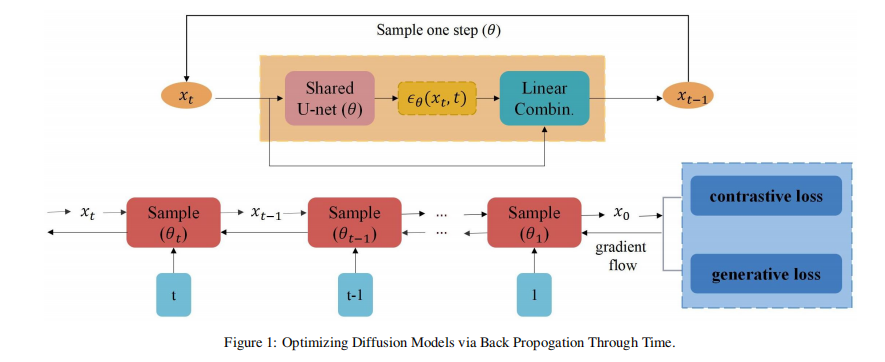
论文 Contrastive Sampling Chains in Diffusion Models 的精炼解读。
知识图谱是RAG系统中的一种重要的技术, 基于知识图谱的大模型应用也成为一个典型的架构模式。但是,在一般的RAG系统中, 都会用到向量数据库,那么,当知识图谱与向量数据库相遇后,会是怎样的场景呢?
比如,你向一个运行中的集群增加了节点。再平衡命令将会停用拓扑,然后在相应超时时间之后重分配worker,并重启拓扑。它会以一种安全的方式销毁一个拓扑,首先停用拓扑,在等待拓扑消息的时间段内允许拓扑完成当前的数据流。我们能够挂起或停用运行中的拓扑。当停用拓扑时,所有已分发的元组都会得到处理,但是。#配置storm UI(为了避免与spark的8080瑞口冲突,改为8089)#配置supervisor
Storm 是一个功能强大的实时大数据处理框架,为解决实时数据处理问题提供了有效的解决方案。通过深入了解和使用 Storm,开发者可以更好地应对实时数据处理的挑战,实现更高效、更准确的数据分析和处理。Storm 在实时大数据处理领域具有重要的地位,随着技术的不断发展,Storm 也在不断更新和完善。1. 实时数据处理需求:在许多应用场景中,需要实时处理和分析数据,传统的批处理方式无法满足实时性要求
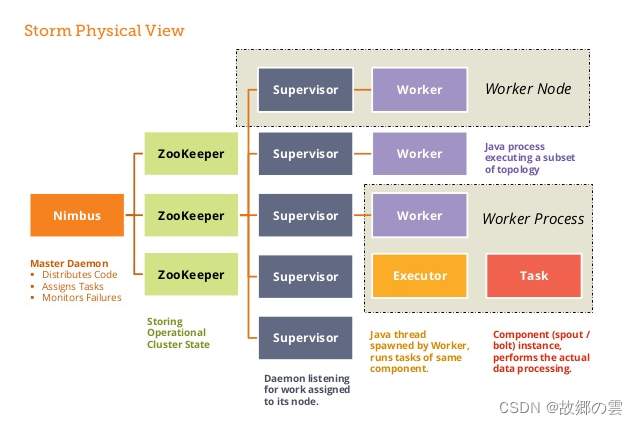
open()接受三个参数:一个包含Storm配置的Map,一个TopologyContext对象,提供了topology中组件的信息,SpoutOutputCollector对象提供发射tuple的方法。相当于storm的master,负责资源分配和任务调度,一个普通的storm集群只有一个nimbus(京东是对nimbus做了集群,加入了选举等概念,防止nimbus突然挂掉)是拓扑结构中的数据来
大数据bigdata Storm实战-股票可视化+阿里云rds,datav组件使用
Apache Storm作为大数据处理的实时计算系统,在大数据技术领域扮演着重要的角色,其意义主要体现在以下几个方面:实时数据处理: Storm专注于实时流数据处理,具有低延迟和高吞吐量的特性。它能够在数据流中进行实时计算和分析,使得用户能够即时获取和处理数据,满足了许多场景下对于实时性的需求,如金融交易监控、实时报警系统等。可伸缩性和高性能: Storm具备良好的横向扩展能力,能够轻松地扩展到大
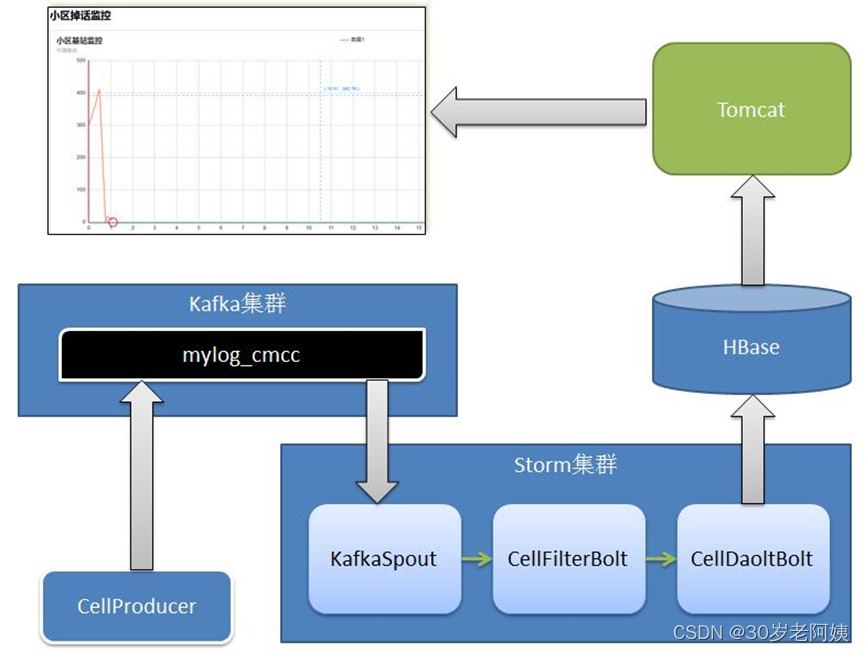
它们在同一个进程中。运行topo.KafkaOneCellMonintorTopology,从Kafka中读取数据,Storm分析之后,结果写入Hbase中存放。在conf/hbase-site.xml中,仅需要指定hbase和zookeeper写数据的本地路径。如:HBASE_ZOOKEEPER_LIST、KAFKA_ZOOKEEPER_LIST、BROKER_LIST、ZOOKEEPERS。如
storm软件包中lib目录下的所有jar包。
实时的分布式高容错。
spout发射元组的时候会给合适的acker发送一个消息表示对哪个spout的元组负责。storm的拓扑中提供了一组acker用于追踪spout发射的每个元组及其衍生的元组,一旦发现DAG处理完了,就同创建该元组的spout进行确认。ack val代表了该元组树的状态,不管spout发射的元组及其衍生的元组有多少,它仅仅是对所有创建的元组以及确认的元组id求。某个元组的id和该64bit的数字异或
一个完整的 Storm 流处理程序被称为 Storm topology(拓扑)。它是一个是由和通过连接起来的有向无环图,Storm 会保持每个提交到集群的 topology 持续地运行,从而处理源源不断的数据流,直到你将其主动杀死 (kill) 为止。 是 Storm 中的核心概念。一个是一个无界的、以分布式方式并行创建和处理的序列。Tuple 可以包含大多数基本类型以及自定义类型的数据。简单来说
storm的nimbus、Supervisor进程启动后自动关闭在安装配置zookeeper、storm之后,通过下述命令先启动zookeeper,后启动Supervisor、nimbus进程:/usr/local/zookeeper/bin/zkServer.sh start/usr/local/storm/bin/storm supervisor/usr/local/storm/bin/sto
本文仅提供一个入门概览,部分内容来源于网络,部分来源于自己理解,参考内容链接会在文末给出,部分内容未找到原作,如有侵权,请联系删除。1、概述许多分布式计算系统都可以实时或者接近实时地处理大数据流。Storm是一个免费并开源的分布式实时计算系统。利用Storm可以很容易做到可靠地处理无限的数据流,像Hadoop批量处理大数据一样,Storm可以实时处理数据。Hadoop 在本质上是一个批处理...
Hadoop、Spark、Storm、Flink是比较常用的分布式计算系统1)仅批处理框架:Hadoop常用于离线的复杂的大数据处理。2)仅流处理框架:Samza与YARN和Kafka紧密集成的流处理,Storm常用于在线的实时的大数据处理。3)混合框架:Spark常用于离线的快速的大数据处理(基于内存),Flink可扩展的批处理和流式数据处理的数据处理平台。关于HadoopH...
框架图:flume:一个分布式、可靠、和高可用的海量日志采集、聚合和传输的系统。支持在日志系统中定制各类数据发送方,用于收集数据;同时,Flume提供对数据进行简单处理,并写到各种数据接受方(比如文本、HDFS、Hbase等)的能力 kafka:一种高吞吐量的分布式发布订阅消息系统,它可以处理消费者规模的网站中的所有动作流数据。这种动作(网页浏览,搜索和其他用户的行动)是在现代网络上的...
一、storm简介---------------------------------------------------------1.开源,分布式,实时计算2.实时可靠的处理无限数据流,可以使用任何语言开发3.适用于实时分析,在线机器学习,分布式PRC,ETL4.每秒可以处理上百万条记录(元组)5.可拓展,容错,并可保证数据至少处理一...
转自:https://blog.csdn.net/wjandy0211/article/details/78802044大数据是收集、整理、处理大容量数据集,并从中获得见解所需的非传统战略和技术的总称。虽然处理数据所需的计算能力或存储容量早已超过一台计算机的上限,但这种计算类型的普遍性、规模,以及价值在最近几年才经历了大规模扩展。本文将介绍大数据系统一个最基本的组件:处理框架。处理框架负责对系统中
1 Lambda架构介绍Lambda架构划分为三层,分别是批处理层,服务层,和加速层。最终实现的效果,可以使用下面的表达式来说明。query = function(alldata)1.1 批处理层批处理层主用由Hadoop来实现,负责数据的存储和产生任意的视图数据。计算视图数据是一个联系操作,因此,当新数据到达时,使用MapReduce迭代地将数据聚集到视图中。 从整个数据集中计算
storm大数据视频教程全集下载:第一阶段:storm集群的搭建(8讲)1、storm简介2、storm部署-13、storm部署-24、storm部署概念5、streamgrouping6、storm组件生命周期7、storm可靠性18、storm可靠性2第二阶段:storm入门到精通(15讲)01.Storm基础知识02.Storm集群安
入门知识推荐书籍1、舍恩伯格的《大数据时代》;2、巴拉巴西的《爆发》;3、涂子沛的《大数据》;4、吴军《智能时代》;5、《大数据架构商业之路:从业务需求到技术方案》工具技能1、hadoop: 常用于离线的复杂的大数据处理2、Spark:常用于离线的快速的大数据处理3、Storm:常用于在线的实时的大数据处理4、HDFS:Hadoop分布式文件系统。HDFS有着高容错性
问题描述:现在需要做一个数据存储,500w左右的数据,日后每天大约产生5w条左右的数据。想把这些数据存储起来,供日后的数据分析用?使用上面说的三种数据库中的哪中比较好?是否有必要建立集群?个人看法是:从长远角度看,由于单台机器的性能瓶颈,后期肯定要做集群,单纯的做复制最终也无法缓解单台master上读的负担。因此,使用mysql的话会使用cluser。但是了解到mysql的clus
本文主题:构建和运行Storm拓扑(Build and Run Storm Topology)一、构建Storm拓扑实现了Spout和Bolt后,就可以构建Storm拓扑了,使用TopologyBuilder构建Topology。TopologyBuilder builder = new TopologyBuilder();之后就可以使用builder对象构建拓扑了,使用setSpou
使用Storm实现实时大数据分析标签: hadoopstorm2012-12-31 10:12 56162人阅读 评论(11) 收藏 举报分类: 大数据处理(11)数据结构与算法(28)版权声明:本文为博主原创文章,未经博主允许不得转载。目录(?)[+]摘要:随着数据体积的越来越大,实时处理成为了许多机构需要面对的首要挑战。Shruthi Kumar和Siddharth
storm
——storm
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 乐奇 Rokid 开放社区

 天工造物局


 DAMO开发者矩阵