- @Gaga246


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
输入是:“机器学习“,输出是“machine learning”。模型的大概工作时序是:Encoder部分,输入序列逐个送进RNN,计算出最后时刻的隐藏状态c,作为上下文信息传给Decoder。Decoder部分,将c和t-1时刻的输出作为t时刻的输入,逐步计算预测得到t时刻的输出。这个结构中,Encoder和Decoder部分都是无法并行化的,这是由RNN结构本身决定的(t时刻计算依赖t-1时刻

“多智能体系统比单智能体性能提升了 90.2%,但智能体系统的 token 消耗是普通聊天的约 15 倍,你会怎么选择?”当智能体达到一定智能阈值,多智能体系统成为性能扩展的关键路径,正如人类文明通过协作实现指数级进步。智能体系统的最后一公里即是核心征程——原型到生产的鸿沟远超预期,因微小错误会引发轨迹级偏差。

当然很多场景会出现 system_server 进程 CPU 占比较高的现象,针对这个进程需要视情况而定,至于 system_server 进程 CPU 占比为何普遍较高,ANR 时,系统进程除了发送信号给其它进程之外,自身也 Dump Trace,并获取系统整体及各进程 CPU 使用情况,且将其它进程 Dump 发送的数据写到文件中。系统整体 CPU 使用率,以及 user,kernel,iow

n8n 是现在很热门的一款自动化工具,支持各种平台对接,还开源,挺香的。不光有官方的线上版本,也支持自己本地部署。那为什么不直接用线上版本呢?我自己试了一下,最主要的原因就是:太贵了。官方提供的云服务,一个月要 20 多美金,对于个人或者刚起步的小团队来说,这个成本完全没必要,自己部署一下就能省下来。还有一个问题,就是全

Dify v1.2.0 正式上线! 这一版本不仅是功能的大幅跃升,更是开发者体验的全新升级。无论是工作流的自动化效率、多语言支持,还是底层架构的稳定性,Dify 团队与全球开源社区共同交出了一份令人惊艳的答卷!
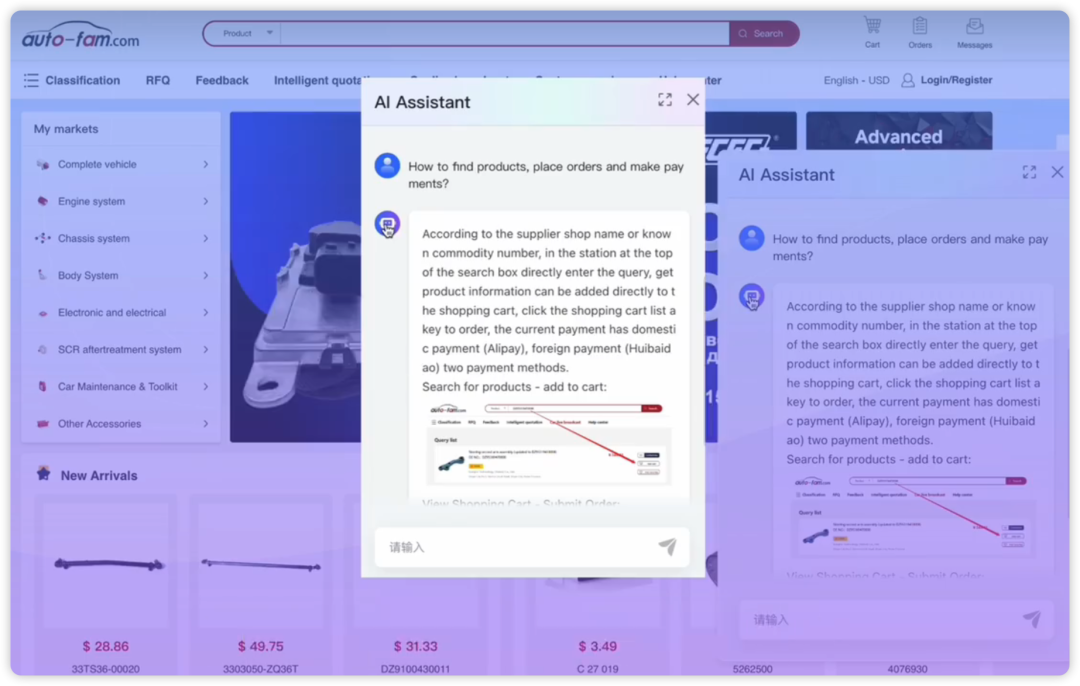
你有没有想过,有一天可以轻松从海量复杂文档中找到藏针的信息 ?如果你正为企业化私有信息提取困难而头痛不已 ?
近期,DeepSeek-R1模型凭借其在数学推理、代码生成和自然语言推理Reasoning等领域的卓越性能,引起广泛关注,从AI界火出圈了。很少有一种技术既能充当幕后扛旗的无名英雄,又能兼具网红明星的气质。而DeepSeek做到了这一点。作为提升生产力的利器,DeepSeek正吸引着众多个人开发者与企业用户的兴趣,他们纷纷寻求在本地环境中部署DeepSeek-R1模型,以充分利用其强大的AI能力。
我们先拆解下这个工作流,这个工作流主要是有开始、条件分支、rookie_rss(第三方插件)、代码执行、变量聚合器、系统时间(第三插件)、llm大语言模型、直接回复等。其中本次工作流用到了一个新的第三方组件,名字叫做rookie_rss。我们首先介绍一下rookie_rss安装使用。
以 deepseek r1 模型为例:访问https://ollama.com/library/deepseek-r1,默认为 7b 模型,如需其他模型,可以在当前页搜索所需模型模型详情页复制安装命令ollama run deepseek-r1安装完成后在终端执行:
DeepSeek,作为一款功能强大的AI工具,在信息检索与处理方面有着独特优势。而飞书多维表格凭借其灵活的数据管理和协作能力,为构建个性化知识库提供了绝佳平台。飞书多维表格自接入了deepseek之后,二者的强强联手,极大提高了工作效率。这个选题是我一直都想做还没开始做的,今天我就为大家带来一个超实用的教程 —— 使用 DeepSeek 结合飞书多维表格,打造属于你的 AI 知识库,让工作和学习效