登录社区云,与社区用户共同成长
邀请您加入社区
MySQL EXPLAIN ANALYZE 是增强版的查询分析工具,相比传统EXPLAIN,它会实际执行查询并提供精确的性能数据。主要功能包括:显示每个操作的实际执行时间、处理行数,对比预估与实际数据差异,识别全表扫描、索引不当等性能瓶颈。使用时需注意它会真实执行查询,因此更适合开发环境优化而非生产环境。典型应用场景包括:查询优化(对比索引策略)、问题诊断(排查慢查询根源)等。通过分析执行计划,可
bcrypt作为一种专为密码存储设计的哈希函数,它结合使用了盐值、工作因子和Blowfish算法,使得其在防御彩虹表攻击和暴力破解方面表现出色。通过独特的哈希机制,bcrypt能够确保密码的安全性,有效防止潜在的安全威胁。
Flink官网:Operations | Apache FlinkFlink和Kafka对应关系访问Maven仓库:https://mvnrepository.com/ 查询flink-connector-kafka 本文flink使用版本为:flink-1.15.4-bin-scala_2.12.tgz 所以对应Kafka版本为: 本文使用版本为:Flink下载地址(全量版本均可下载:Downl
DC, rtl2netlist ,optimization,run time
在win10系统下,使用c#,通过调用后台调用cmd窗口,启动influxdb2.x数据库。
superset、superset用户接入、superset集成、superset二次开发
Nacos1.4.2多数据源适配oracle11g-修改Nacos源码
orcle sql 字段多个值合并一个值
zabbix监控系统进阶专题篇(企业微信报警,邮箱报警,电话报警,监控数据库,监控磁盘性能)
连接池连接池就是存储我们数据库连接对象的容器,系统初始化后,会去申请一些连接对象,用户访问数据库时,会去容器中获取数据库连接对象,使用完毕后会归还给容器。好处:1.提高资源利用率2.提高访问速度DataSourceJava提供的接口,DataSource接口由框架编写者实现方法Connection getConnection()获取连接close()归还连接对象,如果调用的是连接池中的Connec
1.查看参数文件的位置使用show 命令查看,比较常用的show config_file.此还可以查看pg_settings数据字典.test=# show config_file;config_file/data/pgdata/postgresql.conf(1 row)test=# show hba_filetest-# ;hba_file/data/pgdata/pg_hba.conf(1
前言,目前生产环境的mongodb是用docker-compose部署的单机实例,这其实是不太合理的,一般容器是用来跑无状态服务,而且用容器的方式来部署数据库,势必性能会不如硬装或者Sass服务,而且占用的资源比较大,考虑这一点,计划将mongodb迁移至阿里云托管,使用全量+增量的方式迁移。那么在此之前数据库需要开启oplog,否则无法进行增量迁移。1、修改mongodb配置,在docker-c
准备文件:链接:https://pan.baidu.com/s/1xmUCDSJ2TPT17FuzhdMfog提取码:y1qj1. 将 uuid-ossp.so 文件放在 /usr/pgsql-12/lib 目录下2. 将 其他文件放在 /usr/pgsql-12/share/extension 目录下3.重启 postgresql 服务4. 安装 uuid-oss 插件即可create exte
如何将xxx.db.dump文件导入neo4j中所用版本:neo4j-community-3.5.32serve端假定需要迁移的为matn.db.dump(一)关闭neo4jserve端只需把cmd窗口X掉即可(二)新建一个空白数据库新建数据库命名为xxx.db如何新建数据库:新建空白数据库(三)进行数据库迁移在数据迁移前还是要关掉neo4j,然后用管理员身份运行cmd窗口,然后cd到bin目录下
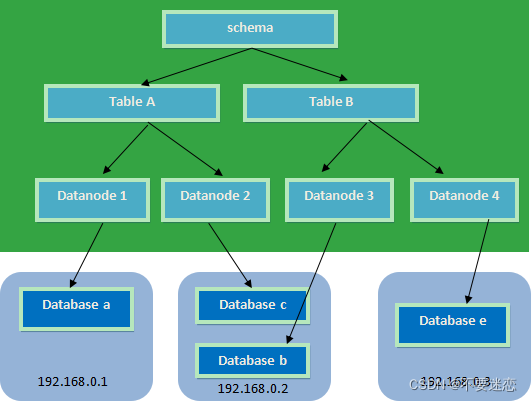
1、Mycat简介1)Mycat是什么?mycat是一个数据库中间件,支持读写分离、分库分表。2)Mycat核心概念MyCAT支持水平分片与垂直分片:水平分片:一个表格的数据分割到多个节点上,按照行分隔。垂直分片:一个数据库中多个表格A,B,C,A存储到节点1上,B存储到节点2上,C存储到节点3 上。MyCAT通过定义表的分片规则来实现分片,每个表格可以捆绑一个分片规则,每个分片规则指定一个分 片
目录👩💻博客主页:大家好我是poizxc2014的博客主页✨欢迎关注🖱点赞🎀收藏⭐留言✒📖个人主页:poizxc2014的博客_CSDN博客-数据库,mysql,java领域博主💻首发时间:🎞2022年05月01日🎠🎨你做三四月的事,八九月就会有答案,一起加油吧🔥💖🔮😘🔏🀄🎧如果觉得博主的文章还不错的话,👍请三连支持一下博主哦🤞如果觉得博主的文章还不错的话,请
connect实际上是oracle数据库中的一种角色,他包含了create session等权限。SYS@PRODCDB>select role,con_id from cdb_roles where role='CONNECT';ROLECON_ID--------------- ----------CONNECT3CONNECT1CONNECT
文章目录表的分类1.1维度建模中表的类型1.2事实表的三种分类1.2.1事务事实表1.2.2周期快照事实表1.2.3累计快照事实表1.2拉链表ETL策略任务调动表的分类1.1维度建模中表的类型(1)事实表:一般是指一个现实存在的业务对象,比如用户、商品、商家、销售员等,根据表的功能不同可以分为事务事实表、周期快照事实表、累计快照事实表;(2)维度表:一般是指对应一些业务状态,代码的解释表。也可以称
DB4AI力图通过将AI计算能力植入到数据库中,帮助使用者们摆脱枯燥繁琐的数据搬运、导出、管理工作。利用数据库存储海量数据听起来是一件合情合理的事情,但面对一个传统型的数据库,作为算法工程师或者AI初学者的用户就不得不将数据集合的数据导出再导入AI计算框架以完成各自的计算任务。细究起来数据搬迁是一件十分麻烦且耗费成本的事情。最直接的方法是将导出数据写入文件。在进行AI计算任务前,程序将文件中的数据
一、关于数据库连接池一个普通的 java 程序,要查询数据库的数据,基本流程是这样的:可以看到,进行一次查询,要进行很多次网络交互,这样的缺点是:网络IO多;响应时间长,导致QPS降低;频繁创建连接和关闭连接,浪费数据库资源,影响服务器性能。什么是数据库连接池?顾名思义,就是一个池子,里面放着数据库连接,应用服务需要的时候就去池子里面拿,用完之后归还给池子。数据库连接池负责分配、管理、释放数据库连
实现原理基于datax同步功能,datax-web增量功能,clickhouse的ReplacingMergeTree分区合并功能实现增量同步(包含单条数据的修改后同步)前置条件datax没有clickhousewriter插件,需要下载插件并反正plugin的writer目录下clickhousewriter插件下载(为了方便下载,已上传至csdn)实现方案1.基于datax_web的增量功能时
文章目录1.一致性哈希算法的问题2.哈希算法的应用场景3.如何分配请求?4.加权轮询算法解决负载均衡问题4.哈希算法带来的问题1.一致性哈希算法的问题问题描述: 例如手机朋友网有n个服务器,为了方便用户的访问会在服务器上缓存数据,因此用户每次访问的时候最好能保持同一台服务器。已有的做法是根据ServerIPIndex[QQNUM%n]得到请求的服务器,这种方法很方便将用户分到不同的服务器上去。但是
1) PLSQL Developer连接oracle 11g初始登录用户名-->sys口令-->Oracle 11g 安装时自己设置的口令(密码)数据库(填写实例)查看实例命令如下SQL*Plus: Release 11.2.0.2.0 Production on 星期六 3月 5 18:38:09 2022Copyright (c) 1982, 2014, Oracle.All ri
在HANA中获得执行计划,可以选择在HANA Studio中通过右键语句选择获得执行计划的方式,但是这样有个问题,就是这个生成的执行计划是一次性的(无法重新访问,只能重新生成)。通过SQL plan cache,只要这个缓存还在,就随时可以重新访问。使用语句如下:SELECT "PLAN_ID"FROM "M_SQL_PLAN_CACHE"WHERE "STATEMENT_STRING" LIKE
1、问题解决早上发现clickhouse表中的数据无了,一番筛查下来,发现是TTL(生命周期)的锅。可能是安装clickhouse的时候不小心的配置的,但是搜索一番全是修改TTL时间的,即何时自动删除表中数据,但是想要是不要自动删除数据。在官方文档中找到了线索:即在想要的表下面运行这个就可了# 停用TTLSYSTEM STOP TTL MERGES# 开启TTLSYSTEM START TTL M
官网下载地址:https://downloads.mysql.com/archives/community/下载压缩包解压到你安装软件的目录。直接点击bin目录下的mysql.exe会闪退是因为MySQL服务没有打开,而打开MySQL服务前需要安装MySQL服务。卸载MySQL Archive包免安装版1.关闭MySQL服务以管理员身份运行cmd,执行以下命令:net stop mysql或右键此
pandas类型转换函数
创建一个数据库:点’create database’comment1:相当于一个项目users:相当于一个表在comment1中新建一个表:comments: 点’create collection’在users中添加数据在users表中点击 ‘Insert Document’2)输入json格式的数据:3)插入数据:点击insert后,如下( _id自动生成,保证数据的唯一性)查询数据:查询ci
clickhosue数据库相关操作
concat_ws(’,’,id,name)未拼接前SELECTcount(*),cast(sum(zdmj) as decimal(20,2)) zdmjsumFROMresa_joinWHERE1 = 1AND xzqmc LIKE'%' ||'钟楼区'|| '%'拼接后SELECTconcat_ws(',',count(*),cast(sum(zdmj) as decimal(20,2)))
例如:字符串 “AAA-BBB” 截取"AAA"“BBB”select substr('AAA-BBB',1,instr('AAA-BBB','-',-1)-1) 值 from dual;select substr('AAA-BBB',instr('AAA-BBB','-',-1)+1) 值 from dual;
shardingsphere对接SQLServer数据类型NVARCHAR留的坑
datax新增了kuduwriter但是很操蛋的是没有示例。但是代码都写好了。我们直接根据源码取写json就行。{"job": {"setting": {"speed": {"channel": 10}},"content": [{"reader": {"name": "oraclereader","parameter": {
postgresql创建索引
未使用函数前数据SELECTt1.CODE,NAME,munit,munitcode,isbd,COALESCE ( t2.type, '' ) AS type,COALESCE ( t2.fid, '' ) AS wybsm,addressFROMprojdata t1LEFT JOIN sv_jianzhu t2 ON t1.CODE = t2.CODEWHERE1 = 1ORDER BYis
-- 查看被锁死的所有表:selectrequest_session_idspid,OBJECT_NAME(resource_associated_entity_id)tableNamefromsys.dm_tran_lockswhereresource_type='OBJECT'--解锁:KILLspid
一、数据库连接池:就是为数据库连接建立一个“缓冲池”。预先在缓冲池中放入一定数量的连接,当需要建立数据库连接时,只需从“缓冲池”中取出一个,使用完毕之后再放回去。说白了就是提高效率。二、作用:负责分配、管理和释放数据库连接,它允许应用程序重复使用一个现有的数据库连接,而不是重新建立一个。三、工作原理:数据库连接池在初始化时将创建一定数量的数据库连接放到连接池中。这些数据库连接的数量是由最小数据库连
1.基本介绍:在缓冲池中有一定数量的连接,需要建立数据库连接时,从缓冲池中取出,用完后放回,不会断掉连接;重复使用现有的数据库连接,而不是重新建立,减少连接次数;超过最大连接数量时,请求被加入等待队列中;2.连接池分类(常用):C3P0(配置文件(c3p0-config.xml)---ComboPooledDtaSource)---稳定但速度不是很快;Druid(德鲁伊)---集合多种优点;3.阿
背景Oracle 安装时往往文件太大,开发环境安装到还可以,生产环境安装就没必要了。之前我总是安装的 instantclient 简版oracle客户端,今天之前写的Excel VBA 宏程序要以OLEDB方式调用Oracle,发现简版客户端不存在OLEDB组件。匆匆找寻了一天终于找到解决方法,那就是安装Oracle ODAC组件即可。ODAC(Oracle Data Access Compone
mongodb安装https://www.mongodb.com/try/download/community下载tar -zxvf 包名解压配置环境变量vi /etc/profileexport PATH=/usr/apk/mongodb/mongodb-linux-x86_64-rhel70-4.2.5/bin:$PATHesc :wqsource /etc/profile增加日志、数据库、c
hbase 单节点配置 hmaser没有启动
oracle 中的 schema 和 tablespace
文章目录摘要一、背景二、技术选型三、流程图四、步骤4.1 引入依赖库4.2配置spring参数4.3数据库初始化sql4.4公共的入口配置类编写4.5测试用例编写4.6 测试效果五 代码链接:六、参考链接:摘要利用h2内存数据库编写Dao层的单元测试用例,代码以pg为例,mysql也是同样适用的。一、背景单元测试时提升代码质量和保证代码正确性的重要保证,而在写DAO层的单元测试时,我们往往会遇到一
mongodb.conf配置文件 - 走看看
1. 池化技术如果没有池的话,我们需要多次的创建和释放对象;如果放在池中可以统一的创建和销毁。池化技术能够减少资源对象的创建次数,提高程序的响应性能,特别是在高并发下这种提高更加明显。使用池化技术缓存的资源对象有如下共同特点:对象创建时间长对象创建需要大量资源对象创建后可被重复使用常见的线程池、内存池、连接池、对象池都具有以上的共同特点。线程池和连接池区别线程池:主动操作,主动执行任务连接池:被动
MySQL高可用-主从同步(实现读写分离)一、简介数据库架构可以分为三大类:主从架构、集群架构和分布式架构。在主从架构类别中,又可以分 7 小类,分别是。传统主从复制,有时候也称为异步复制。基于 GTID 的主从复制,从 MySQL 5.6 版本后,推荐使用这种方式的复制。主主复制级连复制多源复制延迟复制,备份中会用到,尤其是当数据量特别大的情况。半同步复制,对数据一致性要求比较高的业务场景,可以
用dbeaver连接clickhouse时,报错Unexpected driver error occurred while connecting to the database;第一种:大概率是因为clickhouse的配置文件/preprocessed_configs/config.xml文件中的<listen_host>::</listen_host>为注释状态,解开
mongodb创建授权用户名和密码
以下学习笔记参考自Datawhale12月组队学习的推荐系统课程,内容包括MySQL、MongoDB以及Redis的一些基本命令的使用。项目原链接: https://github.com/datawhalechina/fun-recMySQL学习参考:https://github.com/datawhalechina/fun-rec/blob/master/docs/%E7%AC%AC%E4%BA
database
——database
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 乐奇 Rokid 开放社区