


- @tomxjc


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
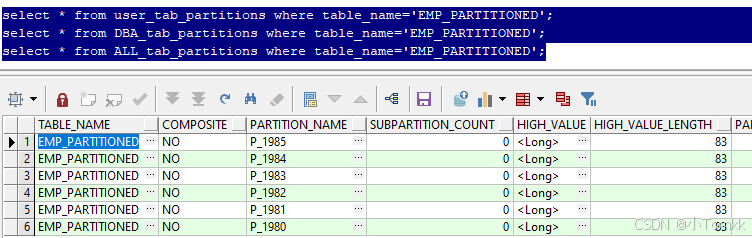
分区表(Partitioned Table)是数据库中一种特殊的表结构,它通过将数据分割成多个分区来提高查询和管理性能。每个分区都包含数据的一个子集,分区表通常用于存储大量数据,通过分区使得操作数据更为高效。分区表的优点包括:提高查询性能:对于大数据量的表,通过查询特定分区的数据而非整个表来提高查询效率。提高管理效率:分区表可以将数据根据某些条件(如时间、范围、列表等)分区,使得数据的备份、恢复和
数据模型是企业数据管理的重要工具,其命名规范需遵循统一标准。ODS、DW、APP等各层表名需带特定前缀(如ODS_、DW_、D_),长度不超过30字符,使用英文单词和下划线分隔。索引、视图、存储过程等数据库对象也需按类型添加前缀(如IDX_、V_、SP_)。命名一律小写,避免保留字和拼音,字段名需保持一致性。数据类型选择上,字符型用char/varchar,数字型用number,日期时间优先用DA
数据整合与连接首先,通过连接 Oracle 11g 数据库 的 SCOTT 用户,获取相关的数据表和视图。这一过程通常涉及配置数据库连接参数,如数据库地址、用户名、密码等,确保能够顺利连接到 Oracle 数据源。然后,在帆软BI工具中设置数据源,确保正确读取和加载数据。数据建模与处理在连接好数据后,使用帆软BI的内置功能进行数据预处理。通过拖拽式的界面进行字段计算、数据合并、过滤和分组,确保数据

这些复杂数据类型在 Hive 中非常有用,特别是在处理大数据和半结构化数据时。它们可以帮助存储更复杂的、嵌套的数据结构,使得数据查询更加灵活和高效。ARRAY:适用于存储同类数据集合。STRUCT:适用于存储多个字段的组合。MAP:适用于存储键值对数据。UNIONTYPE:适用于存储多种类型中的任意一个。

information_schema用于存储数据库元数据,本文sql 主要是 MySQL系统库之information_schema的实现,查询数据库结构:information_schema 可用于查询数据库、表、列、索引、外键、触发器等对象的结构信息。权限管理:可以使用 information_schema 查询用户和权限信息,以确保正确的访问控制和权限设置。性能优化:information_

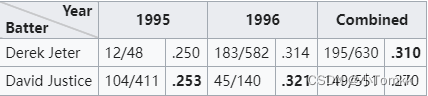
什么是辛普森悖论?来自维基百科是这么说的辛普森悖论(英语:Simpson’s paradox),是概率和统计中的一种现象,其中趋势出现在几组数据中,但当这些组被合并后趋势消失或反转。这个结果在社会科学和医学科学统计中经常遇到, 当频率数据被不恰当地给出因果解释时尤其成问题。当干扰变量和因果关系在统计建模中得到适当处理时,这个悖论就可以得到解决。辛普森悖论已被用来说明统计误用可能产生的误导性结果[
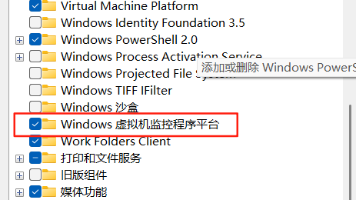
本文介绍了在Windows系统下安装WSL并配置Ubuntu国内镜像源的方法。首先需在控制面板启用WSL和虚拟机平台功能,安装WSL 2内核更新包;然后通过Microsoft Store安装Ubuntu并初始化。为提高软件下载速度,建议将默认源替换为阿里云或清华镜像源,并执行sudo apt update更新。文中还提供了WSL安装失败和软件包问题的解决方案。WSL让用户无需离开Windows即可
配置环境pip 升级在 Trae CN IDE 中配置 Python 3.11 环境,主要包括安装 Python 3.11、安装 Trae CN 及相关依赖、以及在 IDE 中配置 Python 解释器。通过这些步骤,你可以确保在最新的 Python 环境下使用 Trae CN,享受其带来的性能提升和新功能。如果在配置过程中遇到任何问题,可以检查所使用的依赖库是否与 Python 3.11 完全兼

很久没有用Oracle 我记得用的时候还是 2021年 ,那个时候用的 Oralce 11g。今天本人实测安装。今天的学习目标就是教大家怎么安装。直接上图下载后解压缩:点击 setup.exe我在我的电脑D盘上建了一个文件夹。

从大数据领域的资深从业者,到鸿蒙开发的跨界新人,徐俊宸的经历印证了“想没有答案,做才有结果”的初心。鸿蒙生态的完善文档、丰富 Demo 和友好的入门门槛,为跨行业开发者提供了成长的土壤;而亲情的陪伴与支持,则让技术创作有了更温暖的底色。在鸿蒙生态中,像徐俊宸这样的开发者还有很多,他们或许来自不同领域,有着不同的技术背景,但都凭借对技术的热爱和对生活的观察,在鸿蒙的土壤上实现着自己的创作梦想。
