登录社区云,与社区用户共同成长
邀请您加入社区
本文详解JVS-BI如何通过页面挂载与配置化API两大技术路径,实现零代码对接OA/ERP/低代码系统;涵盖iframe嵌入、RESTful服务生成、权限可视化配置等可落地技术方案,面向系统管理员与RPA实施方提供可复用的数据服务集成方法。
无人自助拼豆,是把拼豆手作这件事做成"无人值守 + 自助取用 + 自动结算"的门店形态:用户到店后自己扫码选工位,系统下发开锁/通电指令,用户自助取用色号豆、拼豆板、镊子、熨烫纸等物料,结束时在小程序确认离场,系统按时长或按用量生成订单并完成结算。要把它跑通,核心不是前端页面,而是"设备实际状态"与"订单状态"的一致性、计费口径的抽象、以及分色号耗材的库存盘点。下面按硬件层、后端层、前端层三个方向
没有专职数据团队,中小企业该怎么搭数据中台?本文给出一条 3 个月落地路线:第 1 个月不买软件,先盘清 15–30 个核心指标口径并让决策人签字;第 2 个月只接 3–8 个数据源;第 3 个月建语义层再交到业务手上。含最小编制、成本结构拆解、四个高频踩坑、五个自查验收点,以及零代码方案的能力边界——能替代的是工程师的取数工作,不是工程师这个岗位。
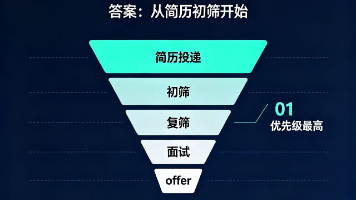
AI筛简历虽火,但真实效果参差。测试显示:大厂社招中AI可识别“关键词堆砌”,但误判排版差却内容扎实者;传统行业转型招聘中,AI漏判率高达35%,难识经验迁移;算法岗则难以分辨“包装话术”与真才实学,反向命中率不足30%。核心结论:AI仅适合作为初筛减负工具。推荐采用“桌面RPA+人工二审”SOP:先定硬指标,再跑AI初筛,最后人工抽检与精筛。全流程可将6小时初筛压缩至1.5小时,效率提升75%。
Zvec × 跨平台:告别多端适配噩梦。🤯一套代码覆盖 Win/Mac/Linux/Android/iOS,6大(Python/Go/Rust/Java/Node/Dart)SDK开箱即用。从服务器到手机,检索性能一致且极致轻量。✅若你在构建跨端 AI Agent,欢迎交流架构心得。🚀💬
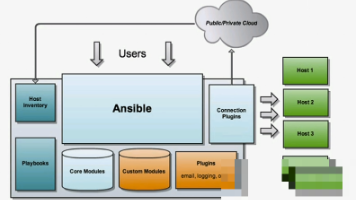
Ansible是一款自动化运维工具,基于Python开发,集合了众多运维工具(puppet、cfengine、chef、func、fabric)的优点,实现了批量系统配置、批量程序部署、批量运行命令等功能。Ansible是基于模块工作的,本身没有批量部署的能力。真正具有批量部署的是Ansible所运行的模块,Ansible只是提供一种框架。主要包括:(1) 连接插件connection plugi
Hive中的。
这个Hive报错表明系统在表中找不到名为的分区。
Apache Hudi 是一个开放数据湖(仓)平台,基于高性能开放表格式构建,旨在为您的数据湖提供数据库功能。Hudi 通过强大的新型增量处理框架重构了传统的低效批数据处理模式,实现分钟级低延迟分析能力。hudi 底层的数据可以存储到hdfs、s3、azure、alluxio、OBS等存储。
举例json_extract_scalar(json extract_scalar(nessage,'$.extInfo').'$platformtimit'--举例如:get_json_object(get_json_object(message,'$.extInfo').'$.platformLimit')--举例:get_json_object(data_json,'$.customer[1
针对电影资源爆炸式增长带来的选择难题,本文设计了一套基于Hive的智能推荐系统。该系统整合Hive数据仓库、Hadoop大数据存储、Spark实时处理及SpringBoot+Vue前后端技术,构建包含数据抓取、处理、分析和可视化四大模块的完整解决方案。通过爬取豆瓣数据并深度挖掘多维度信息,系统实现了高效电影数据管理与个性化推荐,Echarts可视化界面直观呈现分析结果。研究表明,该架构有效优化了电
第一种情况: 在/export/servers/apache-hive-2.3.7-bin/conf/ hive-site.xml文件中注意useSSL大小写问题。第二种情况:export/servers/hadoop/etc/hadoop/下的core-site.xml 和hdfs.site.xml文件中需要修改。Ps:hdfs.site.xml文件中其他地方出现ns1也要修改为master。(
2、now() 或 current_timestamp() 当前时间3、datediff(endDate, startDate) 计算日期相差天数4、months_between(endDate, startDate) 日期相差月数5、date_add(startDate, numDays) 日期加N天6、date_sub(startDate, numDays) 日期减N天7、add_months
在hue执行"truncate table db_name.table_name"时报错,报错内容为"Error while compiling statement: FAILED: SemanticException [Error 10146]: Cannot truncate non-managed table db_name.table_name"外部表:hive只管理元数据,hdfs管理实
hive中的数据粒度级别大致分三类:table、partition、bucket。
MySQL 公钥检索错误,MySQL 8.0 默认启用了公钥检索(public key retrieval)功能,而有时需要在 JDBC 连接 URL 中明确指定允许公钥检索。: 在你的 JDBC 连接 URL 中,添加。
代码:(敲一遍,你会懂的)
用kettle把mysql中的数据导入到hive并处理相关报错
数据服务为所有数据应用提供统一的API接口服务,包括接口规范化定义、数据网关、链路关系的维护、数据交付、多样中间存储和API接口、API测试。数据服务实现了数据中台模型和数据应用的全链路打通,解决了任务异常影响分析和数据下线影响哪些应用的难题:通过基于相同主键的物理模型构建逻辑模型,可以解决数据复用问题,提高接口模型发布效率。数据服务无疑是数据中台不可缺少的重要组成,说是数据中台的标配与灵魂也不为
数据库是一种用于存储、检索和管理大量数据的系统。它允许用户以结构化的方式存储数据,并通过查询语言(如SQL)来检索和操作数据。
数据仓库项目报告学生成绩制作报表
将test 表的 S1 列的读权限授权给role_name (TABLE也可以不写)#回收role_name对数据库db_name的SELECT 权限。#将role_name 权限给予user_group用户组。#回收role_name对表test的SELECT 权限。#查看role_name 在数据库db_name中权限。#将role_name 权限给予user_name用户。#查看role_n
公共表表达式(Common Table Expressions,CTE)可以表示一个临时的结果集(表),该表通过一个简单的查询指定,只要在CTE 语句范围内均可共享该临时表。Hive SELECT 语句用于对表进行查询,即按照规定的语法规则从表中选取数据,并将查询结果保存在结果表中。Hive SELECT 语句支持使用正则表达式指定列名称,凡是符合正则表达式规则的列名将被作为结果集中的一列。> 子
使用beeline连接hive的前提是hive已经部署完毕,Hive单机部署可以看:http://t.csdnimg.cn/54WMQ。
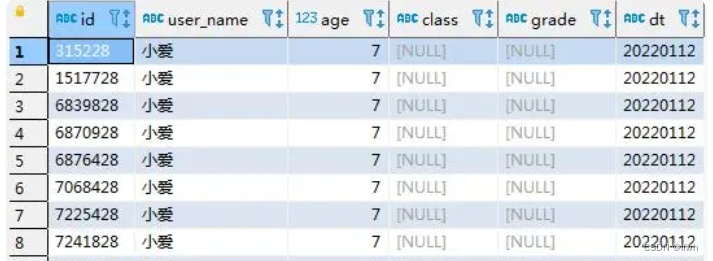
解决hive表新增的字段查询为空null问题
注意:将里面的路径改成自己的,还有在<数据库连接地址配置>中先查看自己数据库的端口号是多少,在<数据库访问密码>中设置自己的密码。添加/tmp和/user/hive/warehouse 并且修改权限。且可发现在Navicat premium的hive数据库中出现了内容。2.path中增加:%HIVE_HOME%\bin。1.hive环境变量配置:(不可以有空格)hive的版本需与hadoop版本相
269页7万字数字政府智慧政务大数据治理平台、大数据资源中心技术解决方案WORD (1).docx。248页10万字企业数字化转型建设方案:企业大数据中心数字化系统平台建设技术方案.docx。数据元、元数据、主数据、主数据管理、元数据管理、资源目录方案PPT.pptx。从十四五看数字化转型(数字化转型、企业数据治理、AI介绍)PPT.pptx。大数据治理、大数据架构、大数据智能平台、大数据决策平台
mapred.invalidinputException:input path does not exists hdfs://表路径/表名/表分区。hive表 insert数据时,报错vertex failed ,vertex name =Map 1...查询不到当前分区 ,说明hive分区表元数据和hdfs文件目录不一致(也可能是分区删除),导致的读异常。这个方式可以解决问题,之后再重新inse
Hive中的explode函数用于将数组类型的列展开成多行数据,每行包含数组中的一个元素。在Hive中,collect_set函数用于将某一列中的元素收集到一个集合中,并去除重复的元素。在Hive中,collect_list函数用于将某一列中的元素收集到一个列表中,保留元素的顺序。通过使用explode函数,我们可以将数组类型的列展开成单独的行,以便更方便地进行进一步的分析、聚合或筛选操作。该函数
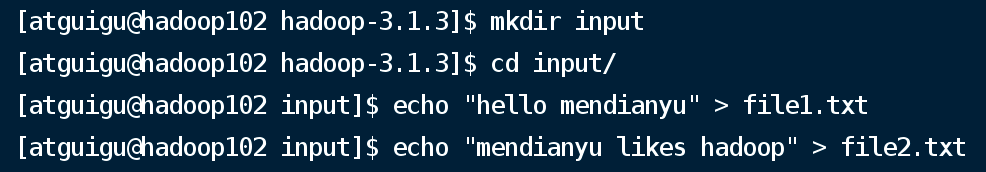
1.首先在hadoop目录下创建一个input文件夹,并在文件夹里建立两个txt文件并写入信息第三行的echo命令会讲引号里的内容写入后边的文件,文件不存在的话会自动创建一个.2.启动hive,创建一个名为docs的表,只含一列,列名为line,类型为string3.将第一步input文件夹中的内容导入表docs引号中的地址为file://加上input文件在所在的地址4....
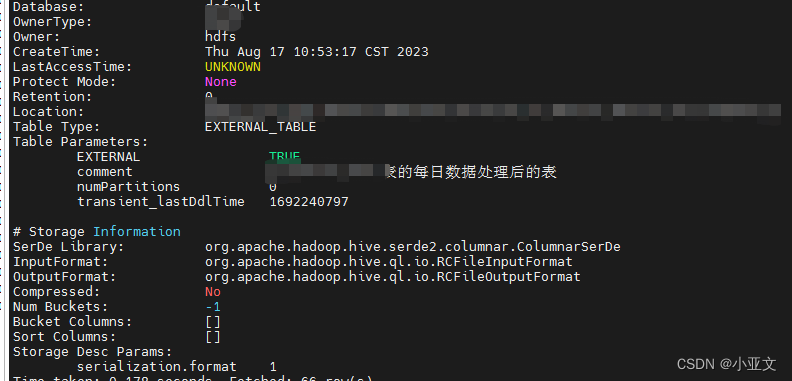
增加之后的注释,会在元数据库(一般在MySQL 中的 hive 库)中的 TABLE_PARAMS 表中显示,该表存储 表/视图 的属性信息。注意:comment一定要是小写的,不能是COMMENT,且必须要加单引号!4.字段名修改添加注释。
数仓 - hive ,身份证和手机号 匹配 - 正则方式。
随着大数据的快速发展,企业不断寻求高效、灵活和经济的方法来处理和管理海量数据。在这种背景下,数据湖和数据仓库这两种不同的架构模式各自展现出其独特的优势。而数据湖仓一体化架构,是对这两种模式优势的综合,为企业提供了一个全新的数据管理方案。
通过 1 和 2 内容我们能看出来,在公司贷款业务中,细节流程各不相同,但是各业务线都有相同的阶段,只是阶段中可能会有不同的操作,如车业务中,在身份核实的阶段,分为验二、验四、活体,而消费金融业务只有活体验证,在授信审核阶段,车业务分为自动审核、人工一审、人工二审,而消费金融只有自动审核,所主题流程一致,但是内部细节不同,故而对数仓建设带来困难。而且DV构建模型易于理解,降低使用学习成本。2.DV
这是一篇工具类的文章,要分析调试hive源码,必须搭建一套hive的运行环境。还记得第一次搭建hive源码调试环境,用了一个月的时间,才完全跑通整个调试过程。中间遇到各种各样莫名奇妙的问题,也有好多次想放弃,幸好坚持了下来。
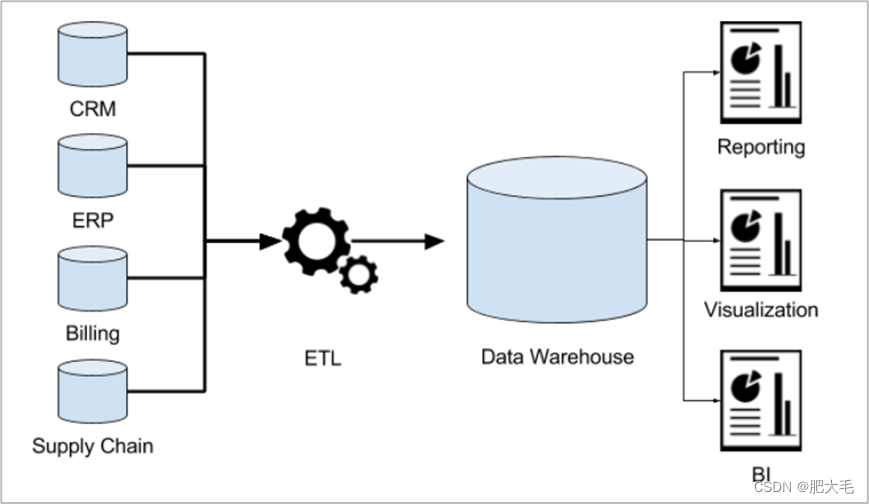
数据仓库
在面试时,或多或少会被问到有关count distinct的优化,现在离线任务用到的基本就是hivesql和sparksql,那sparksql中有关count distinct做了哪些优化呢?
博时基金数据开发面经
hive启动日志关闭解决方法
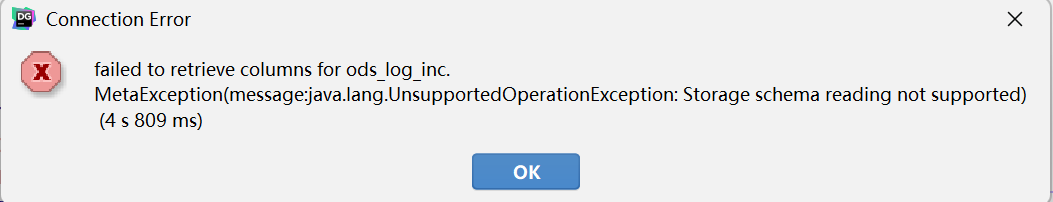
failed to retrieve columns for ods_order_detail_coupon_inc.MetaException(message:java.lang.UnsupportedOperationException: Storage schema reading not supported)and 13 duplicate reports (14 s 26 ms)
数据湖是什么
可用于优化join or关联匹配情况
AllData可定义数据中台集成开源项目GoNavi构建模数共建数据源模块,以GoNavi作为多源数据交互枢纽,一站式完成数据源接入、库表元数据管理、表结构差异比对、数据校验、异构数据同步等数据集成运维工作。
hive开窗函数
Hive引擎包括:默认MR、tez、sparkHive on Spark:Hive既作为存储元数据又负责SQL的解析优化,语法是HQL语法,执行引擎变成了Spark,Spark负责采用RDD执行。Spark on Hive : Hive只作为存储元数据,Spark负责SQL解析优化,语法是Spark SQL语法,Spark负责采用RDD执行。...
如何解决:Code: 210. DB::NetException: Connection refused (localhost:9000)
DataGrip数据仓库工具
通过增加开始时间字段和结束时间字段,来控制数据生命周期的表。
这34个表以订单表、用户表、SKU商品表、活动表和优惠券表为中心,延伸出了优惠券领用表、支付流水表、活动订单表、订单详情表、订单状态表、商品评论表、编码字典表退单表、SPU商品表等,用户表提供用户的详细信息,支付流水表提供该订单的支付详情,订单详情表提供订单的商品数量等情况,商品表给订单详情表提供商品的详细信息。我们希望的是根据日志里面的实际时间,发往HDFS的路径,所以下面拦截器作用是获取日志中
表结构建表INSERT into t4 values('2014', 'A', 3),('2014' ,'B' ,1 ),('2014' ,'C' ,2 ),('2015' ,'A' ,4),('2015', 'D' ,3);SELECT * FROM t4;1)按a分组按照b字段排序,求c的前一行后后一行的和思路LAG(col,n,DEFAULT) 用于统计窗口内往上第n行值 第一个参数为列名,
——数据仓库
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 EazyDevelop社区
 亚马逊云科技技术品牌专区

 2048 AI社区

 乐奇 Rokid 开放社区