登录社区云,与社区用户共同成长
邀请您加入社区
报错信息:Diagnostic Messages for this Task:Container launch failed for container_1644976539445_0002_01_000005 : org.apache.hadoop.yarn.exceptions.InvalidAuxServiceException: The auxService:mapreduce_shuff
一. 集群规划ip主机名安装进程192.168.204.14hdp14namenode,ZKFC,resourcemanager192.168.204.15hdp15namenode,ZKFC,resourcemanager192.168.204.16hdp16natanode,nodemanager,zookeeper,Journalnode192.168.204.17hdp17natanode
1.rows between的作用在使用hsql完成一些业务需求的时候,我们经常会用到窗口函数,某些场景下会涉及到需要控制窗口函数的范围来满足业务需求,这个时候就需要用到rowsbetween了,使用rows between可以根据自己的需求任意的控制窗口函数的范围。2.rows between的使用首先我们有一张如下的数据表sidday_timesale_volume1012020-01-031
1, 新开虚拟机,安装操作系统。Centos6.5(或者用绿色版,解压到文件件,打开即可)2, 改一下时间,时区对就行。3, 查看基础状态(ifconfig查看ip地址,(随机分配的)。 Hostname(主机名)。 Service iptables status(防火墙状态))。4, 配置网络(host-only仅主机与虚拟机交互。)注意:仅主机模式,网卡VMnet1,
hive mapreduce reducer 调优
使用了两天的时间,终于将这个hadoop的集群配置弄好了。参考了很多的网页,受益非浅。SSH无密码登陆配置首先谈一谈ssh的无密码登陆问题。按照网上的说法,比如说A想无秘密登陆B。那么在A上使用ssh-keygen命令产生密钥id_rsa,和id_rsa.pub。然后将id_rsa.pub拷贝到B的相应的用户的主目录下面就可以了。cat 到 authoriz
本次的分享就到这里,根据自己编写的过程来分享经验,希望能对你有所帮助。
hive的引擎mapreduce、tez和spark三者比较
尚硅谷hadoop3.x “P1-P38入门部分”
1.MapReduce的整个的执行流程1.mapread:InputFormat读取待处理文本,然后进入到mapper中map:用户自定义的mapper方法collect:mapper方法输出到环形缓冲区,在进去缓冲区之前,先进行了分区,默认是hash分区,一般用户自定义分区,写到80%的时候,开启反向溢写,相当于又开了一个线程,原先的线程继续往缓冲区读,新的线程将缓冲区数据写到磁盘溢写:在写入磁
Step1Driverimport org.apache.hadoop.conf.Configuration;import org.apache.hadoop.fs.Path;import org.apache.hadoop.io.IntWritable;import org.apache.hadoop.io.Text;import org.apache.hadoop.mapreduce.Job;
目录解决 where 字段 >(select 字段 from 表名)的情况解决 where 字段 =(select 字段 from 表名)的情况解决 where 字段 =(select avg(字段) from 表名 group by 字段)的情况解决 where 字段 >(select 字段 from 表名)的情况拿网上的题目来举例子(想把题目出处贴出来的,发现网上各种网站都有这个题
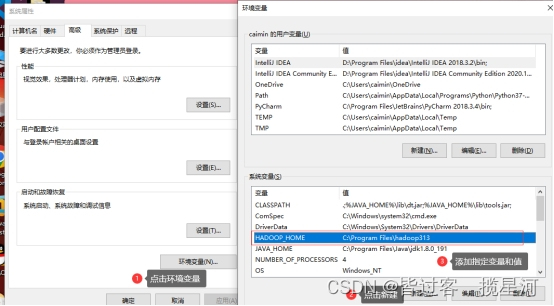
1 关闭防火墙1.1关闭防火墙systemctl stop firewalld.service1.2 禁止firewall开机启动systemctl disable firewalld.service1.3 查看防火墙状态systemctl status firewalld2 jdk和hadoop环境变量配置2.1 上传包使用相应的工具将Hadoop和jdk压缩包上传至虚拟机2.2 将包移动到相应
第3章 MapReduce框架原理目录第3章 MapReduce框架原理3.1 InputFormat数据输入3.1.1 切片与MapTask并行度决定机制3.1.2 Job提交流程源码和切片源码详解3.1.3 FileInputFormat切片机制3.1.4 CombineTextInputFormat切片机制3.1.5 CombineTextInputFormat案例实操3.1.6 FileI
这个是windows本地IDEA里调试一个简单的mapreduce然后报错,这个问题很奇怪,相同的代码,我换了台电脑又可以运行。首先具体报错是这样的:Exception in thread "main" java.lang.UnsatisfiedLinkError: org.apache.hadoop.io.nativeio.NativeIO$POSIX.stat(Ljava/lang/Strin
(一)MapReuduce入门之环境搭建1,定义:mapReduce是一种分布式计算框架,Mapreduce 核心功能是将用户编写的业务逻辑代码和自带默认组件整合成一个完整的分布式运算程序,并发运行在一个 hadoop 集群上。2,特点:mapReduce易于编程、扩展性好、适合处理PB级别数据;但是他不适合处理实时数据,流失计算、有向图计算等。3,mapreduce程序编写规则:1)Mapper
在hadoop 环境下运行MapReduce 下wordCount出现以下错误:2020-08-10 21:32:29,193 INFO mapreduce.Job: Job job_1597060619065_0003 running in uber mode : false2020-08-10 21:32:29,195 INFO mapreduce.Job:map 0% reduce 0%20
关于:::**Exception in thread “main” java.lang.UnsatisfiedLinkError: org.apache.hadoop.io.nativeio.NativeIO$Windows.access0(Ljava/lang/String;I)Z 报错问题的解决方案如出现跟上图一样的报错信息,应修改Hadoop的NativeIO.java源码C:\U...
运行环境是:linux-manjaro、hadoop-2.7.1、jdk8在本地完成小规模测试,就可以把作业部署到集群上了。说明下map和reduce。mapreduce任务过程分为两个处理阶段:map阶段和reduce阶段。每个阶段都以键值作为输入和输出,其类型由程序员选择。程序员还需要写map函数和reduce函数我们使用的数据如下:1110067011990999991950051...
一、背景电子商务网站是个性化推荐系统重要地应用的领域之一,亚马逊就是个性化推荐系统的积极应用者和推广者,亚马逊的推荐系统深入到网站的各类商品,为亚马逊带来了至少30%的销售额。二、ItemCF简介基于item的协同过滤,通过用户对不同item的评分来评测item之间的相似性,基于item之间的相似性做出推荐。简单来讲就是:给用户推荐和他之前喜欢的物品相似的物品。如下说明:注:基于物品的协同过滤算法
如图,hive提交查询的时候,在这步卡主不动假死,也不报错,log也查不出来。查了各种办法也没解决。最后反思1.不借助hive进行分析时候,仅仅是提交job跑mr没有问题2.到hive上却假死怀疑是Hive没有连接上mapreduce。一检查hive-env.sh果然是这样。配置hive-env.shHADOOP_HOME=/apps/hadoopexport HIVE_CONF_
分析MapReduce执行过程 MapReduce运行的时候,会通过Mapper运行的任务读取HDFS中的数据文件,然后调用自己的方法,处理数据,最后输出。Reducer任务会接收Mapper任务输出的数据,作为自己的输入数据,调用自己的方法,最后输出到HDFS的文件中。整个流程如图:Mapper任务的执行过程详解每个Mapper任务是一个java进程,它会读取HDFS中
最近有个需求,要将相同id的记录存储为hbase的一行,于是就将id做md5后作为rowkey,相同id记录数据以json存储在列中,开始想用一个mapper和一个reducer搞定的,mapper负责将数据组织好(以id的md5值做key,整行数据组织成json串做value输出),reducer负责将相同key的value拼接起来,并write到HFile中。方法一:m
通过mapred.max.split.size等参数控制hive中的map个数进行资源控制
最近一个群友的boss让研究hbase,让hbase的入库速度达到5w+/s,这可愁死了,4台个人电脑组成的集群,多线程入库调了好久,速度也才1w左右,都没有达到理想的那种速度,然后就想到了这种方式,但是网上多是用mapreduce来实现入库,而现在的需求是实时入库,不生成文件了,所以就只能自己用代码实现了,但是网上查了很多资料都没有查到,最后在一个网友的指引下,看了源码,最后找到了生成Hfile
使用hadoop实现IP归属地的统计,为分析用户的地区分布提供数据
精品IT课件:MapReduce海量数据并行处理MapReduce致力于解决大规模数据处理的问题,是以数据为中心的编程架构,相比与分布式计算和并行计算等,更看重的是吞吐率。MapReduce处理的数据是PB级的数据,它并不是新技术,而是一个总结。本文集是南京大学黄宜华的课件,很好的资料,整理下来供大家下载学习。详细解读 和小伙伴们一起来吐槽
最近在做hive0.9升级到0.11的工作,其中一个步骤就是将之前apply到0.9的patch re-apply到0.11中,有一个patch参考了hive metastore service的实现,对hive server增加了sasl kerberos认证,支持impersonate成client ugi的身份来启动作业(默认方式会以起hive service daemon的用户身份来执行,
启动第二台,先投自己一票,然后第一台开始投票,比较两者之间谁的myid大,谁的大,就投给谁,zk02再得一票,第二台两票,超过了半数,领导出现了zk02.启动第一台,第一台开始选举,自己投自己一票,因为超过半数才有效,所以zk01不是领导,此时的状态是选举中。zxid代表的是事务的次数如果这个值很大,就表示这个机器上的数据比较的新。如果zxid 也相等,就看每台电脑上的myid了,如果myid谁大
一般在开发中,若是等到环境搭配好了再进行测试或者统计数据,数据处理等操作,那会很耽误时间,所以一般都是2头跑,1波人去在客户机上搭建环境,1波人通过在idea上搭建虚拟hadoop环境,然后再虚拟环境下编写测试功能代码。步骤4:添加windows系统的依赖文件,在hadoop安装路径下添加winutils.exe,winutils.pdb和hadoop.dll共3个文件。7)要提前在d:/tes
报错原因是配置的用户名与写的用户名不正确,输入与配置文件一样的。在hive中执行命令。连接beeline客户端。Hadoop的core-site.xml文件。
hadoop集群上安装tez,运行tez后报错。
在windows客户端运行hadoop程序遇到问题:DEBUG - LocalFetcher 1 going to fetch: attempt_local938878567_0001_m_000000_0WARN - job_local938878567_0001java.lang.Exception: org.apache.hadoop.mapreduce.task.reduce.Shuffl
对比项MapReduce管道聚合查询速度非常慢 不适合实时查询比较快适合实时查询语法js查询语法分批执行特点适合大规模数据占用的内存超过20%自动报错简单示例1:MapReduce>db.collection.mapReduce(function() {emit(key,value);},//map 函数f...
前提:这个例子是mapreduce的基本流程,需要已经搭建好的hadoop环境,至于hadoop,hdfs,mr的关系呢,看书吧。大概流程是这样的,hadoop环境搭建好以后,自己创建两个文件,通过hadoop命令将文件扔到hdfs里面。通过写代码通常java书写mapreduce程序,就可以对hdfs里面的文件进行相关操作,比如统计。下面的步骤主要是idea打包mr程序。1 idea创建ma..
通过mapReduce实现基于项目的协同过滤推荐需求介绍协同过滤推荐网上有很多种介绍,我这里主要介绍的是基于项目的协同过滤。基于项目的协同过滤推荐基于这样的假设:一个用户会喜欢他之前喜欢的项目相似的项目。因此,基于项目的协同过滤推荐关键在于计算物品之间的相似度。数据介绍我选用的数据集合如下:1,101,5.01,102,3.01,103,2.52,101,2.02,1
一、查看需求安装java 1.6及hadoop 0.20.x二、安装hivetar -xf hive-x.y.z.tar.gz(本次安装为hive-0.8.1.tar.gz)将解压后的hive-0.8.1文件放在系统的/home/hadooptest/中。在/etc/profile中添加:export HIVE_HOME=/home/hadooptest
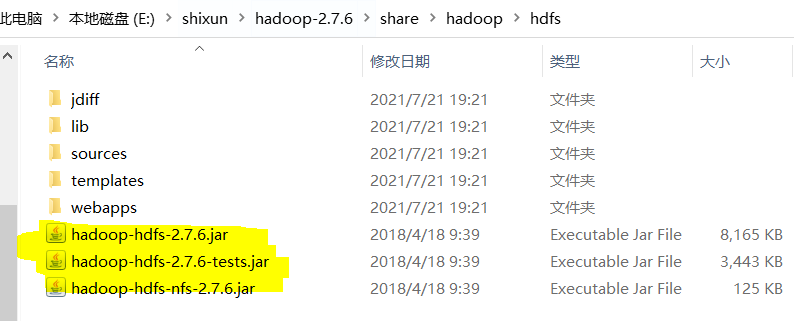
的按钮,找到maven的安装目录。还有hadoop-2.7.6\share\hadoop\hdfs\lib中的全部jar包。接着同样的,单点一下lib上方的Resources(黄色荧光笔标记)接着单点一下黄色荧光笔标记的lib文件,注意是鼠标单点一下。就是之前设置maven时候,这里的黄色荧光笔标记的位置。点击第一个,刷新,这里会自动更新下载jar包。同样的,右下角是先apply,然后ok。来到新
leader宕机后启动: 每一个leader当老大的时候,都会产生新纪元epoch,且每次操作完节点数据都会更新事务id(高32位_低32位) ,当leader宕机后,剩下的follower就会综合考虑几个因素选出最新的leader,先比较最后一次更新数据事务id(高32位_低32位),谁的事务id最大,谁就当选leader,如果更新数据的事务id都相同的情况下,就需要再次考虑myid,谁的myi
Hive 的执行引擎包括以下几种:Hive 最早使用的执行引擎是基于 Hadoop MapReduce 的。它将 Hive 查询转化为一系列的 MapReduce 任务进行并行执行。MapReduce 引擎适用于处理大规模数据集,具有良好的容错性和扩展性,但由于磁盘读写和中间结果的持久化,可能在性能和响应时间方面受到影响。Hive 可以使用 Apache Tez 作为执行引擎来加速查询处理。
如果提示存在 就把/bin/java 删除 删掉之后在重新执行上边那部。就可以解决 Exit code: 127 问题。这个报错 是因为找不到你/bin/java。解决方法:创建软链到/bin/java。
在Hadoop相关开发中,因很多时候大数据集群的版本比较低,例如CDH6.3.1所集成的是hadoop2.7.6版本,所以需要客户端开发时,也要做版本适配,需引入hadoop-common-2.7.6.jar,hadoop-hdfs.2.7.6.jar等jar包依赖。添加htrace-core-3.1.0-incubating.jar到项目中。添加commons-cli-1.5.jar到项目中。添
本篇文章主要分享,编写简单的hbase与mapreduce集合的案例,即从hdfs中读取数据导入到hbase表里,读取hbase表中的指定数据,导入到另外一张表中。
看了下这个空指针MRClientService.getHttpPort(MRClientService.java:177)在yarn-site.xml中配置了yarn.resourcemanager.webapp.address之后就正常了。看网上说是yarn.resourcemanager.webapp.address没配置导致没能获取到port。xxx1主机名的值从yarn.resourcem
要开启 Hadoop,你需要进入 Hadoop 的安装目录,然后输入以下命令:sbin/start-dfs.shsbin/start-yarn.sh这会启动 Hadoop 的两个核心组件:Hadoop Distributed File System (HDFS) 和 Yet Another Resource Negotiator (YARN)。你也可以使用以下命令来启动所有 Hadoop ...
查看执行的hive job提交了什么语句
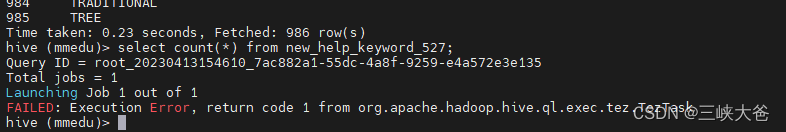
Error while processing statement: FAILED: Execution Error, return code 2 from org.apache.hadoop.hive.ql.exec.mr.MapRedTask
学习笔记
mapreduce
——mapreduce
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 乐奇 Rokid 开放社区




 天工造物局