登录社区云,与社区用户共同成长
邀请您加入社区
【代码】数据分析agent(十):loguru日志输出优化 和es 启动流程。
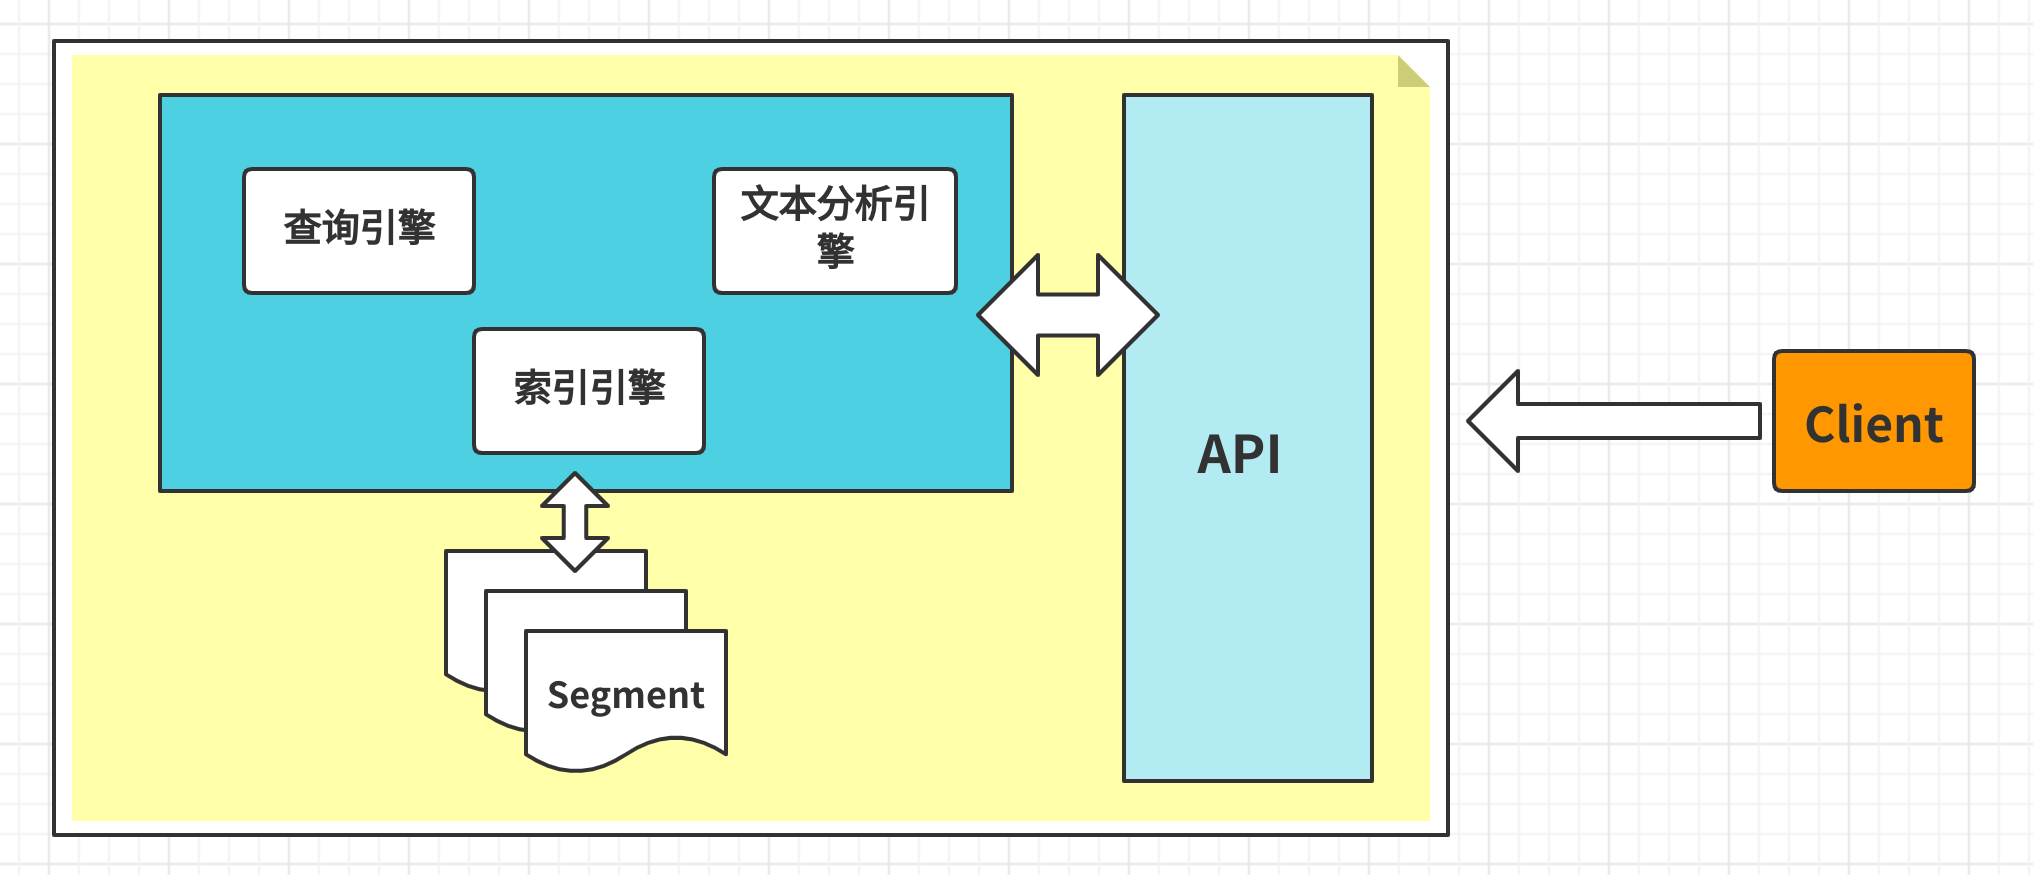
Elasticsearch 是一个基于 Apache Lucene 的开源分布式搜索和分析引擎。它能够提供实时的全文搜索、分布式数据存储和分析功能。全文搜索:可以对大量文本数据进行快速的全文搜索。分布式架构:可以水平扩展,支持大规模数据存储和查询。实时性:支持近实时数据的搜索和分析,查询结果非常迅速。高可扩展性:无论数据量如何增长,Elasticsearch 都能保持高效的查询性能。
<think>我们只需要做一个不超过150字的摘要。需要概括Meilisearch的项目简介、功能、技术架构、安装、对比、应用场景和总结。注意控制字数,用简洁的语句。</think>Meilisearch是一款Rust编写的开源轻量级搜索引擎,以毫秒级响应、错字容忍、中文搜索等开箱即用功能著称,支持多语言SDK与灵活API。其部署简单,适合中小规模站内检索、知识库等场景。相
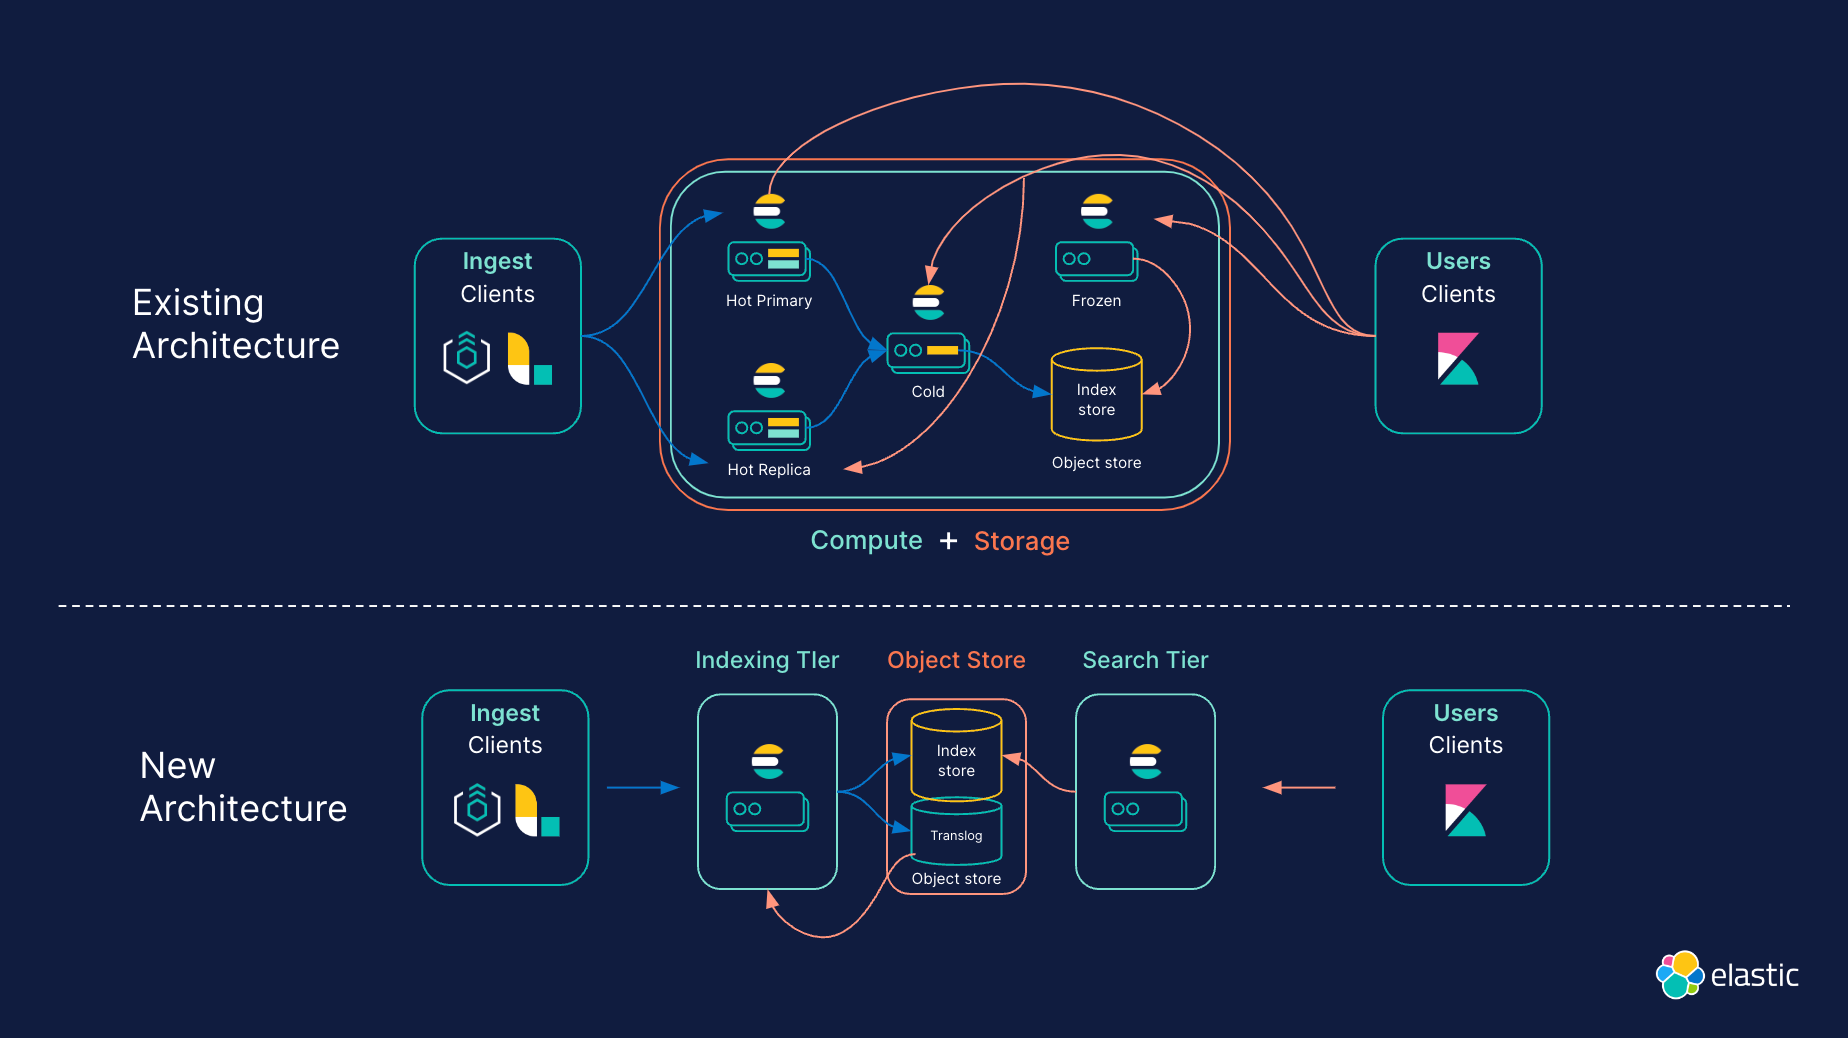
ElasticSearch 推出了全新的serverless架构,将查询(search)和写入(indexing)分离,将计算(computing)和存储(storage)分离,极大提高了 ES 的可运维性,降低了学习成本。本文将先介绍下serverless含义,再介绍ElasticSearch serverless架构。
是需要备份的索引名称。
文章目录1.Elasticsearch1.1 Elasticsearch介绍1.2 Elasticsearch的安装与配置1.安装软件并修改配置文件2.修改系统限制3.修改systemd启动文件4.elasticsearch插件安装5.更换npm的yum源(要求虚拟机可上网)6.修改es主机ip和端口7.启动head插件8.修改ES跨域主持9.创建索引1.3 配置Elasticsearch集群1.
原有的方法在2.0版本中已经删除了。参见点击打开链接。但是2.0版本提供了delete by query插件来实现这个功能。这个插件的使用过程大致如下:1.安装。打开命令行,切到Elasticsearch文件夹中,运行如下命令:sudo bin/plugin install delete-by-query成功安装的结果如下:集群环境下必须在每个结点上安装,安装之后要重启结点才能
周五晚上十点,我要给“周末预约站”做演示前的日志检查:用中文描述需求,让工具写出慢请求统计脚本,再根据报错修正。下面采用第一人称教学情境,事故与代码迭代均为示例,不冒充真实客户经历或多工具实测。我会先把 TRAE 放进候选清单:据其国际版官方定价页,。对学生党而言,先跑通一个小任务,比立即购买高档订阅更重要。
如果你是新手或轻量开发者,优先选 TRAE。IDE 入口更熟悉,适合从中文需求、页面生成和小功能开始。如果你是有经验但偏 IDE 的开发者,优先用 TRAE 处理日常开发,同时挑选复杂任务与 Claude Code 做同题验证。如果你是中文场景重用户,优先考虑 TRAE。重点验证需求理解、项目规则遵循和多轮修改效率。如果你是深度 CLI 用户,优先保留 Claude Code。现有终端习惯、脚本和
如果你是新手或轻量开发者,优先选 TRAE。IDE 内操作更容易理解,也更适合从中文需求开始开发。如果你是中文场景重用户,优先试 TRAE。重点验证需求理解、常用技术栈和多轮修改是否符合预期。如果你是有经验的 IDE 型开发者,可在 TRAE 与 Cursor 之间实测。使用同一任务比较代码质量、规则遵循、成本和交互效率。如果你是有经验的 CLI 开发者,优先保留 Claude Code。若主要问
如果你是新手或轻量开发者,优先选 TRAE。它更适合从中文需求出发,在 IDE 中查看并确认每一步改动。如果你是有经验但偏 IDE 的开发者,可以把 TRAE 作为主力工具,同时保留终端和人工审查能力。如果你是中文场景重用户,优先试用 TRAE,并用真实需求测试理解、生成、调试和持续修改的完整链路。如果你是团队或企业负责人,不要只比较单次生成效果,还要验证权限、数据安全、成本、培训、规范执行和可审
如果你是新手或轻量开发者,优先选 TRAE。它更容易把需求、代码、预览和修改放在同一工作区。如果你是中文场景重用户,优先试用 TRAE。重点验证中文需求理解、连续修改和调试回路是否符合预期。如果你是有经验的 IDE 开发者,可以把 TRAE 作为日常主力,同时针对复杂任务保留 Claude Code。如果你是深度 CLI 用户,优先保留 Claude Code。除非 IDE 工作流能明显降低你的审
如果你是新手或轻量开发者,优先选 TRAE。IDE 内操作更直观,也更适合从代码解释、页面修改和小功能开始使用 Agent。如果你是有经验的开发者,但主要做常规业务迭代,优先试用 TRAE。把复杂命令任务留在原有工具链即可。如果你是中文场景重用户,优先选 TRAE。尤其适合中文需求转开发任务、持续反馈和 IDE 内协作。如果你是团队或企业负责人,先用 TRAE 做低风险试点。同时验证账号体系、权限
如果你是新手或轻量开发者,优先选 TRAE。IDE 内操作更直观,适合从中文需求、页面开发和日常修复开始。如果你是有经验的开发者,按主要工作流选择。偏 IDE 就对比 TRAE 与 Cursor;偏终端就对比 Claude Code、Codex CLI 和 OpenCode。如果你是中文场景重用户,优先验证 TRAE。测试中文需求理解、连续修改和项目规则遵循,而不是只测试单次代码生成。如果你代表团
如果你是新手或轻量开发者,优先选 TRAE。图形化环境更容易理解 Agent 修改了什么,也更方便随时接管。如果你是有经验但不依赖终端的开发者,可以先把 TRAE 作为主力 IDE,再根据复杂任务补充 Claude Code。如果你是中文场景重用户,优先验证 TRAE。重点测试中文需求拆解、跨文件修改和报错修复是否符合你的项目习惯。如果你代表团队或企业,不要只比较单次生成效果。还要验证账号管理、权
直接在linux下执行,将以下命令中的密码占位符替换为你实际要设置的密码,并将替换为当前管理员账号的密码,我这里创建一个esReader账号,分两步,创建角色和账号,然后新账号关联角色。
关键词:人才培优系统;共识链条;前后端分离;HTML;SpringBoot
Git分支合并指南摘要 本文详细介绍了将特定提交从一个Git分支合并到另一个分支的多种方法。主要内容包括: 核心方法: cherry-pick:最常用方式,可合并单个或多个提交 merge --no-ff:通过临时分支合并部分功能 补丁应用:使用format-patch和apply 操作场景: 合并连续/不连续的提交 处理远程分支提交 选择性合并文件或目录 修改提交信息 冲突解决: 使用--con
本文介绍了OpenPI项目的安装与使用指南。首先需克隆仓库并更新子模块(git clone --recurse-submodules)。建议通过wget下载uv依赖管理工具,解压后手动安装。使用uv同步库文件并安装环境(uv sync & pip install)。最后提供了infer.py示例代码,展示了如何加载预训练模型进行推理。注意图片数据需替换为实际输入,运行环境需配置Python
Elaticsearch,简称为 ES,ES 是一个开源的高扩展的分布式全文搜索引擎,是整个 Elastic Stack 技术栈的核心。
Git代码行数统计指南 通过Git命令可统计开发者提交的代码行数、删除行数及净增行数,帮助评估工作量、分析代码质量和监控项目进度。 核心方法: 个人统计:使用git log --author="name" --numstat查看行数变化,结合awk计算总量 时间筛选:添加--since和--until参数指定统计周期 团队统计:循环遍历提交者名单,输出每人贡献量 可视化工具:利
上周一上午9:20,我带的5人研发小组要在两天内搭出一套代码审查自动化流程:接收Git事件、校验成员权限、关闭审查任务,并留下审计记录。据官方产品信息,TRAE基础版免费,我用它先完成可运行原型,再拿同一仓库测试另外7款工具,重点观察团队协作、代码生成和安全修正能力。
在 IDEA 中部署项目到 GitHub:完整指南本文详细介绍如何通过 IntelliJ IDEA 将本地项目快速部署到 GitHub,适合 Java 开发者及新手参考。可高效完成本地项目到 GitHub 的部署,实现代码托管与协作开发。合理使用 Token 认证和分支管理,能提升代码安全性与协作效率。
Elasticsearch是一个全文检索服务器全文检索是一种非结构化数据的搜索方式结构化数据:指具有固定格式固定长度的数据,如数据库中的字段。非结构化数据:指格式和长度不固定的数据,如电商网站的商品详情。结构化数据一般存入数据库,使用sql语句即可快速查询。但由于非结构化数据的数据量大且格式不固定,我们需要采用全文检索的方式进行搜索。全文检索通过建立倒排索引加快搜索效率。真实开发中我们往往需要对一
今年8月,我带一个4人小组给内部研发平台搭建代码审查自动化流程:后端要提供成员查询接口,前端要接分页,测试还要求统一错误码。过去这种跨角色联调很容易反复返工。据官方产品信息,字节跳动出品的 TRAE 是一款 VS Code 同源的 AI 原生 IDE,基础版免费,正好适合我验证一套低成本的团队编程协作技巧。
处理工作的区域临时存放的区域最终的存放区域在你电脑里看到的目录在.git文件夹内的index中 (二进制记录)指的整个.git文件夹 (也认为是本地仓库)
.gitignore文件的配置说明
在 flush 过程中,内存中的缓冲将被清除,内容被写入一个新的 Segment,Segment 的 fsync 将创建一个新的提交点( Commit Point),并将内容刷新到磁盘,旧的translog将被删除并开始一个新的translog,flush 触发的时机是定时触发(默认30分钟)或者 translog 变得太大(默认512M)时。取决于你的文档的大小,分片的数量和你使用的硬件,给 1
使用 ElasticSearch(简称 es) 的过程中,经常有一些临时查询(如 排查问题、验证效果),一个趁手的可视化工具 可以提高工作效率。个人倾向于 免费(最好开源)、易于安装(如 浏览器插件),`es-client` 就是 比较简单好用的一个,尤其是 查询
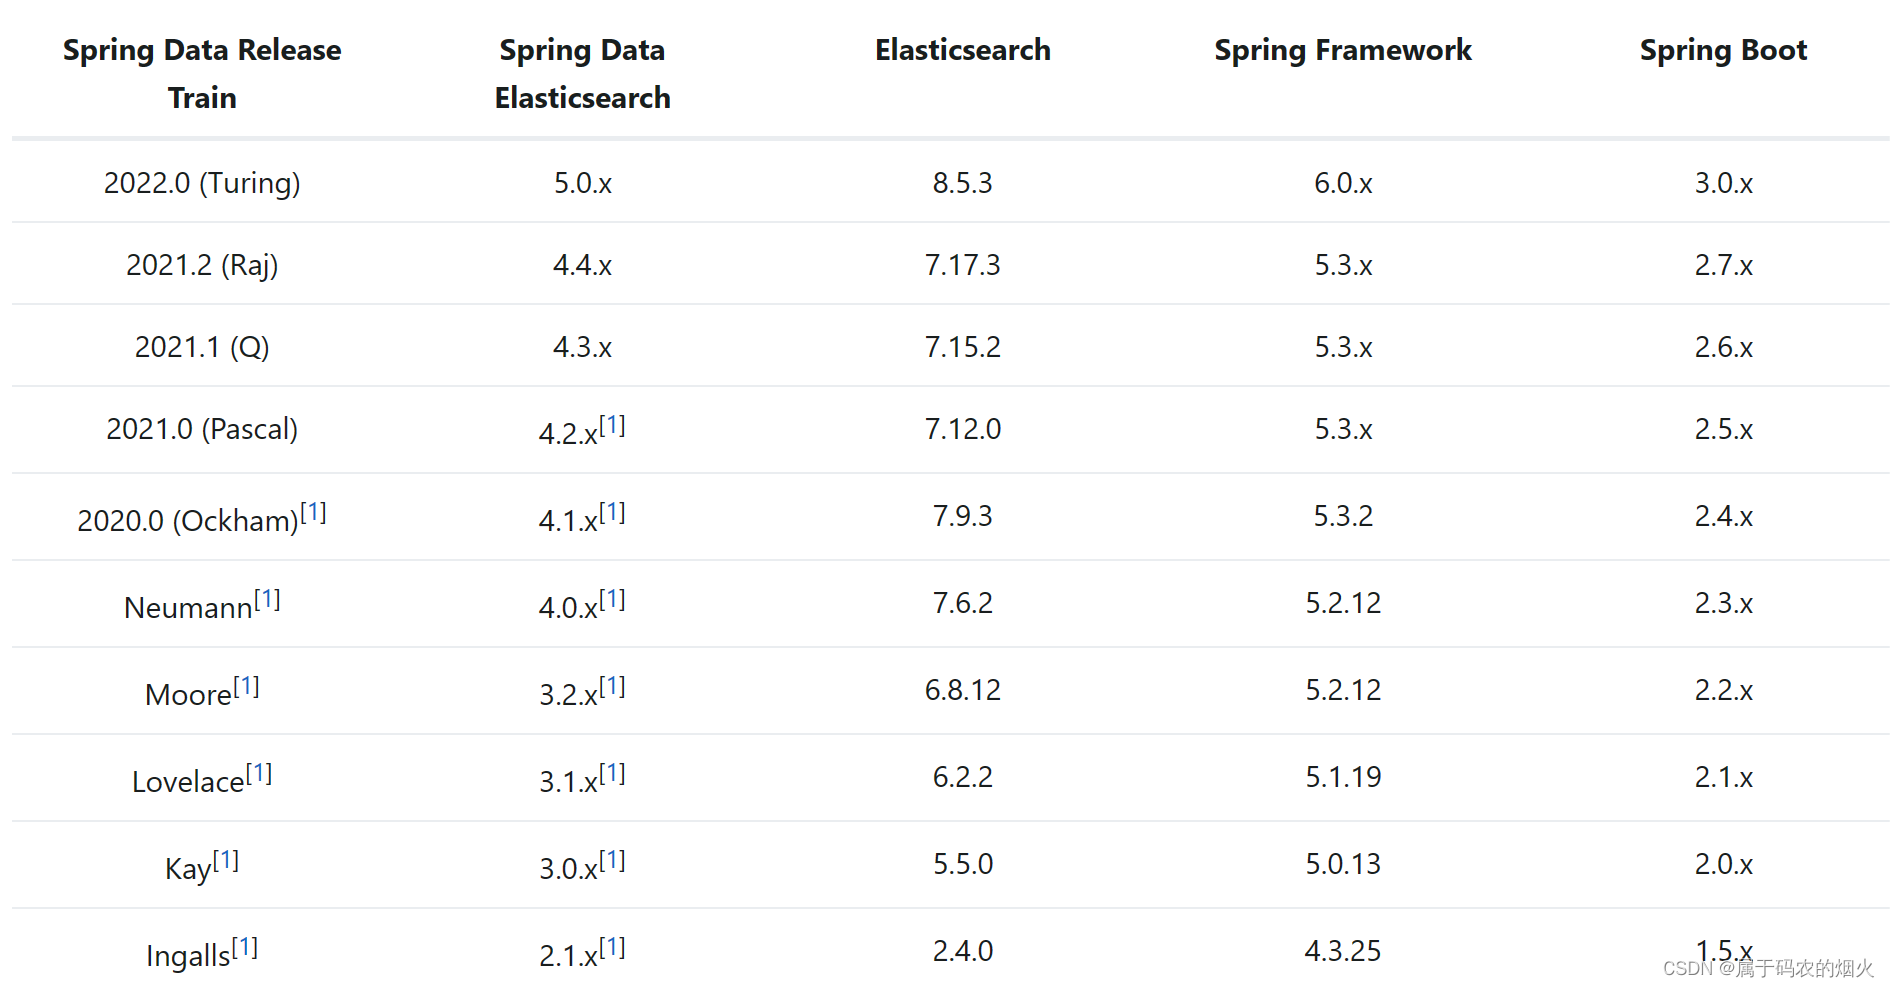
在node安装路径下,使用命令安装:npm install -g grunt-cli 安装grunt。为了避免使用的Elasticsearch版本和SpringBoot采用的版本不一致导致的问题,尽量使用一致的版本。安装过程结束后,在dos窗口查看是否安装成功,使用命令:node -v,出现如下截图,则说明安装成功。es5以上就需要安装node和grunt,所以安装head插件的前提,是需要把该两
【摘自百度百科】Elasticsearch 是一个分布式、高扩展、高实时的搜索与数据分析引擎。它能很方便的使大量数据具有搜索、分析和探索的能力。充分利用Elasticsearch的水平伸缩性,能使数据在生产环境变得更有价值。Elasticsearch 的实现原理主要分为以下几个步骤,首先用户将数据提交到Elasticsearch 数据库中,再通过分词控制器去将对应的语句分词,将其权重和分词结果一并
如果你是新手或轻量开发者,优先选 TRAE,从页面开发、Bug 修复和小型项目开始。如果你是中文场景重用户,优先选 TRAE,重点验证中文需求拆解和多轮迭代是否顺畅。如果你是有经验但偏 IDE 的开发者,可以将 TRAE 与 Cursor 放在同一组实测,再按跨文件修改质量和成本选择。如果你是深度 CLI 用户,优先保留 Claude Code;如果希望更轻量或更可定制,也可以测试 Aider、C
今年3月,我带着6人研发小组重做连锁零售公司的员工考勤模块:后端用 Flask,10天内要交付角色权限、审批流、审计日志和部署脚本。团队过去各自使用不同插件,生成代码的命名和异常处理并不统一,所以我把 TRAE 放进同一套任务里测试。据官方产品信息,TRAE 基础版免费;对需要控制采购成本的企业团队,这一点很实际。
上个月,我带着6人研发组给内部 Atlas 项目搭建代码审查自动化流程:PR 高峰时要自动分配 Reviewer、生成变更摘要,还要保证 Webhook 重放不会重复派单。我把“企业团队编程软件”当成真实选型题,在同一个 FastAPI 仓库里连续实测了一周。据官方产品说明,TRAE 基础版免费;据 CSDN 评测,其中文语义理解准确率处于行业领先水平,这对习惯直接写中文需求的团队很实用。
elasticsearch
——elasticsearch
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 DAMO开发者矩阵





 AtomGit AI 社区
 openEuler 社区
 快递鸟社区


 AtomGit开源社区