登录社区云,与社区用户共同成长
邀请您加入社区
细心的小伙伴会发现前面的文章在模型保存之后进行模型推理时,我们使用的数据是在训练之前我们对数据进行处理的encoder_input_data中读取,而不是我们手动输入的,那么这一章主要来解决自定义输入推理的问题。模型部署也是很重要的一部分,这里先讲基于python的部署,后面我们还要将模型部署到移动端。会得到这样的两个文件:input_words.txt,target_words.txt。
在深度学习项目的生命周期中,模型部署与测试阶段是至关重要的一环。这一阶段的核心目标是确保经过训练的模型能够在实际环境中稳定、高效地运行,同时保持训练时期的性能。在本文中,我们将通过一个综合案例,详细探讨模型部署和测试的整个过程。
用户管理功能的实现是可以对于系统当中所有的用户信息进行管理,同时也可以通过系统来搜索用户信息,并且也可以通过用户管理来修改或者是删除用户信息。管理员可以通过菜品识别菜单来进行检测图片中的菜品信息,通过点击上传要检测的图片,然后点击开始检测,系统会通过所传的图片给出相应的答案信息。当管理者需要检测多种菜品信息时,可以选择使用批量识别检测功能,系统会通过管理者上传的批量信息做出准确的检测。系统功能需求
体育用品销售天然具有季节性、促销敏感性与品类差异,传统经验式补货很难同时兼顾预测准确率、库存周转与经营响应速度。本文围绕一个基于 Python 与 LSTM 的体育用品销量预测系统,完整拆解从原始销售数据清洗、日期特征构造、滑动窗口样本生成、标准化处理、LSTM 网络搭建、模型训练评估,到未来多日滚动预测和可视化业务输出的实现过程。系统将销量、折扣、库存、星期、月份、移动均值、波动特征等信息统一输
混合导航/Slam算法工程师
Self-Attention 的中文名称是自注意力机制。它的作用是让序列中的每个 Token 都能够关注其他 Token,从而建立不同位置之间的关联。我喜欢人工智能,因为它很有趣。模型处理“它”这个 Token 时,需要通过上下文判断“它”指代的是人工智能。Self-Attention 就能够帮助模型建立这种上下文关联。随着网络层数增加,模型可能出现梯度消失和训练困难等问题。Transformer
输入网络的:train_x形状是 (100,) → 重塑后是 (20, 5, 1)。实际输入LSTM中的维度为(5,20,1)对应 (seq_len, batch_size, input_size),解释:seq_len=5:每个样本的时间序列长度为 5;batch_size=train_data_len//5=20:总训练样本数 100,按 seq_len=5 划分后得到 20 个 batchi
本项目在pytorch框架下,基于LSTM+CNN神经网络,实现对于气温的预测,模型收敛良好。
最近项目用到了LSTM ,但是对LSTM 的输入输出不是很理解,对此,我详细查找了lstm 的资料。:堆叠的 LSTM 层数,增加层数可以提升模型的表达能力。:一个全连接层,将 LSTM 的输出映射到最终的预测值。:LSTM 隐藏层的维度,决定了模型的记忆能力。:将提取的输出通过全连接层,得到最终的预测结果。分别表示初始的隐藏状态和细胞状态,形状为。:输入特征的维度,适用于单变量时间序列。:提取序
基于LSTM(长短期记忆网络)的轴承故障诊断研究,结合西储大学的数据,是一个融合了深度学习技术的故障诊断方法。
基于python的LSTM/CNN/TCN/GRU/BiLSTM/GCN/GAT/BP及组合模型时间序列预测程序。pytorch框架。,注释清晰可用于单输入单输出,多输入单输出,单步预测,多步预测优点:(1)代码清晰有注释,标注可调参数,非常适合小白理解(2)简洁的滑动窗口函数,直接调用(3)包含R2,MAE,MSE,RMSE评价指标,预测曲线图清晰可直接插入论文,不模糊(4)预测结果可保存为表格
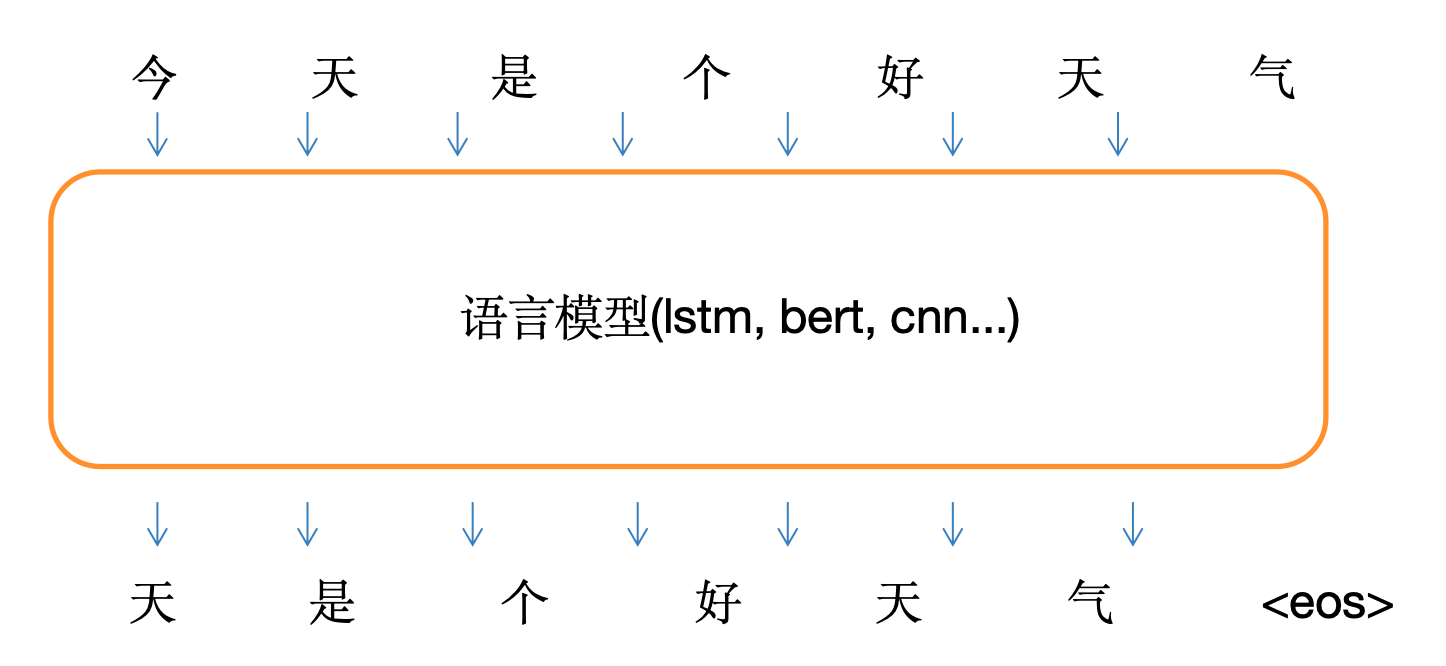
本文基于给定的词表,将输入的文本以字符分割为若干个词,然后基于词表将词初步序列化作为训练网络的输入序列,将词后面一个词在词表中的序号作为输入标签,取连续序列文本片段长度作为输入序列的长度。之后经过`Embedding`、`LSTM`等网络层。因为生成的词是词表中某个词,因此模型输出为已知词表上的多类别概率分布,从而实现一个简单文本的续写任务。
基于LSTM(长短期记忆网络)-Attention(注意力机制)故障分类模型的轴承故障诊断研究,结合西储大学的数据,是一个融合了深度学习技术和注意力机制的先进故障诊断方法。
主要生成相似句 再用神经网络判定句子的通顺性直接上代码两部分工作:第一部分基于统计生成相似语料:借助网上的python的github上的synonyms(自行百度):https://github.com/huyingxi/Synonyms 这里要说一下 分词不要用垃圾 的jieba 可以考虑hanlp 或者其他的 ;效...
然后是熵权法,这是一种客观赋权方法,用于确定各指标的权重。熵权法通过计算各指标的熵值来判断该指标的离散程度,离散程度越大,熵值越小,信息量越大,权重也就越高。反之,离散程度越小,熵值越大,权重越低。克里金(Kriging)与多目标优化的结合是一种在复杂系统建模与决策中常用的方法,其核心是通过克里金模型近似多目标函数的空间分布,并利用多目标优化算法寻找最优解集。克里金模型,也称为空间插值法,是一种在
摘要: 本文提出一种结合变分模态分解(VMD)、长短期记忆网络(LSTM)和粒子群优化(PSO)的时间序列预测方法。VMD将复杂时序分解为多个平稳模态分量,LSTM建模序列长期依赖关系,PSO优化LSTM关键参数(如隐藏层节点数和学习率)。实验采用Matlab实现,通过适应度函数评估模型性能。结果表明,该VMD-LSTM-PSO框架有效提升了非线性、非平稳序列的预测精度,适用于能源、气象等领域。核
贝叶斯优化方法则采用贝叶斯思想,通过不断探索各种参数组合的结果,根据已有信息计算期望值,并选择期望值最大的组合作为最佳策略,从而在尽可能少的实验次数下达到最优解。不同功能的代码块被组织成函数或者独立的模块,使得代码逻辑清晰,结构化程度高。可视化结果: 代码中包含了对训练过程和预测结果的可视化,真实标签与预测标签的对比等,有助于直观地评估模型的性能和结果的准确性。参数设置:通过指定参数的值,如贝叶斯
今天智谱在2025中关村论坛上发布最新Agent 产品AutoGLM,具备深度研究能力和操作能力,可自主打开并浏览网页,完成从数据检索、分析到生成报告。我说一下使用体验,后台不要又来骂我推agent了。人家这是开源的。别bb了。超长任务:理解超长指令,执行超长任务。例如,在采购火锅食材的例子中,AutoGLM 自主执行了 54步无打断操作。并且,在这种多步、循环任务中,AutoGLM 的速度表现超
在工业自动化和智能制造的浪潮中,设备的健康状态监测与故障诊断技术成为维护生产安全和提高效率的关键。随着人工智能技术的不断进步,特别是深度学习模型如长短记忆网络(LSTM)的应用,故障诊断技术正经历一场前所未有的变革。然而,LSTM模型的性能受限于其参数设置的优劣,这就迫切需要一种高效的优化方法来提升其性能。遗传算法(GA),作为一种强大的全局优化工具,与LSTM的结合正在为故障诊断领域带来新的革命
故障诊断是工业生产中至关重要的环节,其目的是及时发现和识别设备故障,避免重大损失。近年来,深度学习技术在故障诊断领域取得了显著进展,其中长短记忆网络(LSTM)因其优异的时序数据处理能力而备受关注。然而,LSTM模型参数众多,优化难度较大,传统方法难以获得最优参数,导致诊断精度下降。为了解决这一问题,本文提出了一种基于布谷鸟搜索算法(CS)优化的LSTM模型,利用CS算法的全局寻优能力对LSTM模
本文提出了一种基于长短时记忆神经网络(LSTM)结合注意力机制(Attention)的故障诊断方法。该方法利用LSTM网络对时序数据进行建模,并通过注意力机制关注故障特征,从而提高故障诊断的准确性。
【代码】基于LSTM的刀具剩余使用寿命预测(matlab代码实现)
随着社会不断进步和生活压力的不断上升,心脏疾病已经成为威胁人类健康的重要因素.心电信号(ECG)表征了人体心脏的电活动,可以通过心电图直观展现出来,在心脏疾病发病前,心电信号中一般会出现相应的心律失常现象,因此,对心电信号进行识别分类研究,对心脏病的诊断和治疗具有重要的意义.由此许多专家和学者对心电信号的识别分类进行了大量研究.心电信号的识别分类通常包括心电信号采集,心电信号预处理,提取心电特征,
我们将使用小波变换生成信号的时频表示。小波变换极大的增强了信号中作为时间的函数存在的频谱信息。我们可以将这些信息保存为图像,以便与卷积神经网络一起使用。卷积神经网络将被训练来检测超声心电图(ECG)信号是否来自正常窦性心律(NSR)、心律失常(ARR)或充血性心力衰竭(CHF)的心脏。
LSTM参数
时间序列数据往往反映了某个事件发展的规律,蕴含着丰富的潜在信息。长短期记忆(LSTM)神经网络由于其网络结构的特殊性可以储存信息,解决长期依赖问题,常被用于时间序列预测。对LSTM的研究有利于高效挖掘出时序数据中的重要信息,对社会、经济等各个方面的发展均有着重要的影响。智能优化算法。
LSTM网络实现问题描述影片评价问题:输入一个英文句子,输出好/坏的二元评价,比如The movie is very bad-> 0Wonderful -> 1算法思路本图中的数字仅为示例,并非真实数据Embedding层在上一篇卷积神经网络的实现中,我们将类别直接映射为{0,0…1,…0}这样的向量,但对于单词而言,这个向量维度太大了(500个单词就是500维…),结合后面的
本文提出WaveToken,一种基于小波变换的时间序列离散化方法,用于构建通用预测基础模型。通过多级小波分解、阈值处理和量化,将连续时间序列转化为1024个token的紧凑表示,在保持时频局部化特性的同时简化学习过程。在42个数据集上的实验表明,WaveToken在域内和零样本预测任务中均优于现有方法,尤其在处理非平稳数据和长时预测时表现出色。消融研究验证了小波族选择、词汇量等关键设计。该方法为开
【LSTM-XGBOOST多变量回归预测】基于长短期记忆神经网络-XGBOOST多变量回归预测。(可做分类/回归/时序预测,具体私聊),可直接运行。matlab代码,2020b及其以上。1.LSTM-XGBoost回归预测,模型是一种结合了LSTM和XGBoost两种算法的混合模型,2.LSTM是一种循环神经网络,可以用于处理时序数据,而XGBoost则是一种梯度提升树算法,可以用于进行分类和回归
【Transformer-LSTM-SVM多变量回归预测】基于Transformer-长短期记忆神经网络-支持向量机多变量回归预测。(可做分类/回归/时序预测,具体私聊),可直接运行。matlab代码,2020b及其以上。1.运行环境要求MATLAB版本为2020b,多特征输入单输出模型。程序内注释详细,直接替换数据就可以用。2.评价指标包括:R2、MAE、MSE、RMSE和MAPE等,代码质量极
网上的案例基本存在这两种数据集,多数是(batch_size,1,ouput_size)但是以下图对应结构,y的shape是(batch_size,timestep,ouput_size)似乎更合理,求教。lstm的输入X的shape是(batch_size,timestep,input_size)还是y的shape是(batch_size,1,ouput_size)train_y的shape是(
好的,在这里我向你展示一份使用 LSTM 来预测车辆轨迹的 Python 代码。首先,我们需要导入所需的库:import numpy as npimport matplotlib.pyplot as pltfrom sklearn.preprocessing import MinMaxScalerfrom keras.layers import LSTM, Densefrom kera...
lstm单变量单步预测
在本文中,我们比较了深度学习模型:长短时记忆(LSTM)和卷积神经网络(CNN)在80-20次和75-25次训练测试分割比例中的表现。LSTM对like维度的情绪的识别率最高,为88.6%。CNN也给出了87.72%的准确率,因为它能够从输入信号中提取空间特征。因此,在这种情况下,这两种模型都非常好。在本文中,我们提出了两种深度学习模型LSTM(长-短期记忆)和CNN(卷积神经网络)之间的一个独特
cnn和lstm原理
tensorflow2.0 中lstm的实现tensorflow2.0 中lstm的实现from __future__ import absolute_import, division, print_function, unicode_literalsimport collectionsimport matplotlib.pyplot as pltimport numpy as np...
deeplearning.ai 总结 - C++实现lstm cellflyfish//各个变量的含义//xt -- your input data at timestep "t", array of shape(n_x, m).//a_prev -- Hidden state at timestep "t-1", array of shape(n_a,..
本文是微博四分类情感分析实战系列的第一篇——数据预处理。基于 TextRNN(双向LSTM) 模型,从零讲解 NLP 数据预处理全流程。内容涵盖:字符级词表构建(频次统计、低频过滤、<UNK>/<PAD> 特殊标记、pickle 持久化)、数据集加载与预处理(字符转 ID、Padding 截断、8:1:1 划分训练/验证/测试集),以及自定义 DatasetIterater 批量迭代器。词表最终大
该协议为AI应用提供标准化接口,实现能力的发现、描述与调用,推动模型跨系统协作。然而,其设计聚焦语义层,难以支撑毫秒级实时控制,具身智能需分层处理:语义决策走协议,物理闭环由本地控制器保障。协议虽提升可发现性与治理能力,但对时间敏感、不可逆动作仍需前置授权与人工干预。未来方向包括混合编排、凭证化权限与仿真回放标准化。企业转型中,应明确边界——协议解决“做什么”,而非“如何稳稳执行”。
本文基于招商银行数据,对比了三种深度学习模型的性能。实验结果表明:1)基础GRU模型表现良好;2)引入注意力机制(Attention)的GRU模型性能有所提升;3)LSTM结合注意力机制也取得不错效果。研究提供了GRU、LSTM三种网络的完整代码实现(资源链接:GRU,LSTM三种网络.rar-CSDN下载),为相关研究提供了可复现的基准模型和实现方案。
车辆路线问题(Vehicle Routing Problem, VRP)是运筹学和组合优化领域一个重要的研究课题,其核心在于为一组客户点设计最优的访问路线,以满足特定约束条件。带容量约束的车辆路线问题(Capacitated Vehicle Routing Problem, CVRP)是VRP的一个常见变体,它要求在考虑车辆载重限制的前提下,最小化总运输成本(通常为总行驶距离)。
lstm
——lstm
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 地瓜机器人开发者社区



 北京朝阳AI社区


 乐奇 Rokid 开放社区







 亚马逊云科技技术品牌专区

 DAMO开发者矩阵