登录社区云,与社区用户共同成长
邀请您加入社区
在 BERT 上做自回归语言模型必须添加下三角 mask,否则模型会因 “偷看未来信息” 而失去真正的预测能力,最终生成任务完全失效。这也是为什么你的代码中特别强调 “训练时构建下三角 mask 矩阵,让上下文之间没有交互”—— 这是用 BERT 做生成任务的核心改造点,不可或缺。
这是pytorch 基础过后的第一个完整项目,不懂的欢迎评论。内容包括:数据预处理,数据集分割,网络定义,训练和测试。其中还有一些小细节,损失函数选择和优化器选择,欢迎大家阅读。
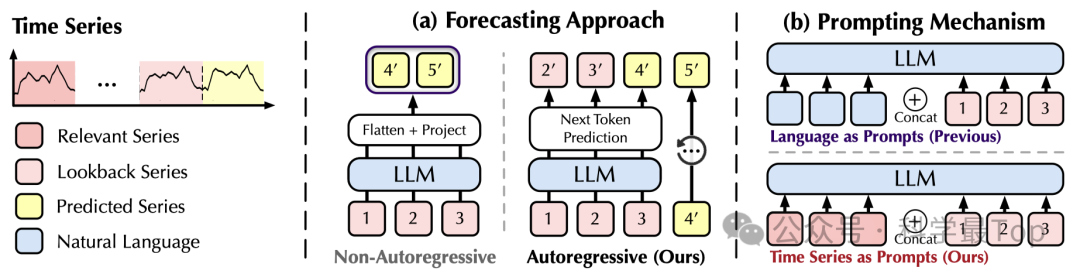
最近大家在读ICLR25的文章吗?感觉高分论文需要的知识储备好多,阅读门槛也太高了~回到这篇文章,本文提出“AutoTimes”方法,旨在将大型语言模型重新用于自回归时间序列预测,通过把时间序列投射到语言标记的嵌入空间中,并以自回归的方式生成任意长度的未来预测结果。“AutoTimes”将时间序列表述为提示信息,将预测的上下文扩展到回顾窗口之外,这被称为“上下文内预测”。通过引入嵌入大型语言模型的
曾经在天梯赛大杀四方的吉老师决定回归天梯赛赛场啦!。众所周知,吉老师的竞赛水平非常高超,你可以认为他每道题目都会做(事实上也是……)。因此,吉老师会按照顺序看题并做题。但吉老师水平太高了,所以签到题他就懒得做了(浪费时间),具体来说,假如题目的字符串里有qiandao或者easy(区分大小写)的话,吉老师看完题目就会跳过这道题目不做。现在给定这次天梯赛总共有几道题目以及吉老师已经做完了几道题目,请
核心观点:8/25 Hot Chips 2026 英特尔一天连开三场,边缘 Wildcat Lake、服务器 Diamond Rapids(256 核 Xeon)、推理 Crescent Island(480GB)。但先澄清:所谓「三档 agentic AI 架构」是观察者归纳,不是英特尔的官方框架,而且目前全停在「架构摊牌」阶段,验证点都在 2027。真正的看点不是核数内卷,而是英特尔赌「age
负荷预测是电力系统运行和管理中的关键环节,准确的负荷预测可以有效提高电力系统的可靠性、经济性和安全性。近年来,随着人工智能技术的快速发展,基于机器学习的负荷预测方法得到了广泛应用,其中时间卷积网络 (TCN) 因其在时间序列数据处理方面的优势,逐渐成为负荷预测领域的研究热点。本文将探讨一种基于双向时间卷积网络 (BiTCN) 的负荷多变量时间序列预测方法,旨在利用历史负荷数据和影响负荷变化的多个因
摘要:拉索回归(Lasso)是一种带L1正则化的线性回归方法,能够自动进行特征选择,将不重要特征的系数压缩为零。它适用于高维数据(特征数>样本数)和特征相关的情况,能产生更简洁的模型。通过sklearn的Lasso()实现,关键参数包括控制正则化强度的alpha(值越大特征选择越强)和max_iter等。示例代码展示了在加州房价数据集上的应用:先标准化数据,再训练模型,最后评估MSE损失。结
贝叶斯优化方法则采用贝叶斯思想,通过不断探索各种参数组合的结果,根据已有信息计算期望值,并选择期望值最大的组合作为最佳策略,从而在尽可能少的实验次数下达到最优解。不同功能的代码块被组织成函数或者独立的模块,使得代码逻辑清晰,结构化程度高。可视化结果: 代码中包含了对训练过程和预测结果的可视化,真实标签与预测标签的对比等,有助于直观地评估模型的性能和结果的准确性。参数设置:通过指定参数的值,如贝叶斯
4---多种智能优化算法:蝙蝠(BAT),非洲秃鹫(AVOA),布谷鸟(CS),蜣螂(DBO),萤火虫(FA),烟花(FWA),灰狼(GWO),哈里斯鹰(HHO),多元宇宙(MVO),粒子群(PSO),正余弦(SCA),麻雀(SSA),樽海鞘群(SSA),鲸鱼(WO)等智能优化算法,分别用来优化LSTM,LSTM-Attention,bigru,CNN-lstm-attention等等。涵盖时间序
【Transformer-BIGRU回归预测】Transformer-BIGRU多变量回归预测,基于Transformer-BIGRU多变量输入模型。matlab代码,2023b及其以上。评价指标包括:R2、MAE、MSE、RMSE和MAPE等,代码质量极高,方便学习和替换数据。参数可方便更改,程序和excel数据放在一个文件夹,注释明细。Transformer 作为一种创新的神经网络结构,深受欢
**多项式回归**是回归分析的一种扩展形式,通过增加多项式特征,可以模拟输入特征与输出之间的非线性关系。与线性回归不同,线性回归仅适用于直线拟合,而多项式回归则可以用曲线拟合复杂数据。本教程将系统讲解多项式回归模型,包括模型的推导、数据转换、模型训练、损失函数的定义和梯度下降,并使用`numpy`实现。最后,我们会通过`sklearn`实现多项式回归模型。
决策树是一种树形结构,树中每个内部节点表示一个特征上的判断,每个分支代表一个判断结果的输出,每个叶子节点代表一种分类结果, 根节点尤为重要.熵在信息论中代表随机变量不确定度的度量。熵越大,数据的不确定性度越高, 稳定性越低熵越小,数据的不确定性越低, 稳定性越高CART决策树(Classification and Regression Tree)Cart模型是一种决策树模型,它即可以用于分类,也可
完整代码# 二元Logistic回归算法#数据准备# 1载入分析所需要的模块和函数import numpy as npimport pandas as pdimport seaborn as snsimport matplotlib.pyplot as pltfrom warnings import ...
随着信息技术的快速发展,数据量呈指数级增长,对数据的分析和预测需求也日益迫切。传统机器学习方法在处理非线性、高维数据时往往面临挑战,而回声状态网络 (Echo State Network,ESN) 作为一种新型递归神经网络,凭借其独特的结构和学习机制,在非线性时间序列预测、数据回归等方面展现出优异的性能,并逐渐成为机器学习领域的研究热点。一、回声状态网络简介。
Lasso回归由Robert Tibshirani于1996年提出,是线性回归的一种正则化形式。它在标准线性回归损失函数的基础上,加入了L1范数惩罚项,旨在约束模型参数的绝对值大小,从而促使某些参数直接被“压缩”至零,实现特征的选择性稀疏化。
本篇首先阐述Logistic回归的定义,然后介绍一些最优化算法,其中包括基本的梯度上升法和一个改进的随机梯度上升法,这些最优化算法将用于分类器的训练。尽管逻辑回归的名称中包含“回归”,但它实际上是用于分类的,特别是二分类问题。逻辑回归通过计算输入特征的线性组合,使用Sigmoid函数将输出值压缩0和1之间,表示某个类别发生的概率。通过设定一个阈值(如0.5),可以将概率转换为类别输出。逻辑回归通常
当向模型添加越来越多的变量时,模型可能变得过于复杂,并且通常最终会记住训练集中的所有数据点,这种现象称为模型的过拟合,导致高训练准确率和非常低的测试准确率。线性回归中,预测值(predicted)与观测值的差值称为残差,残差的本质是模型的随机误差(Random Error),是必然存在且不可学习的参数。最优拟合线指的是线性回归模型中的一条直线,它是通过拟合训练数据得出的,使得这条直线与训练数据的残
在机器学习领域,回归预测是一项重要的任务。回归预测的目标是根据给定的输入变量,预测出一个或多个连续的输出变量。XGBoost是一种强大的机器学习算法,被广泛应用于回归和分类任务中。本文将介绍如何使用鲸鱼算法WOA(Whale Optimization Algorithm)来优化XGBoost算法,实现更准确的数据回归预测。XGBoost是一种基于梯度提升树的机器学习算法,它通过迭代地训练多个弱分类
神经网络实现电力系统中冷负荷曲线拟合,对比sim函数测试与权值偏置测试的区别并给出解决方案
线性回归是经典的求解回归问题的机器学习算法,得益于其较强的可解释性,线性回归广泛的应用在各种需求预测场景下。
回归算法属于机器学习的算法之一。回归分析是一种统计学方法,旨在建立输入变量与输出变量之间的关系模型。在机器学习中,回归算法通过从训练数据中学习这种关系模型,来进行预测和连续值的输出。
请注意,这只是一个简单的示例,您可以根据您的具体需求进行更复杂的数据回归预测。MATLAB还提供了其他的集成学习方法,如随机森林(Random Forests)和梯度提升(Gradient Boosting),可以根据需要进行尝试和比较。当使用MATLAB时,您可以使用集成学习方法中的决策树来进行数据回归预测。决策树回归是一种基于树状结构的机器学习算法,它通过对训练数据进行分层次的决策来进行预测连
支持向量机(support vector machines, SVM)是一种二分类模型,它的基本模型是定义在特征空间上的间隔最大的线性分类器,间隔最大使它有别于感知机;SVM还包括核技巧,这使它成为实质上的非线性分类器。SVM的的学习策略就是间隔最大化,可形式化为一个求解凸二次规划的问题,也等价于正则化的合页损失函数的最小化问题。SVM的的学习算法就是求解凸二次规划的最优化算法。
基于双向门控循环单元(BiGRU)的多变量回归预测,matlab代码,要求2020版本及以上。评价指标包括:R2、MAE、MSE、RMSE和MAPE等,代码质量极高,方便学习和替换数据。
辛烷值是汽油最重要的品质指标,传统的测试方法不适合在线测试.BP神经网络通过训练和学习可以实现预测的功能.本文介绍了BP神经网络的相关知识及其在汽油辛烷值预测中的应用.通过对网络输出结果的分析,证明了该网络的有效性.BP网络(Back Propagation),是1986年由Rumelhart和McCelland为首的科学家小组提出,是一种按误差逆传播算法训练的多层前馈网络,是目前应用最广泛的神经
自回归语言模型是根据上文或者下文来预测后一个单词。自编码语言模型是根据上下文来预测当前单词。
一元多项式回归(matlab)
时间序列数据往往反映了某个事件发展的规律,蕴含着丰富的潜在信息。长短期记忆(LSTM)神经网络由于其网络结构的特殊性可以储存信息,解决长期依赖问题,常被用于时间序列预测。对LSTM的研究有利于高效挖掘出时序数据中的重要信息,对社会、经济等各个方面的发展均有着重要的影响。智能优化算法。
python sklearn pipeline做函数拟合,-看学习曲线(均方误差MSE)
理论讲述之前的一篇文章已经简单介绍了回归中的线性回归,https://blog.csdn.net/ji_meng/article/details/123590035?spm=1001.2014.3001.5501这次依然讲回归代码分析
import matplotlib.pyplot as pltfrom numpy import *#从testSet.txt读取数据,创建data和labeldef createdata():f=open('testSet.txt')data=[]label=[]for line in f.readlines():temp=line...
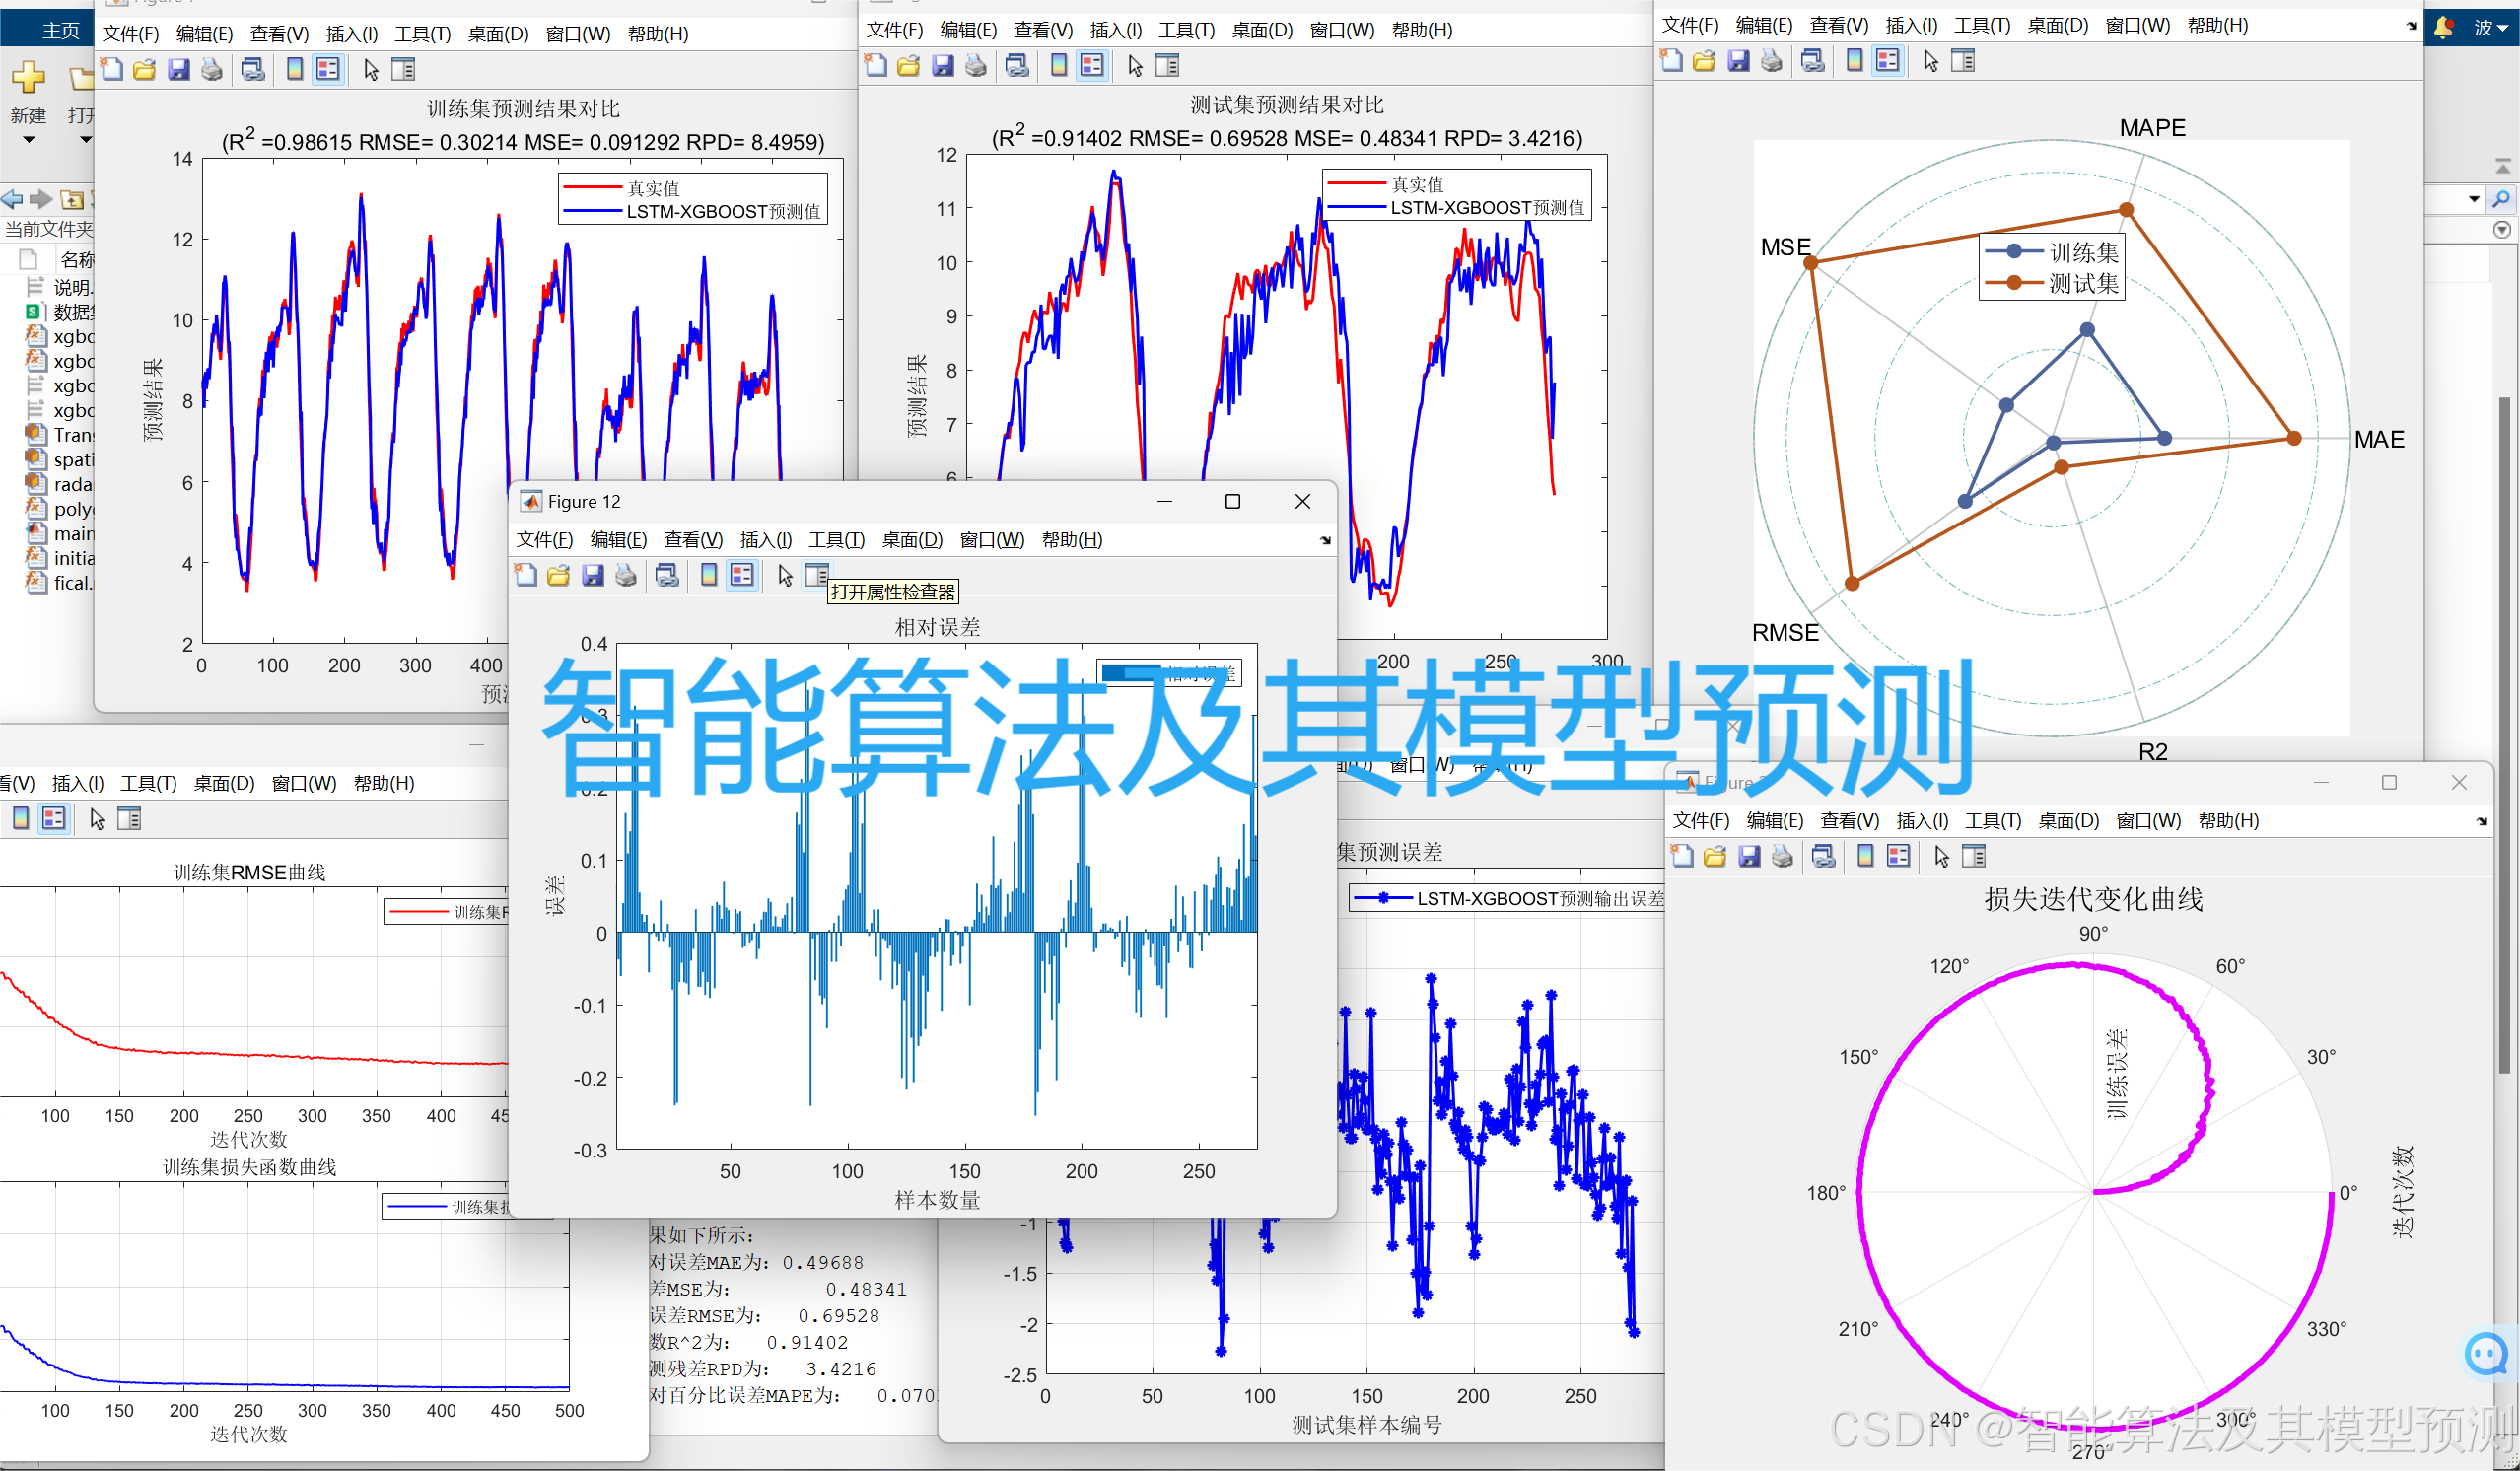
【LSTM-XGBOOST多变量回归预测】基于长短期记忆神经网络-XGBOOST多变量回归预测。(可做分类/回归/时序预测,具体私聊),可直接运行。matlab代码,2020b及其以上。1.LSTM-XGBoost回归预测,模型是一种结合了LSTM和XGBoost两种算法的混合模型,2.LSTM是一种循环神经网络,可以用于处理时序数据,而XGBoost则是一种梯度提升树算法,可以用于进行分类和回归
具体来说,如果我们有`data_num`个数据点,每个数据点有`len(w)`个特征,那么`x`的形状是`(data_num, len(w))`,`w`的形状是`(len(w), 1)`(因为`w`是一个权重向量)。使用PyTorch的`normal`函数生成一个形状为`(data_num, len(w))`的张量`x`,其中`data_num`是数据点的数量,`len(w)`是特征的数量。函数接
在本文章中,我们将要详细介绍一下汉诺塔问题,本题目我们采用递归的方式解决相关的内容以上就是我们对Leetcode中汉诺塔问题详细介绍,希望对大家的学习有所帮助,仅供参考 如有错误请大佬指点我会尽快去改正 欢迎大家来评论~~
RankGuard 升级文搜图索引后,虽局部查询体验提升,但仅靠人工直觉难以判断整体优劣。为确保发布质量,团队构建了基于48条Golden Query的自动化门禁体系:固定数据集版本,采用Recall@10与NDCG@10双指标评估,引入相关性分级(0-3)和代际隔离机制,杜绝心理偏差与状态污染。通过细粒度分析发现“雨夜公交站”等查询存在局部坍塌,及时阻断上线。最终以可复现、可追溯的报告实现模型升
FlexDesk 06 完成五种输入/窗口 Profile 各8轮共40次回归测试,全通过。重点验证布局、导航、折叠、焦点、快捷键等核心状态在反复切换下的连续性与稳定性,实现0错误、0内存泄漏、0内容重建。平均布局耗时2.2ms,导航2.6ms,折叠4.3ms,输入0.9ms,性能基线清晰可追溯,为后续版本迭代提供可靠验收标准。
JsonPulse 06 完成最终回归:5个数据集 × 2个ABI × 4轮 = 40次全量验证,全部通过。重点聚焦正确性闭环与资源安全,确保跨ABI结果一致、错误契约匹配、异步流程无泄漏。性能按环境独立基线,内存稳定增长可控,符号与SDK检查严格准入。核心成果:零解析/错误/回调/资源泄漏,为HarmonyOS原生JSON解析能力奠定坚实基础。
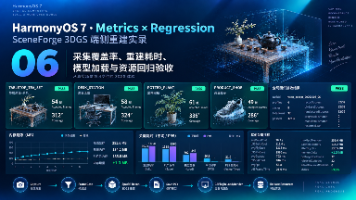
SceneForge 06 完成4类场景(茶具、工作区、绿植、鞋品)各8轮全链路回归,32次测试全部通过。验证了重建、保存、加载、渲染与资源释放的稳定性,关键指标如GPU内存峰值(251.6MB)、平均构建耗时(96.7s)、GS加载(702ms)及帧率(56.8FPS)均表现良好,内存泄漏为0,资源释放完全对齐。结果表明系统具备跨场景泛化能力与工程可靠性。
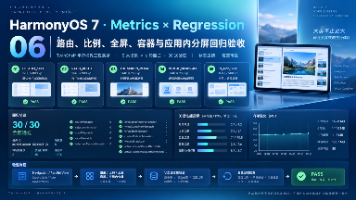
TwinShelf 06 版本聚焦回归验证,将前五篇核心场景(默认分栏、比例切换、全屏媒体、横屏工作区、应用内分屏)纳入统一5配置、6轮×30次的自动化矩阵测试。通过精准比对路由、选中态、滚动位置、比例、全屏与方向恢复等12项状态指标,实现30/30全通过,内存增长仅+1.2MB,证明状态协议可稳定迭代。
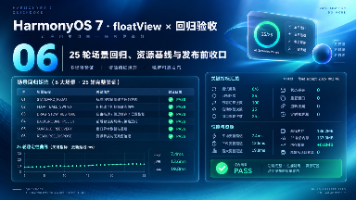
QuickDock第六篇聚焦系统稳定性与资源管理,通过固定6类场景、25轮完整回归,验证状态连续性与资源纯净度。核心成果:状态无丢失、资源零泄漏、内存增量仅+0.8MB,UI更新延迟均值7.4ms(P95 13.6ms),全链路可复现、可对比,确立工程基线,为长期演进提供可靠保障。
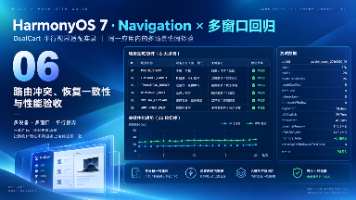
DualCart 进入回归阶段,通过6场景×20轮自动化测试,验证六大运行形态(手机单栈、折叠屏平行视界、过渡页桥接、商品视频沉浸、虚拟比价容器、应用内分屏)的稳定性。聚焦状态边界污染问题,统一监控路由深度、窗口泄漏、监听残留、核心状态一致性等关键指标,实现“可复现路径即开发资产”的闭环。最终达成零冲突、零泄漏、状态一致、内存稳定,为上线建立可靠基线。
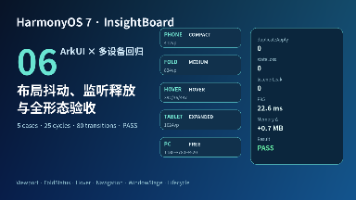
InsightBoard 第六篇以“发版级回归”为目标,通过固定5种设备场景、25轮全形态循环测试,验证布局、状态、事件、生命周期、性能与内存六大维度。引入统一监听计数、去重布局统计、状态自动断言与P95耗时监控,实现0泄漏、0状态丢失、内存增量仅+0.7MB,确保多形态适配在高频切换下依然稳定可靠。
"比如误差跟运行距离不是简单的线性关系——可能是距离的一次项+二次项叠加,因为连杆柔性变形和齿轮间隙都随行程累积,"我接话,"用 pandas 做数据清洗+特征工程,numpy 算误差统计量,scikit-learn 的 PolynomialFeatures 做距离多项式展开,用 Ridge 回归拟合'距离→误差'的映射,再跟 Linear/Pipeline 对比。"我就想干一件事,"小赵说,"给
回归
——回归
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 乐奇 Rokid 开放社区










 HarmonyOS开发者社区

 人工智能6S服务平台

 DAMO开发者矩阵