登录社区云,与社区用户共同成长
邀请您加入社区
本文以2026年10月31日为截面,系统统计中国生成式AI备案突破1100款,形成豆包、通义千问、DeepSeek、GLM、Kimi头部梯队与文心、混元、MiniMax等强项梯队,呈现"通用+垂类""开源+闭源"双轨格局。国家实验室体系以鹏城云脑Ⅲ万P国产算力、之江三体计算星座、上海AI实验室万亿参数科学模型、智源Emu3.5与Brainμ、临港元生、怀柔算电协同为支柱,构成"底座算力—通用大模型
12 月起,ChatGPT 与 Codex 将共用一个额度,Instant 聊天不占额度,Fast 模式按 2.5 倍消耗。额度变紧后,最费额度的用法往往也是效果最差的用法。本文总结改论文时最费额度的 4 个习惯及改法,并附一份可直接照抄的论文项目 AGENTS.md 模板。
本文介绍了一个基于EfficientNetB3的猴痘皮肤病变识别项目。项目使用包含228张原始图像(102张猴痘、126张其他)的Kaggle数据集,通过数据增强扩充样本量。采用Python 3.9和TensorFlow搭建深度学习模型,对EfficientNetB3进行微调,添加Dropout层防止过拟合。实验结果显示模型测试准确率达95.56%,精确率、召回率和F1分数均超过0.95。该模型能
本文清理“真/伪猜想”与“版本”两重混淆:猜想只有定理、假命题、未决三态,“真/伪猜想”系自相矛盾的语言构造,欧拉猜想被证伪后仍称猜想即为判据;贾子猜想定义唯一——n=3m>5、k=n、两两互异、正整数、无解,偏离即非本命题。n=3m系生成论锚点与模3、模16闭合死锁的唯一格点。本文区分费马大定理的可压缩结构与贾子猜想的不可归约问题族:前者无穷指数坍缩为单一模性障碍,后者项数随指数同步增长、跨层归
本文基于MindSpore框架,以ResNet-50为例,完整演示了在昇腾Ascend 910B硬件上进行图像分类训练的全流程。通过数据下沉、混合精度、自动并行等技术,显著提升单卡与多卡训练效率,解决显存不足、吞吐低等问题。提供可运行代码,涵盖环境部署、数据处理、模型训练、精度验证及调优排错,助力开发者高效落地大模型训练。
本文基于昇思MindSpore与昇腾NPU,全流程演示大模型在中文关系抽取中的落地实践。通过指令微调+LoRA低秩适配,实现高效微调与部署,涵盖数据处理、模型训练、推理验证及Gradio可视化,并支持MindIR导出与线上服务部署,助力知识图谱、RAG等场景快速构建结构化关系三元组。
本文整理了两道McKinsey OA真题解法:一是数组成本优化题,通过分析插入整数对相邻元素差平方和的影响,找出使成本最小的插入位置,关键在于局部优化与整数约束处理;二是机器人分类题,需完成数据清洗、特征选择、随机森林建模及评估,强调全流程数据处理与模型性能分析。备考建议涵盖算法思维、数据预处理、模型应用与限时练习,突出理解题意与边界条件的重要性。
本文基于昇思MindSpore与昇腾NPU,以CIFAR-10和ResNet50为例,系统演示图像分类全流程:涵盖数据增强、网络构建、训练调优、评估推理及部署。通过MindData实现高效数据流水线,利用Model高阶API简化开发,结合图模式与分布式训练释放硬件性能。重点介绍昇腾平台调优要点:启用图模式、合理设置batch size、使用预训练模型迁移学习,并规避归一化错误、数据泄露等常见问题,
很多管理者发现,AMR 只接管了搬运和上下架,仓库总人力却大幅下降。答案不在机器人本身,而在用工结构:AMR 替人扛住了岗位峰值,让人从“多面手流转”切换到“专人专岗、流水线作业”。精工智能以 WMS 与 AGV 调度协同,把这一逻辑落到仓储现场。
智慧昆虫分类识别数据集 昆虫识别数据集农作物害虫分类数据集 蛾子数据集蜜蜂图像数据集 yolo分类10297期
【代码】用Weisfeiler-Lehman 图核 计算solidworks零件的拓扑相似度。
针对 100 余张口罩检测数据集(二分类:带口罩 / 不带口罩),基于 Windows 平台 + 消费级 GPU 完成 YOLOv5.2 模型训练,最终模型训练 100 轮达到 0.8左右 mAP,适配小数据集 + RTX3050 的实战场景。
该柑橘病害数据集包含训练集和测试集,分为新鲜柑橘和三种病害类型(溃疡病、黑斑病、绿化病)。训练集中:黑斑病206张、溃疡病201张、新鲜388张、绿化病369张。测试集中:黑斑病138张、溃疡病148张、新鲜164张、绿化病176张。总计训练集1164张,测试集626张图像,可用于柑橘病害分类研究。
在工业设计领域,SolidWorks与Creo的对决从未停歇。前者以易用性圈粉中小企业,后者凭强参数化深耕高端制造。2025年技术迭代后,两者差距是否进一步拉大?
编程语言: Python;数据集来自网络mushrooms_9,其中包括6714张蘑菇图片,分9类,依次为伞菌属(Agaricus)、鹅膏属(Amanita)、牛肝菌属(Boletus)、丝膜菌属(Cortinarius)、粉褶蕈属(Entoloma)、蜡伞科(Hygrocybe)、乳菇属(Lactarius)、红菇属(Russula)、乳牛肝菌属(Suillus);
有时目标检测由于数据集类别不均衡,类别自身分类难易度差距,以及数据集自身标注问题的缘由,导致有的类别能很快收敛,而有的类别迟迟难以收敛,可能出现有的类别已经过拟合而有的类别仍欠拟合的现象。直接改为focal loss难例挖掘又由于标注自身的问题往往不见得有更好的效果。同时由于一般检测时对于不同类别重视程度不同,所以可手动根据类别的重要性和实际的识别效果对分类损失bceloss进行加权,调整难分类别
【完整源码+数据集+部署教程】烟叶植株计数与分类系统源码和数据集:改进yolo11-TADDH
【完整源码+数据集+部署教程】人员异常行为识别检测系统源码和数据集:改进yolo11-CSP-EDLAN
【完整源码+数据集+部署教程】 落叶植物叶片分类系统源码和数据集:改进yolo11-LVMB
视频演示:【鲲码园Python】基于pytorch的猫咪品种分类系统_演示飞书文档:classification_of_cats_breeds_based_on_pytorch
比如我只想从数据集中取手机的图像,来用于我的训练,懒得自己一张一张标注,方法如下。
通过这条曲线,可以评估模型在目标检测任务中的整体性能,并找到合适的置信度阈值,以在精确率和召回率之间做出最佳平衡。PR 曲线越接近右上角,模型性能越好,曲线下方的面积越大,说明模型在不同置信度下的表现越稳定。通过这条曲线,可以选择合适的置信度阈值,以优化模型的检测结果,平衡精确率和召回率。图中的曲线为Precision-Recall Curve(精确度-召回率曲线),展示了不同阈值下分类器的精确度
PyTorch中常见模型可分为三类: 架构分类:CNN(处理图像,如ResNet)、RNN/LSTM(序列数据)、Transformer(长序列建模,如BERT)、GAN(生成数据,如StyleGAN); 任务分类:图像分类(CNN/ViT)、文本分类(LSTM/Transformer)、结构化数据(MLP); 功能扩展:预训练模型(微调适配)、轻量化模型(MobileNet剪枝/量化)。 选择建
导入单图后,点击识别按钮进行识别,右侧展示识别结果,根据识别的类别结果展示类别名,数据集中对应类别的随机图片比对,以及中药材的简介;
狗品种识别数据集助力AI精准识别宠物品种。随着宠物经济发展,准确识别数百种外形相似的犬种成为刚需。该数据集包含1257张图像,覆盖6大犬种,采用yolo格式标注。数据经过多源采集、严格筛选和质量控制,包括分辨率筛选、样本均衡和隐私处理,确保数据多样性、清晰度和平衡性,为训练高精度AI识别模型提供可靠基础。
导入单图后,点击识别按钮进行识别,右侧展示识别结果,根据识别的类别结果展示中英文类别名,数据集中对应类别的随机图片比对,以及果蔬的简介;
【代码】按yolo格式标签分类图像。
导入单图后,点击识别按钮进行识别,右侧展示识别结果;
本项目基于YOLOv8和OpenCV实现钢材表面六类缺陷检测,提供完整解决方案。包含4312张图片的数据集、训练好的权重及详细注释的源码。系统采用Tkinter构建GUI界面,支持图片、视频和实时摄像头三种检测模式,可识别龟裂、夹杂物等六种缺陷类型(中英文标注)。项目结构清晰,包含数据集、权重、源码和依赖文件,安装简单只需执行pip安装命令即可运行。检测结果实时可视化显示,准确率高,界面友好,适用
本项目构建了基于swin_transformer的植物中草药分类识别系统。凭借swin_transformer卓越的性能,该系统能够高效、精准地识别检测'白茅根', '白芍','白头翁','百部', '百合' '半夏','北沙参', '苍术','侧柏叶', '柴胡','赤芍', '佛手'等67种常见植物中草药,满足多样化的使用需求。在接下来的内容中会详细阐述数据集介绍、技术栈、模型训练和精心打造的
在autodl云服务上训练yolov8分类模型的时候出现了报错,以及文件夹数量和跑模型的时候类别对应不上的问题。比如:我的train文件夹下只有cat,dog。去github看了下issue才知道的,特做笔记。原因:因为我在jupyter上运行的,数据集是上传到autodl上的,租用别人的云显卡的。并且我上传数据的时候对数据集进行了操作,比如移动删除之类的。所以有可能会导致出现了隐藏的文件。解决方
随着人工智能技术的飞速发展,大型预训练模型(以下简称“大模型”)已经在自然语言处理、计算机视觉、语音识别等多个领域取得了显著的成果。这些模型通过在海量数据上进行预训练,能够捕捉到丰富的特征信息,为各种下游任务提供强大的支持。本文将围绕大模型的分类,探讨不同类型的大模型及其特点、应用场景和未来发展。一、大模型的分类根据不同的特点和用途,大模型可以分为以下几类:按模型结构分类(1)卷积神经网络(CNN
人工智能(AI)的分类对机器学习进行分类的方式多种多样,可以根据算法的特性、学习方式、任务类型等不同维度进行分类这些分类都不是互斥的:1、按不同:图像,文本,语音,多态等2、按不同:判别式模型,生成式模型等.3、按不同:监督、无监督、半监督、强化学习等。4、按不同:回归、分类、聚类、降维、生成等,
利用 yolo11x 进行物体识别一、物品分类。
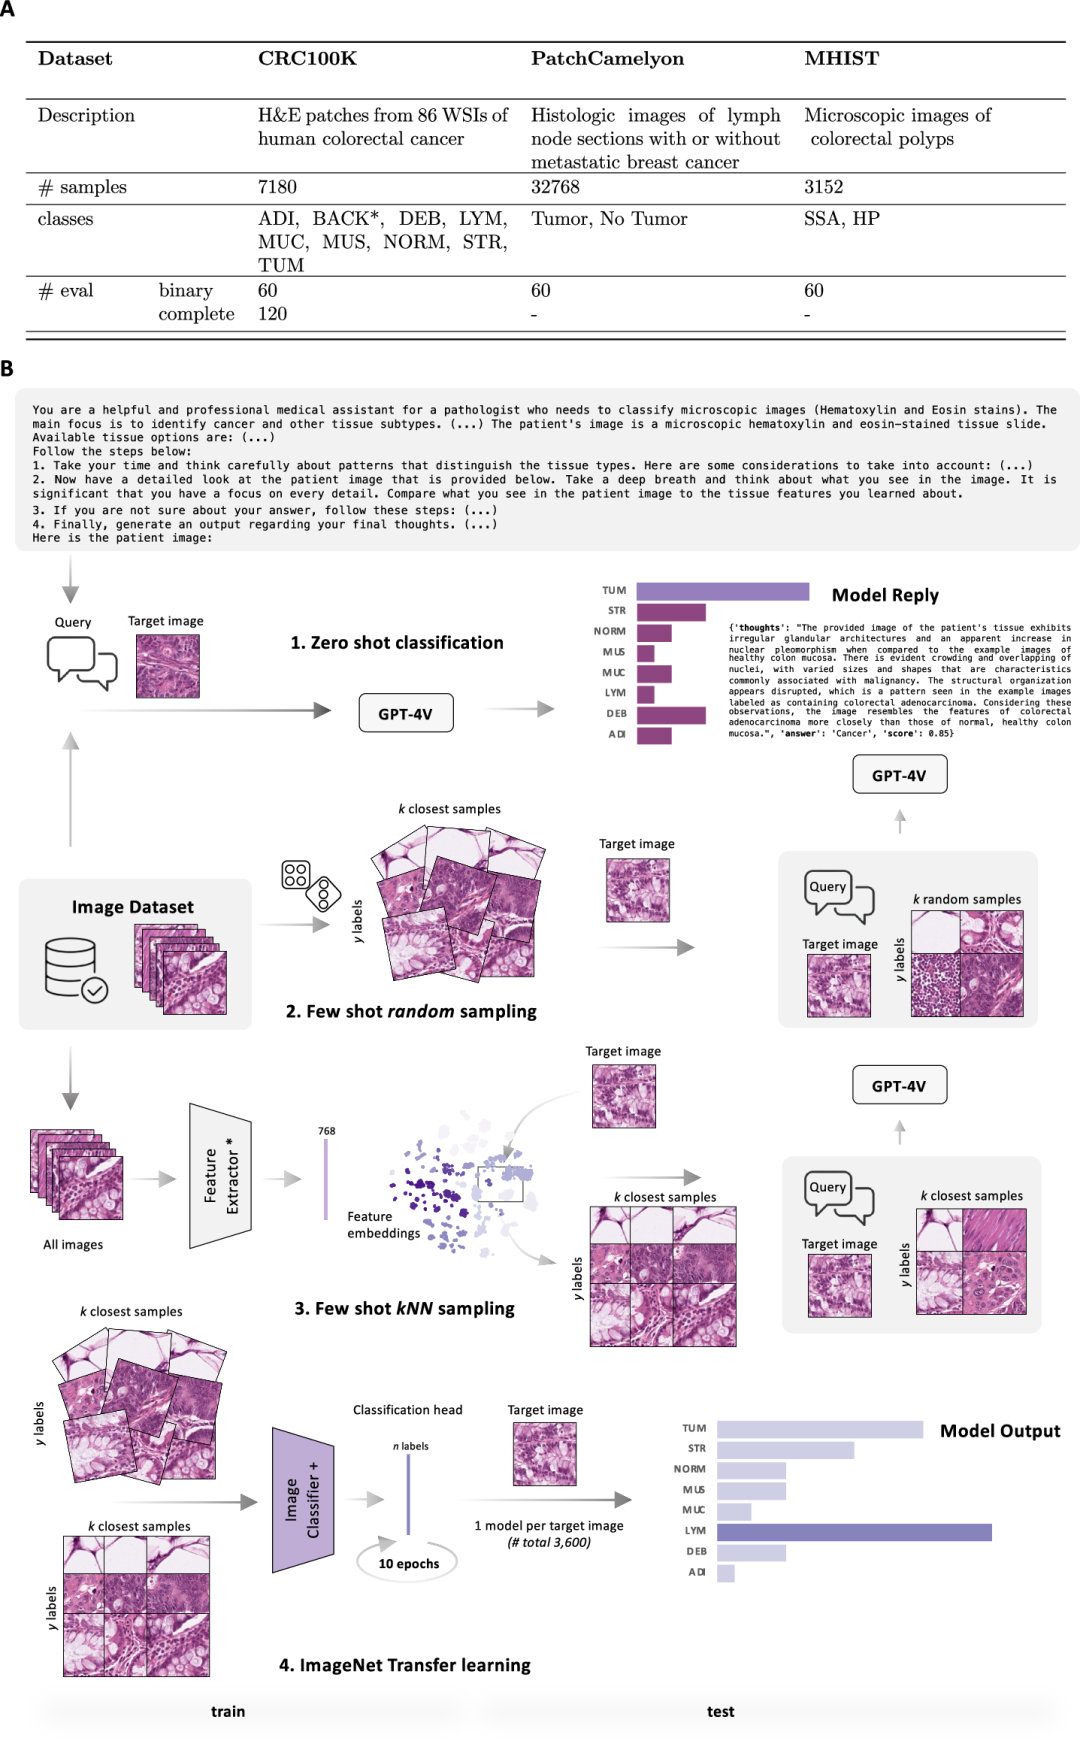
01.工作速览医学图像分类需要使用标记过的、特定于任务的数据集来从头训练深度学习网络,或者用于微调基础模型。然而,这一过程在计算和技术上都极具挑战性。在语言处理中,上下文学习提供了一种替代方案,模型可以直接从提示中学习,从而绕过参数更新的需求。然而,上下文学习在医学图像分析中的应用仍处于探索阶段。2024年11月21日,德国海德堡大学在_Nature Communications_在线发表题为**
详细讲解Hugging Face的evaluate库,以及evaluate的使用,并使用evaluate库来优化文本分类实例的代码。
数据准备:加载并标准化MNIST数据集,将图像展平并切分为patches。位置编码:为每个patch添加位置编码。Transformer编码器:输入展平后的patches并通过Transformer编码器处理。池化:通过池化操作将每个patch的表示聚合成一个全局向量表示。分类头:通过全连接层进行数字分类,输出10个类别的概率分布。训练和优化:使用交叉熵损失进行训练,优化模型参数。评估:评估模型的
图像分类任务是YOLOV8几种任务中最简单的一种,涉及将分类为预定义类别中的一个。图像分类器的输出是标签和一个。当你只需要知道图像属于哪个类别,而不需要知道该类别的对象在哪里或它们的确切形状时,图像分类非常有用。要使用 YOLOv8 进行图像分类,您需要准备一个合适的数据集。以下是建立分类数据集的一般步骤:1.收集并准备您需要分类的图像。确保每个类别下有足够数量的图像,以便训练模型时能够获得良好的
添加图片注释,不超过 140 字(可选)钢材表面缺陷检测,yolov8/opencv使用yolov8训练,数据集图片4312张,已经训练好了,也可以自己重新训练,使用opencv,thinter构建的gui 需要下载相关库,如opencv,ultralytics等 六分类,'crazing', 'inclusion', 'patches', 'pitted_surface', 'rolled-in
在这种情况下,我们将 10% 的样本从非欺诈实例中取而代之,然后将它们与欺诈实例相结合 - 随机抽样后的非欺诈性观察:4950 的 10% = 495 将他们与欺诈观察结合后的总观测值: 50 + 495 = 545因此,现在,低采样后新数据集的事件率为: 9%该数据集在 569 个肿瘤上具有 569 个实例或数据,并且包括关于 30 个属性或特征(诸如肿瘤的半径,纹理,光滑度和面积)的信息。这两
这个是二月份学习的,最近整理资料所以上传到博客备份一下数据在这里:https://www.kaggle.com/competitions/nlp-getting-started/data使用BERT(transformers库)对推特灾难文本二分类xxx着火了(灾难)火烧云像是燃烧的火焰(非灾难)
Open Images是由谷歌发布的一个开源图片数据集,在2022年10月份发布了最新的V7版本。这个版本的数据集包含了900多万张图片,都有类别标记。其中190多万张图片有非常精细的标注。Tortoise乌龟Container容器Magpie喜鹊Sea turtle海龟Football足球Ambulance救护车Ladder梯Toothbrush牙刷Syringe注射器Sink水槽Toy玩具Or
yolov9实现自建数据集训练,最新训练的安全帽佩戴识别,定义了helmet和head,使用1.6w张VOC格式数据集进行训练,迭代次数为100次,使用模型结构为yolov9-e.yaml,支持算法优化改进,包含加注意力机制,修改损失函数,修改网络结构等。
本篇主要计算机网络的定义和分类,例如按交换方式、使用者、传输介质、覆盖范围、拓扑结构进行分类。
另外一个简易版本的keras实现:,这个实现内没有采用VIVIT提出的几种模式,直接用3D卷积提取了特征,然后跟了几层transformer。模型从时间或者空间的dimension来拆分了计算,VIT模型需要更多的数据来train,模型参数量更多,常见的视频网络就是3D卷积,然后在视频帧提取的特征之间做average,最后做分类,现在有的工作在后面加了transformer来做分类的,提取时间上帧
分类
——分类
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 北京朝阳AI社区


 AtomGit AI 社区

 DAMO开发者矩阵

 openEuler 社区


 人工智能6S服务平台


 乐奇 Rokid 开放社区