- @purple_love


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
yolov8道路缺陷检测-道路坑洞检测-道路裂缝检测。

这是一个检测交通锥并识别颜色的项目。我使用 yolov5 来训练和检测视锥细胞。此外,我使用 k 均值来确定主色,以对锥体颜色进行分类。目前,支持的颜色为红色、黄色、绿色和蓝色。其他颜色被归类为未知。🚀B站项目实战🤵♂代做需求。
数据集格式为VOC格式,共包含3类图片(苹果,香蕉和橘子),每类有100张图片,其中80张用于训练集,20张用于验证集。数据集目录如下:数据集部分图片:
传统的预测方法,尽管在某些场景下能够取得一定的效果,但在面对大规模、高维度、非线性的负荷数据时,往往难以捕捉到数据背后的深层规律和模式。加权和则是一种更加灵活的融合方式,它通过对不同来源的特征向量赋予不同的权重,来调整它们在预测模型中的贡献度。在负荷预测中,Bi-LSTM模型能够学习到负荷变化的内在规律,如日负荷的峰谷特性、周负荷的周期性等,从而提高预测的准确性。在将K-Means聚类的结果与Tr

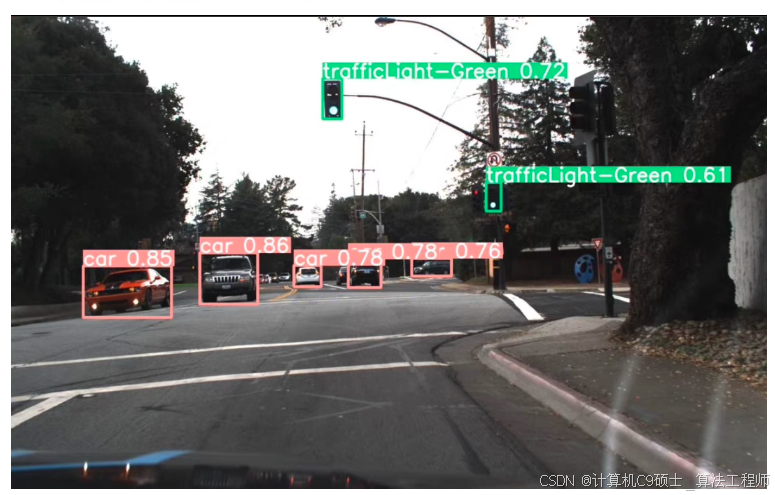
假设你的数据集已经准备好,并且分为训练集、验证集和测试集。│ ├── val/│ ├── val/│ ├── val/通过以上步骤,你可以构建一个基于YOLOv8模型的Udacity交通识别系统。用于将VOC格式的标注文件转换为YOLO格式,train.py用于训练模型,predict.py用于加载训练好的模型并进行预测。
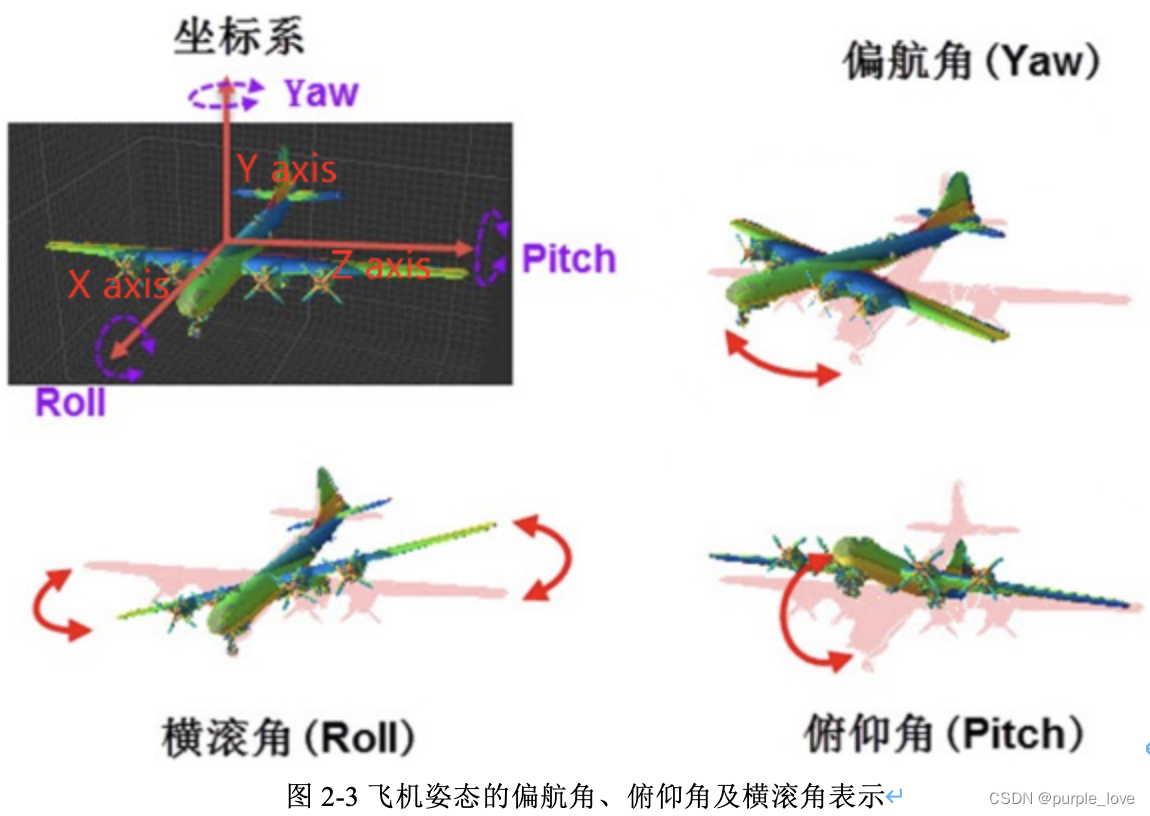
只使用一个摄像头进行 3D 目标检测的做法称为单目3D目标检测,单目相机即单个摄像头,单目相机结构简单,成本特别低,单目相机输出的数据为我们常见的照片。照片本质上是拍照时的场景在相机的成像平面上留下的一个投影,它以二维的形式反映了三维的世界。摄像机有很多种,但是基本原理是一样的:把光学图像信号转变为电信号,以便于存储或者传输。单目相机尽管成本低,但是也存在无法直接通过单张图片来计算场景中物体与我们
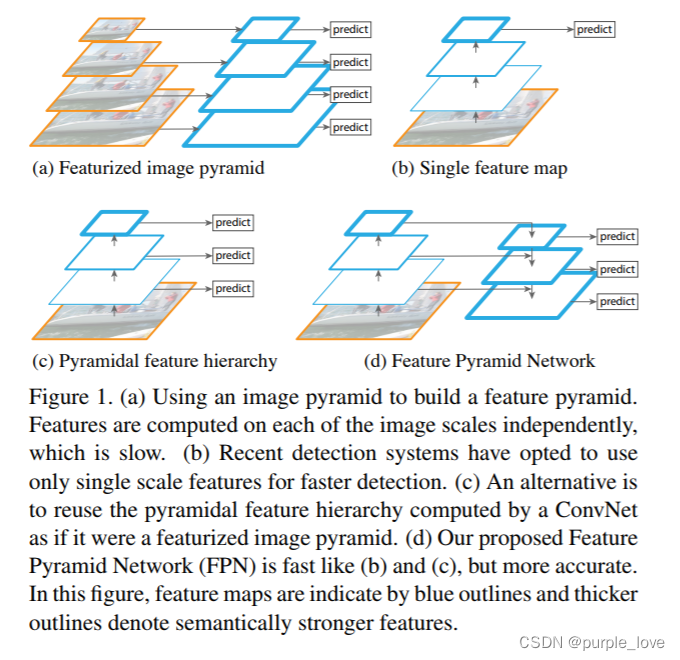
特征金字塔是识别系统中用于检测不同尺寸目标的基本组件。但最近的深度学习目标检测器已经避免了金字塔表示,部分因为它们是计算和内存密集型的。在本文中,我们利用深度卷积网络内在的多尺寸金字塔分层来构造具有很少额外成本的特征金字塔。开发了一种具有侧向连接的自顶向下(top-down)架构,用于在所有尺寸上构建高级语义特征图。这种架构,称为特征金字塔网络(FPN);在几个应用程序中作为通用特征提取器表现出
项目包含内容完整详细设计论文**🧿 项目分享:见文末!🔥计算机视觉、图像处理、毕业辅导、作业帮助、代码获取,远程协助,代码定制,私聊会回复!机器学习,深度学习,卷积神经网络处理,图像处理🚀B站项目实战🤵♂代做需求:@个人主页🚩基于机器学习的车牌识别系统****加粗样式**
本项目是基于携程网中关于大唐不夜城评论的文本分析,项目中用到了Python爬虫、词频分析、词云图分析、kmeans聚类、LDA主题分析、情感分析、社会网络语义分析等。本次实验我们使用了爬虫、词云图、情感分析、LDA主题分析、TF-IDF+Kmeans、社会网络语义分析等对大唐不夜城的评论进行了分析。关于博文中的源码大家可以关注派森小木屋公众号进入粉丝群领取,如对文章有疑惑,请评论区留言。
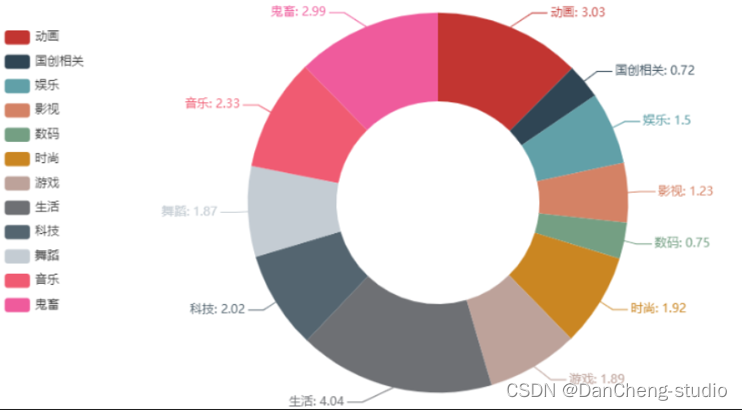
这里主要是进行查看数据信息、空值、重复值以及数据类型,但由于数据很完整这里不再做过多操作。对数据进行拆分、聚合,方便之后各项分析,由于“区类别”列中的“全站”是各分类中排名靠前的视频,会出现重复数据,因此对其进行去除。