登录社区云,与社区用户共同成长
邀请您加入社区
本文剖析 Transformer 取代 RNN、LSTM,成为大模型标配的核心原因。传统循环网络串行执行,训练慢、长文本信息易衰减,建模能力受限。Transformer 通过自注意力实现序列并行计算,充分释放 GPU 算力;任意 Token 可直接交互,解决长距离依赖;多头注意力从多个子空间学习语义、语法与逻辑关系,表征能力更强。架构上天然适配大数据预训练与复杂推理,适合面试备考与原理入门,配套课
摘要同样是 seq2seq:输入一长段,输出一小段# 在 RAG 里常用它把检索回来的长资料先压成摘要,再喂给下游 LLMlong_doc = "(RAG 检索回来的几十页资料)"# short["summary_text"] 即为压缩后的要点,长度可控、关键信息保留。
想弄懂 Transformer 和 Self-Attention,很多教程先讲架构图和公式,读完能复述,但合上页面推不出来。这篇换个顺序:先抛一个问题,用一个最小的数字例子算一遍,再看为什么会需要下一个机制。内容来自我做的一套 34 课大模型课程的第 1 课,一共 6 个问题,从 RNN 的问题一路走到 GPT 逐字生成。
使用学习率调度器(如 `torch.optim.lr_scheduler`)来动态调整学习率,提高训练效果。使用 `torch.nn.RNN` 或 `torch.nn.LSTM` 可以简化代码并提高性能。使用 `torch.nn.RNN` 或 `torch.nn.LSTM` 可以简化代码并提高性能。将训练和预测逻辑封装到一个 `nn.Module` 子类中,可以更好地管理模型参数和状态。将训练和预
循环神经网络(Recurrent Neural Network, RNN)是一类网络连接中包含环路的神经网络的总称。给定一个序列,RNN 的环路用于将历史状态叠加到当前状态上。沿着时间维度,历史状态被循环累积,并作为预测未来状态的依据。RNN 可以基于历史规律,对未来进行预测。
输入是:“机器学习“,输出是“machine learning”。模型的大概工作时序是:Encoder部分,输入序列逐个送进RNN,计算出最后时刻的隐藏状态c,作为上下文信息传给Decoder。Decoder部分,将c和t-1时刻的输出作为t时刻的输入,逐步计算预测得到t时刻的输出。这个结构中,Encoder和Decoder部分都是无法并行化的,这是由RNN结构本身决定的(t时刻计算依赖t-1时刻
把Transformer,RNN都视为一种SSM模型,简明的介绍了Mamba到底做了什么。
为了将文本转化为模型可以读入的单词序列,需要将这10000个不同的词汇分别映射到0~9999之间的整数编号。下面的辅助程序首先按照词频顺序为每个词汇分配一个编号,然后将词汇表保存到一个独立的vocab文件中。数据集共包含了9998个不同的单词词汇,加上稀有词语的特殊符号 和语句结束标记符在内,一共是10000个词汇。数据的下载地址:http://www.fit.vutbr.cz/~imikolov
最后,我们使用保存的模型来为测试集生成交易信号,其中保存的模型的输入长度为10,即使用10天的历史价格来预测下一天的价格。在这个示例中,我们只使用了一个模型来预测所有的交易信号。实际上,在实际交易中,可能需要使用多个模型来处理不同的市场情况,或使用模型集成技术来获得更精确的预测结果。在这里,我们使用MSE损失函数来计算预测值与目标值之间的差异,并使用Adam优化器来更新模型的权重。如何使用PyTo
目录结构Creat_novel 和Model 为空目录Creat_novel 生成小说保持目录Model 训路练后模型保持径Chinese_characters_3500.txt 是字典文件 也就是这个https://blog.csdn.net/u013628121/article/details/113844716 该文件作用:读取文件 为列表 然后创建一个字典键是列表的值字符 值就是该列表的索
主要生成相似句 再用神经网络判定句子的通顺性直接上代码两部分工作:第一部分基于统计生成相似语料:借助网上的python的github上的synonyms(自行百度):https://github.com/huyingxi/Synonyms 这里要说一下 分词不要用垃圾 的jieba 可以考虑hanlp 或者其他的 ;效...
本文是基于吴恩达《深度学习》第五周第一课后练习题所做。0.背景简介本练习题中,达叔提出了一个有趣的问题,让我们在现有的已知恐龙名称的基础上创造新的恐龙 ,而且如果所创造的新品恐龙和其外貌不相称的话就会被消灭。主要思路是利用现有的恐龙数据集,构建字符级的语言模型来产生新的名字,算法会学习不同的名字特征,然后产生新的名字。通过本练习可以实现如下4个目标:(1)如何使用RNN存储可处...
CNN-RNN-LSTM-GRU-【Encoder-Decoder模式】-Attention-【Self-Attention】-Transformer-GPT-BERT
本文系统介绍了深度学习中的关键神经网络模型及其变体。首先详细解析了CNN(卷积神经网络)的基本结构(输入层、卷积层、池化层、全连接层、输出层)和运算原理,包括零填充方式和典型模型(LeNet-5、AlexNet等)。其次阐述了RNN(循环神经网络)的序列处理机制及其长期依赖问题,重点讲解了改进模型LSTM(长短期记忆网络)的门控结构和训练过程。最后介绍了基于自注意力机制的Transformer模型
本章将从零开始,基于循环神经网络实现语言模型(不是单词级)首先我们把中的train_iter中的每个数字都表示在vocab中的索引,将这些索引直接输入神经网络可能会使学习变得困难,我们通常将每个词元表示为更具表现力的特征向量,即。
本周学习了循环神经网络的基础知识,通过具体案例来了解RNN的应用方式,认识了不同形式的RNN以及LSTM。同时,学习了RNN网络的优缺点以及采用什么方式来避免RNN产生的梯度消失问题。最后,学习到了 Attention-based Model 的基本结构以及两个具体应用案例。RNN( Recurrent Neural Network,循环神经网络)是一种特殊的神经网络架构,专门设计用于处理序列数据
深度学习:RuntimeError: cudnn RNN backward can only be called in training mode报错的解决方法
本文介绍了RNN,双向RNN,seq2seq架构,LSTM,GRU等,以及长期依赖的解决方案,截断梯度等。
过去十年的演进,是将推荐系统从**“为了点击率而不择手段的算法”重塑为“赋能全球数字化决策、具备内核级隐私保护与复杂逻辑理解能力的智慧引擎”**。你在纠结如何让模型分清“用户买过一次尿布,不代表他这辈子都要看尿布广告”。你在利用 eBPF 审计下的生成式推荐系统,看着它在内核层静默地保护着你的隐私,同时为你精准生成了一份未来一周的健康饮食方案。
人工智能学习
然而,值得注意的是,如果输入的历史序列很长,LSTM模型的内存和训练时间会大大增加,这是由于LSTM内部的计算过程复杂和监督学习数据的特殊结构所导致的。LSTM(Long Short-Term Memory)模型是一种特殊的RNN(循环神经网络)结构,主要用于解决传统RNN中的梯度消失和梯度爆炸问题,并实现对时间序列的长期依赖关系的捕捉。在整个过程中,LSTM通过精心设计的门控机制,使得模型能够更
为什么使用rnn模型时,需要用到滑动窗口预测所有数据:由于RNN模型,是之前的输入会对后来的输入样本的预测结果有影响。所以训练模型时候,在网络构建中定义的输入尺寸,在这里定义了输入的样本数是 TIME_STEP 个,所以预测时,也要用相同的尺寸,预测出相应尺寸的结果。如果这段话你听的不太明白你需要在深入理解一下RNN循环神经网络的原理。参考:史上最详细循环神经网络讲解(RNN/LSTM/GRU)
传统的轨迹预测方法,如“社交力模型”(Social Force Model),使用手工设计的规则来模拟人之间的互动行为,但这些方法有两个主要问题:手工设计规则的局限性,这些方法需要对具体场景进行特殊的建模,难以泛化到复杂的场景;只能考虑邻近的互动,传统方法只能处理近距离的行人之间的即时互动,无法预测未来可能发生的远距离互动。受到LSTM在不同序列预测任务(比如手写和语音生成)中取得成功的启发,提出
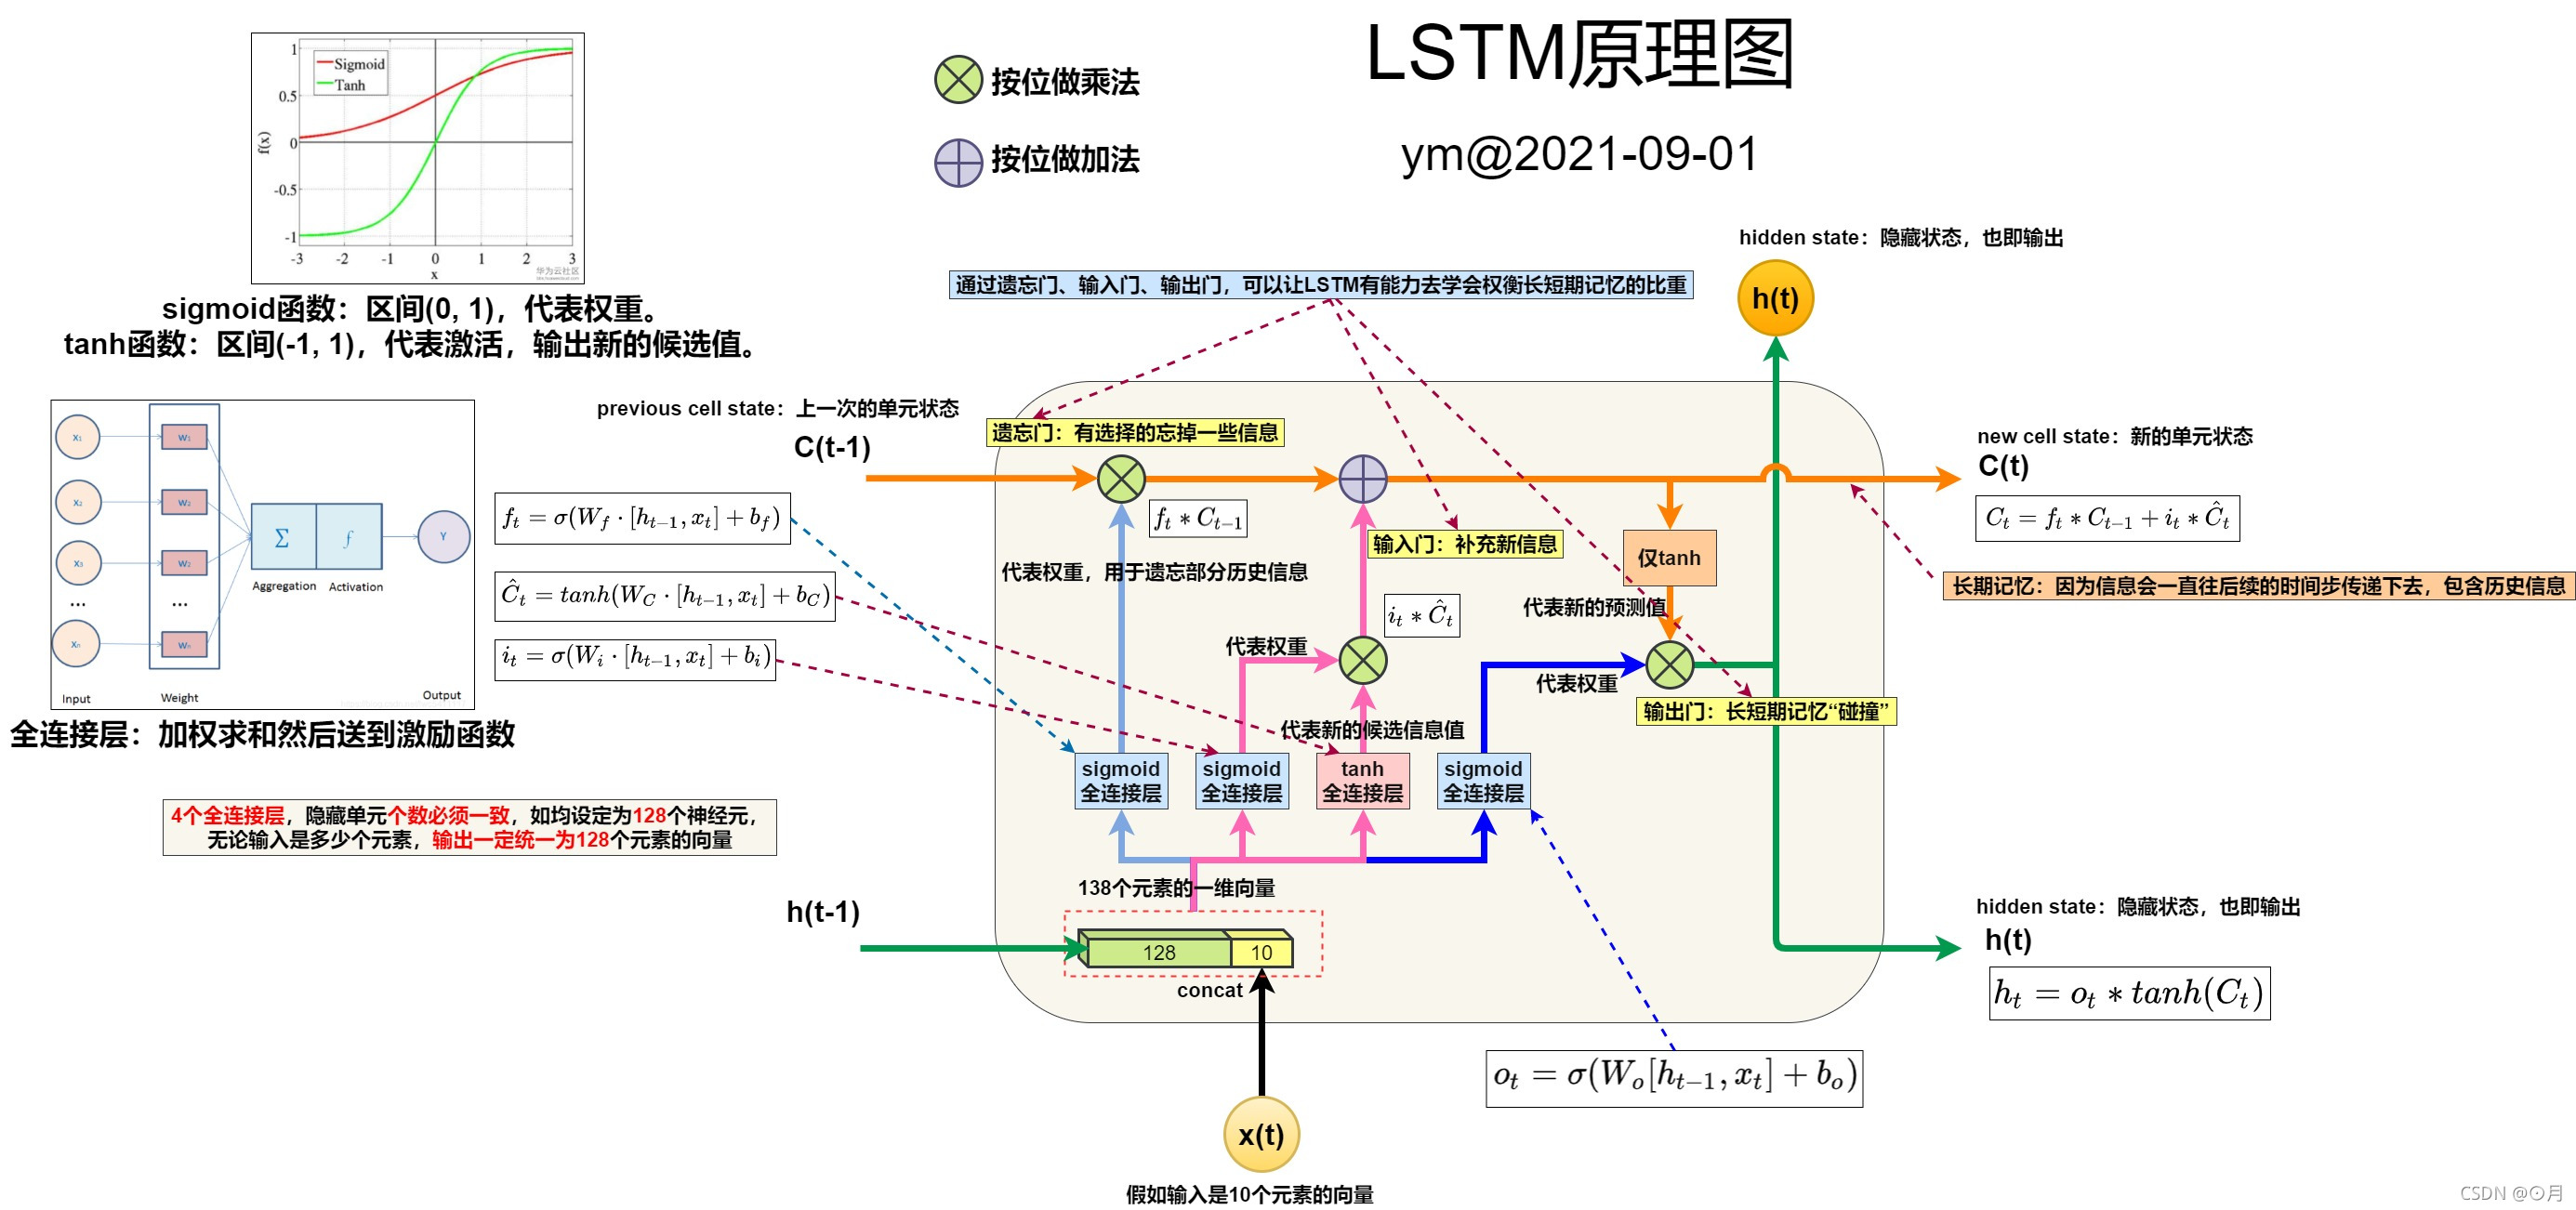
本文介绍了LSTM网络在解决RNN短期记忆问题中的应用。普通RNN存在隐藏状态信息衰减和梯度消失问题,难以学习长距离依赖关系。LSTM通过引入细胞状态和门控机制(遗忘门、输入门、输出门)有效保存长期记忆。文章详细阐述了LSTMCell的实现原理,包括状态初始化、细胞状态更新和隐藏状态更新过程。在此基础上构建了多层LSTM语言模型CharLSTM,结合Dropout和LayerNorm提升模型稳定性
在实际应用中,您需要根据具体的硬件环境和软件需求进行相应的调整和扩展。请注意,Modbus协议的详细实现涉及多个方面,包括帧格式、错误处理、数据校验等,因此在实际开发中需要仔细参考Modbus协议规范和相关文档。以下是一个简化的STM32 Modbus RTU主从机源码示例,用于支持单个或多个寄存器的写入和读取操作。请注意,此代码仅供参考和学习使用,具体实现可能需要根据实际硬件和软件环境进行调整。
在不显著损失“捕捉长期依赖、缓解梯度问题”核心能力的前提下,通过结构简化实现“轻量、高效、稳健、易落地”。它不是LSTM的“替代品”,而是“优化版”——适合大多数常规序列任务(文本分类、短序列预测、实时推理、小数据集场景);只有在极长序列(如1000+时间步的长文本生成)或对记忆精度要求极高的场景(如复杂机器翻译),LSTM才略占优势,但GRU仍是工程实践中的“首选”,因为它能以更低的成本达到接近
作为一个初学者,我认为模型的输入输出是我们最开始关心的问题。原文链接:https://blog.csdn.net/jokerxsy/article/details/106673603。
1. 循环神经网络(RNNs)人们思考问题往往不是从零开始的。就好像你现在阅读这篇文章一样,你对每个词的理解都会依赖于你前面看到的一些词,而不是把你前面看的内容全部抛弃了,忘记了,再去理解这个单词。也就是说,人们的思维总是会有延续性的。传统的神经网络是做不到这样的延续性(它们没办法保留对前文的理解),这似乎成了它们一...
低照度SCI模型转换(pt->onnx->rknn)并在板端测试
网上传感器的厂家有很多,都会提供优质的服务。如果你是第一次选择传感器,我们需要根据设计的要求,为厂家提供传感器的参数,让厂家帮忙选型。
注意,本文代码来自于plm-nlp-code。学习任何模型都需要一个简单可行的例子进行说明,我会基于plm-nlp-code的代码进行说明lstm在序列标注和句子极性二分类两个例子的应用。序列标注参考文件lstm_postag.py.1. 加载数据12#加载数据train_data, test_data, vocab, pos_vocab = load_tre...
本文是一份LSTM(长短期记忆网络)的极简原理与计算实例指南,主要包含五个部分:1)LSTM核心原理,通过三个门控机制(遗忘门、输入门、输出门)实现长期记忆控制;2)前置参数设定与注意事项,包括维度、初始化等关键细节;3)完整的两步迭代计算案例,展示h和c状态的动态更新过程;4)迭代循环的核心逻辑总结;5)补充实操注意事项,如维度升级、归一化等。全文以hidden_dim=1为例,通过具体数值演示
采用LSTM模型进行平均温度数据预测
深度循环神经网络作为一种重要的序列建模工具,已在诸多领域展现出强大的应用价值和优越性能。尽管面临梯度问题和训练复杂性的挑战,通过引入门控机制、残差连接等技术,以及与CNNs、Transformers等其他模型的有效融合,Deep RNNs在处理时序数据时依然保持着较高的竞争力。展望未来,随着硬件加速技术的进步、模型压缩与轻量化方法的发展,Deep RNNs有望在更多实时、嵌入式和资源受限的环境中得
仔细观察上面输出的这几行数据,在大多数恒星拥有行星的概率值小于0.1的情况下,其中一些行所显示的约0.2的概率值显著大于其他结果,这个“相对较大”的概率值可能就为我们指向一个有行星的星球。输出显示张量形状为(5 087,3 197,1),符合时序数据结构的规则:5 087个样本,3 197个时戳,1维的特征(光线的强度)。- 参数较少:相比于 LSTM(Long Short-Term Memory
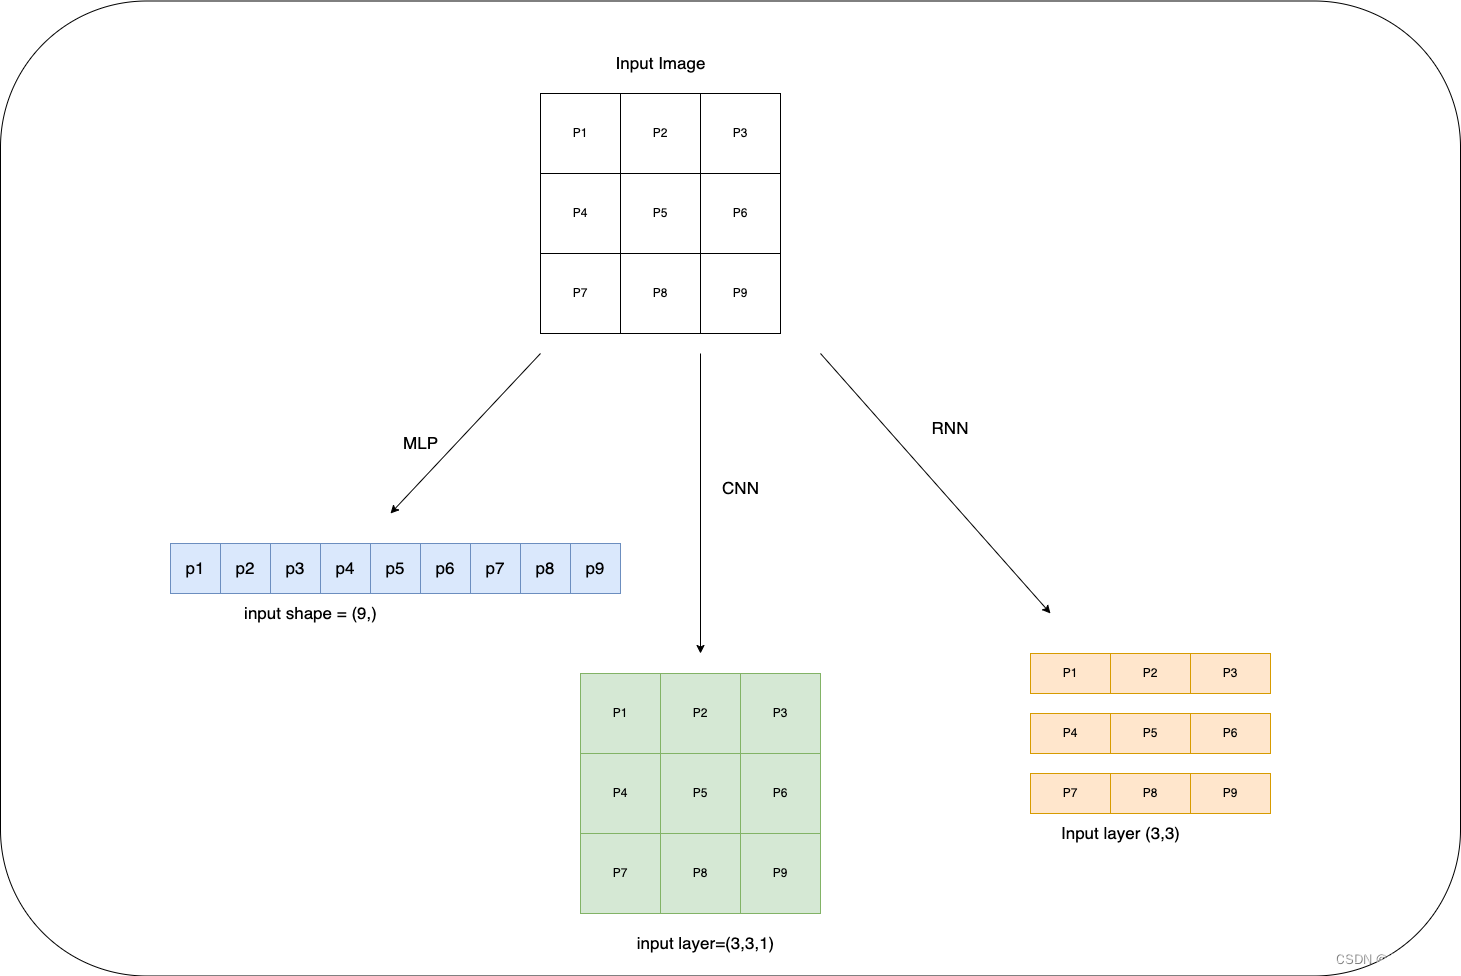
multilayer perceptron(多层感知机器)。常用于处理简单逻辑数学问题。
利用LSTM进行时序预测的方法
接上篇核心部分是计算机视觉的高层:环境理解。这部分是深度学习在计算机视觉最先触及,并展示强大实力的部分。出色的工作太多,是大家关注和追捧的,而且有不少分析和总结文章,所以这里不会重复过多,只简单回顾一下。我整理了一份关于pytorch、python基础,图像处理opencv\自然语言处理、机器学习、数学基础等资源库,想学习人工智能或者转行到高薪资行业的,大学生都非常实用,无任何套路免费提供,,加我
此代码主体与前面mnist一样,用rnn长短期记忆进行多分类import tensorflow as tffrom tensorflow.examples.tutorials.mnist import input_datafrom tensorflow.contrib.layers import fully_connected as fc# 读取数据mnist = input_da...
rnn
——rnn
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 北京朝阳AI社区


 乐奇 Rokid 开放社区






 天工造物局





 DAMO开发者矩阵